웨비나 요약: 텍스트 챗봇에 사람 같은 목소리 입히기
- 게시일
- 최종 업데이트
듣기이 글 오디오로 듣기
채팅 에이전트는 기업용 소프트웨어 스택의 기본 요소가 되었습니다. 대부분의 기업은 이미 하나를 갖추고 있거나 구축 중입니다. 하지만 사용자가 텍스트 대신 말하고 싶어 할 때 어떻게 해야 하는지는 아직 많은 기업이 해결하지 못했습니다.
음성은 단순한 편의성을 넘어 중요한 방식으로 상호작용을 바꿉니다. 사용자는 텍스트로는 완전히 사라지는 좌절감, 긴급함, 혼란을 말투로 표현합니다. "주문한 상품이 아직 도착하지 않았어요"라고 입력하는 고객과 불안감이 느껴지는 목소리로 같은 말을 하는 고객은 서로 다른 신호를 보내고 있습니다. 그리고 대화 내용을 읽을 수만 있는 에이전트는 정보의 절반만 활용하는 셈입니다.
이제 대부분의 팀이 던지는 질문은 음성을 추가할지 여부가 아니라, 이미 잘 작동하는 모든 것을 다시 구축하지 않고 어떻게 추가할 것인가입니다.
라이브 워크숍: 텍스트 챗봇에 사람처럼 들리는 음성 더하기에서 Paul Asjes(개발자 경험), Bhargavi Bhatt(고객 경험), Fergal Burnett(제품 마케팅, ElevenAPI)은 기존 에이전트에 음성을 추가할 때 마주하는 기술적 현실과 실제로 작동하는 통합 방식에 관해 설명했습니다.
음성 기반 구축이 생각보다 어려운 이유
핵심 과제 중 하나는 턴테이킹입니다. 사람은 억양, 리듬, 맥락을 통해 상대가 말을 마쳤는지 압니다. 하지만 음성 활동 감지(표준 방식)는 침묵만 감지합니다.
그 결과 모든 멈춤을 발화 신호로 받아들이는 시스템이 흔히 만들어집니다. 이런 시스템은 말을 끊고, 생각을 끝내기도 전에 중단하며, 자연스러운 망설임을 완성된 문장처럼 처리합니다.
기술적으로는 작동하지만, 대화 측면에서는 망가져 있습니다.
맥락은 문제의 또 다른 절반입니다. 매 턴마다 LLM에 대화 기록을 전달하는 일은 필요하지만 충분하지는 않습니다. 같은 말도 전달 방식에 따라 의미가 달라집니다. 안도하며 말하는 "괜찮아요"와 답답한 마음으로 말하는 "괜찮아요"는 같은 텍스트 기록이지만 서로 다른 상호작용입니다. 이 차원을 무시하는 음성 시스템은 개별 모델이 아무리 뛰어나도 언제나 어딘가 어색하게 들립니다.
엔지니어링 부담도 있습니다. 자체 음성 오케스트레이션을 운영하는 팀은 턴테이킹 로직, 인터럽트 처리, 지연 시간 프로파일링을 지속적으로 관리해야 합니다. 한 번 구축하고 끝나는 일이 아닙니다.
기존 에이전트에 음성을 추가하는 방법
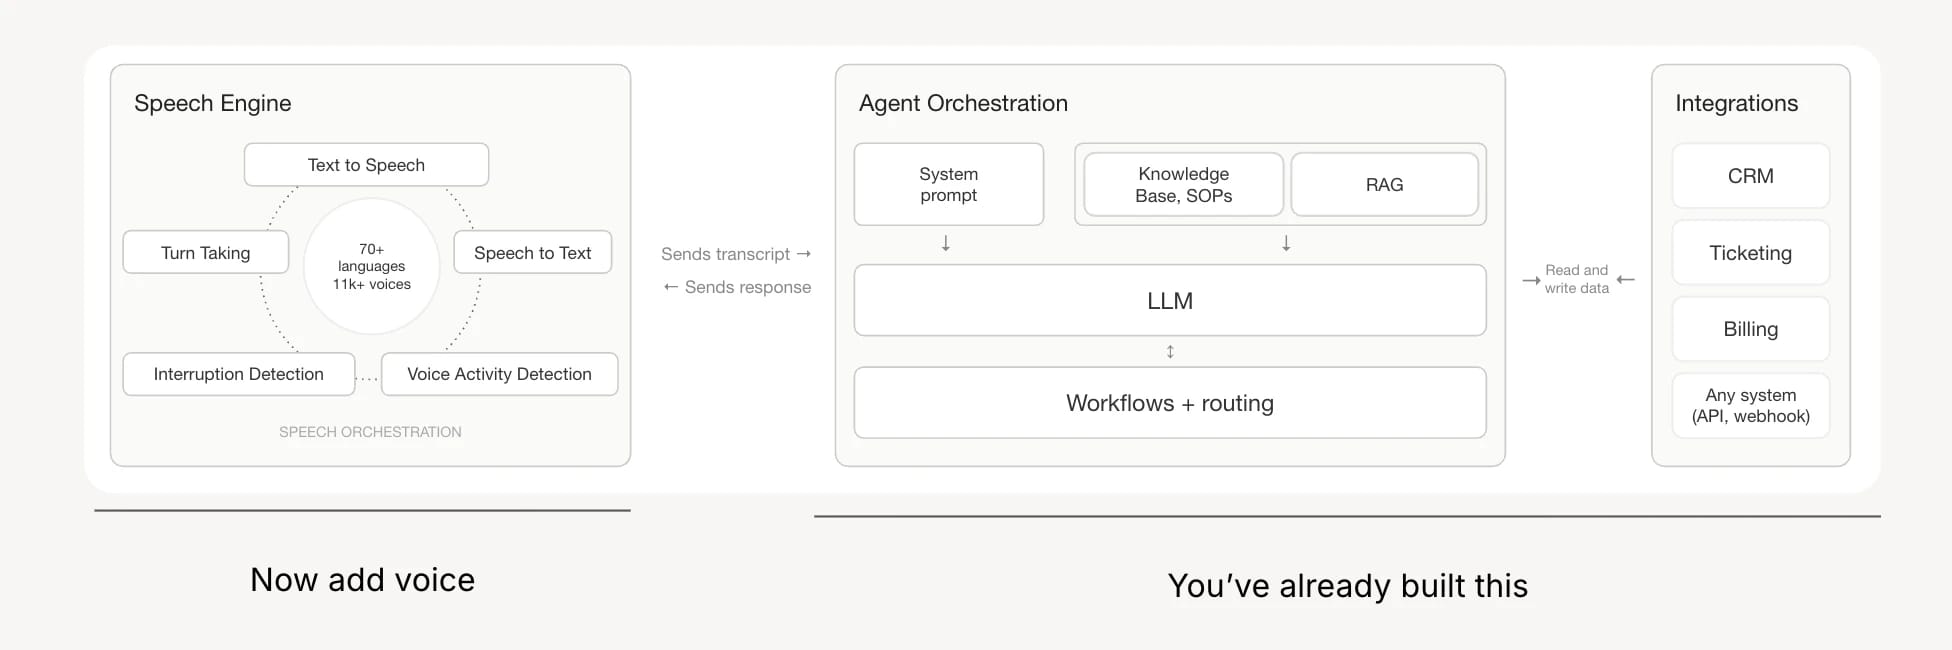
가장 깔끔한 방식은 이중 WebSocket 아키텍처입니다.
- 하나의 연결은 클라이언트와 ElevenLabs API 사이에서, 다른 하나는 서버와 ElevenLabs API 사이에서 실행됩니다
- 사용자가 마이크에 말하면 오디오가 ElevenLabs API로 전송되고, այնտեղ에서 전사된 뒤 서버로 전달됩니다
- 서버는 ElevenLabs API에서 받은 전체 대화 기록을 LLM에 제공하고, 스트리밍 응답은 오디오 합성을 위해 다시 전송됩니다
- LLM의 생성이 끝나기 전에도 이 과정을 시작할 수 있어 첫 바이트 지연 시간을 낮게 유지합니다
핵심 통합 지점은 onTranscript 메서드입니다. 이 메서드는 각 턴이 끝날 때 실행되어 전체 대화 기록을 LLM에 전달합니다.
세션 시작 시 contextualUpdate 를 사용하면 사용자가 음성으로 전환하기 전 텍스트 대화에서 발생한 모든 내용을 이어갈 수 있습니다. 덕분에 하나의 에이전트가 맥락을 잃지 않고 두 모달리티에서 모두 작동할 수 있습니다.
구축할 때 유념할 사항:
- 음성에서는 채팅보다 LLM 선택이 더 중요합니다. 응답 품질이 더 높더라도 심층 추론 모델은 오디오에서 부자연스러운 망설임으로 느껴지는 멈춤을 만듭니다. 실시간 음성에서는 더 빠른 모델이 체감 품질에서 거의 항상 우세합니다.
- 오디오에는 WebSocket보다 WebRTC를 사용하세요. WebRTC에는 기본 제공 에코 및 노이즈 제거 기능이 있어 모바일이나 소음이 많은 환경에서 특히 중요합니다. 오디오 전송에 WebSocket을 사용하면 이를 직접 처리해야 합니다.
- 사용자에게 언어를 선택하도록 요청하지 마세요. 대화 흐름이 끊깁니다. 음성의 처음 몇 초에서 언어를 감지해 고정하는 편이 더 나은 패턴이며, 사용자가 아무것도 하지 않아도 자연스럽게 전환할 수 있습니다.
- 턴테이킹 모델을 LLM과 분리하세요. 사용자가 말을 마쳤는지 판단하는 데 LLM을 사용하면 매 턴마다 지연 시간과 비용이 늘어납니다. 전용 턴테이킹 모델은 이를 더 빠르고 정확하게 처리하므로 아키텍처에서 별도 구성 요소로 다룰 가치가 있습니다.
직접 운영할 인프라의 범위
정답은 이미 갖춘 환경에 따라 달라집니다. 작동하는 채팅 에이전트가 있다면 LLM, 오케스트레이션, 비즈니스 로직은 그대로 유지하면서 그 위에 음성 레이어를 추가하는 것이 일반적으로 가장 빠르고 위험이 적은 방법입니다.
무언가를 다시 구축하는 것이 아닙니다. 이미 작동하는 시스템에 오디오 인터페이스를 더하는 것입니다.
요구 사항에 전화, 배포 채널 관리, 내장 테스트, 분석까지 포함된다면 스택의 더 많은 부분을 음성 에이전트 플랫폼에 맡기는 것이 합리적입니다. 두 방식은 상호 배타적이지 않습니다. 팀은 가벼운 음성 레이어로 시작한 뒤 사용 사례가 성숙해짐에 따라 플랫폼 기능을 추가할 수 있습니다.
데모: 기존 챗봇에 음성 추가하기
이 데모에서는 텍스트 기반 여행 계획 챗봇과 대화 중인 사용자가 일본 여행을 위한 지역 및 음식 추천을 요청하는 과정을 살펴봅니다.
다룬 내용:
- 기반 에이전트를 전혀 변경하지 않고 챗봇에 음성 레이어를 확장했습니다.
- 사용자는 대화 도중 입력에서 말하기로 전환했고, 에이전트는 두 모달리티 전반에서 전체 맥락을 유지했습니다.
- 사용자는 네덜란드어로 말했고, 에이전트는 언어 전환을 자동으로 감지했습니다
- 에이전트가 중간에 인터럽트된 뒤 문장 도중 영어로 다시 전환해 달라는 요청을 받자, 실제로 전환했고 별도 요청 없이 약간의 네덜란드어 억양으로 응답을 마무리했습니다.
- 대화 전반에서 인터럽트 감지 기능 덕분에 사용자는 에이전트가 차례를 마칠 때까지 기다리지 않고 자연스럽게 말을 이어갈 수 있었습니다.
중요한 이유:
이 데모는 처음부터 설계된 음성 에이전트를 보여준 것이 아닙니다. 이미 작동하던 텍스트 에이전트 위에 음성 레이어를 추가한 사례였습니다. 맥락 처리, 언어 감지, 인터럽트 동작은 모두 음성 레이어에서 제공했으며, 기반 텍스트 에이전트는 변경되지 않았습니다.
전체 세션 보기
전체 웨비나는 여기에서 시청하세요.
Paul은 ElevenLabs의 Developer Growth 팀에서 활동하며, 스페인 발렌시아를 기반으로 플랫폼의 개발자 경험(Developer Experience) 엔지니어로서 개발자 지원과 툴링에 집중하고 있습니다. ElevenLabs에 합류하기 전에는 Stripe에서 개발자 관계(Developer Relations)를 담당했고, WorkOS에서 DX 업무를 했으며, 오랜 기간 풀스택 웹 애플리케이션과 개발자 도구를 개발해왔습니다.