인터랙션 모델: 자연스러운 인간-AI 대화 구축
- 게시일
- 최종 업데이트
AI 음성 에이전트의 말을 중간에 끊어 본 사람이라면, 시스템이 사람 간의 대화를 위해 만들어지지 않았을 때 어떤 느낌인지 알 것입니다. 리듬은 어색하고, 음성은 내용과 동떨어져 있으며, 정보가 정확해도 상호작용은 어딘가 부자연스럽습니다. 지식 있는 사람과 대화하는 것이 아니라, 우연히 말을 사용하는 소프트웨어를 조작하는 것 같은 느낌입니다.
이러한 부자연스러움의 원인은 구조적입니다. 많은 음성 AI 시스템은 실제 대화의 흐름이 아니라 턴을 처리하도록 설계되었습니다. 한 번에 하나의 발화를 듣고, 처리하고, 응답합니다. 간단한 데모에서는 잘 작동하지만, 대화가 감정적이고 예측하기 어려워지면 한계를 드러냅니다.
인터랙션 모델은 오디오와 텍스트 전반에서 실시간으로 소통하도록 설계된 AI 시스템입니다. 무엇을 말했는지뿐 아니라 언제 말했는지, 그리고 그 순간 어떤 감정적 반응이 필요한지도 파악합니다. 이 글에서는 인터랙션 모델의 차별점, 음성 AI를 도입하는 기업에 중요한 이유, 그리고 ElevenLabs가 이를 어떻게 구현해 가고 있는지 설명합니다.
요약
- 대부분의 음성 AI는 끼어들기, 침묵 또는 여러 턴에 걸쳐 이어지는 맥락을 처리하지 못해 실제 대화에서 한계를 보입니다.
- ElevenLabs의 인터랙션 스택은 맥락을 잃거나 대화 흐름을 끊지 않고 끼어들기, 휴지, 겹쳐 말하기를 처리하도록 설계되었습니다.
- ElevenLabs는 고도화된 캐스케이드 아키텍처, 자체 개발 음성 인식(STT) 및 텍스트 음성 변환(TTS), 그리고 낮은 지연 시간과 자연스러운 양방향 대화에 맞춰 조정된 스택을 통해 진정한 인터랙션 모델을 구축하고 있습니다.
대부분의 인간-AI 음성 커뮤니케이션이 자연스럽지 않은 이유
대부분의 음성 AI는 대화를 분리된 입력과 출력의 연속으로 처리합니다. 시스템은 한 덩어리의 음성을 기다렸다가 텍스트로 변환하고, 해당 텍스트를 처리한 뒤 응답합니다. 이는 명령과 응답 방식의 상호작용에는 효과적이지만, 실제 대화는 깔끔하게 이어지는 텍스트 교환이 아닙니다. 휴지와 끼어듦으로 가득한 지속적인 주고받음입니다.
턴 사이의 흐름과 턴을 넘어 이어지는 맥락을 제거하면 다음과 같은 세 가지 문제가 발생합니다.
- 말을 끊거나 기다리게 합니다: 시스템은 생각하기 위한 잠깐의 멈춤과 발화가 끝난 것을 구분하지 못합니다. 그래서 아직 말하고 있는데 끼어들거나, 말을 멈춘 뒤에도 침묵합니다. 문장 중간에 생각을 정리하면 말이 끊기고, 할 말을 마치면 어색한 정적을 기다려야 합니다.
- 말하기 시작하면 반응하지 못합니다: 시스템은 응답을 시작하는 순간 듣기를 멈춥니다. 방향을 바꾸려고 말을 끊어도, 무언가 바뀌었다는 사실을 인식하지 못해 이미 넘어간 질문에 대한 답을 계속합니다.
- 대화 중 맥락을 잊습니다: 각 턴이 분리되어 처리되므로 다섯 번 전의 대화 맥락은 이어지지 않습니다. 결국 같은 말을 반복하게 되거나, 시스템은 이제 막 대화가 시작된 것처럼 응답합니다.
그 결과, 기능적으로는 올바르지만 여전히 어딘가 어색한 대화가 만들어집니다.
기존 음성 AI가 할 수 없는 일을 인터랙션 모델이 하는 방식
기존 음성 AI가 한 번에 한 턴씩 처리하는 반면, 인터랙션 모델은 말하는 내용과 다음에 필요한 조치를 동시에 파악하며 전체 대화를 পরিচাল합니다. 기능적 차이는 인터랙션 모델이 실제 대화 상황에 반응한다는 점입니다.
인터랙션 모델의 특징:
- 실시간 응답: 시스템은 대화 속도로 응답하도록 설계되었으며, 구성에 따라 엔드투엔드 사이클을 1초 이내에 실행할 수 있습니다.
- 끼어들기, 침묵, 겹쳐 말하기의 자연스러운 처리: 생각을 위한 멈춤과 발화가 끝난 것을 구분하므로, 말을 끊거나 어색한 정적을 만들지 않습니다. 고객이 방향을 바꾸기 위해 동시에 말해도 맥락을 잃거나 대화가 무너지지 않도록 처리합니다.
- 전체 대화에 걸친 연속성: 턴마다 맥락을 초기화하는 대신 대화 이력을 계속 유지하므로, 10번째 턴의 응답에는 첫 번째 턴 이후 일어난 모든 일이 반영됩니다.
- 상황에 맞춘 전달: 음성은 수행 중인 작업의 종류에 따라 더 차분하게, 더 직접적으로 또는 더 안심시키는 방식으로 바뀌도록 프로그래밍할 수 있습니다.
- 병렬 작업 실행: 시스템은 정보를 조회하고 도구 호출을 실행하면서 동시에 계속 말할 수 있어, 정보를 찾는 동안 침묵하지 않습니다.
인터랙션 모델의 진정한 시험대는 통화가 원활하지 않을 때입니다. 아래 녹음에서 고객은 항공편 취소 문제로 전화합니다. 고객은 긴장한 상태이며 문제를 신속히 해결해야 합니다.
에이전트는 고객이 사용하는 말에서 긴급함과 불만을 즉시 파악합니다. 어조를 조정하고, 흐름을 놓치지 않은 채 끼어들기를 처리하며, 연결된 도구를 사용해 취소된 항공편에 대한 실질적인 해결책을 제시합니다. 결국 고객은 사람 상담원의 도움 없이 문제를 해결합니다.
이를 오늘날 사용되는 일반적인 턴 기반 에이전트와 비교해 보세요. 이러한 시스템은 매번 멈춤을 기다리고 중립적인 기준으로 답하며, 고객이 느끼는 불만을 완전히 놓칩니다. 발신자가 실제로 느끼는 감정을 해결하지 못하는 대화가 몇 차례 이어지면, 통화는 사람 상담원에게 넘겨질 가능성이 높고 고객은 처음보다 더 큰 불만을 느끼게 됩니다.
ElevenLabs가 인터랙션 모델을 구축하는 방식
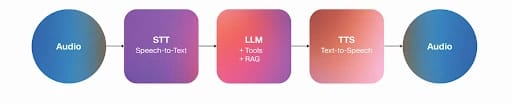
ElevenLabs의 대화 파이프라인은 고도화된 캐스케이드 아키텍처를 사용합니다. 하나의 모델이 모든 것을 처리하는 퓨즈드 아키텍처와 달리, 각 단계는 고유한 전문 컴포넌트로 구성됩니다.
이 접근 방식의 장점은 전체 시스템을 다시 구축하지 않고도 파이프라인의 각 단계를 독립적으로 최적화하고, 모든 구성 요소에 더 나은 모델을 적용할 수 있다는 점입니다. 또한 이러한 구성 요소를 자체 개발하기 때문에, 풍부한 컨텍스트를 서로 전달하도록 함께 최적화됩니다. 따라서 파이프라인은 개별 도구의 연쇄가 아니라 하나의 일관된 대화처럼 작동합니다.
캐스케이드 모델 구조
퓨즈드 모델 구조
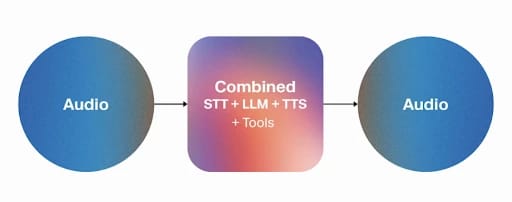
이미지: 캐스케이드 모델과 퓨즈드 모델 비교
현재 파이프라인을 구성하는 기술은 다음과 같습니다.
- Scribe v2 Realtime: 자체 개발 STT 모델은 90개 이상의 언어에서 약 150ms 만에 음성을 전사하며, 배경 소음, 억양, 끼어들기, 웃음이나 휴지 같은 비언어적 요소도 안정적으로 처리합니다. 의료 용어부터 금융 전문 용어까지 도메인별 어휘도 처리하도록 설계되었습니다.
- 예측형 턴테이킹: 이 시스템은 고정된 침묵 임계값에 의존하지 않고 대화의 흐름을 읽어 언제 말하고, 멈추고, 기다릴지 결정합니다. ElevenLabs의 음성 활동 감지 모델이 개선되면서 배경 음성과 짧은 응답을 더 효과적으로 필터링하여 턴테이킹을 더욱 자연스럽게 만듭니다.
- Eleven v3 Conversational: 실시간 양방향 대화를 위해 설계된 ElevenLabs의 가장 표현력 뛰어난 TTS 모델, 실시간 양방향 대화를 위해 구축되었습니다. 대화의 감정적 분위기를 턴 간에 이어 가므로, 10번째 턴에서 에이전트가 전달하는 방식에는 그 전까지의 모든 맥락이 반영됩니다.
- Expressive Mode: Eleven v3 Conversational과 턴테이킹 시스템을 기반으로 구축된 Expressive Mode는 그 순간 에이전트의 음성이 어떻게 들릴지를 제어합니다. 고객이 불만을 느끼면 긴장을 완화하고, 혼란스러워하면 안심시키며, 명확성이 필요할 때는 직접적으로 응답합니다. 또한 표현 태그를 읽어 [laughs], [whispers], [sighs] 같은 신호를 바탕으로 특정 순간의 전달 방식을 조정합니다.
- Flash v2.5: ElevenLabs의 저지연 TTS 모델은 32개 언어를 지원하며 75ms 이내에 음성을 생성합니다. 지연 시간이 우선일 때 자연스러운 사람의 대화 리듬 안에서 응답 시간을 유지합니다.
- Speech Engine: 스택을 하나로 연결하는 계층으로, 대화마다 하나의 연결을 통해 WebSocket으로 서버를 ElevenLabs의 ElevenAPI에 연결합니다. ElevenLabs가 STT와 TTS를 처리하는 동안 서버에서 LLM을 실행하므로, 기술팀은 자체 모델을 사용하고 대화 로직을 자체 인프라에서 유지할 수 있습니다.
이 모델들은 지속적으로 개선되고 있으며 새 버전도 정기적으로 출시됩니다. 새 릴리스마다 더 빠른 응답, 더 정확한 감정 인식, 더 많은 언어, 더 매끄러운 전달을 통해 소프트웨어와 대화하는 경험과 사람과 대화하는 경험의 격차를 줄입니다.
생각하면서 말하기
인터랙션 모델의 모든 부분이 엄격한 순서대로 실행될 필요는 없습니다. ElevenAgents는 질문과 답변 사이에 기본적으로 침묵하는 대신, 대화가 이어지는 동안에도 백그라운드에서 계속 작업할 수 있습니다.
몇 가지 핵심 시스템이 함께 작동해 말하기와 생각하기를 동시에 가능하게 합니다.
- 병렬 도구 호출: 에이전트는 말하는 중에도 데이터베이스를 조회하고, 도구를 실행하거나 주문 상태를 확인할 수 있어, 정보 검색이 대화 속의 어색한 공백처럼 느껴지지 않습니다.
- 소프트 타임아웃: LLM이 응답을 생성하는 데 예상보다 오래 걸리면, 에이전트는 어색한 침묵 대신 “생각해 볼게요” 또는 “음” 같은 짧은 완충 문구를 말합니다. 소프트 타임아웃은 자연스러운 대화 흐름을 유지하고 끼어들기 가능성을 줄이는 데 도움이 됩니다.
- 끼어들기 무시 용어: 시스템은 고정된 침묵 임계값을 사용하기보다, 실제로 턴이 끝난 시점을 파악하기 위해 발화의 의미를 읽으려 합니다. 마찬가지로 “알겠어요”나 “음흠” 같은 짧은 맞장구는 전체 끼어들기를 유발하지 않도록 설정할 수 있어, 발신자가 중간에 말을 보탤 때마다 에이전트가 흐름을 잃지 않습니다.
이 시스템들은 함께 작동해 에이전트가 응답을 버퍼링하거나 로드하는 것처럼 느껴지지 않게 합니다. 백그라운드에서 정보를 처리하고 생각을 정리하는 동시에, 사람이 하듯 자연스럽게 공백을 메우는 간결한 대화 엔진을 구성합니다.
ElevenLabs에서 대화가 실제로 작동하는 방식
앞서 살펴본 컴포넌트는 깔끔한 한 줄로 차례차례 실행되지 않습니다. 서로 겹쳐서 작동합니다. 고객 지원 통화 중 발신자가 “제 주문은 이미 배송됐나요, 아니면 아직 처리 중인가요?”라고 물었을 때 ElevenLabs 에이전트가 처리하는 방식은 다음과 같습니다.
- 발신자가 말합니다: 오디오는 WebSocket 연결을 통해 ElevenLabs로 스트리밍되며, Scribe는 음성보다 약 150ms 뒤에서 실시간 전사를 시작합니다.
- 시스템이 흐름을 파악합니다: Scribe가 아직 전사 중인 동안에도 예측형 턴테이킹은 발신자가 말을 마쳤는지, 아직 생각 중인지 평가합니다. 뒤에 이어진 “아니면 아직 처리 중인가요?”는 휴지가 아니라 다음 단계로 넘기는 신호로 인식되므로, 침묵 속에서 기다리지 않고 다음 단계를 시작합니다.
- LLM이 맥락을 구성하고 응답합니다: 전사된 질문은 대화 이력, RAG, 통화 초반의 도구 출력, 그리고 시스템 프롬프트가 함께 전달됩니다. LLM은 이 모든 정보를 바탕으로 추론하고 발신자의 주문 정보를 기반으로 응답을 생성합니다.
- TTS 모델이 응답을 합성합니다: 텍스트가 자연스러운 음성으로 바뀝니다. Expressive Mode가 활성화되어 있으면 응답에는 상황에 맞는 전달 신호가 포함되어, 일상적인 업데이트도 밋밋하지 않고 편안하고 여유롭게 들립니다. 지연 시간이 우선일 때는 Flash가 75ms 이내에 합성을 처리합니다.
- 응답이 다시 스트리밍됩니다: 합성이 끝나기 전부터 오디오가 재생되므로, 발신자는 나머지 부분이 생성되는 동안 답변의 시작을 들을 수 있습니다.
- 사이클이 반복됩니다: 새로운 턴마다 대화의 어조, 맥락, 이력이 계속 이어집니다.
이 빠른 과정 전반에서 대화는 자연스럽게 느껴집니다. 발신자는 기계에 맞추는 것을 멈춥니다. 천천히 말하거나, 과도하게 또박또박 발음하거나, 신호음을 기다리지 않습니다. 그저 사람과 대화하듯 말합니다.
비즈니스 전반에 자연스러운 음성 에이전트 배포
여기서 설명한 모든 기능은 현재 프로덕션 환경에서 제공되고 있습니다. 캐스케이드 아키텍처부터 1초 미만의 파이프라인까지, 전 세계 기업은 이미 ElevenAgents를 사용해 실제 고객 대화를 대규모로 처리하고 있습니다.
에이전트 아키텍처는 가드레일, 감사 로그, 규정 준수 제어 기능을 지원하므로 규제가 엄격하고 중요한 환경에도 적용할 수 있습니다. ElevenLabs는 SOC 2 Type II, ISO 27001, HIPAA, PCI DSS Level 1 인증을 보유하고 있으며, 데이터가 특정 경계 내에 머물러야 하는 팀을 위해 Zero Retention Mode와 리전별 데이터 레지던시를 제공합니다.
에이전트를 업무에 활용할 준비가 되셨나요? 에이전트를 생성하고 콘솔에서 구축을 시작하거나, 영업팀에 문의하여 환경에 맞는 배포를 상담할 수 있습니다.
인터랙션 모델 FAQ

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.