AI로 오디오를 텍스트로 변환
ElevenLabs의 오디오 텍스트 변환기를 사용해 인터뷰, 강의, 음성 메모를 정확한 화자 라벨 텍스트로 변환하세요. 배경 소음, 강한 억양, 수 시간 분량의 녹음도 문제없습니다. 지금 90개 이상의 언어로 이용해 보세요.
100만 명 이상의 사용자가 신뢰 · 무료로 시작
AI로 오디오를 텍스트로 변환
ElevenLabs의 오디오 텍스트 변환기를 사용해 인터뷰, 강의, 음성 메모를 정확한 화자 라벨 텍스트로 변환하세요. 배경 소음, 강한 억양, 수 시간 분량의 녹음도 문제없습니다. 지금 90개 이상의 언어로 이용해 보세요.
100만 명 이상의 사용자가 신뢰 · 무료로 시작
인터뷰.pdf
단순한 전사를 넘어선 오디오 이해
ElevenLabs 오디오-텍스트 변환은 누가 말하는지, 언제 말하는지, 주변에서 어떤 일이 일어나는지 파악해 언제나 구조화된 실행 가능한 트랜스크립트를 제공합니다.
최고 수준의 정확도
Scribe는 벤치마크 테스트에서 모든 주요 경쟁 ASR 모델을 능가합니다. 멀리 떨어진 마이크, 강한 억양, 낮은 품질의 전화 녹음에서도 업계 최고 수준의 단어 오류율을 제공합니다.
트랜스크립트 편집
단어를 클릭해 수정하고, 세그먼트를 분할하거나 병합하고, 잘못 표시된 화자를 다시 지정할 수 있습니다. 페이지를 벗어날 필요가 없습니다. 단어 단위 타이밍으로 모든 편집 내용이 오디오에 정확히 맞춰집니다.
90개 이상의 언어와 억양
Scribe는 충분히 지원받지 못하는 언어를 포함해 90개 이상의 언어를 전사합니다. 언어를 자동으로 감지해 정확한 AI 오디오-텍스트 변환을 제공합니다. 여러 언어가 섞인 인터뷰도 하나의 일관된 트랜스크립트로 받아볼 수 있습니다.
다양한 파일 형식 지원
MP3, WAV, M4A, FLAC, OGG는 물론 비디오 파일도 업로드하고, 결과를 TXT, DOCX, PDF, SRT, VTT, JSON 또는 HTML로 다운로드하세요. 녹음하는 모든 기기를 하나의 도구로 지원합니다.
오디오 이벤트 태깅
Scribe는 웃음이나 박수 같은 비음성 이벤트를 표시하므로, 강의 트랜스크립트에서 청중의 반응이 나온 지점을 실시간으로 확인할 수 있습니다.
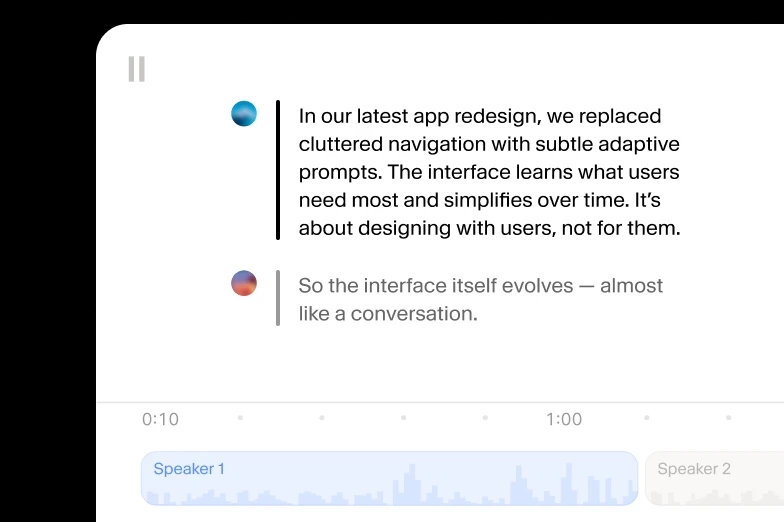
화자별 타임스탬프
Scribe는 최대 32명의 화자를 구분하고 모든 단어에 타임스탬프를 추가합니다. 따라서 패널 토론이나 그룹 인터뷰에서 누가 언제 무엇을 말했는지 언제나 정확히 알 수 있습니다.
3단계로 간편하게 오디오를 텍스트로 변환
수백만 단어 전사 완료, 계속 늘어나는 중
“ElevenLabs는 주로 음성 메시지를 전사하는 데 사용하고 있으며, 특히 정확도가 매우 뛰어납니다. 아직 읽기를 배우는 어린 학생이 말할 때도 학생의 읽기 유창성을 효과적으로 분석할 수 있어, 각 학생의 학습 진도를 파악하는 데 큰 도움이 됩니다.”

Pedro A.
기술 책임자
“인터뷰 전사에 완벽하고, 연설을 준비할 때 음성 품질도 놀라울 만큼 뛰어납니다.”
Izabela M.
고객 경험 연구원
“ElevenLabs의 Scribe v2 모델은 전사 요청에서 거의 실시간에 가까운 지연 시간과 뛰어난 추론 속도를 제공합니다. 지금까지 사용해 본 다른 모델보다 훨씬 빠릅니다.”
Vedaswaroop I.
창업자
지금 무료로 오디오를 텍스트로 변환하세요
웹에서 시작하기
ElevenCreative 웹 플랫폼에서 오디오를 텍스트로 변환하세요.
- 매월 10k 크레딧 제공
- 90개 이상의 언어와 억양
- 대용량 작업을 위한 유연한 요금제
오디오-텍스트 변환 API 및 SDK
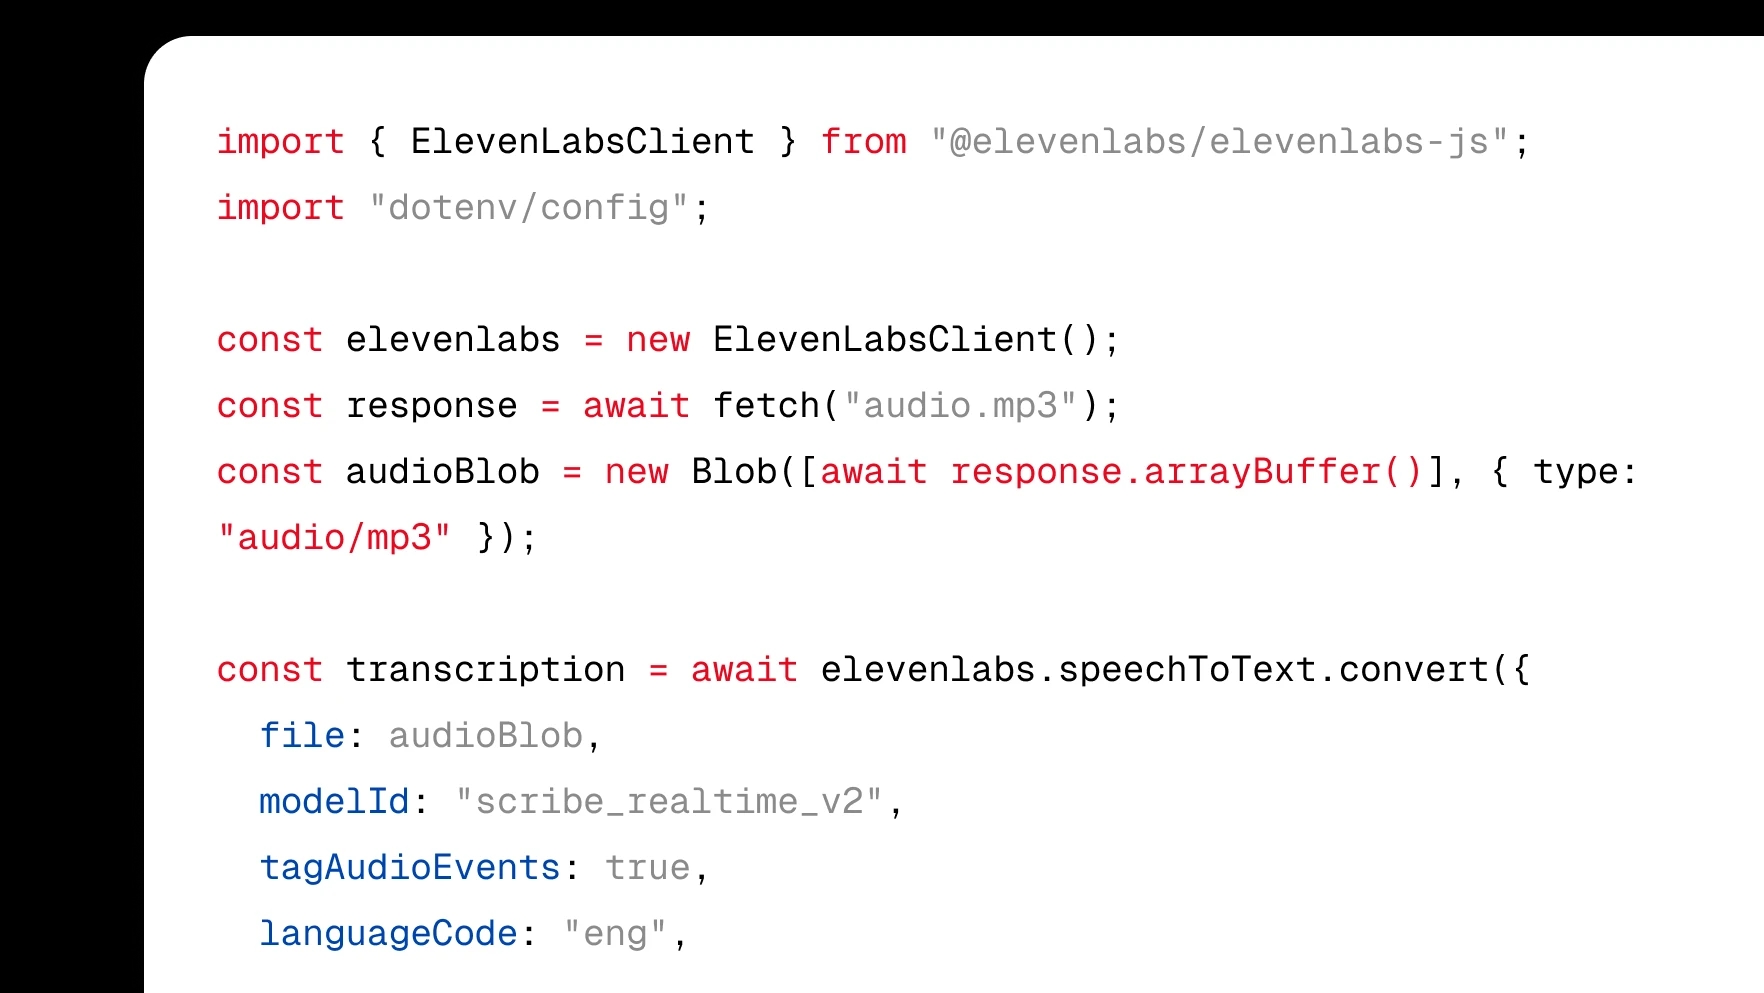
몇 줄의 코드로 제품에 전사 기능을 직접 통합하세요.
- 웹 및 모바일용 네이티브 SDK
- WebSocket 및 REST API
- 10만 명 이상의 개발자 커뮤니티