この声は存在しない - ジェネレーティブボイスAI
- 公開日
聴くこの記事を聴く
最近は、誰もが生成AIについて話しているようです。ChatGPT、Stable Diffusion、DALL-E、Midjourneyのような、ディープラーニングを活用した大規模言語モデルやテキストから画像を生成するモデルは、テクノロジー業界だけでなく幅広い分野で大きな話題を呼んでいます。これらを近年のAIにおける最も重要な進展の一つと見る人も少なくありません。賛否はあるとしても、非常に強力な何かが登場したというのが大方の印象のようです。2023年には、絵を描いたりビデオを作成したりできるモデルについて耳にするでしょう。最新・最高のスマートフォンは何かと尋ねるように、まもなく最新・最高の基盤モデルは何かを尋ねるようになるはずです。しかし、この盛り上がりの中でも、生成メディアにはまだ著しく注目されていない分野があると考えています。それがAI音声です。そして、そこは私たちがリーダーを目指す分野でもあります。Elevenでは、ディープラーニング技術が引き出す可能性を日々活用し、自然なテキスト読み上げとボイスクローンツールを提供しています。そして今、一からまったく新しい合成音声をデザインできる独自の生成モデルも導入しています。
ボイスジェネレーター:音声をデザインする
ユーザーは毎日プラットフォームを利用して、オーディオブック、ゲーム、ファンフィクションなどのキャラクターに命を吹き込んでいます。すべてのユーザーがコンテンツのニーズに合い、かつ自分だけが使える音声を見つけるには、現在の話者バンクは小さすぎると気づきました。そこで、まったく新しい合成音声をデザインできるようにしました。
この実現方法のアイデアは、現在使っている音声合成とボイスクローンの手法を掘り下げる中で生まれました。どちらのプロセスでも、特定の音声の特徴をエンコードする方法が必要です。そのアイデンティティを担うのが話者埋め込みであり、話者の音声をベクトルで表現したものです。専用モデルをトレーニングすれば、話者埋め込みの分布からサンプリングし、無限に多くの新しい音声を作り出せると考えました。
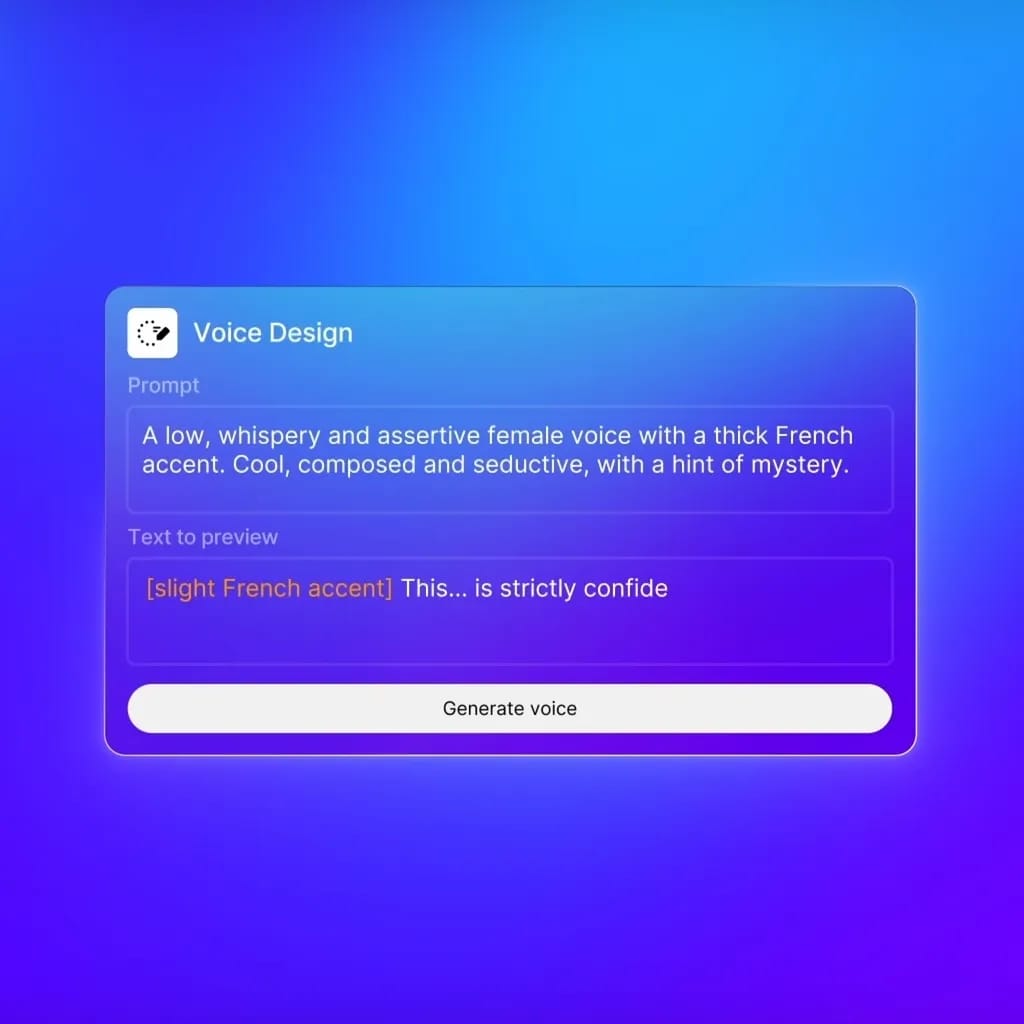
ユーザーの多くは特定の話し方の特徴を求めているため、プロセスにある程度の制御を加える必要がありました。音声の特徴に基づいて生成できるよう、条件付けによってモデルを拡張しました。現在のモデルでは、新しい音声の核となるアイデンティティを決める基本パラメーター、つまり性別、年齢、アクセント、ピッチ、話し方を設定できます。つまり、「生成」を押すたび、同じ基本パラメーターを選んだ場合でも、これまで存在しなかった、まったく新しい音声が生成されます。
この方法でデザインできる音声の例をご紹介します:
「音声をデザイン」は、Voice Labの一部として今年2月にプラットフォームで提供開始予定です。
何に使えるのか?
ツールはすでに人間と変わらないほど自然な音声を生成でき、人工音声の活用範囲は今後さらに広がると考えています。ニュース記事やコマーシャル用の音声収録を含むこうした新たな用途の多くでは、一つの音声を特定のブランドやユースケースに限定し、そのための音声として認識できること、そして他で使われないことが求められます。一方、ストーリーテリングやビデオゲームのようなユースケースでは、開発の初期段階から柔軟に試せる自由度が重視されます。そこで、巨大な仮想話者セットを作るのではなく、用途に最も適した音声を最終的に選ぶのはユーザー自身であるべきだと考えました。
書籍の著者は、作品を手軽にオーディオ化できるだけでなく、オーダーメイドのナレーションをデザインする芸術的な主導権も維持できます。これにより、読者・リスナーは出版物と関わるための新しい興味深い方法を得られるとともに、楽しめるオーディオブックの数も大幅に増えていきます。
ニュース出版社はますますオーディオ分野へ進出しており、自社の出版物を表す特徴的な音声を選ぶことは重要な課題です。多くのリスナーは内容だけでなく、表現形式にも価値を見出します。同様に重要なのは、特定の音声が自社だけを表すものであると、出版社が確信できるようになることです。
ビデオゲーム開発者は、必要なツールを手元で利用して、これまで声を持たなかった多数のNPCに声を与えられるようになります。品質を損なうことなくコスト効率を高められるだけでなく、自らが作る仮想世界に完全に固有の音声もデザインできます。
広告クリエイターには、特定のキャンペーンに合うボイスオーバーが必要です。そのため、開発の開始時点で心に響く目的に合ったナレーションをデザインできることは、大きなメリットになります。追加のリソースを確保することなく、複数の音声や話し方をすぐに試せます。
クリエイターから、あらゆる種類のオーディオ・ビデオコンテンツを制作する人、企業のコミュニケーションに声を付けたい担当者まで、ユニークで特定のユースケースに合わせた魅力的なオーディオをデザインする可能性は、今や無限に広がっています。
倫理的なAI
ボイスクローンの悪用がもたらす影響への懸念と同様に、AI技術の普及によって専門職の生計が脅かされるのではないかと心配する人が増えています。Elevenでは、ボイスアクターが対価を得て、特定用途の音声モデルをトレーニングするために自分の声をライセンス提供できる未来を描いています。クライアントやスタジオはこれからもプロの声の才能をプロジェクトに喜んで起用するでしょう。AIは、より迅速な制作と、開発初期に試行や方向性の確立を行う自由度を高めることに役立つだけです。この技術は話し言葉のオーディオをデザイン・収録する方法を変えるでしょう。しかし、ボイスアクターがすべてのセッションに物理的に उपस्थितする必要がなくなることで、一度により多くのプロジェクトに参加できる自由を得られ、声を真に残し続けることも可能になります。
さらに期待しているのは、これまで著者や開発者が収録費用を負担できなかった多くの書籍、ニュース、インディーゲーム、その他のコンテンツが、別のメディアを通じて利用できるようになることです。アクセスが広がれば、それぞれのコンテンツでオーディエンスを拡大する機会も生まれます。
Elevenでは、知的財産権を尊重し、技術の悪用を防ぐための対策を講じることに全力で取り組んでいます:
- 違法または有害とみなされる目的での悪意ある技術利用を禁じる利用規約を遵守するクライアントとのみ提携します;
- モデルが生成したすべてのオーディオに電子透かしを入れ、即座に当社まで追跡できるよう取り組んでいます;
- 認識可能な音声を使用する際は、デモンストレーション目的に限り、利益相反を生じさせない文脈で使用します;
- 同時に、音声の権利者とそのライセンサーによる権利の主張を支援し、既知のすべての侵害を確認して対応します。
今後に向けて:自分の声を強化する
将来的には、音声生成モデルとボイスクローンモデルの機能を組み合わせ、ユーザーが自分の声を強化できるようにする予定です。自分の声をクローンし、望む効果に合わせて加工できるようになります。自分の話し方が少し単調だと感じるなら、変化を加えられます。録音されるのが本当に苦手なら、出力をより自然に聞こえるよう加工できます。事前録画のプレゼンテーションでも音声メッセージでも、どのような目的であれ自分の声を使ったオーディオを作る必要がある人は、ボタンをクリックするだけでツールスイートを活用できます。
新年おめでとうございます
2022年の終わりにあたり、継続的なご参加とフィードバックをいただいたベータユーザーの皆様に感謝します。現在開発している機能の多くは、皆様からのご意見やご提案によるものです。皆様をお迎えできてこれほど嬉しいことはありません。素晴らしい新年をお迎えください。
ElevenLabsベータ
こちらからベータプラットフォームに登録し、ぜひお試しください。常に改善を続けており、この初期段階ではユーザーの皆様からのあらゆるご意見が非常に貴重です。