
Riepilogo Webinar: Dai una voce naturale al tuo chatbot testuale
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Gli agenti di chat sono diventati una componente standard dello stack software aziendale. La maggior parte delle aziende ne ha uno o ne sta sviluppando uno. Ciò che in meno hanno capito è cosa succede quando un utente preferisce semplicemente parlare.
La voce cambia l'interazione in modi importanti, non solo per comodità. Gli utenti esprimono frustrazione, urgenza e confusione attraverso il tono, elementi che il testo elimina completamente. Un cliente che scrive "il mio ordine non è arrivato" e uno che lo dice con ansia percepibile inviano segnali diversi e l'agente che può leggere solo la trascrizione lavora con appena metà delle informazioni.
La domanda che oggi si pongono molti team non è se aggiungere la voce, ma come farlo senza ricostruire tutto ciò che già funziona.
Nel Workshop dal vivo: dai al tuo chatbot testuale una voce che suona umana, Paul Asjes (Developer Experience), Bhargavi Bhatt (Customer Experience) e Fergal Burnett (Product Marketing, ElevenAPI) hanno illustrato gli aspetti tecnici dell'aggiunta della voce a un agente esistente e come si presenta concretamente un'integrazione funzionante.
Perché sviluppare con la voce è più difficile di quanto sembri
Una delle sfide principali è la gestione dei turni. Gli esseri umani capiscono quando qualcuno ha finito di parlare grazie all'intonazione, al ritmo e al contesto. Tuttavia, il rilevamento dell'attività vocale (l'approccio standard) rileva soltanto il silenzio.
Il risultato è spesso un sistema che interpreta ogni pausa come un invito a parlare: interrompe, tronca il discorso a metà e reagisce alle esitazioni naturali come se fossero frasi complete.
È funzionale dal punto di vista tecnico, ma non funziona nella conversazione.
Il contesto è l'altra metà del problema. Passare la cronologia della conversazione a un LLM a ogni turno è necessario, ma non sufficiente. Le stesse parole assumono significati diversi a seconda di come vengono pronunciate: "Sto bene" detto con sollievo e "Sto bene" detto con frustrazione hanno la stessa trascrizione, ma producono un'interazione diversa. Un sistema vocale che ignora questa dimensione suonerà sempre leggermente fuori posto, indipendentemente dalla qualità dei singoli modelli.
C'è anche il carico di lavoro tecnico. I team che gestiscono autonomamente l'orchestrazione vocale devono occuparsi continuamente della logica dei turni, della gestione delle interruzioni e dell'analisi della latenza. Non è un'implementazione una tantum.
Come aggiungere la voce a un agente esistente
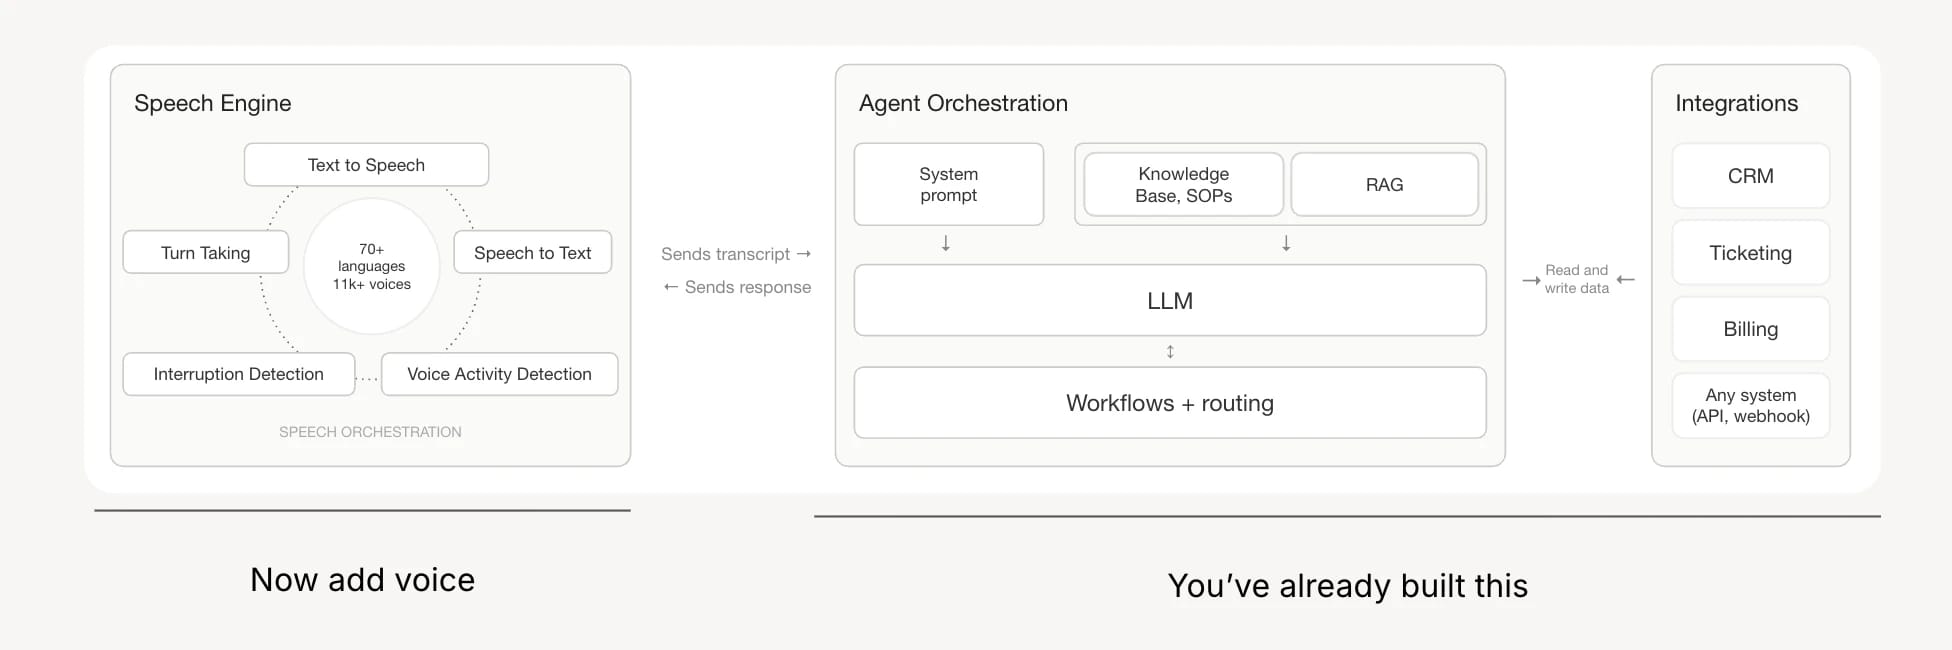
L'approccio più lineare è un'architettura con due WebSocket.
- Una connessione è attiva tra il client e l'API di ElevenLabs, mentre un'altra è attiva tra il tuo server e l'API di ElevenLabs
- L'utente parla nel microfono, l'audio viene inviato all'API di ElevenLabs, dove viene trascritto e inoltrato al tuo server
- Il tuo server passa all'LLM l'intera cronologia della conversazione ricevuta dall'API di ElevenLabs e la risposta in streaming torna indietro per la sintesi audio
- Questo può iniziare prima che l'LLM abbia terminato la generazione, mantenendo bassa la latenza del primo byte
Il punto di integrazione chiave è il metodo onTranscript , che viene attivato alla fine di ogni turno e passa all'LLM l'intera cronologia della conversazione.
Un contextualUpdate all'avvio della sessione mantiene ciò che è accaduto nella parte testuale della conversazione prima che l'utente passasse alla voce: è questo che consente a un singolo agente di funzionare in entrambe le modalità senza perdere il contesto.
Alcuni aspetti da tenere presenti durante lo sviluppo:
- La scelta dell'LLM conta più nella voce che nella chat. I modelli di ragionamento approfondito introducono pause che nell'audio risultano esitazioni innaturali, anche se la qualità della risposta è maggiore. Per la voce in tempo reale, i modelli più veloci vincono quasi sempre in termini di qualità percepita.
- Per l'audio, preferisci WebRTC ai WebSocket. WebRTC include la cancellazione dell'eco e del rumore, particolarmente importante sui dispositivi mobili o in ambienti rumorosi. Usare i WebSocket per il trasporto audio significa dover gestire questi aspetti autonomamente.
- Non chiedere agli utenti di selezionare una lingua. Interrompe il flusso della conversazione. Rilevare la lingua dai primi secondi di parlato e mantenerla è un approccio migliore, che consente anche di cambiare lingua in modo naturale senza richiedere alcuna azione all'utente.
- Separa il modello di gestione dei turni dall'LLM. Usare l'LLM per decidere quando un utente ha finito di parlare aggiunge latenza e costi a ogni turno. Un modello dedicato alla gestione dei turni lo fa più velocemente e con maggiore precisione, quindi vale la pena trattarlo come un componente distinto dell'architettura.
Quanta infrastruttura gestire internamente
La risposta giusta dipende da ciò che già esiste. Se hai un agente di chat funzionante, aggiungere un livello vocale sopra di esso, mantenendo invariati LLM, orchestrazione e logica aziendale, è di solito il percorso più rapido e meno rischioso.
Non stai ricostruendo nulla. Stai aggiungendo un'interfaccia audio a qualcosa che già funziona.
Se le esigenze includono telefonia, gestione dei canali di deployment, test integrati e analisi, ha senso affidare una parte maggiore dello stack a una piattaforma per agenti vocali. I due approcci non si escludono a vicenda: i team possono iniziare con un livello vocale leggero e aggiungere funzionalità della piattaforma man mano che il caso d'uso matura.
Demo: aggiungere la voce a un chatbot esistente
Questa demo mostra un utente nel mezzo di una conversazione con un chatbot testuale per la pianificazione di viaggi, che chiede consigli su quartieri e cibo per un viaggio in Giappone.
Cosa abbiamo trattato:
- Il chatbot è stato esteso con un livello vocale senza apportare modifiche all'agente sottostante.
- L'utente è passato dalla digitazione alla voce nel mezzo della conversazione e l'agente ha mantenuto il contesto completo in entrambe le modalità.
- L'utente ha parlato in olandese; l'agente ha rilevato automaticamente il cambio di lingua
- Quando l'agente è stato interrotto e gli è stato chiesto di tornare all'inglese a metà frase, lo ha fatto e ha concluso la risposta con un leggero accento olandese, senza che gli venisse richiesto.
- Durante tutta la conversazione, il rilevamento delle interruzioni ha consentito all'utente di parlare sopra l'agente in modo naturale, senza che questo completasse il proprio turno.
Perché è importante:
La demo non mostrava un agente vocale sviluppato appositamente. Mostrava un agente testuale già funzionante, con un livello vocale aggiunto sopra. La gestione del contesto, il rilevamento della lingua e il comportamento in caso di interruzione provenivano tutti dal livello vocale, mentre l'agente testuale sottostante non è stato modificato.
Guarda la sessione completa
Guarda il webinar completo qui.
Paul fa parte del team Developer Growth di ElevenLabs, con base a Valencia, in Spagna, dove lavora come Developer Experience Engineer occupandosi di advocacy e strumenti per la piattaforma. Prima di entrare in ElevenLabs, ha guidato le Developer Relations in Stripe, si è occupato di DX in WorkOS e ha trascorso anni a sviluppare applicazioni web full-stack e strumenti per sviluppatori.




