
Creare agenti vocali destinati a durare: alcune lezioni apprese dal forward deployed engineering
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Per la maggior parte delle organizzazioni, le soluzioni puntuali per il supporto sono da tempo valutate in base alla capacità di deviare le richieste. Questo significa ridurre il volume delle chiamate e limitare le interazioni con gli operatori umani. Ma deviare una richiesta non significa risolverla, e il divario tra le due cose è dove l'esperienza del cliente si deteriora. Per colmarlo, gli agenti devono avere accesso non solo ai dati, ma anche ai sistemi necessari per agire su di essi. Di conseguenza, gli agenti possono elaborare rimborsi, guidare i clienti nel processo di checkout e trasferire la conversazione a un operatore umano con tutto il contesto quando la situazione lo richiede. Così le aziende possono gestire le interazioni con i clienti su larga scala, riducendo in modo significativo il carico sui team di supporto umani e migliorando l'esperienza per entrambe le parti della chiamata. In una recente implementazione con Revolut, azienda fintech che serve 70 milioni di clienti nel mondo, questo si è tradotto in una riduzione di 8 volte del tempo di risoluzione e in un tasso di successo delle chiamate del 99,7%.
Le organizzazioni devono affrontare cambiamenti di questa portata in modo iterativo, mantenendoli strettamente legati alla missione principale dell'azienda e supportati con decisione dai vertici. A livello tecnico, il ragionamento in un ambiente non strutturato comporta rischi intrinseci che vanno gestiti con attenzione. Dare a un agente la capacità di agire nel Customer Relationship Management (CRM), modificare un ordine nel sistema point-of-sale o inoltrare un caso significa che il modello di governance conta quanto il modello stesso. Il punto non è quindi se gli agenti possano svolgere un lavoro reale, ma quali meccanismi siano necessari per implementarli in sicurezza e in modo ripetibile.
In questo articolo, partiamo dalla nostra esperienza per condividere ciò che rende gli agenti efficaci, dalla prima implementazione fino alla scalabilità sull'intera attività di assistenza clienti di un'organizzazione.
Implementare agenti rispetto a implementare software
Prima di approfondire la creazione di agenti, vale la pena confrontare l'implementazione degli agenti vocali con quella del software tradizionale, che le aziende adottano da decenni. Da questa prospettiva, gli agenti possono essere distinti in due componenti: software tradizionale e orchestratore centrale.
Software


Orchestratore centrale
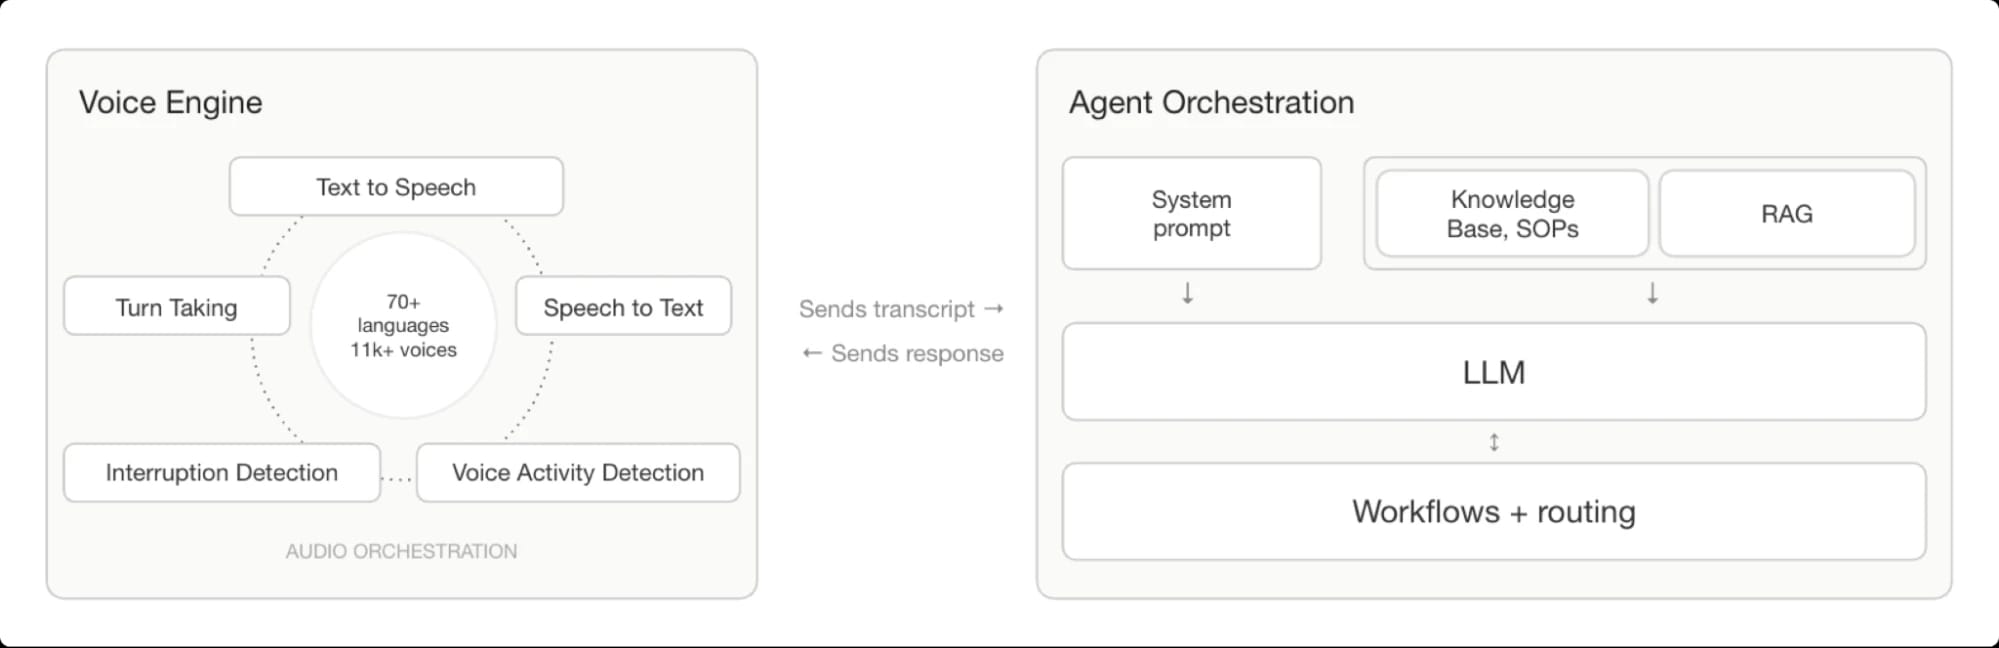
I componenti software tradizionali puntano principalmente a migliorare l'erogazione e le prestazioni dell'agente. Per ElevenAgents, includono funzionalità come versioning, test A/B, telefonia e la configurazione del primo messaggio, tra le altre. Dopo l'implementazione, questi componenti presentano una deriva minima o nulla, rendendo il loro comportamento altamente prevedibile. Grazie a solide pratiche di sviluppo, le organizzazioni possono sfruttare rapidamente queste funzionalità e comprendere a fondo le loro prestazioni in produzione attraverso un rigoroso insieme di metriche, trace e log. I miglioramenti della latenza in questo livello seguono schemi ben noti: caching, connection pooling, scalabilità dell'infrastruttura e ottimizzazione dei protocolli sono tutte leve affidabili con risultati deterministici.
Per loro natura, i componenti dell'orchestratore centrale sono più difficili da prevedere, ma determinano le prestazioni runtime dell'agente sia in termini di qualità delle risposte sia di latenza percepita. A differenza del software tradizionale, questi componenti operano su linguaggio naturale e audio, dove lo spazio degli input è di fatto illimitato e piccoli cambiamenti nella formulazione, nel contesto, nel rumore di fondo o nel comportamento dell'utente possono produrre output significativamente diversi nel tempo. Per questo, i test convenzionali da soli non bastano: un agente può funzionare senza problemi in centinaia di casi di test e fallire comunque in produzione in modi difficili da prevedere.
Anche la latenza in questo livello è meno deterministica: dipende dai tempi di inferenza del modello, dall'inserimento di artefatti sonori, dalle catene di tool call e dalla variabilità intrinseca dei sistemi generativi. Gestire bene questi componenti richiede una disciplina diversa, basata su framework di valutazione, monitoraggio della produzione e disponibilità a iterare continuamente sui dati delle conversazioni reali, anziché affidarsi solo alle ipotesi precedenti all'implementazione.
Questa distinzione definisce il modo in cui le organizzazioni dovrebbero affrontare l'adozione: iniziare con casi d'uso rilevanti per l'organizzazione ma a basso rischio, quindi scalare con criterio man mano che cresce la fiducia nel sistema.
Ciclo di rilascio
Selezionare i casi apripista
Per i team che iniziano ad adottare gli agenti vocali, scegliere i giusti casi apripista è una delle decisioni iniziali più importanti. Inoltre, dipende meno dalla tecnologia di quanto molti si aspettino. I team che ottengono successi iniziali ed evitano l'interminabile abisso dei POC tendono ad avere qualcosa in comune: sanno rispondere con chiarezza alle domande seguenti.
- In che modo questo caso d'uso genera valore aziendale misurabile? Il caso d'uso da cui iniziare non è il più interessante dal punto di vista tecnico, ma quello che ha maggiori probabilità di incidere su un risultato a cui l'azienda tiene già. Può essere misurato attraverso l'impatto sui ricavi, la riduzione dei costi, la soddisfazione dei clienti e altre metriche che i responsabili già monitorano e di cui rispondono. Senza un legame diretto con il valore aziendale, diventa difficile giustificare i cicli di iterazione necessari per perfezionare l'agente e lo slancio rischia di esaurirsi prima che la tecnologia possa dimostrare il proprio valore.
- Gli utenti capiscono subito qual è l'ambito e lo scopo dell'agente? L'ambiguità dell'ambito è una delle fonti più comuni di deriva tra sviluppo e produzione. Gli utenti che non comprendono cosa un agente possa e non possa fare ne metteranno alla prova i limiti in modi che la suite di valutazione non aveva previsto. Un agente con un ambito ben definito stabilisce le aspettative fin dal primo messaggio e gestisce con efficacia le richieste fuori ambito.
- Come si presentano le interazioni positive e quelle negative, ed è possibile codificarle in un insieme concreto di criteri di valutazione? Una buona interazione non è semplicemente quella in cui l'agente completa l'attività, ma quella in cui l'utente si sente ascoltato, il trasferimento a un operatore avviene al momento giusto e il risultato è in linea con gli obiettivi aziendali. I criteri di valutazione rientrano in due categorie: metriche quantitative rilevate dalla piattaforma, come il tasso di completamento delle attività e il tasso di escalation, e criteri basati sulle trascrizioni, che richiedono l'analisi della conversazione stessa. Definire fin dall'inizio i criteri basati sulle trascrizioni offre al team un obiettivo concreto verso cui lavorare. Stabiliscono inoltre una soglia naturale per il go-live. Quando il tuo agente supera costantemente i criteri di valutazione e le metriche della piattaforma si sono stabilizzate, puoi passare alla produzione con fiducia. Senza criteri definiti, il go-live è una valutazione soggettiva.
- Quali sono i compromessi tra prestazioni e controllo, e quale dei due conta di più in questa fase? Maggiore è l'autonomia concessa a un agente, più le interazioni diventano naturali e flessibili, ma maggiore è anche il rischio che operi al di fuori di limiti convalidati. Un controllo più stretto, tramite prompt vincolati e una logica di escalation più rigorosa, riduce questo rischio ma può far apparire l'agente rigido. Nessuno dei due estremi è corretto. Le organizzazioni che impongono vincoli troppo presto finiscono con un IVR glorificato. Quelle che si muovono troppo in fretta prima di aver instaurato fiducia creano un carico per il supporto che supera i vantaggi. Capire dove impostare questo equilibrio in ogni fase di maturità orienterà la configurazione del modello, la logica di escalation e la quantità di conoscenze dell'agente che risiede nel prompt rispetto alle fonti recuperate o strutturate.
Una volta risposto a queste domande, l'organizzazione è pronta a passare dalla strategia all'esecuzione e a definire l'ambito della realizzazione.
Dare basi solide alla realizzazione iniziale
Nel passare all'esecuzione, i team possono attingere a metodologie quasi antiche quanto il software stesso. Il Test Driven Development (TDD) fornisce la struttura per mantenere gli agenti allineati alle metriche principali durante tutta la realizzazione.
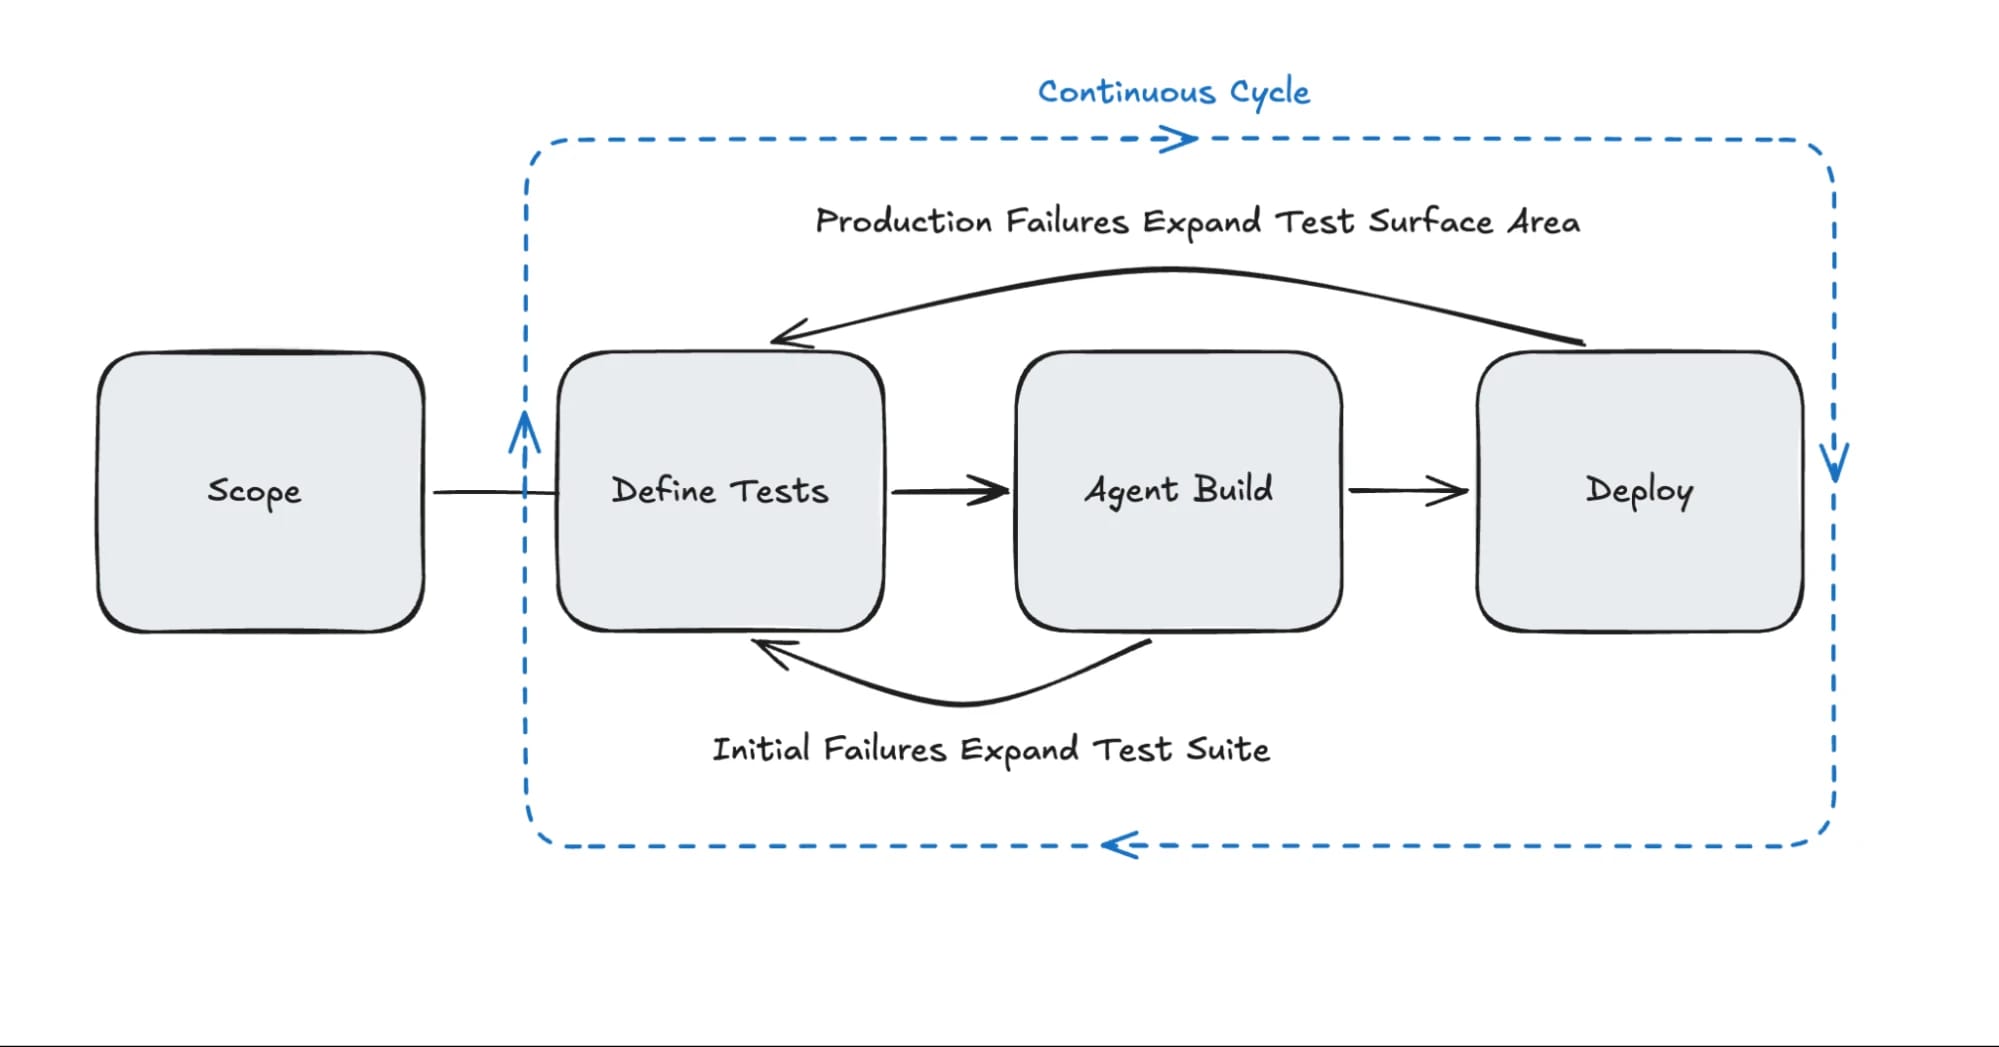
In concreto, i team di sviluppo e gli stakeholder aziendali dovrebbero definire e creare insieme due elementi fondamentali: Criteri di valutazione del successo, che stabiliscono cosa significa un buon risultato sia a livello di singola chiamata sia a livello aggregato, e i Test dell'agente, che verificano ripetutamente i comportamenti specifici che l'agente deve mostrare. I primi si definiscono al meglio analizzando chiamate reali gestite da operatori umani, non appena diventano disponibili. I secondi vengono creati in modo incrementale, partendo da un insieme iniziale di comportamenti previsti e ampliandolo man mano che ne vengono introdotti di nuovi e si scoprono casi limite.
Una volta predisposto un primo insieme di test, lo sviluppo dell'agente inizia dal system prompt. Qui vengono definite le regole, il tono e l'approccio dell'agente: cosa deve fare, cosa non deve fare e come deve comportarsi ai confini del proprio ruolo. Un system prompt ben costruito dipende tanto dalla struttura quanto dal contenuto. Separare le istruzioni in sezioni chiaramente etichettate, mantenere insieme le indicazioni correlate ed evitare formulazioni condizionali fa una differenza significativa nella coerenza del comportamento dell'agente. In questa fase facciamo spesso riferimento alla guida al prompting.
Insieme al system prompt, vengono configurati i componenti principali dell'agente: l'LLM, il modello Text to Speech (TTS) e la voce. La scelta dell'LLM è soprattutto un compromesso tra latenza e prestazioni: i modelli ottimizzati per la velocità in genere sacrificano parte della capacità di ragionamento, e viceversa. Per il TTS, la scelta giusta dipende da ciò che il caso d'uso richiede maggiormente: espressività, bassa latenza o supporto multilingue. La voce, invece, è una decisione tanto di brand quanto tecnica. Definisce come l'organizzazione si presenta a chi chiama, rendendola una delle poche decisioni di configurazione che riguarda tanto i team di brand e marketing quanto gli ingegneri che creano l'agente. Per questo, la selezione della voce può procedere in parallelo con il resto dello sviluppo, anziché diventare un collo di bottiglia all'inizio o alla fine. ElevenAgents offre accesso a oltre 10.000 voci, e se nessuna è adatta, i team possono clonarne una o crearne una propria.
Da qui, gli agenti possono essere estesi facoltativamente con una knowledge base, tool e configurazioni dei canali. Ogni aggiunta sblocca nuove funzionalità, ma introduce anche nuovi aspetti da testare. Che si tratti di integrazione della telefonia, accesso a database esterni o capacità di agire per conto di un cliente, vale la pena verificare a fondo queste decisioni rispetto ai criteri di valutazione prima di ampliare l'ambito. Quando vengono aggiunti tool, il system prompt e la descrizione del tool forniscono indicazioni esplicite su quando e come invocarli, affinché l'agente li utilizzi in modo coerente e nel contesto giusto.
Con queste basi, l'agente è pronto per essere messo alla prova.
Verso la preparazione alla produzione
Con i test e i criteri di valutazione definiti durante la fase iniziale ora eseguiti su un agente realizzato, lo sviluppo diventa un ciclo serrato: aggiungere altri test, individuare gli errori, aggiornare il system prompt o la configurazione ed eseguire di nuovo. La maggior parte degli errori in questa fase non è dovuta al modello, ma al prompt. Un'istruzione che sembrava chiara isolatamente si rivela ambigua quando l'agente la incontra nel mezzo di una conversazione. Emergono casi limite che la suite di test iniziale non aveva previsto. Ciascuno diventa un nuovo test Next Turn, che può essere creato dalla conversazione stessa. Alla domanda su quando smettere di iterare c'è una risposta concreta: quando l'agente supera costantemente i criteri di valutazione in più esecuzioni e le metriche della piattaforma, come il tasso di completamento delle attività e il tasso di escalation, si sono stabilizzate entro intervalli accettabili. Ecco perché definire questi criteri prima di realizzare l'agente è così importante. Senza, la preparazione alla produzione diventa una valutazione soggettiva e il traguardo continua a spostarsi.
In pratica, la maggior parte dei team scopre che un piccolo insieme di schemi di errore ricorrenti è responsabile della maggior parte dei problemi. I più comuni sono l'ambiguità del prompt, quando l'agente riceve istruzioni in conflitto o poco specificate e adotta un comportamento imprevedibile; l'uso improprio dei tool, quando l'agente invoca un tool nel contesto sbagliato o non lo invoca quando dovrebbe; e la deriva nell'escalation, quando l'agente inoltra la conversazione in modo troppo aggressivo o trattiene conversazioni che avrebbe dovuto trasferire. Ognuno di questi problemi ha una correzione a livello di prompt. In genere basta rendere più precisa l'istruzione pertinente, aggiungere un esempio esplicito o modificare la soglia di escalation. Il rischio sta nel non individuarli prima del go-live.
L'errore più comune dei team è considerare una suite di test superata come una garanzia anziché come un segnale. Una suite che copre soltanto il percorso ideale verrà superata facilmente, ma dirà molto poco. Ciò che dà peso ai risultati è la copertura di rifiuti, cambi di direzione nel corso della conversazione, input ambigui e interazioni con uso intensivo di tool. Allo stesso modo, i team che saltano i test di simulazione e si affidano esclusivamente a test a livello di turno non rilevano una classe di errori che emerge soltanto nell'arco di una conversazione completa, come la deriva del contesto, in cui l'agente perde traccia dei turni precedenti, o gli errori cumulativi, in cui un piccolo passo falso all'inizio della chiamata si trasforma in un esito negativo. Una volta risolti gli schemi di errore ricorrenti e quando l'agente gestisce con efficacia, anziché perfettamente, la lunga coda dei casi limite, il valore marginale di ulteriori iterazioni in staging diminuisce. A quel punto, il segnale più prezioso arriva dalle conversazioni reali.
Andare in produzione non significa che l'iterazione sia finita. Significa che l'apprendimento si sposta dai test sintetici alle trascrizioni di produzione. I criteri di valutazione che hanno definito il go-live diventano la base rispetto alla quale vengono misurate le prestazioni in produzione, e il ciclo prosegue da lì.
Cicli di feedback, valutazione e quando smettere di iterare
Una volta definiti ed eseguiti i test, le lacune nella pipeline diventano rapidamente visibili. Attraverso Analisi delle conversazioni, i team possono individuare il momento esatto in cui un'interazione è andata storta e usare questo segnale per creare un nuovo test e capire cosa deve cambiare. Gli interventi più comuni riguardano il prompt: rendere più precise le descrizioni delle tool call, aggiungere istruzioni più esplicite per i casi limite o chiarire condizioni di escalation che nella pratica si sono rivelate ambigue. In alcuni casi, il problema è più profondo e occorre rivedere la configurazione del modello sottostante se la latenza o la qualità del ragionamento non soddisfano le esigenze del caso d'uso.
In questa fase, la disciplina più importante è convalidare i cambiamenti anziché darli per scontati. Una correzione che risolve un errore può introdurne silenziosamente un altro. ElevenAgents supporta il versioning, permettendo ai team di testare nuove iterazioni su una piccola percentuale di utenti prima di estenderle a una popolazione più ampia. Così puoi confermare che i miglioramenti migliorano davvero i risultati, anziché spostare altrove la modalità di errore.
Cosa può andare storto
L'errore con le conseguenze più rilevanti in questa fase è saltare i rollout ramificati e distribuire le modifiche direttamente all'intera popolazione di utenti. Senza rollout graduali, perdi la capacità di isolare l'impatto di ogni modifica e, su larga scala, diventa quasi impossibile capire cosa stia realmente determinando miglioramenti o regressioni nelle metriche della piattaforma. Trattare l'intera base utenti come ambiente di test non è solo rischioso: elimina l'osservabilità necessaria per prendere decisioni sicure in futuro.
Oltre alla strategia di rollout, vale la pena proteggersi da altre due modalità di errore. La prima è dare un peso eccessivo agli errori recenti. Quando una conversazione molto visibile va male, è naturale volerla correggere subito e su vasta scala, ma modifiche reattive del prompt apportate senza eseguire l'intera suite di test causano spesso regressioni in comportamenti prima stabili. Ogni modifica, per quanto piccola, dovrebbe essere trattata come una nuova iterazione e testata di conseguenza. La seconda è la deriva della valutazione. Nel tempo, i team possono abbassare inconsapevolmente l'asticella di ciò che conta come test superato, soprattutto sotto pressione per rilasciare. I criteri di valutazione definiti durante la definizione dell'ambito dovrebbero rimanere il punto di riferimento. Se iniziano a sembrare troppo rigidi, la risposta giusta è rivederli e aggiornarli deliberatamente, non lasciare che gli standard si deteriorino informalmente.
Scalare con fiducia
Aumentare il traffico è una decisione basata sulla fiducia, non sul tempo. Il segnale per espandere è quando l'agente supera costantemente i criteri di valutazione in più esecuzioni dei test, le metriche della piattaforma si sono stabilizzate e i rollout ramificati non hanno mostrato regressioni significative rispetto al gruppo di controllo.
In questa fase, una domanda comune è quanto traffico sia sufficiente per trarre una conclusione. Batch con meno di 100 chiamate per ramo producono una varianza troppo elevata per valutare i risultati in modo affidabile. Un tasso di superamento del 60% su 25 chiamate e uno del 60% su 100 chiamate rappresentano livelli di fiducia molto diversi. Oltre a raggiungere un numero definito, il batch dovrebbe essere abbastanza ampio da far emergere l'intera gamma di input realistici, compresi i casi limite probabili, gli intenti poco comuni e le modalità di errore che compaiono solo con volumi elevati e raramente si osservano in campioni piccoli.
Più traffico amplifica sia ciò che funziona sia ciò che non funziona. Espandersi prima di aver affrontato gli schemi di errore principali crea un carico per il supporto difficile da ridimensionare.
Ripeti il processo
Sapere quando fermarsi è importante quanto sapere cosa correggere. L'iterazione ha rendimenti decrescenti e il segnale giusto per fare una pausa arriva quando l'agente soddisfa costantemente i criteri di valutazione definiti durante la definizione dell'ambito. A quel punto, ulteriori modifiche comportano più rischi che vantaggi.
Cosa significhi «soddisfare costantemente i criteri» varia in base al contesto. I team con accesso limitato ai dati o integrazioni incomplete potrebbero rilevare che tassi di escalation intorno al 50% sono un limite realistico finché tali vincoli non vengono risolti. Dove l'accesso ai dati è solido, le implementazioni con le prestazioni migliori puntano in genere a un completamento delle attività superiore all'80% e a un'escalation inferiore al 20%. Più importante di qualsiasi singolo numero è la stabilità: prestazioni costanti per diverse settimane di traffico in produzione, senza regressioni significative tra le esecuzioni dei test, sono il vero segnale. Quando il guadagno marginale della prossima iterazione è inferiore al rischio di regressione, è il momento di fermarsi.
Questo non significa che il lavoro sia terminato. Quando emergono nuovi requisiti, il processo ricomincia dall'inizio. Le domande sulla definizione dell'ambito della prima realizzazione restano altrettanto rilevanti per la seconda. La differenza è che i team che affrontano un secondo ciclo lo fanno con una suite di test, una baseline di valutazione e un'esperienza operativa che il primo ciclo ha dovuto costruire da zero. Questo vantaggio cumulativo è ciò che distingue le organizzazioni che ottengono valore duraturo dagli agenti vocali agenti da quelle che restano bloccate nella proof of concept.
Conclusione
I team che abbiamo visto colmare il divario tra deviazione e risoluzione sono quelli che definiscono cosa significa un buon risultato prima di iniziare a sviluppare, mantengono la disciplina durante il ciclo di iterazione e trattano ogni implementazione come la base per quella successiva. Gli agenti conversazionali non sono un'implementazione una tantum: le conversazioni reali fanno emergere casi limite che nessuna suite di test può prevedere completamente, e il lavoro di miglioramento non si ferma al go-live.
ElevenAgents è progettato attorno a questa realtà. Agent Testing, Conversation Analysis e rollout ramificati sono le fondamenta che trasformano una proof of concept in un sistema che risolve davvero i problemi dei clienti su larga scala, non si limita a deviarli. È questo il divario che vale la pena colmare.


