वेबिनार सारांश: अपने टेक्स्ट चैटबोट को इंसानों जैसी आवाज़ दें
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
चैट एजेंट एंटरप्राइज़ सॉफ़्टवेयर स्टैक का एक सामान्य हिस्सा बन गए हैं। ज़्यादातर कंपनियों के पास एक है या वे एक बना रही हैं। लेकिन कम ही लोगों ने यह समझा है कि जब यूज़र सिर्फ़ बात करना चाहता हो, तब क्या होता है।
वॉइस इंटरैक्शन को ऐसे तरीकों से बदलती है जो सिर्फ़ सुविधा से कहीं आगे जाते हैं। यूज़र अपनी झुंझलाहट, जल्दबाज़ी और उलझन को टोन के ज़रिए व्यक्त करते हैं, जिन्हें टेक्स्ट पूरी तरह हटा देता है। "मेरा ऑर्डर नहीं आया" टाइप करने वाला ग्राहक और यही बात सुनाई देने वाली घबराहट के साथ कहने वाला ग्राहक अलग-अलग संकेत दे रहे हैं — और जो एजेंट सिर्फ़ ट्रांसक्रिप्ट पढ़ सकता है, उसके पास केवल आधी जानकारी होती है।
अब ज़्यादातर टीमें यह नहीं पूछ रही हैं कि वॉइस जोड़नी है या नहीं, बल्कि यह कि जो कुछ पहले से काम कर रहा है उसे दोबारा बनाए बिना यह कैसे किया जाए।
इस लाइव वर्कशॉप: अपने टेक्स्ट चैटबॉट को इंसानों जैसी आवाज़ दें में, Paul Asjes (डेवलपर एक्सपीरियंस), Bhargavi Bhatt (कस्टमर एक्सपीरियंस) और Fergal Burnett (प्रोडक्ट मार्केटिंग, ElevenAPI) ने मौजूदा एजेंट में वॉइस जोड़ने की तकनीकी वास्तविकताओं और एक काम करने वाला इंटीग्रेशन वास्तव में कैसा दिखता है, इस पर चर्चा की।
वॉइस के साथ बनाना जितना दिखता है, उससे ज़्यादा मुश्किल क्यों है
मुख्य चुनौतियों में से एक है टर्न-टेकिंग। इंसान स्वर, लय और संदर्भ से समझ जाते हैं कि कोई बोलना खत्म कर चुका है। लेकिन वॉइस एक्टिविटी डिटेक्शन (मानक तरीका) सिर्फ़ चुप्पी का पता लगाता है।
अक्सर नतीजा ऐसा सिस्टम होता है जो हर ठहराव को बोलने का निमंत्रण मान लेता है: जो बीच में टोकता है, विचार पूरा होने से पहले काट देता है और स्वाभाविक हिचकिचाहट को पूरा वाक्य समझकर जवाब देता है।
तकनीकी रूप से यह काम करता है, लेकिन बातचीत के लिहाज़ से यह टूटा हुआ है।
संदर्भ समस्या का दूसरा हिस्सा है। हर टर्न पर LLM को बातचीत का इतिहास भेजना ज़रूरी है, लेकिन काफ़ी नहीं है। वही शब्द बोलने के तरीके के आधार पर अलग मतलब रखते हैं — राहत के साथ कहा गया "मैं ठीक हूँ" और झुंझलाहट के साथ कहा गया "मैं ठीक हूँ" एक ही ट्रांसक्रिप्ट हैं, लेकिन अलग इंटरैक्शन। जो वॉइस सिस्टम इस पहलू को नज़रअंदाज़ करता है, वह हमेशा थोड़ा अस्वाभाविक लगेगा, भले ही अलग-अलग मॉडल कितने ही अच्छे हों।
इंजीनियरिंग का अतिरिक्त काम भी है। अपनी वॉइस ऑर्केस्ट्रेशन संभालने वाली टीमों को टर्न-टेकिंग लॉजिक, इंटरप्शन हैंडलिंग और लेटेंसी प्रोफाइलिंग लगातार बनाए रखनी पड़ती है। यह एक बार बनाकर खत्म होने वाला काम नहीं है।
मौजूदा एजेंट में वॉइस कैसे जोड़ें
सबसे साफ़ तरीका डुअल WebSocket आर्किटेक्चर है।
- एक कनेक्शन क्लाइंट और ElevenLabs API के बीच चलता है, और दूसरा आपके सर्वर और ElevenLabs API के बीच
- यूज़र माइक्रोफ़ोन में बोलता है, ऑडियो ElevenLabs API को भेजा जाता है, जहाँ उसे ट्रांसक्राइब करके आपके सर्वर को भेज दिया जाता है
- आपका सर्वर ElevenLabs API से मिला पूरा बातचीत इतिहास LLM को देता है और स्ट्रीम किया गया जवाब ऑडियो सिंथेसिस के लिए वापस भेजा जाता है
- यह LLM के जनरेट करना पूरा करने से पहले शुरू हो सकता है — जिससे फ़र्स्ट-बाइट लेटेंसी कम रहती है
मुख्य इंटीग्रेशन पॉइंट onTranscript मेथड है, जो हर टर्न के अंत में ट्रिगर होता है और बातचीत का पूरा इतिहास LLM को भेजता है।
सेशन शुरू होने पर contextualUpdate यूज़र के वॉइस पर स्विच करने से पहले बातचीत के टेक्स्ट हिस्से में जो हुआ था, उसे आगे ले जाता है — इसी से एक ही एजेंट संदर्भ खोए बिना, दोनों मोडैलिटी में काम कर पाता है।
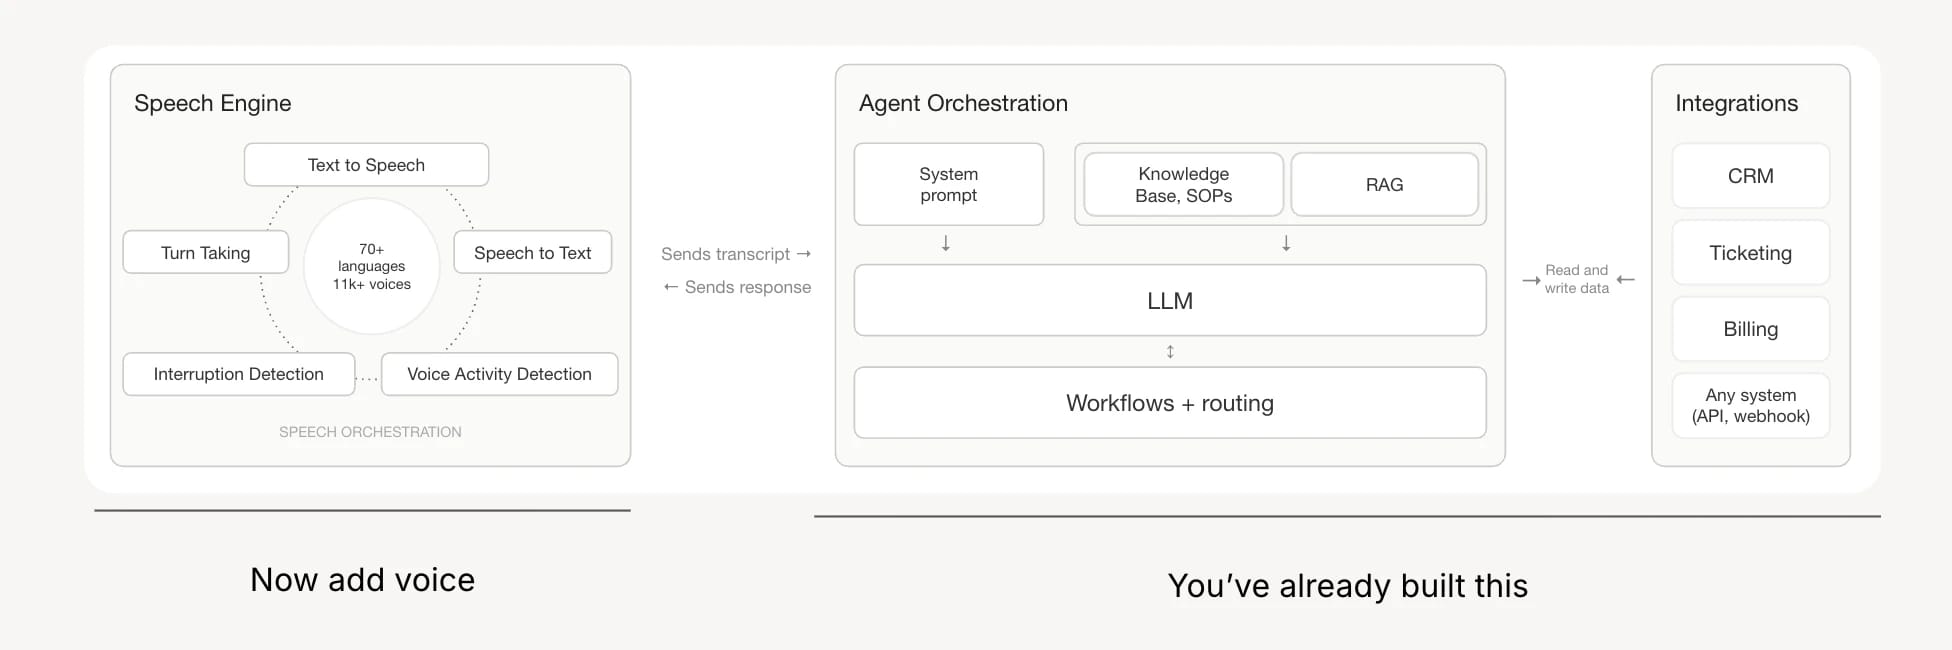
बनाते समय कुछ बातें ध्यान में रखें:
- चैट के मुकाबले वॉइस में LLM का चुनाव ज़्यादा अहम है। डीप रीजनिंग मॉडल में ऐसे ठहराव आते हैं जो ऑडियो में अस्वाभाविक हिचकिचाहट जैसे लगते हैं, भले ही जवाब की क्वालिटी बेहतर हो। रीयल-टाइम वॉइस में, महसूस होने वाली क्वालिटी के मामले में तेज़ मॉडल लगभग हमेशा बेहतर होते हैं।
- ऑडियो के लिए WebSockets के बजाय WebRTC इस्तेमाल करें। WebRTC में इको और नॉइज़ कैंसलेशन पहले से मौजूद होते हैं, जो मोबाइल या शोर वाले माहौल में खास तौर पर अहम हैं। ऑडियो ट्रांसपोर्ट के लिए WebSockets इस्तेमाल करने का मतलब है कि आपको यह खुद संभालना होगा।
- यूज़र्स से भाषा चुनने के लिए न कहें। इससे बातचीत का प्रवाह टूटता है। बोलने के शुरुआती कुछ सेकंड से भाषा पहचानकर उसे लॉक कर देना बेहतर पैटर्न है — और यूज़र से कुछ कराए बिना सहज रूप से भाषा बदलने देता है।
- अपने टर्न-टेकिंग मॉडल को LLM से अलग रखें। यूज़र ने बोलना कब खत्म किया, यह तय करने के लिए LLM का इस्तेमाल हर टर्न में लेटेंसी और लागत बढ़ाता है। एक समर्पित टर्न-टेकिंग मॉडल इसे ज़्यादा तेज़ी और सटीकता से संभालता है, इसलिए आर्किटेक्चर में इसे अलग कंपोनेंट मानना सही है।
कितना इन्फ्रास्ट्रक्चर खुद संभालें
सही जवाब इस पर निर्भर करता है कि आपके पास पहले से क्या है। अगर आपके पास काम करने वाला चैट एजेंट है, तो उसके ऊपर वॉइस लेयर जोड़ना (अपने LLM, ऑर्केस्ट्रेशन और बिज़नेस लॉजिक को बरकरार रखते हुए) आम तौर पर सबसे तेज़ और कम जोखिम वाला रास्ता है।
आप कुछ भी दोबारा नहीं बना रहे हैं। आप पहले से काम कर रही चीज़ में एक ऑडियो इंटरफ़ेस जोड़ रहे हैं।
अगर ज़रूरतों में टेलीफ़ोनी, डिप्लॉयमेंट चैनल मैनेजमेंट, बिल्ट-इन टेस्टिंग और एनालिटिक्स शामिल हों, तो स्टैक का ज़्यादा हिस्सा वॉइस एजेंट प्लेटफ़ॉर्म को सौंपना समझदारी है। दोनों तरीके एक-दूसरे के विरोधी नहीं हैं — टीमें हल्की वॉइस लेयर से शुरू कर सकती हैं और उपयोग का मामला विकसित होने पर प्लेटफ़ॉर्म क्षमताएं जोड़ सकती हैं।
डेमो: मौजूदा चैटबॉट में वॉइस जोड़ना
इस डेमो में एक यूज़र टेक्स्ट-आधारित ट्रैवल प्लानिंग चैटबॉट के साथ बातचीत के बीच में है और जापान यात्रा के लिए इलाकों और खाने की सिफ़ारिशें मांग रहा है।
हमने क्या कवर किया:
- अंडरलाइंग एजेंट में कोई बदलाव किए बिना चैटबॉट में वॉइस लेयर जोड़ी गई।
- यूज़र ने बातचीत के बीच में टाइप करने से बोलने पर स्विच किया — एजेंट ने दोनों मोडैलिटी में पूरा संदर्भ बनाए रखा।
- यूज़र ने डच में बात की; एजेंट ने भाषा में बदलाव अपने-आप पहचान लिया
- जब एजेंट को बीच में रोका गया और वाक्य के बीच में वापस अंग्रेज़ी पर स्विच करने को कहा गया, तो उसने ऐसा किया — और बिना कहे हल्के डच लहजे में जवाब पूरा किया।
- पूरी बातचीत में, इंटरप्शन डिटेक्शन की मदद से यूज़र एजेंट की बारी खत्म होने का इंतज़ार किए बिना स्वाभाविक रूप से उसके ऊपर बोल सका।
यह क्यों मायने रखता है:
डेमो में कोई खास तौर पर बनाया गया वॉइस एजेंट नहीं दिखाया गया था। इसमें एक पहले से काम कर रहे टेक्स्ट एजेंट पर वॉइस लेयर जोड़ी गई थी। संदर्भ हैंडलिंग, भाषा पहचान और इंटरप्शन व्यवहार, सभी वॉइस लेयर से आए थे — अंडरलाइंग टेक्स्ट एजेंट में कोई बदलाव नहीं हुआ था।
पूरा सेशन देखें
पूरा वेबिनार यहाँ देखें।
Paul ElevenLabs में डेवलपर ग्रोथ टीम का हिस्सा हैं और वेलेंसिया, स्पेन में रहते हैं। यहां वह डेवलपर एक्सपीरियंस इंजीनियर के तौर पर प्लेटफ़ॉर्म के लिए एडवोकेसी और टूलिंग पर काम करते हैं। ElevenLabs से पहले, उन्होंने Stripe में डेवलपर रिलेशंस संभाला, WorkOS में DX किया, और कई सालों तक फुल-स्टैक वेब ऐप्लिकेशन और डेवलपर टूलिंग बनाई।