टेक्स्ट टू स्पीच API इंटीग्रेशन: स्ट्रीमिंग, बैचिंग, रिट्राई
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
टेक्स्ट टू स्पीच API को इंटीग्रेट करना आसान है… यानी कुछ अहम फैसले लेने के बाद: कौन-सा ट्रांसफर मोड इस्तेमाल करें, मॉडल और आउटपुट फ़ॉर्मैट कैसे चुनें, स्ट्रीम कैसे करें, concurrency limit पार किए बिना ज़्यादा वॉल्यूम कैसे संभालें, कैश और रीट्राई कैसे करें ताकि एक ही ऑडियो को रेंडर करने के लिए दो बार भुगतान न करना पड़े, और किसी दूसरे प्रोवाइडर के मुकाबले time-to-first-byte को कैसे बेंचमार्क करें।
टेक्स्ट टू स्पीच API इंटीग्रेशन में आपकी मदद के लिए, हमने इन सभी आर्किटेक्चरल फैसलों और उनके लिए क्या करना है, इसे विस्तार से बताया है। यह गाइड आपको ElevenLabs टेक्स्ट टू स्पीच API को इंटीग्रेट और स्केल करने में मदद करेगी। इसमें ऐसे कोड स्निपेट हैं जिन्हें आप प्रोडक्शन में पेस्ट करके तुरंत शुरू कर सकते हैं।
यहाँ बताए गए कॉन्सेप्ट्स की पूरी जानकारी के लिए, हमारी इन गाइड्स को देखें: ऑडियो स्ट्रीमिंग को समझना, लेटेंसी ऑप्टिमाइज़ करना, और ElevenLabs मॉडल ओवरव्यू।
सारांश
- एक ही ElevenLabs टेक्स्ट टू स्पीच API endpoint है, जिसे आप तीन तरीकों से एक्सेस कर सकते हैं: batch convert, HTTP stream और stream-input WebSocket।
- HTTP में हर in-flight request आपकी concurrency limit में गिना जाता है, जबकि WebSocket में केवल active generation गिना जाता है।
- अपने parallelism को प्लान की limit से थोड़ा नीचे रखें और ऑडियो आउटपुट को प्रभावित करने वाले हर पैरामीटर का hash कैश करें, ताकि एक ही टेक्स्ट के लिए कभी दो बार बिल न हो।
- Concurrency की सीमा तक पहुँचने से पहले धीमा होने के लिए, 429 और 5xx को exponential backoff और full jitter के साथ रीट्राई करें।
टेक्स्ट टू स्पीच API इंटीग्रेट करने के तीन तरीके
टेक्स्ट टू स्पीच का एक ही endpoint है, लेकिन उसे इंटीग्रेट करने का तरीका आपकी लेटेंसी, जटिलता और लागत तय करता है।
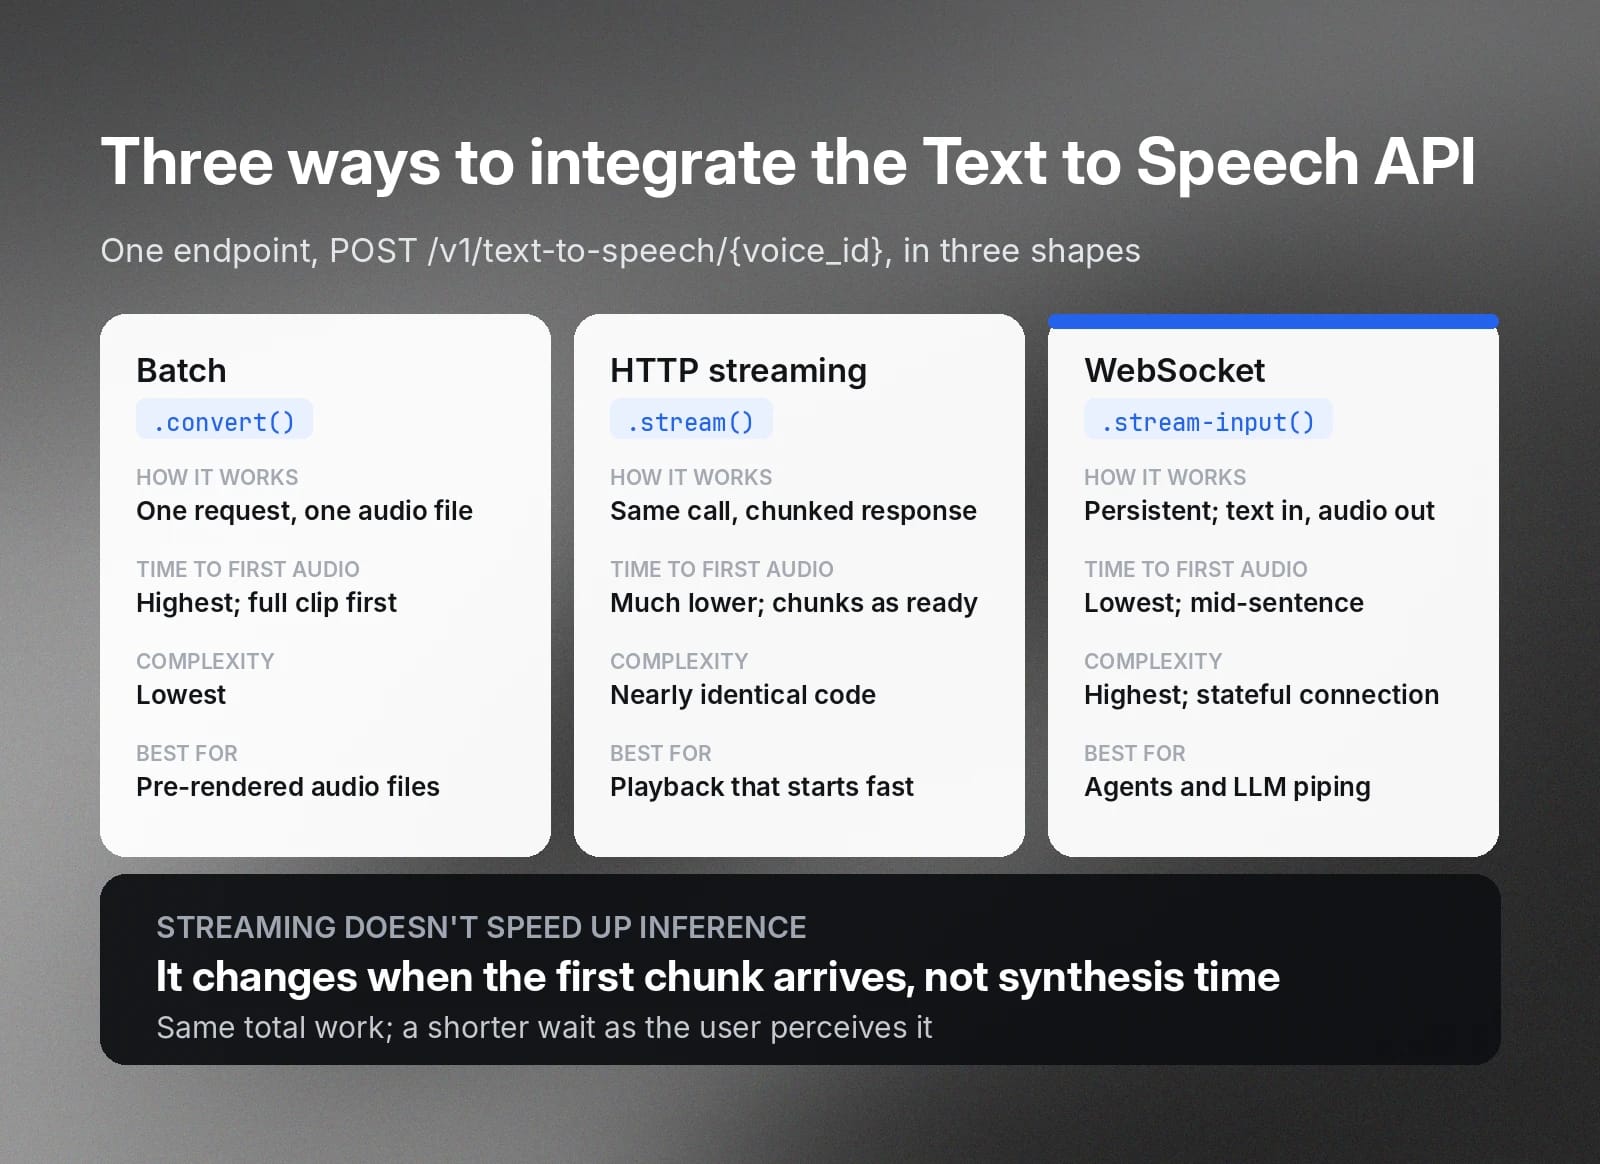
वही POST /v1/text-to-speech/{voice_id} call तीन रूपों में काम करता है और हर रूप थोड़ा अलग काम के लिए उपयुक्त है। टेक्स्ट टू स्पीच API को इंटीग्रेट करने के तीनों तरीकों का विवरण यहाँ है:
- Batch (convert) सबसे आसान इंटीग्रेशन है: आप एक request भेजते हैं और बदले में एक ऑडियो response पाते हैं। यह सबसे कम जटिल विकल्प है और इसका time-to-first-audio सबसे ज़्यादा होता है, क्योंकि कोई byte वापस आने से पहले पूरी क्लिप synthesize होती है।
- HTTP streaming (stream) में request वही रहता है, लेकिन response chunks में मिलता है: आप path में /stream जोड़ते हैं, stream method call करते हैं, और ऑडियो chunked response के रूप में लौटता है। कोड लगभग एक जैसा रहता है, लेकिन महसूस होने वाली लेटेंसी काफी कम होती है।
- WebSocket (stream-input) एक persistent connection बनाए रखता है: आप टेक्स्ट को धीरे-धीरे भेजते हैं और साथ ही ऑडियो chunks वापस पाते हैं। यह interactive agents और LLM के tokens बनते ही, वाक्य पूरा होने से पहले, उसके output को speech में बदलने के लिए बनाया गया है।
स्ट्रीमिंग मॉडल से ऑडियो तेज़ी से जनरेट नहीं करवाती; inference time में कोई बदलाव नहीं होता। स्ट्रीमिंग सिर्फ यह बदलती है कि आपको पहला chunk कब मिलता है: पूरी क्लिप बनने से पहले ही उसे भेज दिया जाता है, इसलिए कुल काम समान होने पर भी यूज़र को कम इंतज़ार महसूस होता है।
Batch बनाम स्ट्रीमिंग बनाम WebSocket: निर्णय तालिका
इन तीन तरीकों में से चुनते समय कई बातों पर विचार करना चाहिए।
एक त्वरित गाइड: offline rendering के लिए batch चुनें, जिस ज्ञात टेक्स्ट का यूज़र इंतज़ार कर रहा हो उसके लिए HTTP streaming, और agents व live LLM-to-speech के लिए WebSocket चुनें।
नीचे दी गई तालिका उन पहलुओं में trade-offs बताती है जो बड़े स्तर पर अहम होते हैं।
HTTP में, चाहे batch हो या streaming, हर in-flight request अपनी पूरी अवधि तक आपके प्लान की concurrency limit में गिना जाता है। WebSocket में केवल वह समय गिना जाता है जब मॉडल सक्रिय रूप से ऑडियो जनरेट कर रहा हो; खुला हुआ लेकिन idle socket आम तौर पर लगभग कोई लागत नहीं जोड़ता।
एक cascaded voice agent के लिए, जो पूरी बातचीत के दौरान connection खुला रखता है लेकिन सिर्फ agent की बारी में ऑडियो जनरेट करता है, यह अंतर बड़ा है। इसी वजह से agents बनाते समय WebSockets का इस्तेमाल किया जाता है। पूरा protocol रियलटाइम टेक्स्ट टू स्पीच WebSocket गाइड में दिया गया है।
मॉडल और आउटपुट फ़ॉर्मैट चुनना
आपके TTS API इंटीग्रेशन से मिलने वाले ऑडियो को दो विकल्प आकार देते हैं। पहला, मॉडल, जो गुणवत्ता और गति तय करता है। दूसरा, आउटपुट फ़ॉर्मैट, जो container, bitrate और sample rate तय करता है।
शुरुआत से ही इन दोनों को सही चुनने पर लेटेंसी और टेलीफोनी compatibility जैसी आगे की चीज़ें सही बैठती हैं।
मॉडल्स
हम कई टेक्स्ट टू स्पीच मॉडल उपलब्ध कराते हैं। इन्हें सबसे अच्छे से सबसे कम अच्छे क्रम में नहीं रखा गया है; हर मॉडल अलग trade-offs करता है।
ध्यान दें कि ~75ms का आंकड़ा representative conditions में मॉडल inference का है; इसमें नेटवर्क और एप्लिकेशन लेटेंसी शामिल नहीं है। लंबे input और load के साथ यह बढ़ता है। हमेशा अपने एप्लिकेशन से मापें, किसी benchmark नंबर से नहीं।
Flash मॉडल छोटे होते हैं और inference time घटाने के लिए ज़्यादा aggressive approximations का उपयोग करते हैं। Eleven v4 और Multilingual v2 बड़े मॉडल हैं, जो बेहतर आउटपुट देने के लिए प्रति character अधिक समय लेते हैं।
रियल-टाइम या agent path के लिए eleven_flash_v2_5 इस्तेमाल करें; यह सबसे कम लेटेंसी वाला multilingual विकल्प है। narration, ऑडियोबुक्स, या मार्केटिंग वॉइसओवर के लिए, स्थिर और उच्च fidelity चाहिए तो eleven_multilingual_v2 इस्तेमाल करें, या अधिकतम expressiveness और emotional range चाहिए तो eleven_v4।
जब उच्चारण अहम हो, जैसे फोन नंबर, तारीख या मुद्रा के लिए, तो टेक्स्ट के API तक पहुँचने से पहले अपने एप्लिकेशन में ही नंबर normalization करें। जिस बोली जाने वाली शैली में चाहिए, उसे पूरा लिखें।
खुद normalization करने से अलग-अलग मॉडल्स में उच्चारण अनुमानित रहता है और ऐसे model-specific defaults पर निर्भरता नहीं रहती जो बदल सकते हैं।
आउटपुट फ़ॉर्मैट
output_format parameter मिलने वाले ऑडियो का container, sample rate और bitrate नियंत्रित करता है। जिन values का आप सबसे ज़्यादा उपयोग करेंगे:
वॉइस सेटिंग्स
नीचे दी गई सेटिंग्स जनरेट की गई speech की delivery नियंत्रित करती हैं:
- Stability: consistency और expressiveness को नियंत्रित करती है। कम values ज़्यादा विविध और expressive speech देती हैं, जबकि ज़्यादा values अधिक स्थिर और अनुमानित delivery देती हैं।
- SimilarityBoost: यह नियंत्रित करता है कि आउटपुट reference voice से कितना करीब मेल खाता है।
- Style: बढ़ाने पर वॉइस की स्वाभाविक बोलने की शैली को ज़्यादा उभारता है।
- useSpeakerBoost: कम लेटेंसी लागत के साथ मूल speaker से समानता को बेहतर करता है।
- Speed: 1.0 की default value के आसपास delivery की गति समायोजित करता है।
इन सेटिंग्स में Stability का आम तौर पर महसूस की जाने वाली गुणवत्ता पर सबसे ज़्यादा प्रभाव पड़ता है। कम values ज़्यादा expressive लेकिन कम consistent आउटपुट देती हैं, जबकि ज़्यादा values consistency और predictability को प्राथमिकता देती हैं।
वॉइस चुनते समय, सबसे कम लेटेंसी वाला संयोजन Flash के साथ एक Instant वॉइस क्लोन या default voice है; Professional Voice Clones बेहतरीन लगते हैं, लेकिन हर generation में अतिरिक्त overhead जोड़ते हैं, जिसका आपको ध्यान रखना चाहिए।
इस गाइड में sample voice id JBFqnCBsd6RMkjVDRZzb (George) है।
स्ट्रीमिंग इंटीग्रेशन (HTTP और WebSocket)
इस सेक्शन में हम टेक्स्ट टू स्पीच API इंटीग्रेशन के व्यावहारिक मूल भाग को समझते हैं। इसमें SDK इंस्टॉल करना, stream खोलना और आते ही ऑडियो को consume करना शामिल है। HTTP path ज़्यादातर web और app playback के लिए है, जबकि WebSocket path agents और live LLM output के लिए है।
इन दोनों तरीकों में यह माना गया है कि आपने नीचे दिए अनुसार ElevenLabs client initialize कर लिया है।
स्ट्रीमिंग path एक stream खोलता है और chunks आते ही उन्हें consume करता है। voiceId पहला positional argument है, जिसके बाद camelCase keys (modelId, outputFormat, voiceSettings) वाला options object आता है:
WebSocket variant के लिए wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input से कनेक्ट करें। अपनी voice settings और शुरुआत में एक space वाला पहला message भेजें, फिर उपलब्ध होते ही text messages भेजें और उन JSON frames को पढ़ें जिनके audio field में base64-encoded chunks होते हैं।
हाई throughput के लिए batching और concurrency limits
हाई-throughput इंटीग्रेशन concurrency से नियंत्रित होता है, यानी एक ही समय में ऑडियो जनरेट करने वाली requests की संख्या से। हर प्लान में model family के हिसाब से एक limit होती है।
हर प्लान में अलग concurrency limit शामिल है:
- Free: 4 concurrent Flash requests।
- Starter: 6 concurrent Flash requests।
- Creator: 10 concurrent Flash requests।
- Pro: 20 concurrent Flash requests।
- Scale और Business: 30 concurrent Flash requests; Enterprise limits कस्टम होती हैं।
Multilingual v2 की limits ऊपर बताई गई limits की लगभग आधी हैं।
Bounded pool एक साथ चलने वाली requests की संख्या सीमित करके इसे कम करता है:
MAX_CONCURRENCY को अपने प्लान की limit के बराबर रखने के बजाय उससे थोड़ा कम रखें। यह अतिरिक्त जगह उसी key को share करने वाले दूसरे traffic को संभालती है और आपको उस threshold से नीचे रखती है जहाँ 429 लौटता है।
Character limits और लंबे टेक्स्ट को विभाजित करना
हर मॉडल एक request में स्वीकार किए जाने वाले characters की संख्या सीमित करता है। किसी भी long-form integration में टेक्स्ट को विभाजित करके ऑडियो को फिर से जोड़ना होता है।
हर मॉडल के लिए प्रति-request character limits ये हैं:
- Flash v2.5: प्रति request अधिकतम 40,000 characters स्वीकार करता है।
- Flash v2: प्रति request अधिकतम 30,000 characters स्वीकार करता है।
- Multilingual v2: प्रति request अधिकतम 10,000 characters स्वीकार करता है।
- Eleven v3: प्रति request अधिकतम 5,000 characters स्वीकार करता है।
- Eleven v4: प्रति request अधिकतम 10,000 characters स्वीकार करता है।
इससे लंबा टेक्स्ट कई requests में बाँटना होगा। वाक्य की सीमाओं पर विभाजित करने की कोशिश करें, ताकि chunks के बीच की जोड़ पर prosody बनी रहे।
Chunks को क्रम से रेंडर करें और ऑडियो को जोड़ दें। ऐसे long-form narration में जहाँ हर chunk स्वतंत्र हो, दोनों हिस्से सीधे साथ काम करते हैं: splitText output को ऊपर दिए bounded pool में भेजें और बाकी काम उसे करने दें।
Caching और idempotency
टेक्स्ट टू स्पीच आउटपुट इतना deterministic होता है कि उसी टेक्स्ट को उसी voice, model और settings के साथ फिर से रेंडर करना बेकार है। ऑडियो को प्रभावित करने वाले inputs के hash को key बनाकर result कैश करें; वही key retries में idempotency token के रूप में भी काम करती है।
दोनों काम ऐसे करें।
इसे काम करने लायक बनाने वाला नियम यह है कि ऑडियो बदलने वाला हर parameter key में होना चाहिए, जिसमें outputFormat और voice settings शामिल हैं। सही तरीके से करने पर वही key idempotency token भी बन जाती है। जब कोई client पहले से सफल request को रीट्राई करता है, तो दोबारा जनरेट करने के बजाय आप cached bytes लौटाते हैं।
Error handling और rate limits (429s)
प्रोडक्शन client को backoff और jitter के साथ retries की ज़रूरत होती है, साथ ही status code के अनुसार अलग handling की भी, क्योंकि कुछ failures को रीट्राई करना सही है और कुछ को नहीं।
नीचे दी गई तालिका हर status के लिए सही action बताती है और यह सेक्शन समझाता है कि 429 hard wall के बजाय soft limit क्यों है।
429 कोई hard wall नहीं है और इसका mechanism समझना मददगार है। Concurrency limit पार होने पर requests को पहले priority के आधार पर queue किया जाता है, जिससे आम तौर पर लगभग 50ms जुड़ता है। उसके बाद भी capacity पार होने पर ही आपको 429 मिलता है।
Response में current-concurrent-requests और maximum-concurrent-requests headers भी होते हैं, जो आपकी live headroom दिखाते हैं। इन्हें पढ़कर आप limit तक पहुँचने से पहले धीमा कर सकते हैं।
अगर आपको बेहतर retry behavior के बजाय ज़्यादा headroom चाहिए, तो अपना प्लान अपग्रेड करें। Enterprise ग्राहक अपने account manager के ज़रिए अधिक limits का अनुरोध कर सकते हैं।
लेटेंसी और time-to-first-byte का बेंचमार्किंग
लेटेंसी आपके region, input और मौजूदा load पर निर्भर करती है। इसलिए भरोसे लायक लेटेंसी नंबर केवल वही है जिसे आपने अपने environment से मापा हो।
यह सेक्शन Flash streaming endpoint के लिए time-to-first-byte (TTFB) देता है और इसे इस तरह बनाया गया है कि आप इसी harness को किसी दूसरे provider पर चलाकर समान परिस्थितियों में तुलना कर सकें।
इसे प्रकाशित परिणाम नहीं, एक methodology समझें। कोई एक run किसी चीज़ की गारंटी नहीं है।
टेक्स्ट टू स्पीच API इंटीग्रेशन की लेटेंसी बेंचमार्क करते समय ये बातें अहम हैं:
- Network round-trip शामिल करें: TTFB आपकी location और provider के सबसे नज़दीकी cluster पर निर्भर करता है, इसलिए वहीं से test चलाएँ जहाँ आपके servers आम तौर पर चलते हैं।
- Warmup run हटाएँ: Cold connection पर पहली request धीमी होती है और आपके नंबरों को प्रभावित कर सकती है।
- Inputs स्थिर रखें: Input length, voice, model और load सभी result को बदलते हैं, इसलिए providers के बीच इन्हें एक जैसा रखें।
- Distribution रिपोर्ट करें: नंबर हर run में बदलते हैं, इसलिए एक value के बजाय median और p95 प्रकाशित करें।
इन बातों को ध्यान में रखने के बाद, आप बेंचमार्क करने के लिए तैयार हैं।
किसी दूसरे provider से तुलना करने के लिए, उसी आकार का एक function लिखें। फिर दोनों को एक छोटे runner से चलाएँ, जो एक warm-up call हटा दे, लगभग 20 timed samples के बीच पर्याप्त अंतर रखे ताकि वे आपस में टकराएँ नहीं, और milliseconds में median व p95 रिपोर्ट करे।
निष्पक्ष तुलना variables को नियंत्रित करने पर निर्भर करती है।
दोनों providers को एक ही machine और network से चलाएँ—बेहतर होगा कि residential broadband वाले laptop के बजाय उस region के server से चलाएँ जहाँ आप वास्तव में deploy करते हैं। वही input text इस्तेमाल करें और ऑडियो छोटा रखें, ताकि generation length के बजाय मॉडल inference नंबर पर हावी रहे। कई runs में median और p95 रिपोर्ट करें, क्योंकि एक अकेला measurement noise है।
ध्यान रखें कि public internet पर TTFB में 20-200ms का network round-trip शामिल होता है, जिसका मॉडल से कोई संबंध नहीं है। हम North America, Europe और Southeast Asia के clusters से सेवा देते हैं और सबसे नज़दीकी cluster तक route करते हैं। इसलिए अपने test client को उसी के अनुसार co-locate करें, वरना आप मुख्य रूप से data center की दूरी को बेंचमार्क कर रहे होंगे।
आपके टेक्स्ट टू स्पीच API इंटीग्रेशन के मुख्य बिंदु
एक प्रोडक्शन टेक्स्ट टू स्पीच API इंटीग्रेशन कुछ असरदार फैसलों पर निर्भर करता है।
अगर आप इन्हें सही कर लें, तो बाकी सब अपने आप सही बैठता है:
- काम के अनुसार मॉडल चुनें: किसी भी interactive काम के लिए Flash v2.5 इस्तेमाल करें और offline rendering के लिए, जहाँ लेटेंसी कम अहम हो, Multilingual v2 या Eleven v4 जैसा उच्च-fidelity मॉडल चुनें।
- जब भी यूज़र इंतज़ार कर रहा हो, stream करें: ज्ञात टेक्स्ट के लिए HTTP streaming और agents के लिए WebSocket इस्तेमाल करें, ताकि idle time आपके concurrency budget में न गिने।
- Parallelism को अपने प्लान की limit तक सीमित रखें: Concurrent requests को प्लान limit से थोड़ा कम रखें और ऑडियो आउटपुट को प्रभावित करने वाले हर parameter के hash पर कैश करें, ताकि उसी ऑडियो के लिए कभी दो बार बिल न हो।
- 429 और 5xx को exponential backoff और full jitter के साथ रीट्राई करें: 429 और 5xx मिलने पर full jitter के साथ back off करें, और limit के कितने करीब हैं यह देखने के लिए concurrency headers पर नज़र रखें।
- लंबे टेक्स्ट को वाक्य सीमाओं पर विभाजित करें: हर मॉडल की character limit के भीतर वाक्य सीमाओं पर विभाजित करें, ताकि prosody जोड़ पर बनी रहे।
और गहराई से जानने के लिए, स्ट्रीमिंग how-to, ऑडियो स्ट्रीमिंग कॉन्सेप्ट, authentication, और client-side उपयोग के लिए single-use tokens देखें।
ElevenAPI के साथ अपना टेक्स्ट टू स्पीच इंटीग्रेशन बनाएं
इस गाइड को पढ़ने के बाद, आपके पास प्रोडक्शन टेक्स्ट टू स्पीच API इंटीग्रेशन के लिए हर ज़रूरी pattern है। Streaming, batching, caching, retries और benchmarking तक, अब आप इसे लागू करने के लिए तैयार हैं।
शुरू करने के लिए टेक्स्ट टू स्पीच API के बारे में और जानें या साइन अप करें और आज ही ElevenAPI के साथ अपनी पहली call करें।
टेक्स्ट टू स्पीच API इंटीग्रेशन FAQ
Tadas Petra एक डेवलपर रिलेशंस इंजीनियर हैं, जो डेवलपर्स को ElevenLabs के प्रोडक्ट्स के साथ काम करने में मदद करते हैं। वह Hungrimind के फाउंडर भी हैं, जो एक डेवलपर एजुकेशन प्लेटफॉर्म है। इससे पहले, वह Agora में लीड डेवलपर एडवोकेट और Zero To Mastery में इंस्ट्रक्टर थे।