Stream conçoit des agents IA multimodaux avec ElevenLabs
- Rédigé par
- Fergal Burnett Small
- Publié
ÉcouterÉcouter cet article
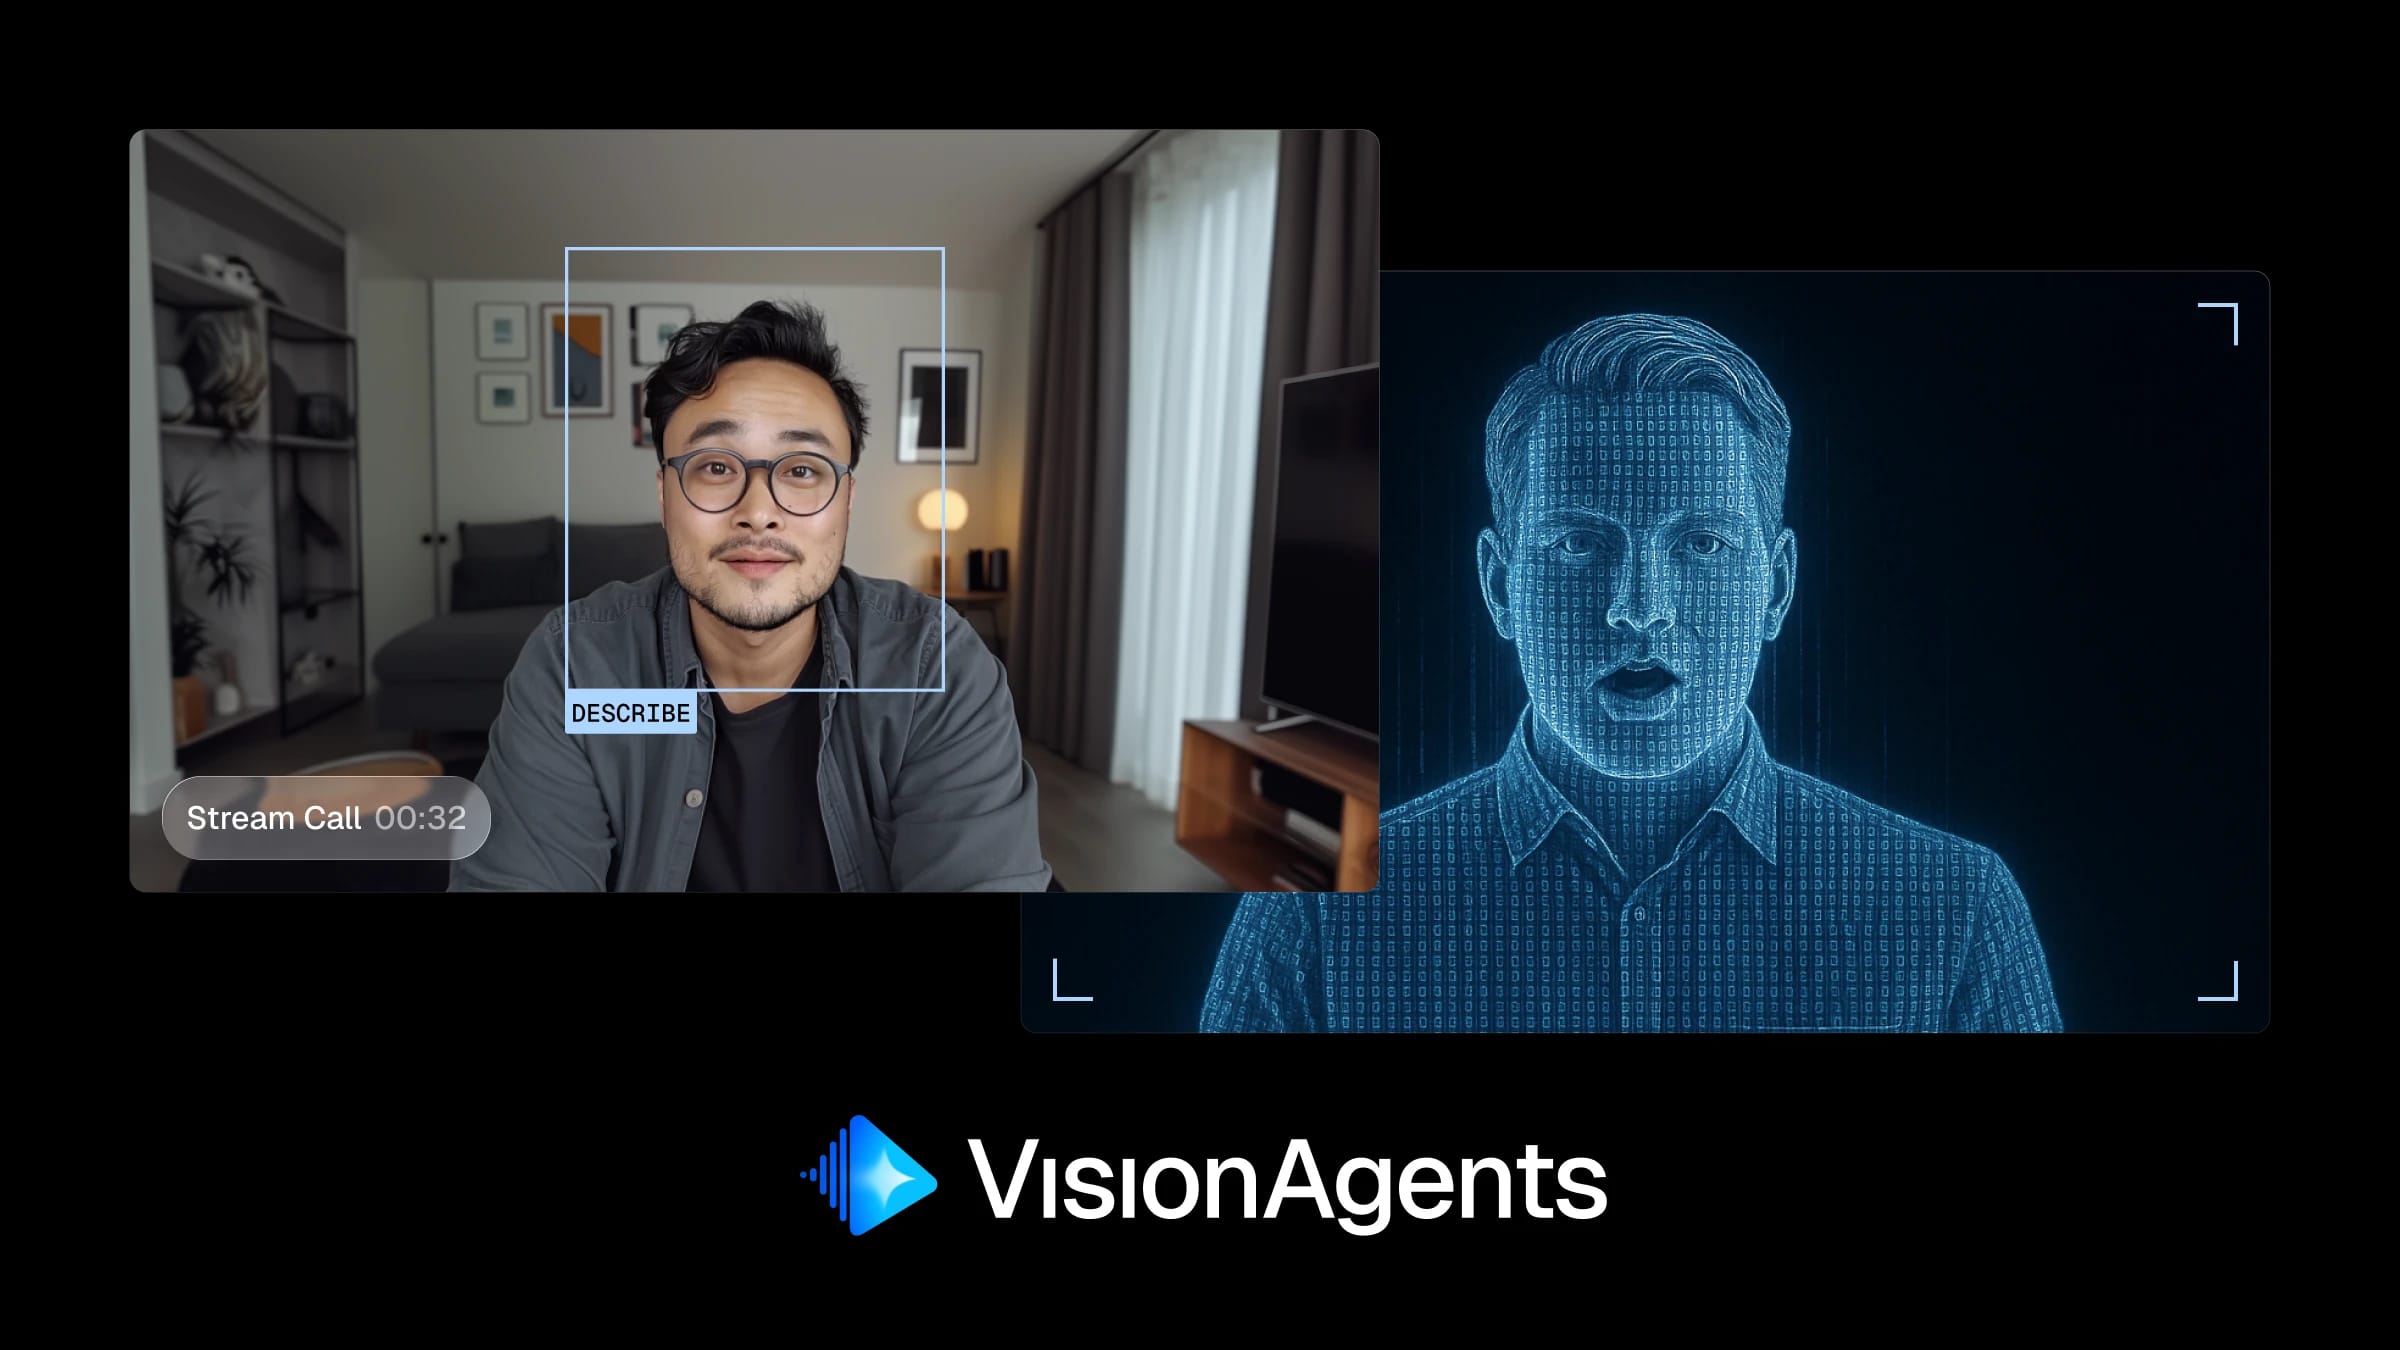
Stream a lancé Vision Agents, un framework open source qui permet aux développeurs de concevoir des expériences IA multimodales à faible latence, associant vidéo, audio et conversation en temps réel. Le framework intègre ElevenLabs Text to Speech pour produire des voix expressives et réactives, favorisant une interaction fluide entre les utilisateurs et les systèmes d’IA.
Des agents multimodaux en temps réel
Vision Agents permet à l’IA de voir, d’entendre et de répondre en temps réel. Conçu sur les SDK vidéo et audio de Stream, ce framework offre aux développeurs une base à faible latence pour prototyper et déployer des expériences d’agents multimodaux.
Lors de l’évaluation de fournisseurs de Text to Speech, Stream a choisi ElevenLabs pour la qualité de ses voix et sa facilité d’intégration. ElevenLabs est désormais l’option vocale principale proposée aux utilisateurs de Stream.
« ElevenLabs nous a permis d’intégrer rapidement de puissantes capacités de synthèse vocale à notre SDK, afin que les Agents puissent répondre en temps réel aux questions des utilisateurs avec des voix expressives ou réagir à ce qu’ils voient. » Neevash Ramdial, directeur marketing chez Stream
Une intégration rapide, fiable et pensée pour les développeurs
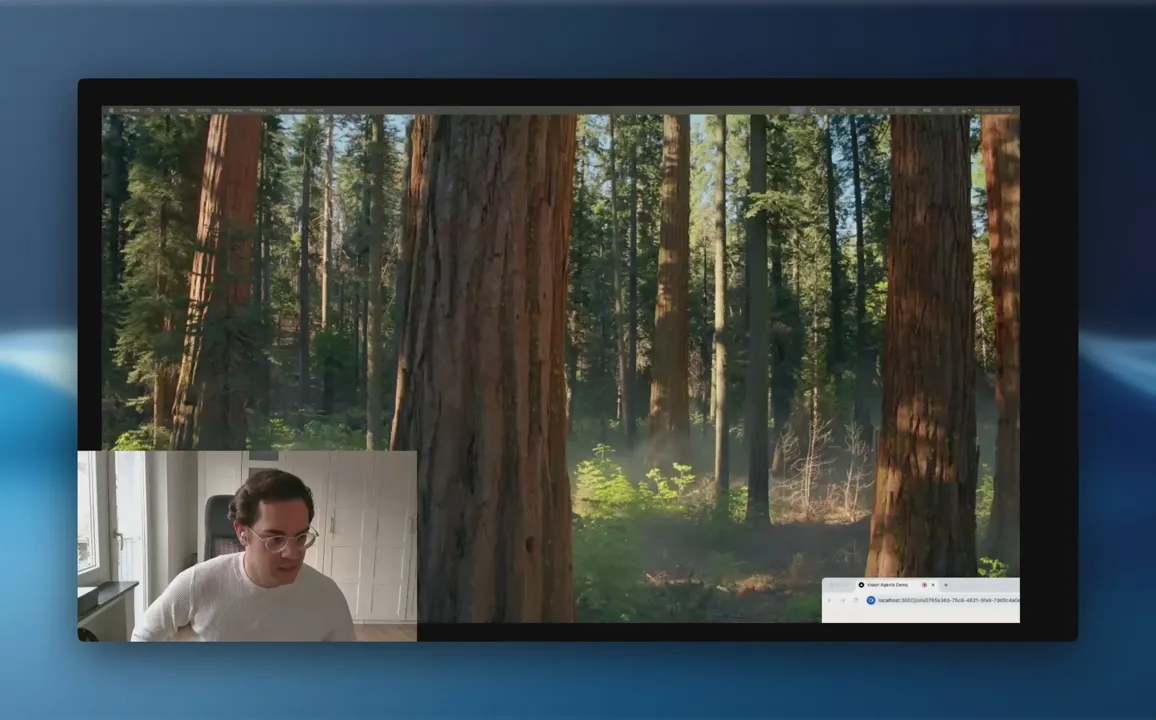
Stream a intégré ElevenLabs à l’ensemble de son code en quelques jours seulement, permettant aux développeurs d’ajouter une sortie vocale réaliste à leurs agents Vision avec un minimum de configuration. L’intégration offre désormais :
- Configuration dix fois plus rapide : la préintégration d’ElevenLabs réduit le temps de configuration vocale de 400 lignes de code à seulement 40.
- Performances à faible latence : la génération vocale rapide d’ElevenLabs, associée au réseau edge mondial de Stream, assure une réactivité naturelle et humaine.
- Une expérience développeur évolutive : les SDK de Stream simplifient la conception, le test et le déploiement d’agents multimodaux.
Construire l’avenir de l’IA multimodale
Les Vision Agents de Stream montrent comment les modèles d’ElevenLabs élargissent les possibilités de l’IA multimodale. En associant la compréhension visuelle à Text to Speech, les développeurs peuvent concevoir des agents qui voient, parlent et écoutent avec une fluidité quasi humaine.
Vous souhaitez concevoir avec Text to Speech ? Contactez-nous ici.
Fergal fait partie de l’équipe Growth et s’occupe de faire découvrir nos recherches et nos produits aux utilisateurs.