
Etiquetas SSML explicadas: cómo controlar las pausas, la pronunciación y el ritmo en texto a voz
- Escrito por
- Jack Limebear
- Publicado
EscucharEscucha este artículo
Speech Synthesis Markup Language (SSML) es un lenguaje de marcado basado en XML que envuelve el texto en etiquetas para indicar a un modelo de texto a voz cómo debe leerlo, incluyendo dónde hacer pausas, cómo pronunciar una palabra y qué frase enfatizar.
Esa capa de control está detrás de buena parte de la voz IA que ya escuchas. Tanto un sistema de respuesta de voz interactiva (IVR) que lee un número de confirmación como un audiolibro con IA cuyo narrador hace una pausa al final de un capítulo dependen de alguna versión de ella. Si has dedicado tiempo a personalizar voz generada por IA, seguramente te hayas encontrado con SSML.
SSML forma parte de la tecnología TTS desde hace más de dos décadas y sigue siendo una pieza clave de cómo muchos proveedores ofrecen TTS. Esta guía explica qué es SSML y exactamente dónde se aplica en la gama de modelos de ElevenLabs, junto con el mejorado sistema de Audio Tags que utilizan Eleven v3 y Eleven v4 para ofrecer texto a voz con un sonido natural de referencia.
Descubre Eleven v4 en acción con Audio Tags
Descubre Eleven v4Resumen
- SSML es un lenguaje de marcado basado en el W3C que se utiliza para controlar las pausas vocales, el énfasis, la pronunciación y el ritmo de la voz sintetizada.
- Los modelos de ElevenLabs, excepto Eleven v3 y Eleven v4, admiten la etiqueta SSML <break> para pausas de hasta 3 segundos.
- Eleven Flash v2 y Eleven Turbo v2 admiten la etiqueta <phoneme> para personalizar la pronunciación en inglés.
- Eleven v3 y Eleven v4 no admiten SSML en absoluto. En su lugar, utilizan Etiquetas de audio con instrucciones en lenguaje natural entre corchetes, como [whispering] y [sighs], para controlar el flujo de la voz sintetizada.
- La API de WebSocket controla el análisis de SSML mediante el parámetro enable_ssml_parsing y envía las etiquetas SSML como mensajes completos para evitar latencia adicional.
- Etiquetas como <prosody>, <say-as>, <sub>, <lang>, <voice> y <audio> no son compatibles con los modelos de ElevenLabs, pero cada una tiene una alternativa: ajustes de voz, normalización de texto, diccionarios de pronunciación, modelos multilingües, voces independientes y efectos de sonido.
¿Qué es SSML?
SSML es un lenguaje de marcado que te permite anotar texto escrito con instrucciones sobre cómo debe leerlo un motor de síntesis. El World Wide Web Consortium (W3C) lo desarrolló como un estándar para ir más allá de los modelos de texto a voz simples. SSML ofrece indicaciones explícitas y legibles por máquinas sobre cómo debe pronunciarse un pasaje, en lugar de depender de modelos que interpretan texto sin formato.
SSML no es un lenguaje de marcado exclusivo de un único proveedor. Amazon Polly y Microsoft Azure Speech usan etiquetas SSML, como <break> y <emphasis>, como su principal mecanismo de control. La mayoría de plataformas de texto a voz en la nube aceptan alguna versión del estándar. SSML ha sido la forma predeterminada de anotar voz mucho antes de que existieran los modelos de voz generativos.
SSML sigue siendo un estándar fundamental, mientras se desarrollan controles más recientes y específicos de cada modelo junto con las tecnologías modernas de voz generativa. Esta especificación neutral respecto a proveedores permite implementar etiquetas básicas comunes. Después, los proveedores pueden añadir sus propias extensiones y restricciones sobre esas etiquetas básicas.
Etiquetas SSML habituales y su función
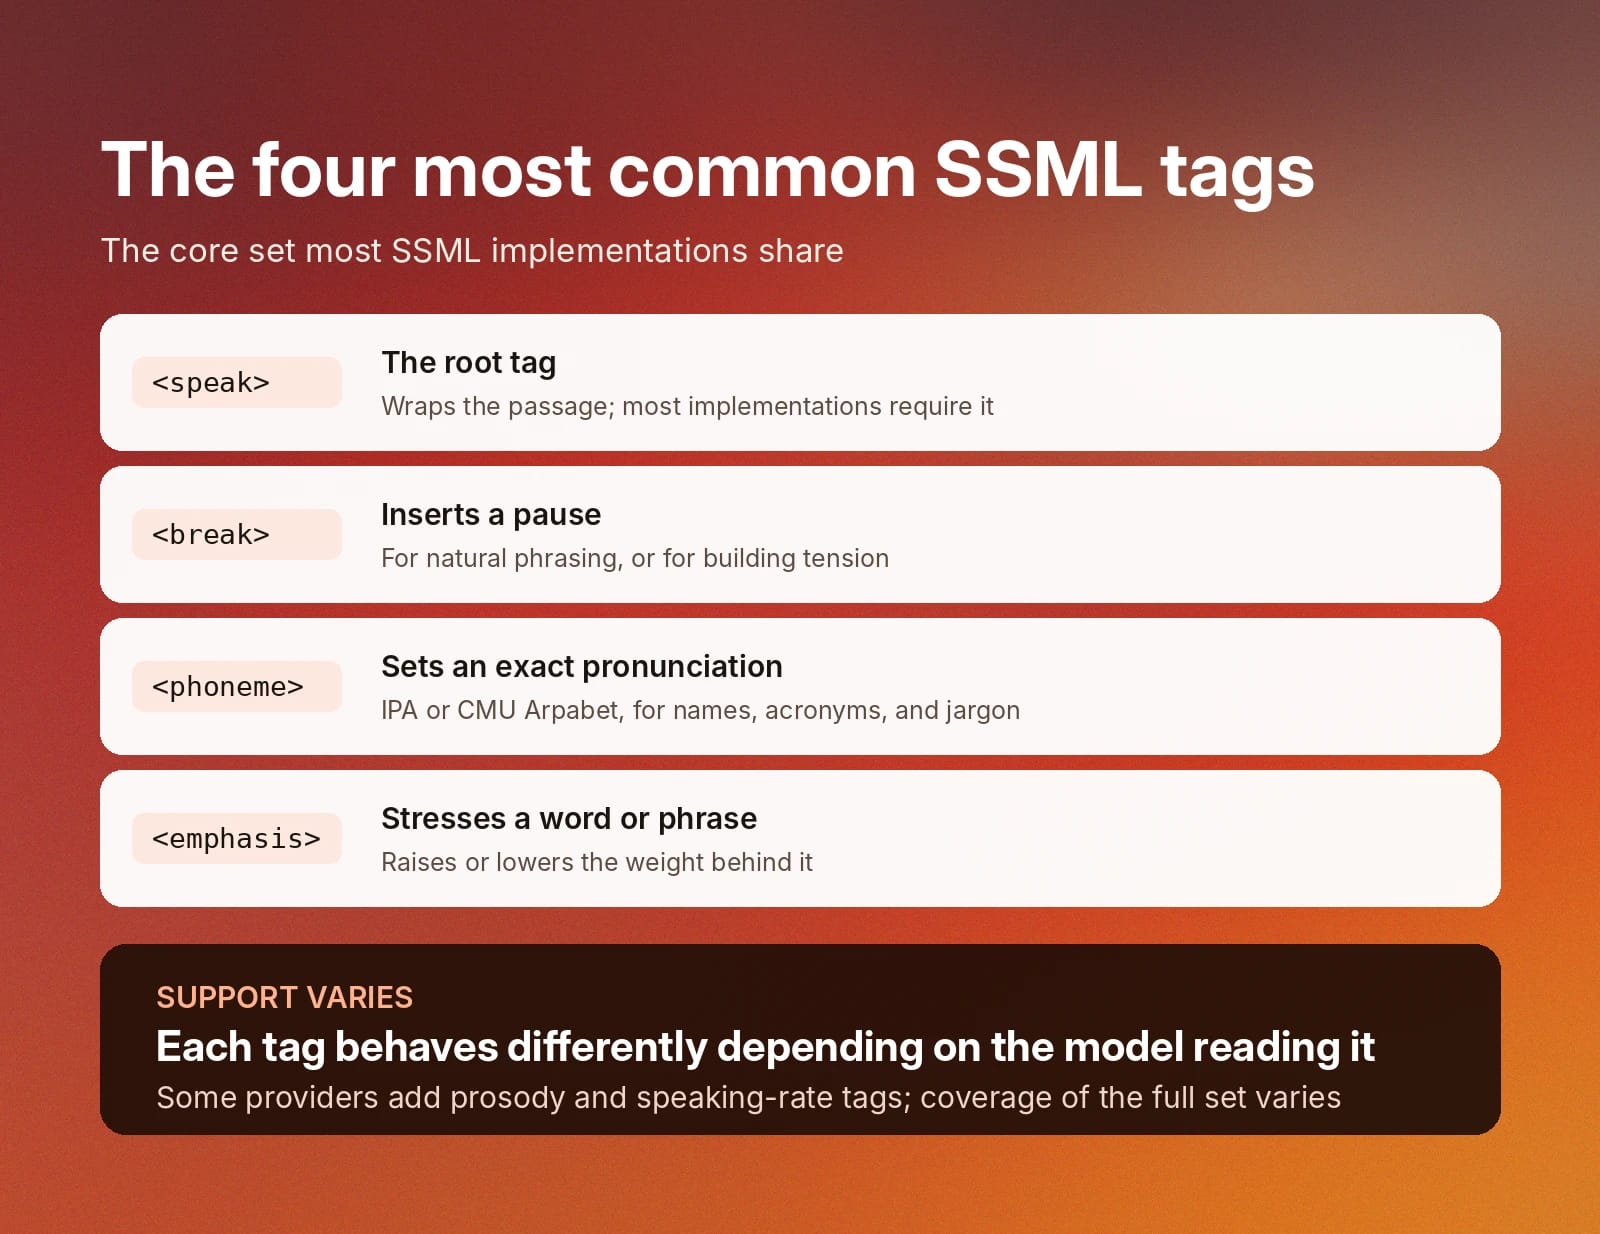
Las implementaciones de SSML comparten un conjunto básico de etiquetas que la mayoría busca al intentar controlar la voz sintetizada.
Estas son las etiquetas SSML más habituales:
- <speak>: es la etiqueta raíz que engloba todo el pasaje. La mayoría de implementaciones la requieren para reconocer el contenido incluido como SSML.
- <break>: inserta una pausa de una duración determinada. Resulta útil para crear una entonación natural entre cláusulas u oraciones, o para generar tensión en un texto.
- <phoneme>: especifica la pronunciación exacta de una palabra mediante un alfabeto fonético como IPA o CMU Arpabet, lo que resulta útil para acrónimos, nombres o términos técnicos.
- <emphasis>: enfatiza una palabra o frase, imitando cómo una persona elevaría o reduciría de forma natural el peso de su significado.
Cada una de estas cuatro etiquetas se comporta de forma distinta según el modelo TTS que la lea. Algunos proveedores admiten etiquetas adicionales para la prosodia o la velocidad de habla. Un guion escrito para un proveedor de TTS no se comportará igual en otro, aunque ambos afirmen admitir SSML, porque la cobertura del conjunto completo de etiquetas varía.
Lo que más varía es qué etiquetas procesa realmente cada modelo de texto a voz, y ahí es donde la implementación de ElevenLabs adquiere particularidades.
Usar SSML con ElevenLabs
La compatibilidad con SSML en ElevenLabs no es completamente uniforme. Depende del modelo que selecciones para generar el audio. La etiqueta <break> es el elemento con mayor compatibilidad, y <phoneme> está disponible en un conjunto más limitado de modelos.
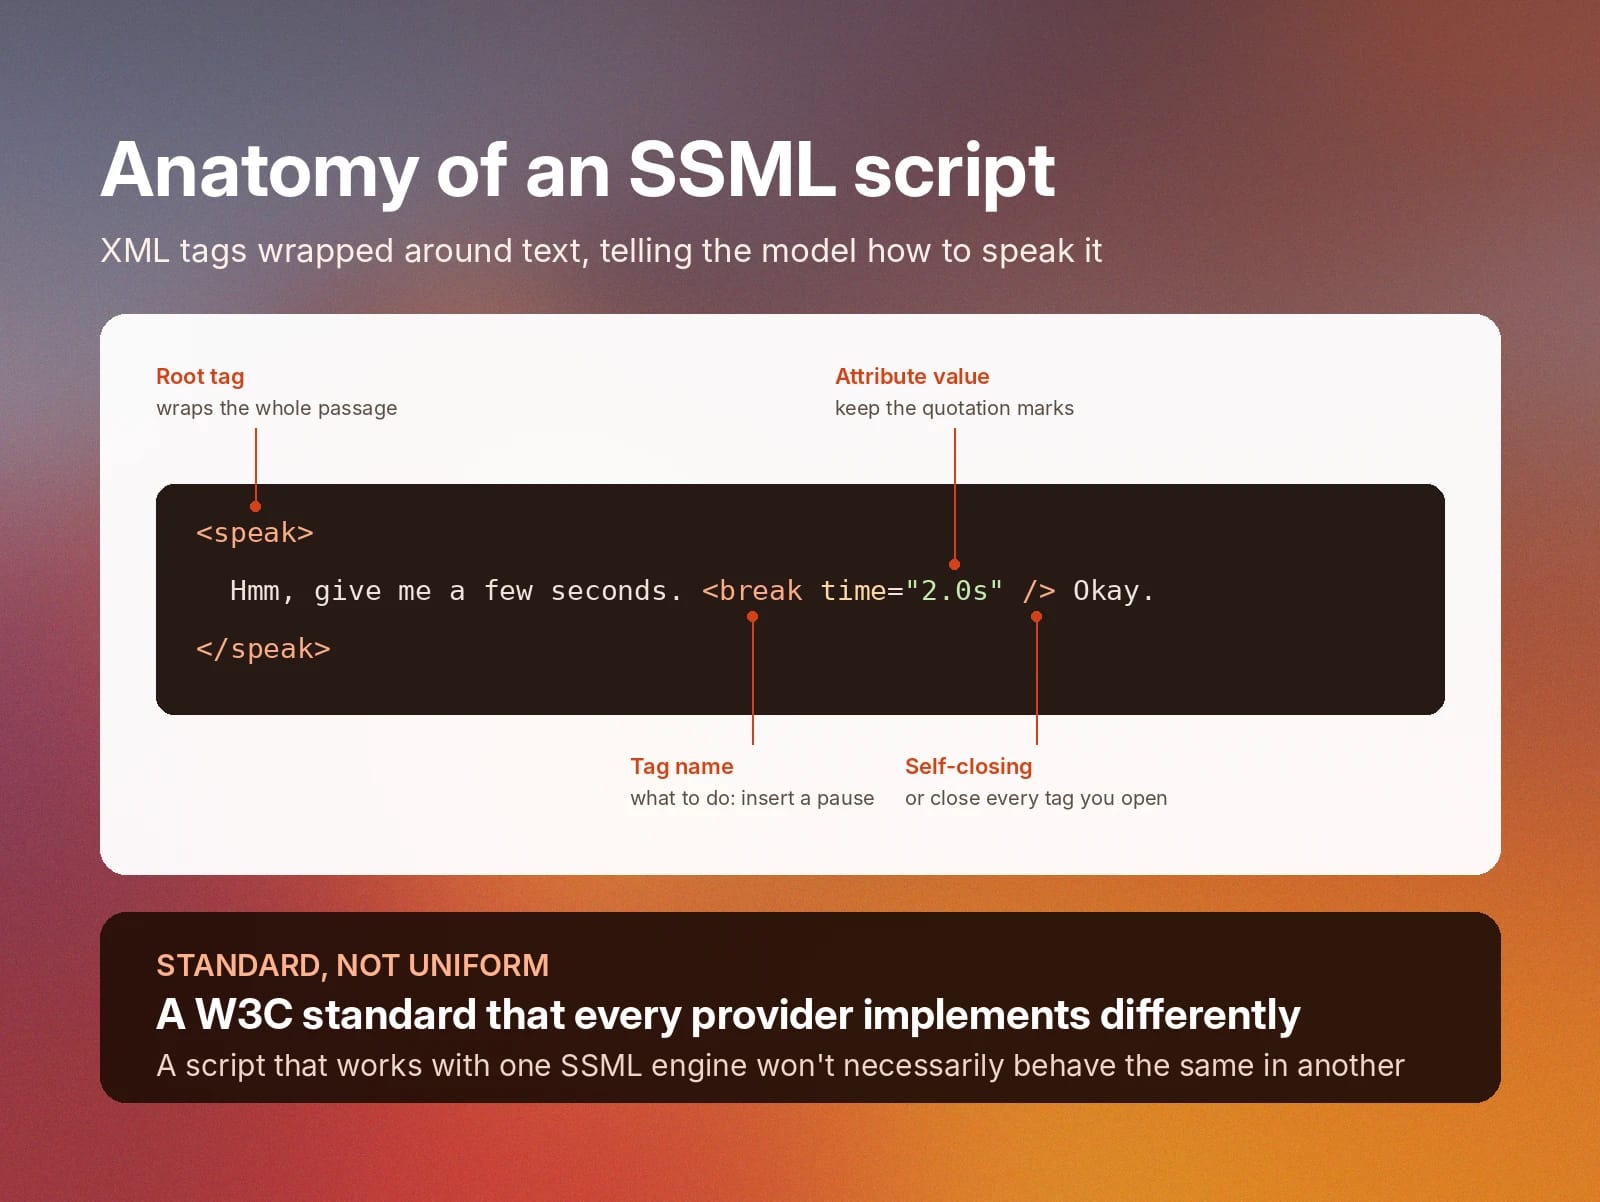
Los modelos TTS más antiguos de ElevenLabs, como Multilingual v2, admiten la etiqueta <break> para pausas de hasta tres segundos. Por ejemplo, un agente de IA podría decir «Espera, déjame pensar» y usar después <break time="2.0s" /> para crear una pausa audible antes de continuar con «De acuerdo, sé cómo ayudarte». Es la etiqueta más habitual en muchos workflows, ya que ayuda a simular un estilo de conversación más natural.
Al usar etiquetas SSML, es mejor limitarse a unas pocas a la vez. Usar muchas en una oración o párrafo puede hacer que un modelo cambie de velocidad inesperadamente o produzca diversos artefactos de audio. Las distintas voces también gestionan las pausas de forma diferente, especialmente las entrenadas con muestras que incluyen muletillas como «eh» o «em».
SSML en la práctica con ElevenLabs
Los modelos Flash v2 y Turbo v2 de ElevenLabs van un paso más allá y también admiten la etiqueta <phoneme> para pronunciaciones personalizadas, solo en inglés. Esto hace que la etiqueta phoneme sea útil para corregir cómo pronuncia un modelo un nombre, acrónimo, término técnico u otra terminología empresarial. Se aplica siempre que el guion se ejecute en uno de estos dos modelos.
Por el contrario, Eleven v3 y Eleven v4 rompen por completo con este patrón. Usan Audio Tags para controlar la entonación. Además, Eleven v4 incorpora compatibilidad nativa con IPA en línea, lo que permite leer directamente en el texto símbolos IPA entre barras inclinadas. Más abajo explicamos qué sustituye a la etiqueta break y a los controles de entonación.
Para consultar el desglose completo de los controles de texto a voz de ElevenLabs, incluidos los diccionarios de pronunciación y la normalización de texto, consulta la guía de buenas prácticas.
Ejemplos de código SSML con ElevenLabs
Los ejemplos siguientes muestran SSML en un guion y en una llamada a la API. Recuerda que <break> funciona en todos los modelos excepto Eleven v4 y Eleven v3, y que <phoneme> solo funciona en Flash v2 y Turbo v2 (solo en inglés).
Un guion SSML básico con una pausa
Envuelve el texto y la etiqueta en un bloque <speak>, y conserva las comillas alrededor del valor del atributo:
Encuentra más información sobre pausas y etiquetas phoneme de SSML mediante ElevenAPI.
Corrige una pronunciación con <phoneme>
Usa IPA o CMU Arpabet para indicar exactamente cómo debe sonar una palabra. Aquí, el nombre «Siobhan» se guía con IPA, mientras que «Madison» se define con CMU Arpabet:
Genera voz con SSML en Python
Esta llamada envía un guion que contiene una etiqueta break a un modelo que la admite:
Genera voz con SSML en JavaScript
A continuación encontrarás un ejemplo similar para generar voz con SSML, pero escrito en JavaScript.
SSML y la API de WebSocket
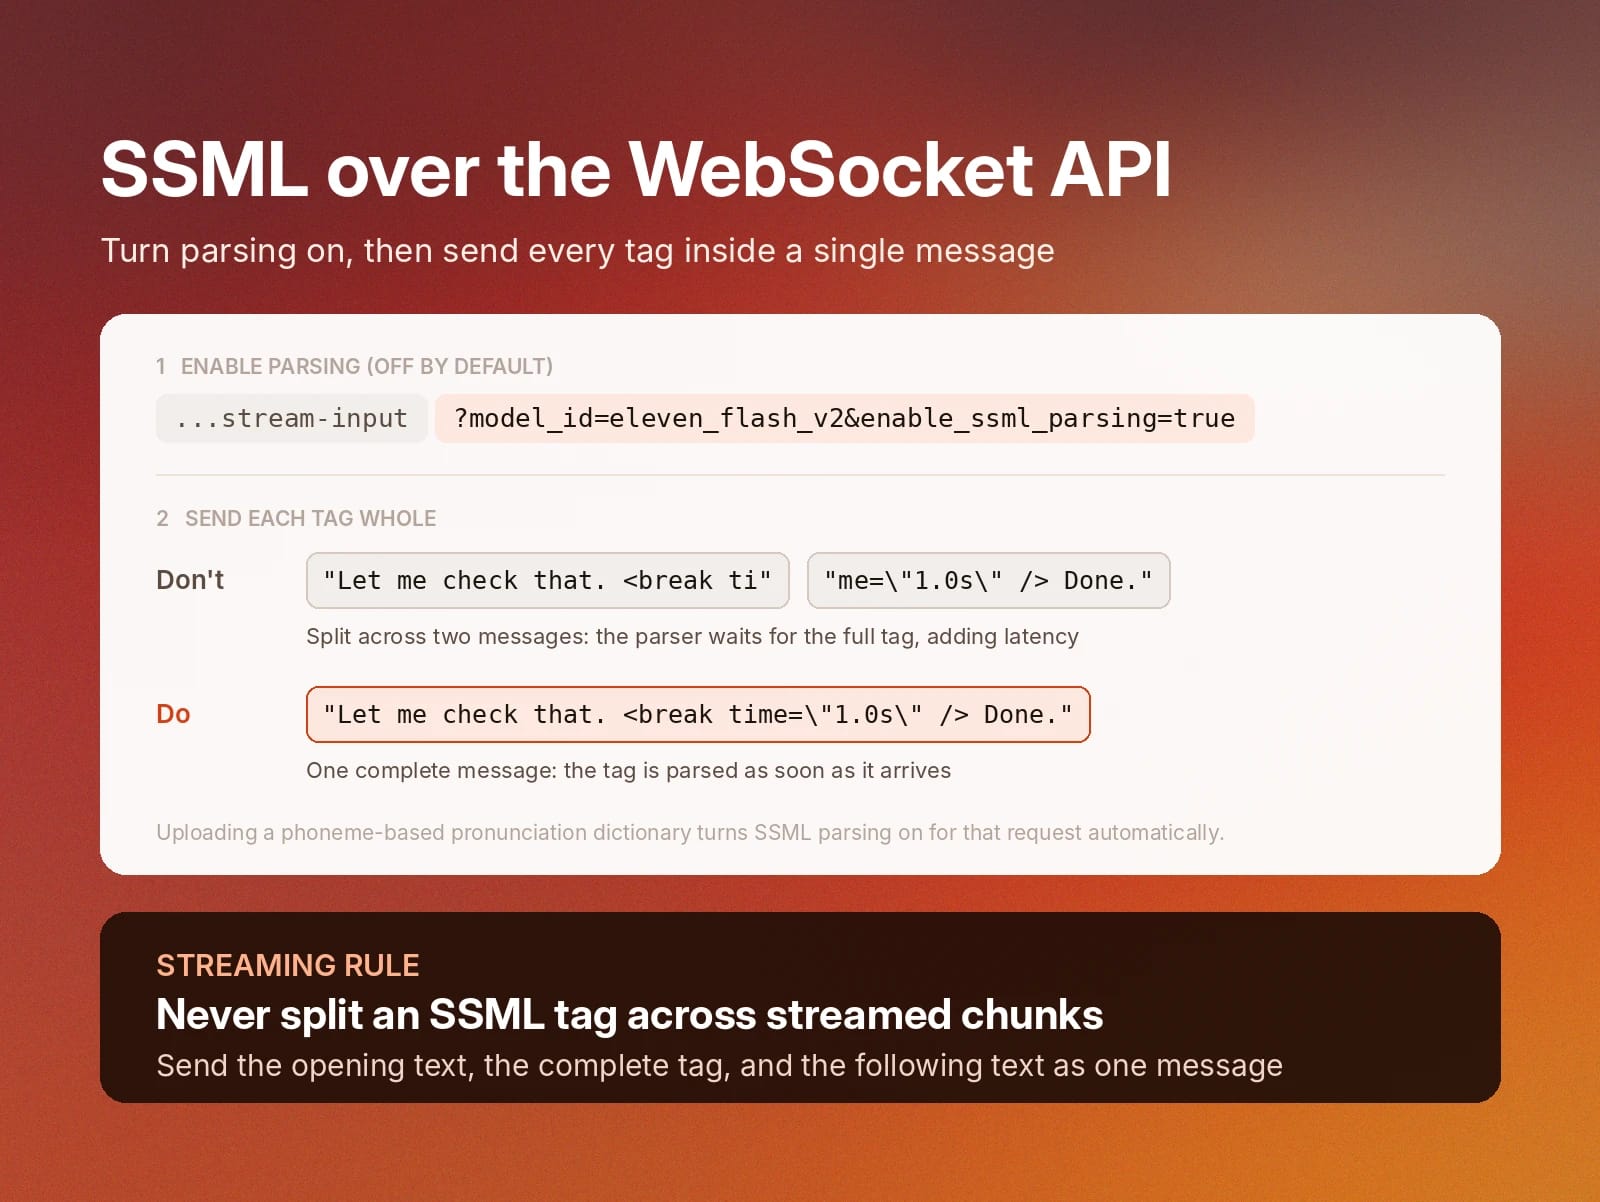
Transmitir audio mediante la API de WebSocket de ElevenLabs en lugar de una solicitud HTTP estándar requiere habilitar explícitamente el análisis de SSML. Está desactivado de forma predeterminada y se controla mediante el parámetro enable_ssml_parsing.
Para obtener los mejores resultados, recomendamos enviar cada etiqueta SSML como un mensaje completo y autocontenido, en vez de dividirla entre varios fragmentos transmitidos. Dividir una etiqueta a mitad de un mensaje añade latencia, ya que el analizador necesita la etiqueta completa antes de poder actuar sobre ella.
Subir un diccionario de pronunciación basado en fonemas habilita automáticamente el análisis de SSML para la solicitud, incluso si no se configuró específicamente el parámetro enable_ssml_parsing. Para obtener todos los detalles de los parámetros y el formato de mensajes disponibles para la API de WebSocket, consulta esta guía de documentación sobre generar audio en tiempo real.
El siguiente ejemplo activa el análisis de SSML en la URL de conexión y envía la etiqueta break completa en un único mensaje:
Etiquetas SSML que ElevenLabs no admite y qué usar en su lugar
Etiquetas SSML que ElevenLabs no admite y qué usar en su lugar
Si trabajas con un modelo anterior de ElevenLabs, puede ser útil saber qué etiquetas SSML son compatibles. Debido a la variedad de alternativas preferidas, los primeros modelos de ElevenLabs ahora solo procesan <break> y <phoneme>; las demás etiquetas SSML se cubren mediante otros métodos.
Otras etiquetas SSML que quizá conozcas de la especificación W3C no se leen como marcado, por lo que cada una requiere un enfoque diferente. Esto es lo que puedes usar en ElevenLabs en lugar de otras etiquetas SSML:
Etiqueta SSML
Qué hace
Qué usar en su lugar
<prosody>
Configura el tono, la velocidad de habla y el volumen
Los ajustes de voz de velocidad y estabilidad. En Eleven v3 y Eleven v4, Audio Tags de entonación como [slowly] o [rushed]
<emphasis>
Enfatiza una palabra o frase
Mayúsculas o puntuación para enfatizar. En Eleven v3 y Eleven v4, etiquetas como [shouts]
<say-as>
Controla cómo se leen los números, las fechas y las siglas
Normalización de texto, escribir el valor con palabras o una regla de diccionario de pronunciación
<sub>
Sustituye la forma hablada de una palabra escrita
Una regla de alias de diccionario de pronunciación
<lang>
Cambia el idioma de una frase
Un modelo multilingüe, con la frase escrita en el idioma de destino
<voice>
Cambia de hablante a mitad del guion
Una generación independiente por voz o un diálogo con varios hablantes en Eleven v3 y Eleven v4
<audio>
Inserta un archivo o sonido de audio grabado
Audio Tags de efectos de sonido en Eleven v3 y v4, la herramienta de efectos de sonido de ElevenLabs o mezclar el audio después de generarlo
Prosodia: tono, velocidad de habla y volumen con SSML
Prosodia: tono, velocidad de habla y volumen con SSML
Para cambiar el ritmo dentro de un guion, divide el texto en generaciones independientes o añade etiquetas <break> entre las oraciones. En Eleven v3 y v4, utiliza las Audio Tags de la tabla anterior, como [slowly], [rushed] y [whispers], colocadas directamente en la línea.
Para cambiar el ritmo dentro de un guion, divide el texto en generaciones independientes o añade etiquetas <break> entre las oraciones. En Eleven v3 y v4, usa las Audio Tags de la tabla anterior, como [slowly], [rushed] y [whispers], colocadas directamente en la línea.
Pronunciación: <phoneme>, <say-as> y <sub> con SSML
Estos son los principales métodos que puedes utilizar:
- Usa <phoneme> para una corrección puntual en Flash v2 o Turbo v2, como en el ejemplo anterior.
- Usa un diccionario de pronunciación para términos que se repiten en muchos guiones. Un diccionario puede contener reglas de fonemas y reglas de alias que se comportan como <sub>; por ejemplo, asignar «UN» a «United Nations».
- Para lo que gestiona <say-as>, como números, fechas, monedas y números de teléfono, utiliza la normalización de texto, que convierte los valores escritos en palabras habladas. Cuando un valor deba leerse de una única forma, como un número de confirmación, escríbelo con letras o separa los dígitos en el guion.
Idioma y configuración regional
Idioma y configuración regional
Flash v2 y Turbo v2 solo están disponibles en inglés, por lo que los guiones que mezclan idiomas necesitan un modelo multilingüe, como Multilingual v2, Flash v2.5, Eleven v3 o Eleven v4. Eleven v4 y v3 también admiten etiquetas de acento como [French accent] y transcripción IPA en más de 70 idiomas.
Flash v2 y Turbo v2 solo están disponibles en inglés, por lo que los guiones que mezclan idiomas necesitan un modelo multilingüe como Multilingual v2,
Audio y efectos de sonido
Para añadir sonido dentro del propio habla, solo tienes que escribir la etiqueta de efecto de sonido, como [applause] o [door slamming], y ver cómo Eleven v4 y Eleven v3 le dan vida. Para un diseño de sonido más largo o granular, genera el efecto de sonido por separado y mézclalo con la pista de voz en tu editor o workflow de producción.
Para añadir sonido dentro de la propia voz, solo tienes que escribir la etiqueta de efecto de sonido, como [applause] o [door slamming], y ver cómo Eleven v4 y Eleven v3 le dan vida. Para un diseño de sonido más largo o granular,
Buenas prácticas de SSML con ElevenLabs
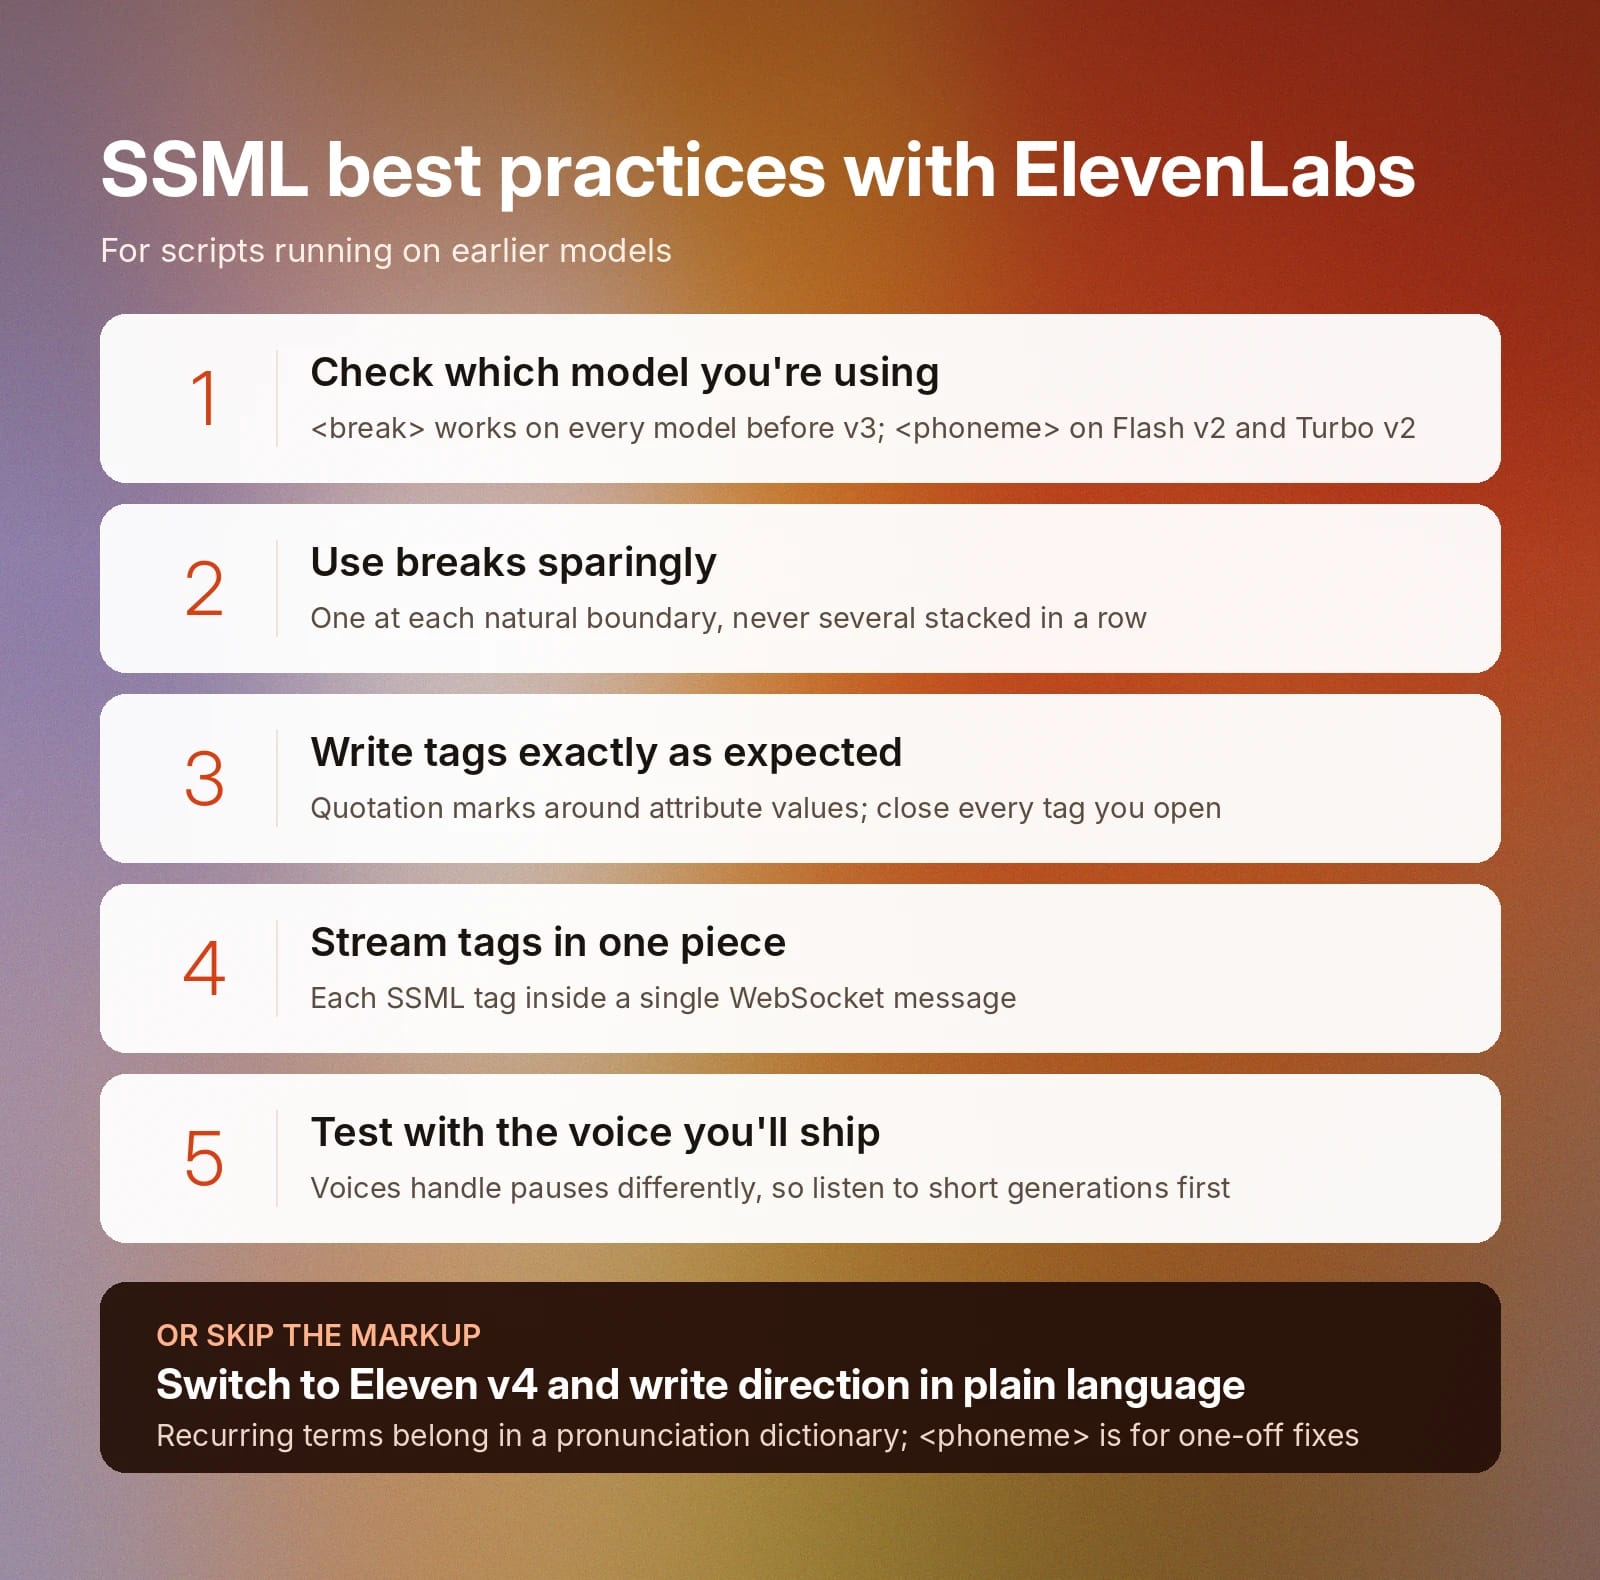
Estas son algunas recomendaciones para empezar a trabajar con SSML en ElevenLabs:
- Comprueba qué modelo utilizas: <break> funciona en todos los modelos excepto Eleven v3; <phoneme> solo funciona en Flash v2 y Turbo v2, y las Audio Tags solo funcionan en modelos más recientes, como Eleven v4 y Eleven v3.
- Usa las pausas con moderación: coloca una en cada límite natural en lugar de acumular varias seguidas.
- Escribe las etiquetas SSML como corresponde: conserva las comillas alrededor de los valores de los atributos, por ejemplo <break time="2.0s" />, y cierra todas las etiquetas que abras.
- Transmite las etiquetas de una pieza: envía cada etiqueta SSML dentro de un único mensaje WebSocket.
- Prueba con la voz que vas a publicar: las voces manejan las pausas de forma diferente, así que escucha generaciones cortas antes de ejecutar un guion completo. ElevenLabs tiene más de 17.500 voces en nuestra Biblioteca de voces.
Además de estas buenas prácticas para SSML, es buena idea utilizar un diccionario de pronunciación para cualquier término que vaya a aparecer con frecuencia. Para correcciones puntuales, <phoneme> es la mejor opción.
¿Cuáles son los principales casos de uso de SSML?
¿Cuáles son los principales casos de uso de SSML?prosodia al habla generada por IA.
Estos son algunos casos de uso en los que el estándar SSML resulta útil:
- Sistemas de respuesta de voz interactiva (IVR): útiles cuando un sistema IVR necesita hacer una pausa entre una indicación y un menú, o leer números con claridad.
- Agentes conversacionales: añadir una pausa breve antes de una respuesta para que el intercambio suene natural.
- Audiolibros y narración de larga duración: hacer pausas al final de los capítulos y entre escenas para marcar claramente el antes y el después de cada momento.
- E-learning y formación: corregir la pronunciación de nombres de productos, términos técnicos, siglas y términos específicos de empresa.
- Notificaciones y alertas: controlar cómo se leen las fechas, las horas y los códigos de referencia.
Aunque SSML ofrece diversos casos de uso, puedes lograr todos ellos con Audio Tags sin tener que memorizar e insertar etiquetas SSML, que a menudo son complejas, en tus guiones. Eleven v4 y Eleven v3 crearon el sistema Audio Tag para ofrecer a usuarios un control completo de sus resultados de voz generada por IA sin las complicaciones de SSML.
Aunque SSML ofrece una amplia gama de casos de uso, todos pueden lograrse sin tener que memorizar e insertar etiquetas SSML, a menudo complejas, en tus guiones gracias a las Audio Tags. Eleven v4 y Eleven v3 crearon el sistema de Audio Tags para ofrecer a usuarios control total sobre la voz generada por IA sin las complicaciones de SSML.
Por qué Eleven v4 usa Audio Tags en lugar de SSML
- Emociones o sentimientos, como [sad] o [excited]
- Entonación y ritmo, como [whispers] o [rushed]
- Reacciones humanas, como [sighs] o [laughs]
- Acentos y voces de personaje, como [French accent]
- Efectos de sonido, incluidos [applause] o [door shutting]
El motivo de este diseño se basa en cómo el modelo interpreta el contexto en una conversación. La arquitectura de Eleven v4 interpreta el contexto con mayor profundidad que los modelos anteriores, lo que le permite seguir señales emocionales, cambios de tono, transiciones entre hablantes y pistas contextuales sin parámetros ni ajustes independientes.
SSML proporciona instrucciones específicas en un punto fijo del texto, lo que puede hacer que la entonación parezca rígida y entrecortada. SSML es uno de los principales motivos por los que el texto generado por IA suena robótico, a pesar de la alta calidad de los modelos subyacentes.
Una indicación como [whisper] ofrece a Eleven v4 una pauta interpretativa que se aplica a toda la línea circundante y que viene determinada por la prosodia de todo lo que la rodea.
La mayoría de elementos SSML tienen un equivalente directo en v4:
Etiqueta SSML
Qué hace
Equivalentes en Eleven v4
<break time="1s">
Inserta una pausa
[pause], puntos suspensivos o un salto de línea
<prosody rate="slow">
Ralentiza el habla
[drawn out] o [slowly]
<prosody rate="fast">
Acelera el habla
[rushed]
<emphasis>
Enfatiza una palabra concreta
[shouts] o escribir una palabra en mayúsculas
<prosody pitch="high">
Eleva el tono
Etiquetas emocionales como [excited]
<prosody pitch="low">
Baja el tono
Etiquetas emocionales como [sorrowful]
La pronunciación sigue el mismo patrón de sustitución. Eleven v4 incluye compatibilidad nativa con IPA y transcripción en más de 90 idiomas. Esto permite a los equipos controlar la pronunciación sin las etiquetas XML necesarias, añadiendo directamente al texto la transcripción entre barras inclinadas.
La pronunciación sigue el mismo patrón de sustitución. IPA se incluye como compatibilidad nativa en Eleven v4, con transcripción en más de 90 idiomas. Esto permite a los equipos controlar la pronunciación sin las etiquetas XML necesarias, añadiendo transcripción entre barras inclinadas directamente en el texto.
Empieza a crear voz con sonido natural en ElevenCreative
Descubre cómo las Audio Tags se traducen en audio final con Eleven v4 o crea una cuenta gratuita para experimentar hoy con SSML y Audio Tags en tus propios guiones.
Preguntas frecuentes

Jack Limebear forma parte del equipo de Growth, donde escribe y desarrolla estrategias de contenido para el blog y la sección de insights. Antes de unirse a ElevenLabs, pasó más de diez años liderando la estrategia de contenido en organizaciones que van desde startups SaaS en rápido crecimiento hasta empresas Fortune 500. Tiene un máster en Literatura Inglesa por la Universidad de Cambridge.



