
Guía práctica: frameworks de agentes de código abierto y ElevenAgents
- Escrito por
- Akhil Chauhan
- Publicado
- Última actualización
EscucharEscucha este artículo
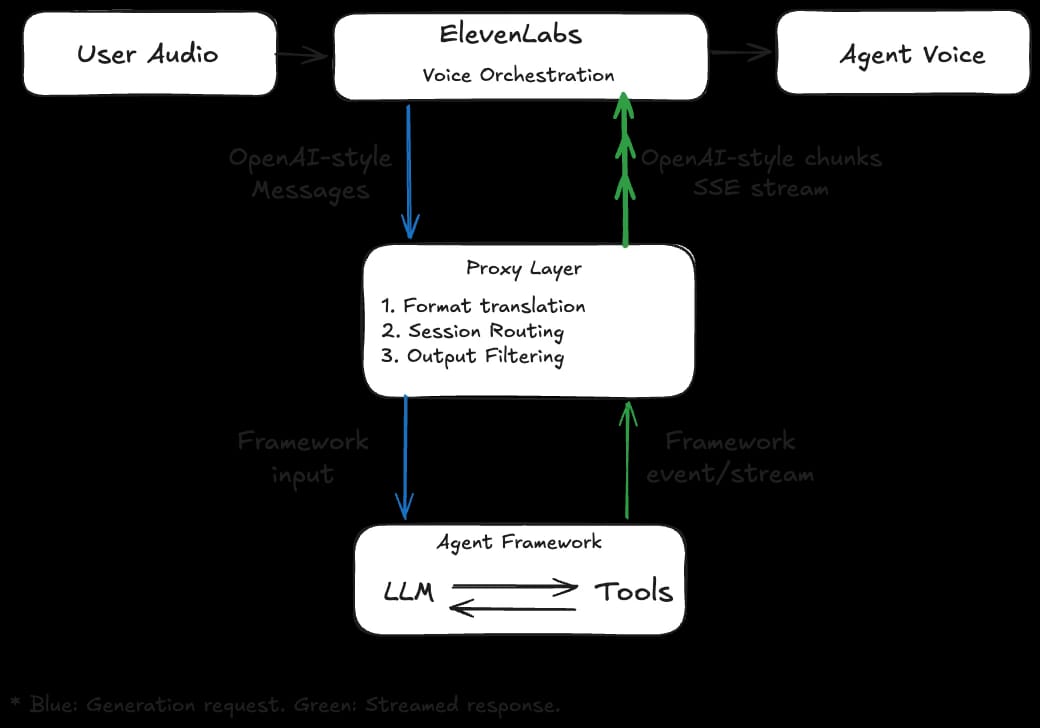
En nuestra publicación anterior sobre Integración de agentes externos con la orquestación de voz de ElevenLabs, explicamos cómo los equipos pueden conectar su orquestación de agentes basada en texto a ElevenLabs mediante Custom LLM. A partir de esa base, esta guía muestra cómo adaptar e implementar los principales frameworks de agentes de código abierto tras la interfaz de Custom LLM. El resultado es una arquitectura flexible que añade una capa de voz a sistemas de agentes consolidados sin comprometer la gestión del estado, la orquestación de herramientas ni el control específico de cada aplicación. En todos los frameworks seguimos el mismo patrón de tres pasos: crear una solicitud de generación, extraer la respuesta de texto final y reformatearla en un formato Server-Sent Events (SSE) compatible con OpenAI. ElevenLabs admite los formatos Chat Completions y Responses. Aunque esta guía cubre cuatro frameworks muy utilizados, los patrones se pueden aplicar a cualquier entorno de ejecución capaz de producir salida en streaming compatible con OpenAI.
Configuración general
Los ejemplos de esta sección usan Python y FastAPI, aunque funcionará cualquier stack que gestione solicitudes HTTP POST y respuestas SSE en streaming. Cuando la orquestación de voz de ElevenLabs detecta un posible final de turno, envía una solicitud de generación a la ruta de API de Custom LLM configurada. Esta sección explica los componentes principales de esa capa de traducción: el puente o proxy que permite que la orquestación de voz y el framework de agentes hablen el mismo idioma.
Es comprensible que clientes elijan cada framework por su familiaridad general o por su capacidad para cumplir un propósito concreto. LlamaIndex, por ejemplo, se desarrolló originalmente para simplificar la configuración de la generación aumentada por recuperación (RAG), mientras que CrewAI se creó para automatizar tareas definidas en la era de los agentes. Objetivos de diseño distintos producen estructuras de respuesta diferentes, y cada una requiere un tratamiento específico. Transmitir fragmentos a medida que el LLM los genera, en lugar de esperar a que finalice el turno, es fundamental porque permite que el modelo de Texto a Voz (TTS) empiece a generar voz antes y reduzca así la latencia percibida. Nos centramos en cuatro frameworks populares: LangGraph, Google ADK, CrewAI y LlamaIndex.
Nota sobre el código compartido
Cada framework debe transmitir respuestas como fragmentos SSE compatibles con OpenAI. Presentamos una pequeña función auxiliar que se usa en todos los ejemplos para construir estos fragmentos.
Con esta base, empecemos con LangGraph.
LangGraph
LangGraph modela agentes como grafos, donde los nodos representan pasos individuales y las aristas definen el flujo de control entre ellos. La configuración mínima es sencilla: inicializa un modelo de chat, define las herramientas del agente y crea el entorno de ejecución del grafo de agentes.
Para cada solicitud de generación, el agente de LangGraph recibe todo el historial de la conversación, lo que le permite mantener internamente el estado necesario. LangGraph admite persistencia en el servidor mediante Checkpoints, aunque no los tratamos aquí para mantener una implementación mínima.
Una vez resuelta la gestión del estado, la siguiente decisión específica de LangGraph es el modo de streaming, para el que ofrece dos opciones, cada una adecuada para un caso de uso distinto:
- stream_mode="values" proporciona instantáneas del estado del grafo. Es más sencillo de implementar, pero incluye un estado de mensajes más completo en cada respuesta, lo que añade latencia a los flujos conversacionales en tiempo real.
- stream_mode="messages" transmite fragmentos incrementales de mensajes del modelo. En general, es preferible para interacciones de voz en tiempo real, ya que reduce el tiempo hasta el primer audio en la capa de orquestación de ElevenLabs.
Más concretamente, la implementación de mensajes del bucle del agente incluye pasos intermedios, como actualizaciones de llamadas a herramientas, que no deberían pronunciarse en voz alta. El proxy las filtra y solo pasa el texto de respuesta dirigido al usuario a la capa de TTS. Veamos un ejemplo de un turno que usa una herramienta.
[1] El modelo decide llamar a una herramienta (tool_calls=["get_price"])[2] La herramienta se ejecuta y devuelve datos (result="$24.99") [3] El modelo genera una respuesta con el resultado (content="Cuesta $24.99")
Naturalmente, solo los fragmentos del paso 3 deben reenviarse en el stream SSE. En la práctica, dos comprobaciones gestionan este filtrado en el bucle de streaming: una para conservar solo los eventos langgraph_node == "model" y otra para omitir el contenido vacío. Juntas, garantizan que solo el texto del asistente dirigido al usuario se reenvíe a ElevenLabs como SSE. Con estos conceptos reunidos, presentamos una implementación ligera del proxy de solicitudes.
Esto garantiza que solo se reenvíen a ElevenLabs los fragmentos del modelo dirigidos al usuario. Como LangGraph muestra la ejecución interna de sus herramientas a través del stream de estado, el filtrado es explícito y lo controla el proxy.
A continuación, veremos los matices de trabajar con el Agent Development Kit (ADK) de Google.
Google ADK
El ADK de Google abstrae el bucle de ejecución tras unas pocas primitivas principales: Agent, Runner y SessionService. El Runner de ADK se sitúa entre la capa HTTP y la definición del agente. Gestiona el enrutamiento de mensajes, la orquestación de herramientas, el ciclo de vida de las sesiones y el streaming de eventos.
Con el agente, el backend de sesiones y el runner inicializados, el proxy resuelve o crea una sesión de ADK para cada solicitud entrante. En ADK, session_id controla la persistencia de la memoria: reutilizar el mismo session_id entre turnos conserva automáticamente el historial, las llamadas a herramientas y las respuestas anteriores. Como la identidad de la conversación se encuentra aguas arriba en ElevenLabs, el proxy gestiona este mapeo de forma explícita. Al pasar el identificador correcto para la solicitud de generación, el SDK puede gestionar internamente el contexto anterior. Pasamos el identificador arbitrario durante el inicio de la conversación mediante parámetros adicionales enviados en el cuerpo de la solicitud.
Con el mensaje y la sesión preparados, se puede invocar el runner. Las llamadas a herramientas y sus resultados siguen apareciendo como eventos internos de ADK durante la ejecución, pero se tratan como pasos intermedios de orquestación, no como salida dirigida al usuario. Esto elimina la necesidad de un filtro manual en comparación con los frameworks en los que las llamadas a herramientas aparecen como texto visible para el usuario.
El siguiente controlador es una implementación simplificada que incluye en línea la resolución de sesiones y la lógica de obtener o crear.
A continuación, veremos CrewAI, que por diseño está más centrado en tareas.
CrewAI
CrewAI se diseñó para orquestar flujos de trabajo multiagente en torno a tareas estructuradas (investigar, escribir, resumir), en lugar de bucles de diálogo abiertos. Los agentes se definen con un rol, un objetivo y un trasfondo. La ejecución se centra en objetos Task, cada uno con una descripción clara y una salida esperada.
A diferencia del modelo de bucle de agentes utilizado en LangGraph y ADK, CrewAI suele construir Task y Crew por solicitud para definir la unidad de trabajo de ese turno de la conversación. Mantenemos el contexto conversacional inyectando los turnos anteriores en la siguiente tarea mediante un marcador de posición. La variable {crew_chat_messages} se completa en cada solicitud con el historial de conversación acumulado y, después, se interpola en la descripción de la tarea durante la ejecución. También buscamos producir texto limpio y listo para locución filtrando explícitamente patrones de trazado intermedios (Thought, Action, Action Input, Observation) y emitiendo solo el texto de la respuesta final.
El siguiente controlador reúne la construcción de tareas por solicitud, la interpolación del historial, el streaming a nivel de Crew, el filtrado de trazas y el formato de salida.
A continuación, veremos LlamaIndex, que sigue una vía distinta centrada en un modelo de streaming nativo basado en eventos.
LlamaIndex
A diferencia de los demás frameworks tratados en esta publicación, LlamaIndex se diseñó para conectar LLM a fuentes de datos externas (almacenes de documentos, índices y pipelines de recuperación). Su capa de agentes, FunctionAgent, se apoya en esa base para recuperar información y razonar sobre contexto estructurado, en lugar de gestionar diálogos abiertos o ejecutar tareas.
Para preservar la continuidad conversacional, el proxy transforma los mensajes entrantes en mensajes de chat de LlamaIndex y luego los divide entre el último turno del usuario (user_msg) y los turnos anteriores (chat_history). El campo event.delta de cada evento AgentStream contiene el siguiente fragmento de texto, que se asigna directamente a un fragmento delta.content al estilo de OpenAI. Los deltas no vacíos se pueden reenviar tal cual, lo que convierte este en el puente de streaming más directo de la guía. El stream contiene tanto eventos de orquestación (llamadas a herramientas y resultados) como eventos de voz (deltas de texto del asistente). Para mantener limpia la salida de voz, el proxy conserva solo los eventos AgentStream y omite los deltas vacíos.
[1] AgentStream (delta='') ← omitido[2] ToolCall ← omitido[3] ToolCallResult ← omitido[4] AgentStream (delta='Esto') ← reenviado ✓[5] AgentStream (delta=' cuesta')← reenviado ✓[6] AgentStream (delta=' $49.99')← reenviado ✓
Esta separación mantiene la mecánica intermedia de las herramientas fuera de la salida hablada y preserva la voz incremental de baja latencia. El controlador listo para usar que aparece a continuación reúne estos pasos.
LlamaIndex es menos prescriptivo sobre los patrones de ejecución conversacional de extremo a extremo que los frameworks con capas de orquestación integradas más completas. Para implementaciones de producción, normalmente requiere que clientes implementen la gestión de sesiones, medidas de seguridad para las respuestas, orquestación de herramientas y trazado.
Conclusión
Cada framework de esta guía se conecta a ElevenLabs mediante el mismo contrato: acepta una solicitud de Completions o Responses al estilo de OpenAI y devuelve fragmentos SSE en streaming. Esto permite a los equipos añadir orquestación de voz a una implementación de agentes existente con cambios mínimos, conservando lo que ya han creado y habilitando la IA conversacional en tiempo real. Esta modularidad es un principio fundamental de la plataforma ElevenAgents. Tanto si las organizaciones amplían un agente existente como si crean una solución nativa de voz desde el principio, la orquestación de voz de ElevenAgents está diseñada para adaptarse a sus necesidades.
Si ya utilizas un agente con un framework de código abierto y quieres habilitar la voz, prueba este enfoque y cuéntanos qué te parece.

