
Praxisleitfaden: Open-Source-Agent-Frameworks und ElevenAgents
- Verfasst von
- Akhil Chauhan
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
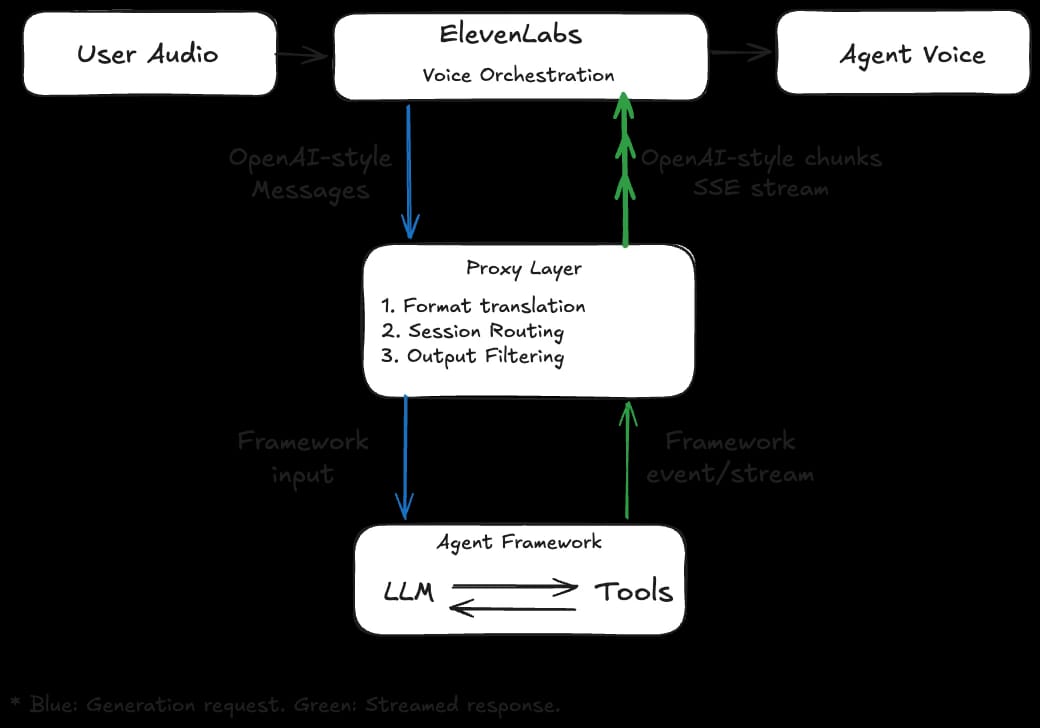
In unserem vorherigen Beitrag über Externe Agents in die ElevenLabs-Sprachorchestrierung integrieren haben wir erläutert, wie Teams ihre bestehende textbasierte Agent-Orchestrierung über das Custom LLM mit ElevenLabs verbinden können. Auf dieser Grundlage zeigt dieser Leitfaden, wie führende Open-Source-Agent-Frameworks für die Custom-LLM-Schnittstelle angepasst und dahinter bereitgestellt werden können. Das Ergebnis ist eine flexible Architektur, die ausgereiften Agent-Systemen Sprache hinzufügt, ohne State-Management, Tool-Orchestrierung oder anwendungsspezifische Kontrolle zu beeinträchtigen. Frameworkübergreifend folgen wir demselben Muster aus drei Schritten: Generierungsanfrage erstellen, endgültige Textantwort extrahieren und im OpenAI-kompatiblen Server-Sent-Events-Format (SSE) umformatieren. ElevenLabs unterstützt sowohl die Formate Chat Completions als auch Responses. Dieser Leitfaden behandelt zwar vier weit verbreitete Frameworks, die Muster lassen sich jedoch auf jede Runtime übertragen, die OpenAI-kompatible Streaming-Ausgaben erzeugen kann.
Allgemeine Einrichtung
Die Beispiele in diesem Abschnitt verwenden Python und FastAPI. Jeder Stack, der HTTP-POST-Anfragen und gestreamte SSE-Antworten verarbeitet, funktioniert jedoch. Wenn die Sprachorchestrierung von ElevenLabs ein wahrscheinliches Turn-Ende erkennt, sendet sie eine Generierungsanfrage an den konfigurierten Custom-LLM-Endpunkt. Dieser Abschnitt erläutert die Kernkomponenten dieser Übersetzungsschicht – die Brücke oder den Proxy, durch die Sprachorchestrierung und Agent-Framework dieselbe Sprache sprechen.
Kunden wählen ein Framework verständlicherweise aufgrund ihrer Vertrautheit damit oder seiner Fähigkeit, einen bestimmten Zweck zu erfüllen. LlamaIndex wurde beispielsweise ursprünglich entwickelt, um die Einrichtung von Retrieval-Augmented Generation (RAG) zu vereinfachen, während CrewAI zur Automatisierung definierter Aufgaben im Zeitalter der Agents entwickelt wurde. Unterschiedliche Entwicklungsziele führen zu unterschiedlichen Antwortstrukturen, die jeweils spezifisch verarbeitet werden müssen. Entscheidend ist, Chunks zu streamen, während das LLM sie erzeugt, statt auf einen vollständigen Turn zu warten. So kann das Text-to-Speech- (TTS) Modell früher mit der Spracherzeugung beginnen, was die wahrgenommene Latenz reduziert. Wir konzentrieren uns auf vier beliebte Frameworks: LangGraph, Google ADK, CrewAI und LlamaIndex.
Hinweis zum gemeinsam genutzten Code
Jedes Framework muss Antworten als OpenAI-kompatible SSE-Chunks streamen. Wir führen eine kleine Hilfsfunktion ein, die in allen Beispielen zur Erstellung dieser Chunks verwendet wird.
Mit dieser Grundlage beginnen wir mit LangGraph.
LangGraph
LangGraph modelliert Agents als Graphen, bei denen Knoten einzelne Schritte darstellen und Kanten den Kontrollfluss zwischen ihnen definieren. Die minimale Einrichtung ist einfach: Chat-Modell initialisieren, Agent-Tools definieren und die Agent-Graph-Runtime erstellen.
Bei jeder Generierungsanfrage erhält der LangGraph-Agent den vollständigen Gesprächsverlauf und kann so den erforderlichen State intern verwalten. LangGraph unterstützt serverseitige Persistenz über Checkpoints, die wir hier jedoch nicht behandeln, um die Implementierung schlank zu halten.
Nachdem das State-Management abgedeckt ist, folgt die nächste LangGraph-spezifische Entscheidung: der Streaming-Modus. LangGraph bietet zwei Optionen, die jeweils für einen anderen Anwendungsfall geeignet sind:
- stream_mode="values" liefert Snapshots des Graph-Status. Die Implementierung ist einfacher, umfasst jedoch bei jeder Antwort einen vollständigeren Nachrichtenstatus, was die Latenz in Echtzeit-Gesprächsabläufen erhöht.
- stream_mode="messages" streamt inkrementelle Nachrichten-Chunks vom Modell. Dies wird im Allgemeinen für Sprachinteraktionen in Echtzeit bevorzugt, da es die Zeit bis zum ersten Audio in der ElevenLabs-Orchestrierungsschicht verkürzt.
Genauer gesagt enthält die Messages-Implementierung der Agent-Schleife Zwischenschritte wie Updates zu Tool-Aufrufen, die nicht laut wiedergegeben werden sollten. Der Proxy filtert diese heraus und leitet nur für Nutzer bestimmte Antworttexte an die TTS-Schicht weiter. Hier ist ein Beispiel für einen Turn mit Tool-Nutzung.
[1] Modell entscheidet sich für den Aufruf eines Tools (tool_calls=["get_price"])[2] Tool wird ausgeführt und gibt Daten zurück (result="$24.99") [3] Modell erzeugt anhand des Ergebnisses eine Antwort (content="Es kostet 24,99 $")
Natürlich sollten nur die Chunks aus Schritt 3 im SSE-Stream weitergeleitet werden. In der Praxis übernehmen zwei Prüfungen diese Filterung in der Streaming-Schleife: eine, die nur Ereignisse mit langgraph_node == "model" beibehält, und eine, die leere Inhalte überspringt. Zusammen stellen diese Prüfungen sicher, dass nur für Nutzer bestimmter Assistententext als SSE an ElevenLabs weitergeleitet wird. Diese Konzepte ergeben zusammen eine schlanke Implementierung des Anfrage-Proxys.
Dadurch werden nur für Nutzer bestimmte Modell-Chunks an ElevenLabs weitergeleitet. Da LangGraph seine interne Tool-Ausführung über den State-Stream sichtbar macht, erfolgt die Filterung explizit und wird vom Proxy gesteuert.
Als Nächstes sehen wir uns die Besonderheiten bei der Arbeit mit Googles Agent Development Kit (ADK) an.
Google ADK
Googles ADK abstrahiert die Runtime-Schleife hinter einigen Kernprimitiven: Agent, Runner und SessionService. Der Runner von ADK sitzt zwischen der HTTP-Schicht und der Agent-Definition. Er verarbeitet Nachrichtenrouting, Tool-Orchestrierung, Sitzungslebenszyklus und Event-Streaming.
Sobald Agent, Session-Backend und Runner initialisiert sind, löst der Proxy für jede eingehende Anfrage eine ADK-Session auf oder erstellt sie. In ADK steuert session_id die Speicherpersistenz: Die Wiederverwendung derselben session_id über mehrere Turns hinweg übernimmt automatisch Verlauf, Tool-Aufrufe und frühere Antworten. Da die Gesprächsidentität bei ElevenLabs vorgelagert ist, verarbeitet der Proxy dieses Mapping explizit. Durch Übergabe des korrekten Identifikators für die Generierungsanfrage kann das SDK vorherigen Kontext intern verarbeiten. Den beliebigen Identifikator übergeben wir bei der Gesprächsinitiierung über zusätzliche Parameter im Request-Body.
Sobald Nachricht und Session vorbereitet sind, kann der Runner aufgerufen werden. Tool-Aufrufe und Tool-Ergebnisse erscheinen während der Ausführung weiterhin als interne ADK-Events, werden jedoch als Zwischenstufen der Orchestrierung und nicht als für Nutzer bestimmte Ausgabe behandelt. Dadurch ist im Vergleich zu Frameworks, in denen Tool-Aufrufe als sichtbarer Text erscheinen, kein manueller Filter erforderlich.
Der folgende Handler ist eine vereinfachte Implementierung mit integrierter Session-Auflösung sowie Get-or-Create-Logik.
Als Nächstes betrachten wir CrewAI, das von Grund auf stärker auf Aufgaben ausgerichtet ist.
CrewAI
CrewAI wurde entwickelt, um Multi-Agent-Workflows rund um strukturierte Aufgaben wie Recherche, Schreiben und Zusammenfassen zu orchestrieren, statt um offene Dialogschleifen. Agents werden mit einer Rolle, einem Ziel und einer Hintergrundgeschichte definiert. Die Ausführung konzentriert sich auf Task-Objekte, jeweils mit einer klaren Beschreibung und erwarteten Ausgabe.
Im Gegensatz zum Agent-Schleifen-Modell von LangGraph und ADK erstellt CrewAI normalerweise für jede Anfrage Task und Crew, um die Arbeitseinheit für diesen Gesprächs-Turn zu definieren. Den Gesprächskontext führen wir fort, indem wir vorherige Turns über einen Platzhalter in die nächste Task einfügen. Die Variable {crew_chat_messages} wird bei jeder Anfrage mit dem bisherigen Gesprächsverlauf gefüllt und dann zur Ausführungszeit in die Task-Beschreibung interpoliert. Darüber hinaus wollen wir sauberen, für die Sprachausgabe geeigneten Text erzeugen, indem wir Zwischenmuster für die Nachverfolgung (Thought, Action, Action Input, Observation) ausdrücklich herausfiltern und nur den endgültigen Antworttext ausgeben.
Der folgende Handler vereint die Erstellung von Tasks pro Anfrage, Verlaufsinterpolation, Streaming auf Crew-Ebene, Trace-Filterung und Ausgabeformatierung.
Als Nächstes betrachten wir LlamaIndex, das einen anderen Weg mit Fokus auf ein natives ereignisgesteuertes Streaming-Modell einschlägt.
LlamaIndex
Im Gegensatz zu den anderen in diesem Beitrag behandelten Frameworks wurde LlamaIndex entwickelt, um LLMs mit externen Datenquellen wie Dokumentspeichern, Indizes und Retrieval-Pipelines zu verbinden. Seine Agent-Schicht FunctionAgent baut darauf auf, um strukturierten Kontext abzurufen und darüber zu schlussfolgern, statt offene Dialoge zu führen oder Aufgaben auszuführen.
Um die Kontinuität des Gesprächs zu erhalten, wandelt der Proxy eingehende Nachrichten in LlamaIndex-Chat-Nachrichten um und teilt sie dann in den neuesten Nutzer-Turn (user_msg) und vorherige Turns (chat_history) auf. Das Feld event.delta jedes AgentStream-Events enthält das nächste Textfragment, das direkt einem delta.content-Chunk im OpenAI-Stil entspricht. Nicht leere Deltas können unverändert weitergeleitet werden, was dies zur einfachsten Streaming-Brücke im Leitfaden macht. Der Stream enthält sowohl Orchestrierungs-Events wie Tool-Aufrufe und Ergebnisse als auch Sprach-Events wie Text-Deltas des Assistenten. Damit die Sprachausgabe sauber bleibt, behält der Proxy nur AgentStream-Events und überspringt leere Deltas.
[1] AgentStream (delta='') ← ignoriert[2] ToolCall ← ignoriert[3] ToolCallResult ← ignoriert[4] AgentStream (delta='Es') ← weitergeleitet ✓[5] AgentStream (delta=' kostet') ← weitergeleitet ✓[6] AgentStream (delta=' 49,99 $')← weitergeleitet ✓
Diese Trennung hält die Mechanik von Zwischen-Tools aus der gesprochenen Ausgabe heraus und bewahrt gleichzeitig inkrementelle Sprachausgabe mit niedriger Latenz. Der direkt einsetzbare Handler unten führt diese Schritte zusammen.
LlamaIndex macht weniger Vorgaben für End-to-End-Muster der Gesprächs-Runtime als Frameworks mit umfangreicheren integrierten Orchestrierungsschichten. Bei Produktionsbereitstellungen müssen Kunden daher typischerweise Session-Verwaltung, Antwort-Guardrails, Tool-Orchestrierung und Tracing selbst implementieren.
Fazit
Jedes Framework in diesem Leitfaden verbindet sich über denselben Vertrag mit ElevenLabs: Es akzeptiert eine Completions- oder Responses-Anfrage im OpenAI-Stil und streamt SSE-Chunks zurück. So können Teams mit minimalen Änderungen Sprachorchestrierung auf eine bestehende Agent-Implementierung aufsetzen. Sie erhalten damit, was sie bereits aufgebaut haben, und erschließen gleichzeitig Conversational AI in Echtzeit. Diese Modularität ist ein Grundprinzip der ElevenAgents-Plattform. Ganz gleich, ob Unternehmen einen bestehenden Agent erweitern oder von Anfang an sprachbasiert entwickeln: Die Sprachorchestrierung von ElevenAgents ist darauf ausgelegt, sie dort abzuholen, wo sie stehen.
Wenn Sie bereits einen Agent mit einem Open-Source-Framework betreiben und Sprache aktivieren möchten, probieren Sie diesen Ansatz aus und teilen Sie uns Ihre Erfahrungen mit.



