对话式 AI 智能体测试
- 发布时间
- 最近更新
当对话式 语音智能体 上线后,如何大规模监控?如何发现它们未按预期运行?完成修改后,又该如何测试?
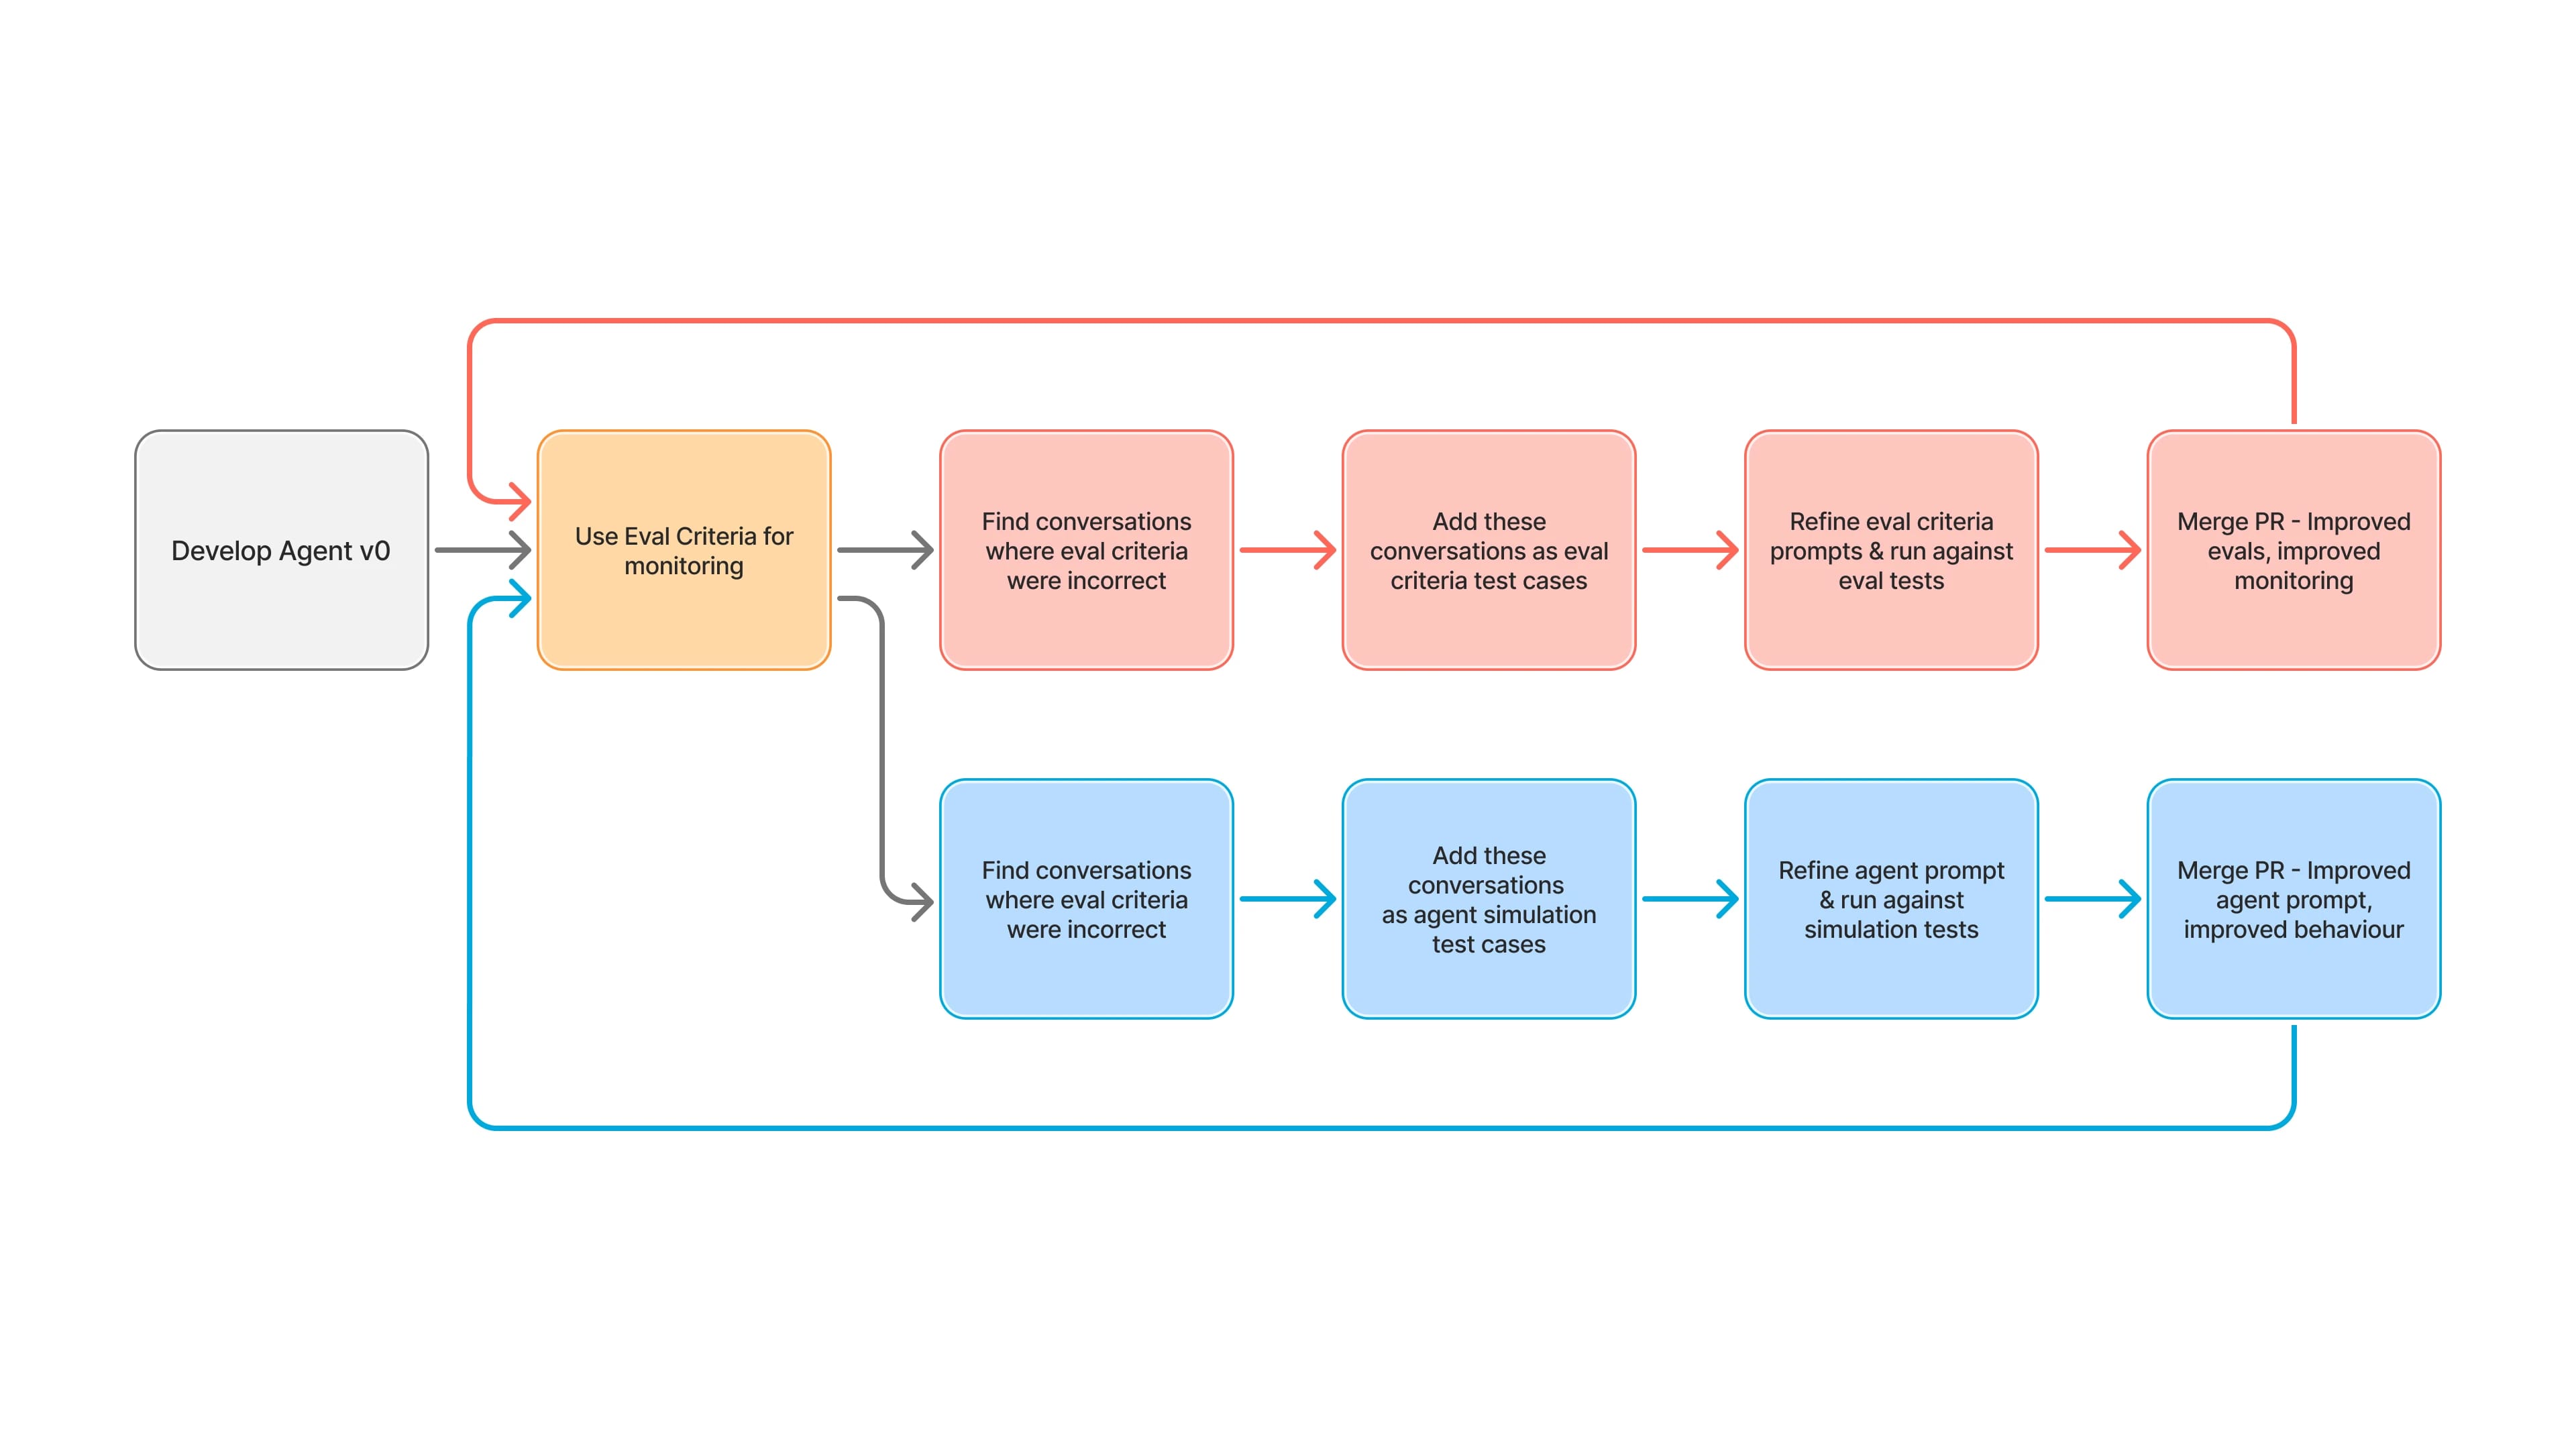
这些问题推动我们开发了 El,一款由 对话式 AI 驱动的文档助手。随着 El 不断发展,我们构建了一套基于评估标准和对话模拟的智能体监控、评估和测试系统。
奠定基础:可靠的评估标准
改进任何智能体,都要先了解它在实际使用中的表现。因此,我们不断完善评估标准,确保其足够准确可靠,可用于监控智能体表现。我们将失败对话定义为:智能体提供了错误信息,或未能帮助用户实现目标。
我们制定了以下评估标准:
- 互动:对话是否有效?用户是否提出了相关问题?对话是否合理?
- 正向互动: 用户是否满意离开,还是感到困惑或沮丧?
- 理解根本原因: 智能体是否正确识别出用户的根本问题?
- 解决用户咨询: 智能体是否解决了用户问题,或提供了其他支持方式?
- 幻觉: 智能体是否编造了知识库中不存在的信息?
如果互动未通过,对话本身就无效。若其他任一标准未通过,我们会进一步调查。调查结果会指导我们如何改进智能体。有时需要优化工具使用方式或时机,有时则需增加护栏措施,防止执行不受支持的操作。
放心迭代:对话模拟 API
确定改进方向后,下一步就是测试。这正是我们的 对话模拟 API 的用武之地。它可模拟真实用户场景,包括端到端场景和针对特定环节的场景,并使用与生产环境相同的标准自动评估结果。它支持工具模拟和自定义评估,能够灵活测试特定行为。
我们采用两种方式:
- 完整模拟:测试完整对话,从头到尾进行验证。
- 局部模拟: 从对话中途开始,验证决策点或子流程。这是我们进行单元测试的首选方式,支持快速迭代和针对性调试。
清晰、聚焦的场景让我们能够控制 LLM 的测试内容,确保覆盖边缘情况、工具使用和回退逻辑。
自动化扩展:将测试嵌入 CI/CD
最后一环是自动化。我们通过 ElevenLabs 的开放 API,将评估和模拟嵌入 CI/CD 流水线,与 GitHub DevOps 流程连接。每次更新都会在部署前自动测试,既能防止回归问题,也能快速获得真实环境表现的反馈。
成果:更强大、更智能的 El
这一流程改变了我们构建和维护 El 的方式。我们建立了一个反馈闭环,将实际使用情况与结构化评估、针对性测试和自动化验证相连,让我们能更快、更有信心地发布改进。
现在,这套框架可应用于我们构建的任何智能体。