Stream 搭建多模态 AI 智能体,集成 ElevenLabs
- 发布时间
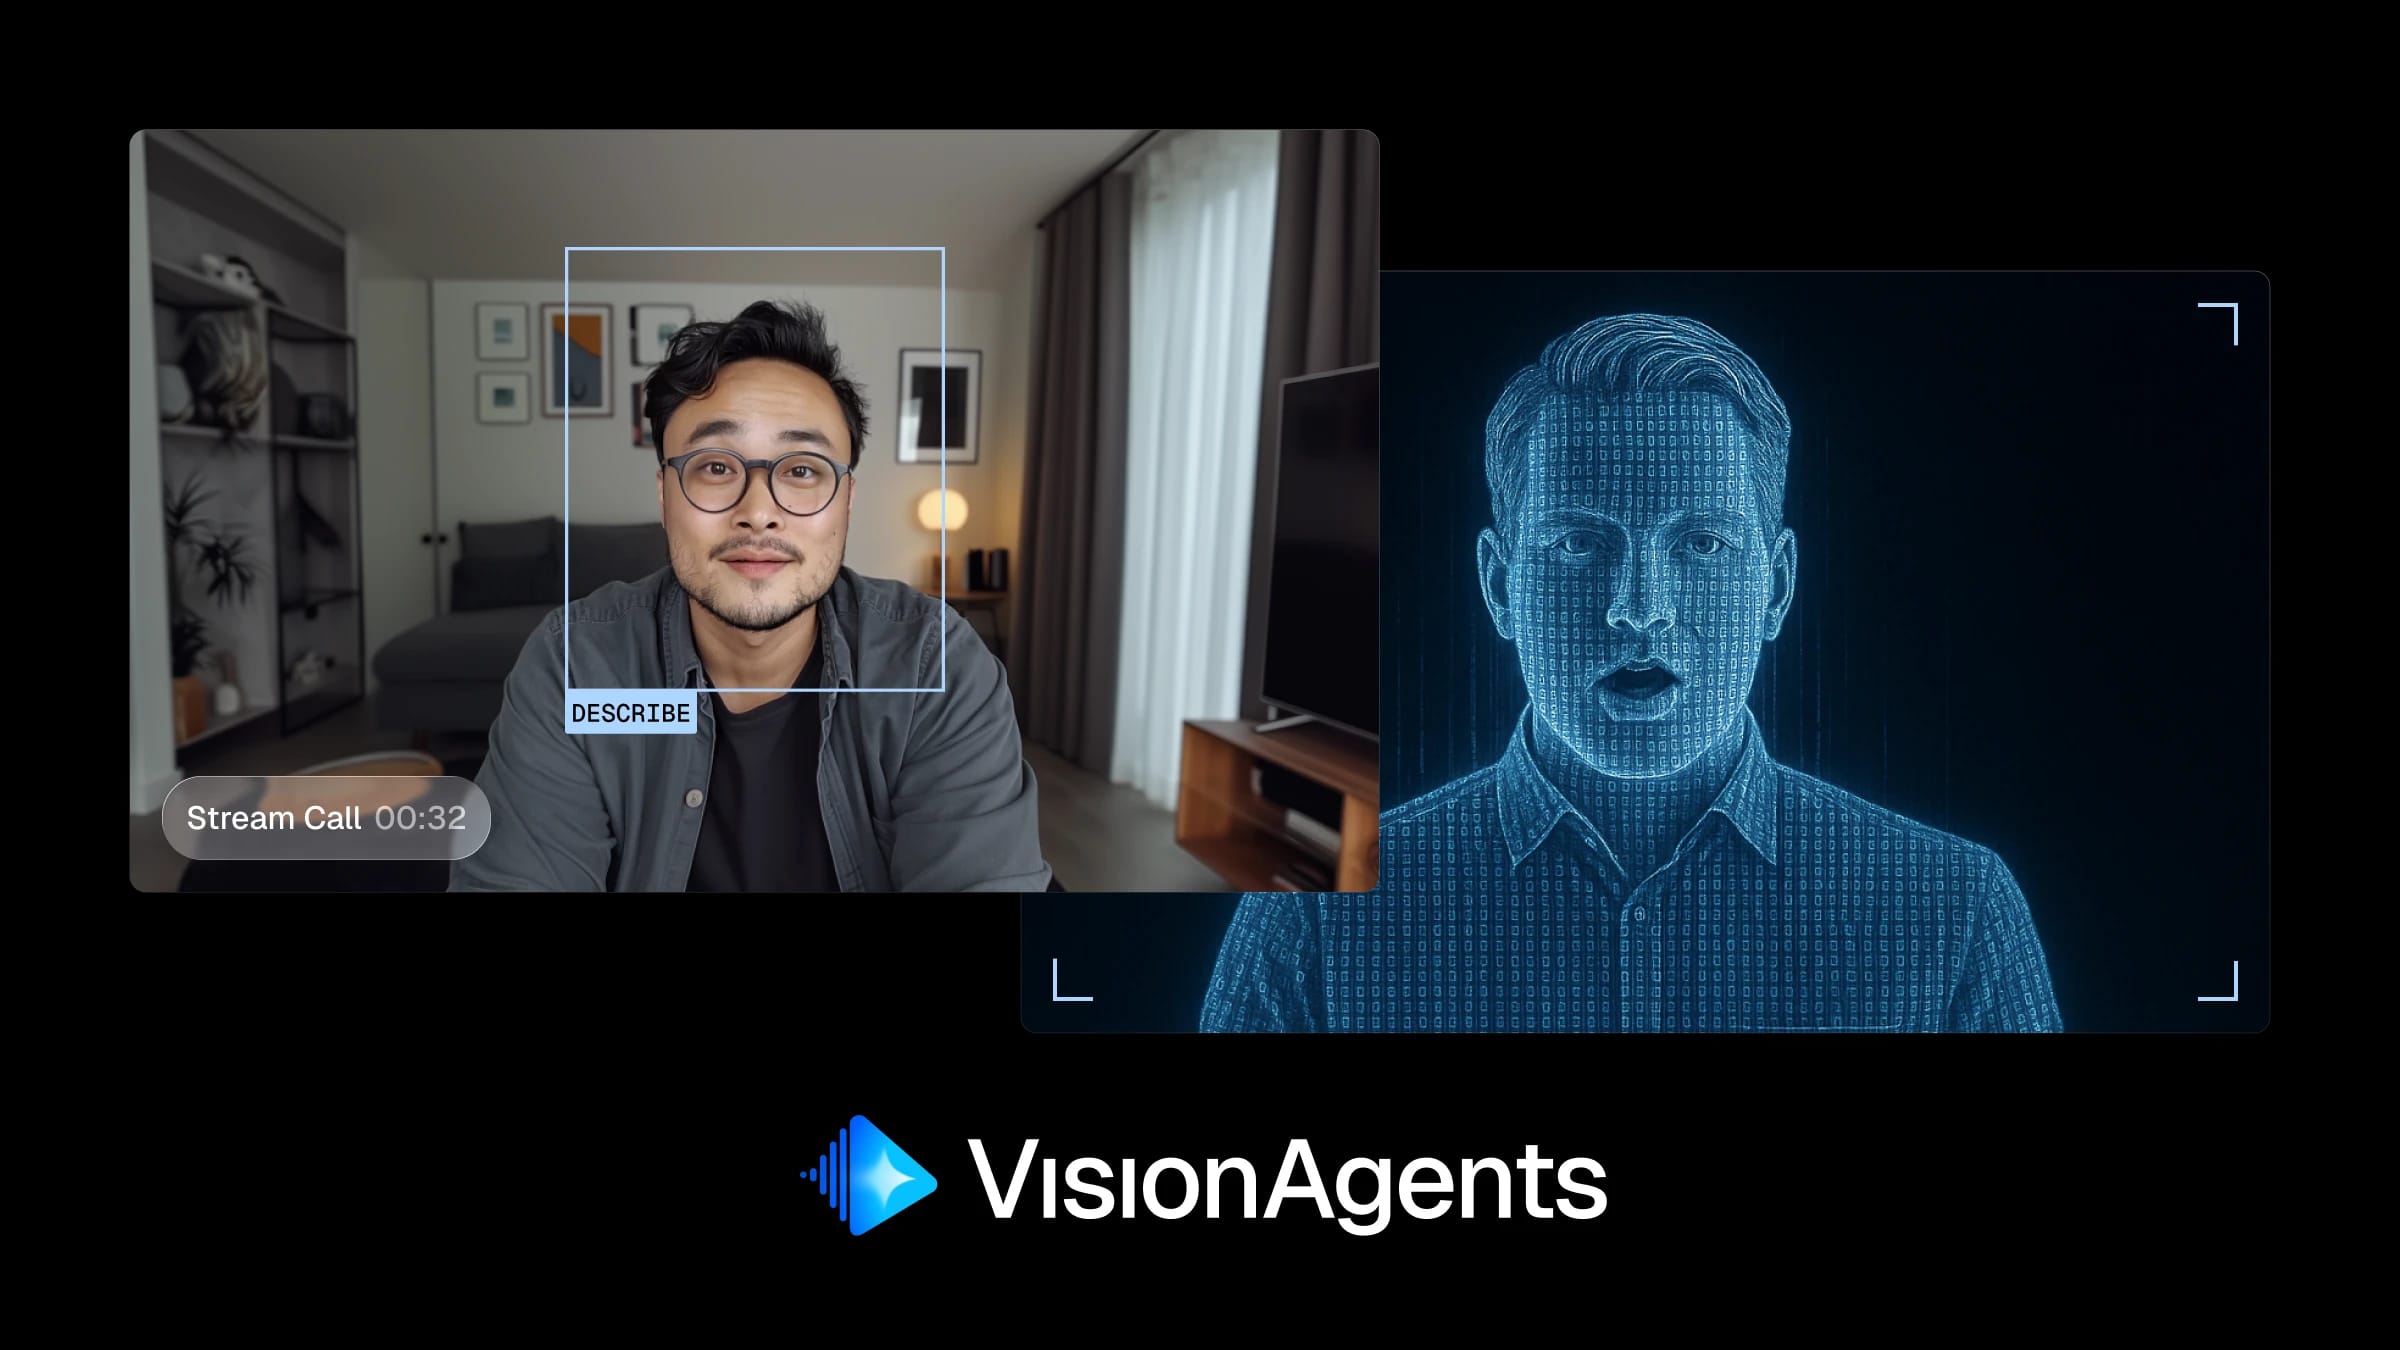
Stream 推出了 视觉智能体 —— 一个开源框架,帮助开发者打造低延迟的多模态 AI 体验,结合实时视频、音频和对话。该框架集成了 ElevenLabs文本转语音,为用户和 AI 系统之间的无缝互动提供富有表现力、响应迅速的语音。
实现实时多模态智能体
Vision Agents 让 AI 能够实时“看见”、听见并做出回应。基于 Stream 的视频和音频 SDK,框架为开发者原型设计和部署多模态智能体提供了低延迟基础。
在评估文本转语音服务商时,Stream 选择了 ElevenLabs,因其业界领先的音质和易用的集成体验——ElevenLabs 现已成为 Stream 用户的主要语音选择。
“ElevenLabs 让我们可以快速为 SDK 集成强大的文本转语音功能,
快速、可靠、开发者友好的集成
Stream 仅用几天就将 ElevenLabs 集成到全代码库,开发者几乎无需配置即可为 Vision Agents 添加拟真语音输出。集成带来了:
- 搭建速度提升 10 倍 —— 预集成 ElevenLabs 后,语音搭建代码量从 400 行减少到 40 行。
- 低延迟表现 —— ElevenLabs 的极速语音生成结合 Stream 全球边缘网络,确保响应自然流畅。
- 可扩展的开发体验 —— Stream 的 SDK 简化了多模态智能体的创建、测试和部署流程。
共建多模态 AI 的未来
Stream 的 Vision Agents 展示了 ElevenLabs 模型如何拓展多模态 AI 的可能性。结合视觉理解和 文本转语音,开发者可以打造不仅能“看”,还能“说”和“听”的智能体,接近真人流畅度。
想用文本转语音开发?欢迎联系 这里.
Fergal is on the Growth team at ElevenLabs, helping bring the company's research and products to more users. Previously, he worked on product and data at Entrepreneurs First, and spent two years at CloudKitchens building a new retail business vertical from the ground up. He studied at Yale University.