Przedstawiamy Scribe v3 i v3 Live — nasze najdokładniejsze modele zamiany mowy na tekst
- Autor
- Min Kim
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Produkty oparte na audio zaczynają się od transkrypcji: notatki ze spotkań, agenci głosowi, dubbing, dokumentacja kliniczna i archiwa transmisji obejmujące treści z wielu dekad. Ważne, by transkrypcja była poprawna za pierwszym razem, bo każdy błąd trafia dalej, gdzie jego poprawa kosztuje znacznie więcej.
Ale audio z rzeczywistego świata bywa chaotyczne. Kilka osób mówi jednocześnie na spotkaniu, klient stoi na ruchliwej ulicy i robi pauzę w połowie zdania albo podczas rozmowy z pomocą techniczną żadna ze stron nie mówi w swoim pierwszym języku.
Dziś ElevenLabs wprowadza dwa nowe modele Speech to Text stworzone właśnie z myślą o takich warunkach:
- Scribe v3 do nagranego audio popełnia o 27% mniej błędów słownych niż Scribe v2 w 102 językach i ma najdokładniejsze etykiety mówców ze wszystkich testowanych przez nas modeli,
- Scribe v3 Live to wariant o niskim opóźnieniu do dźwięku w czasie rzeczywistym, który popełnia o 43% mniej błędów niż Scribe v2 Realtime. Po raz pierwszy oferuje też diarizację mówców (oznaczanie, kto co powiedział) i lepsze wykrywanie końca wypowiedzi.
Scribe v3 Live jest już dostępny w ElevenAgents. Oba modele są też dostępne w ElevenAPI, gdzie przejście z Scribe v2 wymaga zmiany identyfikatora modelu w jednej linijce.
Opinie, które ukształtowały Scribe v3
Scribe obsłużył setki milionów godzin transkrypcji dla aplikacji do notatek ze spotkań, centrów kontaktowych, narzędzi do dokumentacji klinicznej i agentów głosowych. Zespoły korzystające z niego w różnych zastosowaniach stale prosiły o te same pięć rzeczy.
Zespoły tworzące narzędzia do spotkań i notatek chciały lepszej diarizacji przy szybkiej wymianie zdań i co najmniej trzech mówcach. Zespoły agentów głosowych mówiły, że licznik ciszy przerywa rozmówcom, gdy zatrzymują się w połowie zdania lub zwalniają, by podać numer. Zespoły tworzące produkty na żywo rezygnowały z dokładności na rzecz szybkości, bo tryb realtime wyraźnie ustępował przetwarzaniu wsadowemu. Klienci w Indiach chcieli, by hindi dorównywał angielskiemu, nawet gdy rozmówcy zmieniają język w połowie zdania. Wielu chciało też mieć większą kontrolę nad wynikiem — od zapisu liczb jako „123” po listy kluczowych terminów wystarczająco długie dla katalogu produktów lub listy nazw leków.
Etykiety mówców, wykrywanie tur rozmowy i większa kontrola nad wynikiem
Diarizacja, która sprawdza się w zatłoczonym pomieszczeniu
W transkrypcji spotkania właściwe wskazanie mówcy jest równie ważne jak poprawne słowa. Scribe v3 popełnia o 17% mniej błędów diarizacji niż Scribe v2 w nagraniach z co najmniej trzema mówcami — czyli tam, gdzie większość obecnych modeli zawodzi. Scribe v3 Live po raz pierwszy wprowadza też diarizację do transkrypcji w czasie rzeczywistym, z o 39% mniejszą liczbą błędów diarizacji niż kolejny najlepszy testowany przez nas model realtime.
Wykrywanie tur rozmowy, które słucha konwersacji
Aby rozmowy brzmiały naturalnie, agenci głosowi muszą trafnie przewidywać, kiedy mówca skończył mówić. Tradycyjne systemy zmiany tur rozmowy opierają się na okresach ciszy. Sama cisza wymusza jednak kompromis: krótki próg może przerwać osobę, która robi pauzę w środku zdania, a długi sprawia, że agent wydaje się powolny. Scribe v3 Live wykorzystuje kontekst rozmowy i audio, dzięki czemu rozmówca, który zatrzymuje się w połowie podawania numeru, nie zostanie przerwany. To to samo wykrywanie tur rozmowy, z którego korzysta już ElevenAgents — teraz dostępne także w ElevenAPI.
Większa kontrola nad językami, terminologią i formatowaniem
Scribe v3 potrafi wywnioskować, jakie języki może zawierać nagranie, i pozwala wybrać, czy liczby mają być zwracane jako cyfry czy słowa. Podpowiedzi dotyczące kluczowych terminów obsługują do 1000 znanych ci terminów, takich jak nazwy marek, akronimy i żargon, a edycje transkrypcji stosują reguły formatowania zapisane prostym angielskim, np. „zapisuj każdą datę jako RRRR-MM-DD”.
Scribe v3 Live dodaje tryb wielojęzyczny do rozmów, w których język zmienia się w połowie zdania. Dodaje też bibliotekę kluczowych terminów dla słownictwa zbyt obszernego na listę. Podczas gdy podpowiedzi dotyczące kluczowych terminów obejmują te, o których wiesz, że padną, biblioteka przechowuje tysiące terminów, które mogą paść, a model sprawdza ją tylko wtedy, gdy usłyszy prawdopodobne dopasowanie.
Jak wypada Scribe v3
ElevenLabs porównało oba modele z Scribe v2, Scribe v2 Realtime i innymi popularnymi modelami Speech to Text, oceniając każdy na tych samych zbiorach danych. Dokładność wielojęzyczną zmierzyliśmy na wewnętrznej wersji benchmarku FLEURS, który testuje krótką, czystą, odczytaną mowę w 102 językach. FLEURS nie mierzy diarizacji, ponieważ każdy klip ma jednego mówcę, dlatego stworzyliśmy też własny zbiór danych z prawdziwych spotkań, rozmów z agentami i notatek głosowych w 16 językach. Wkrótce udostępnimy go jako open source.
Diarizacja mówców
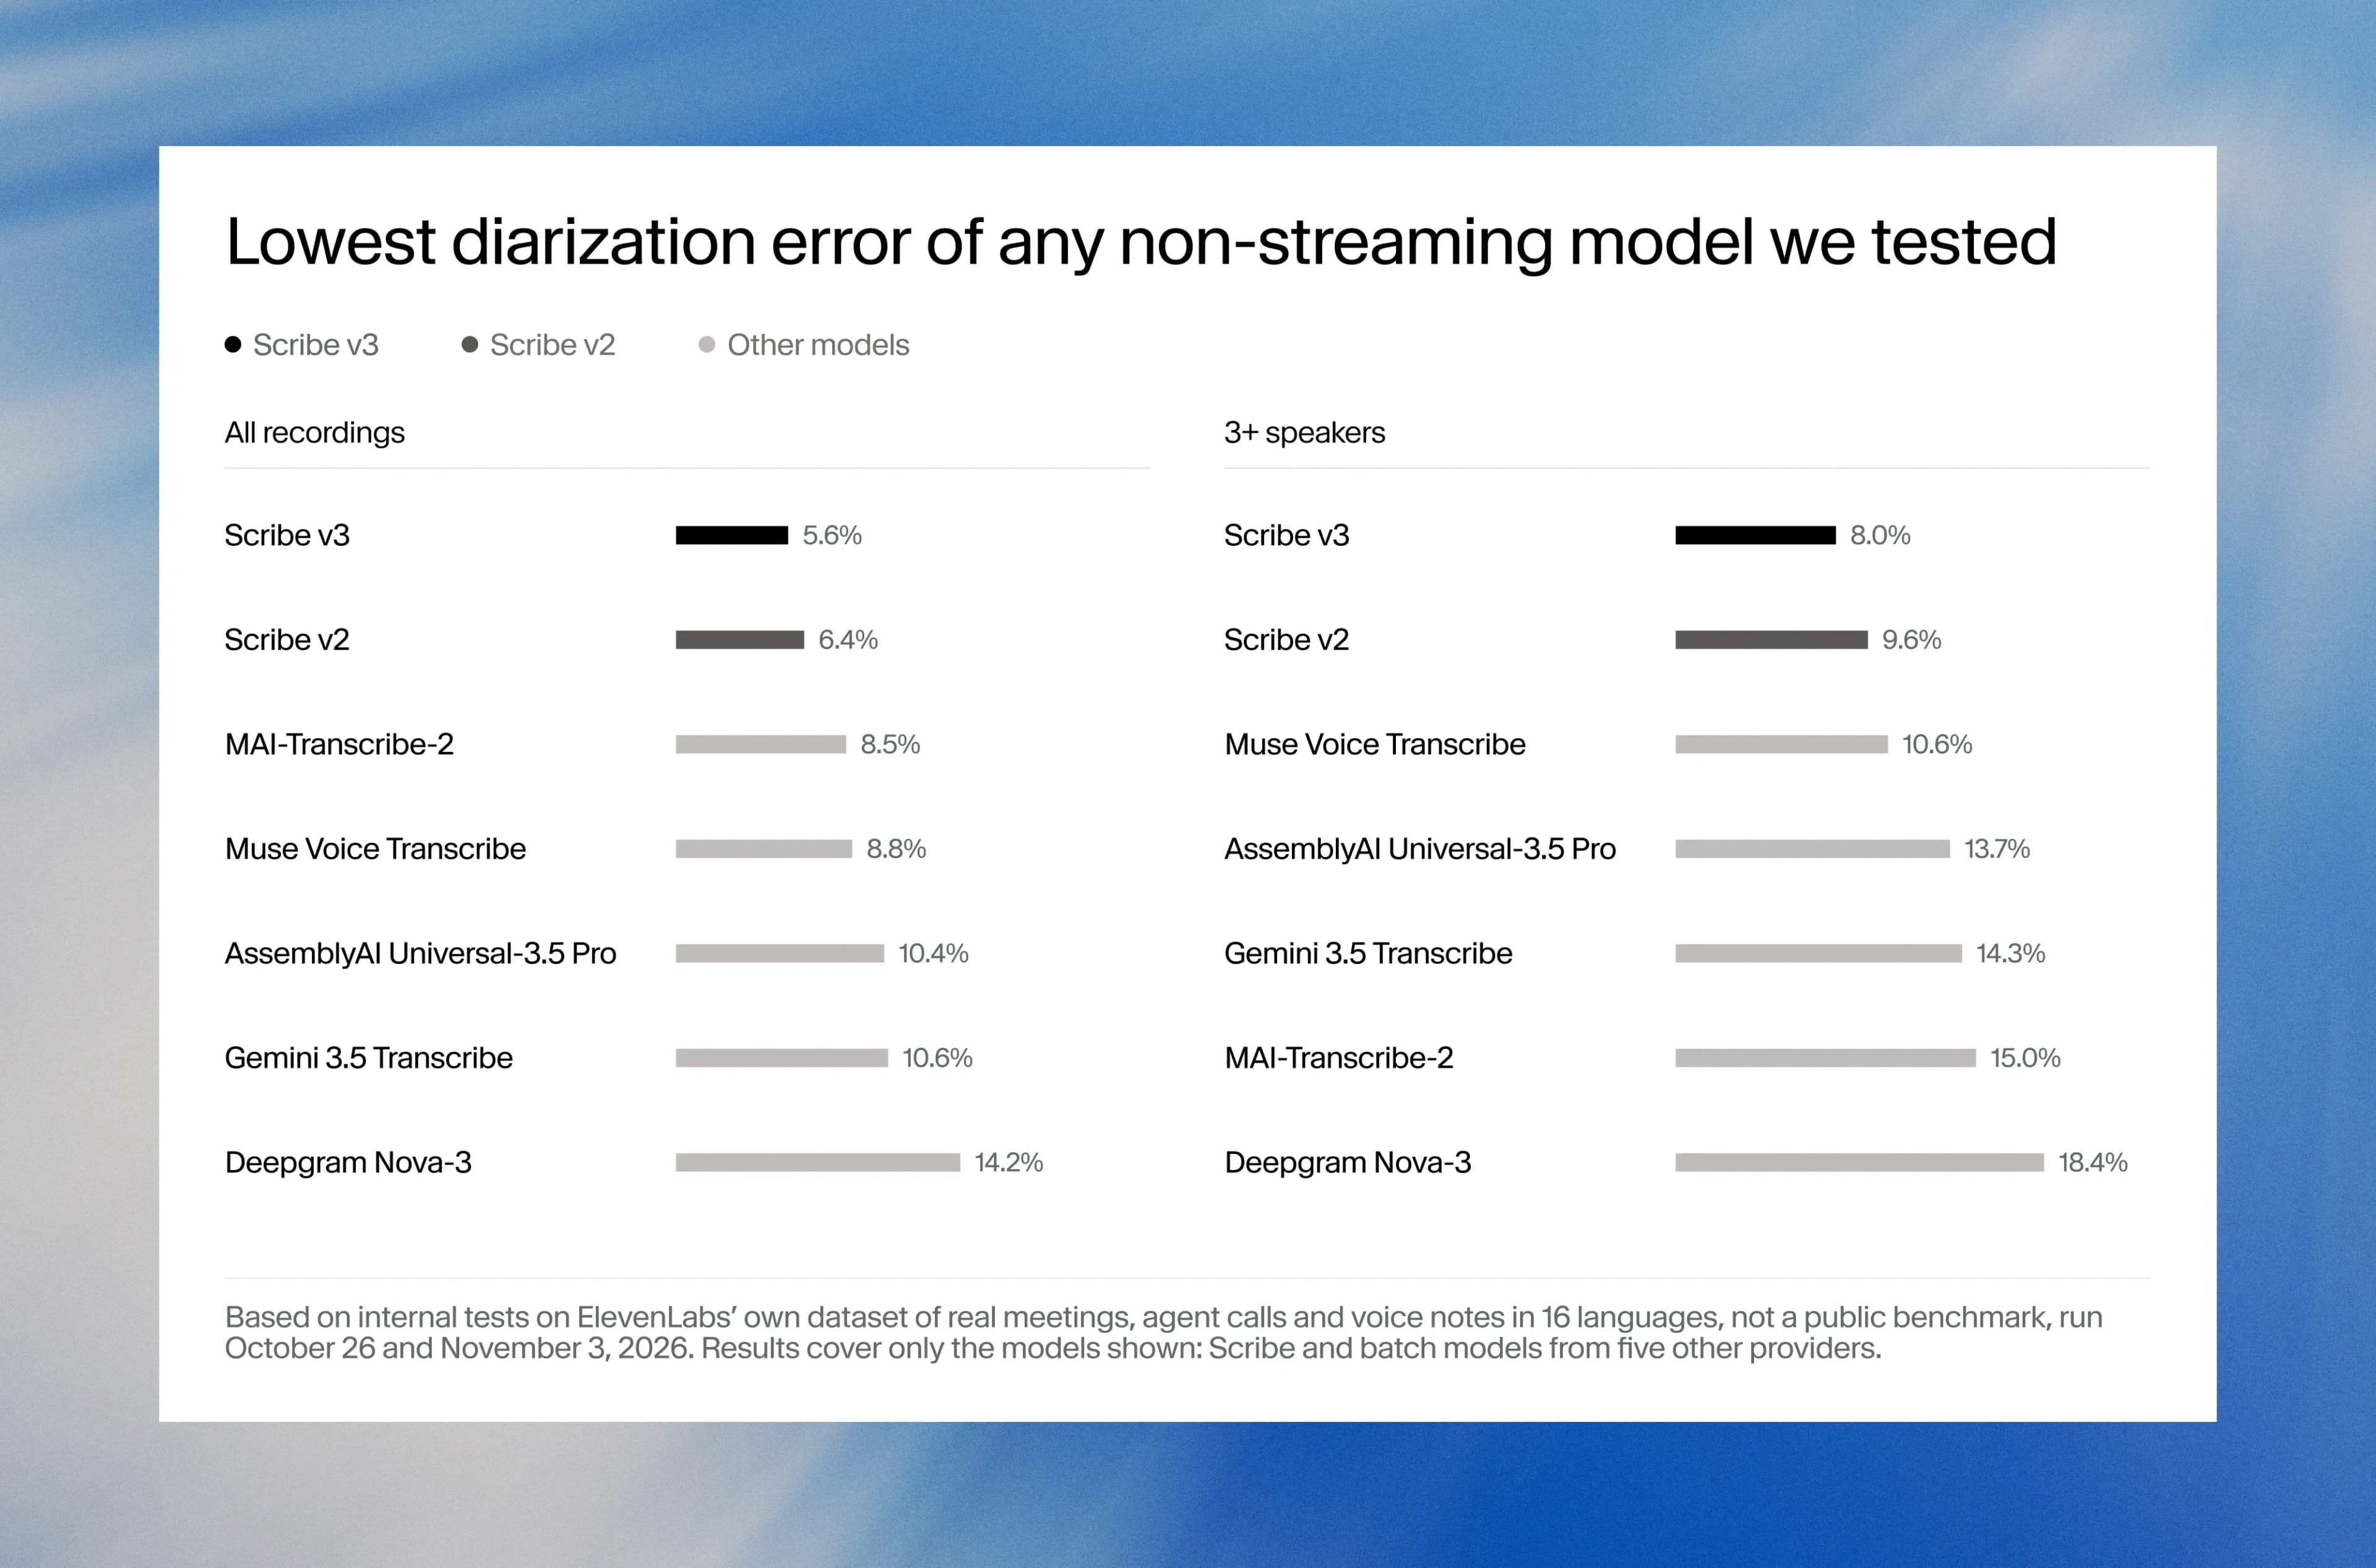
Scribe v3 ma najniższy błąd diarizacji ze wszystkich testowanych przez nas modeli: o 12% mniej błędów niż Scribe v2 ogółem i o 17% mniej w nagraniach z co najmniej trzema mówcami.
Dokładność wielojęzycznej transkrypcji
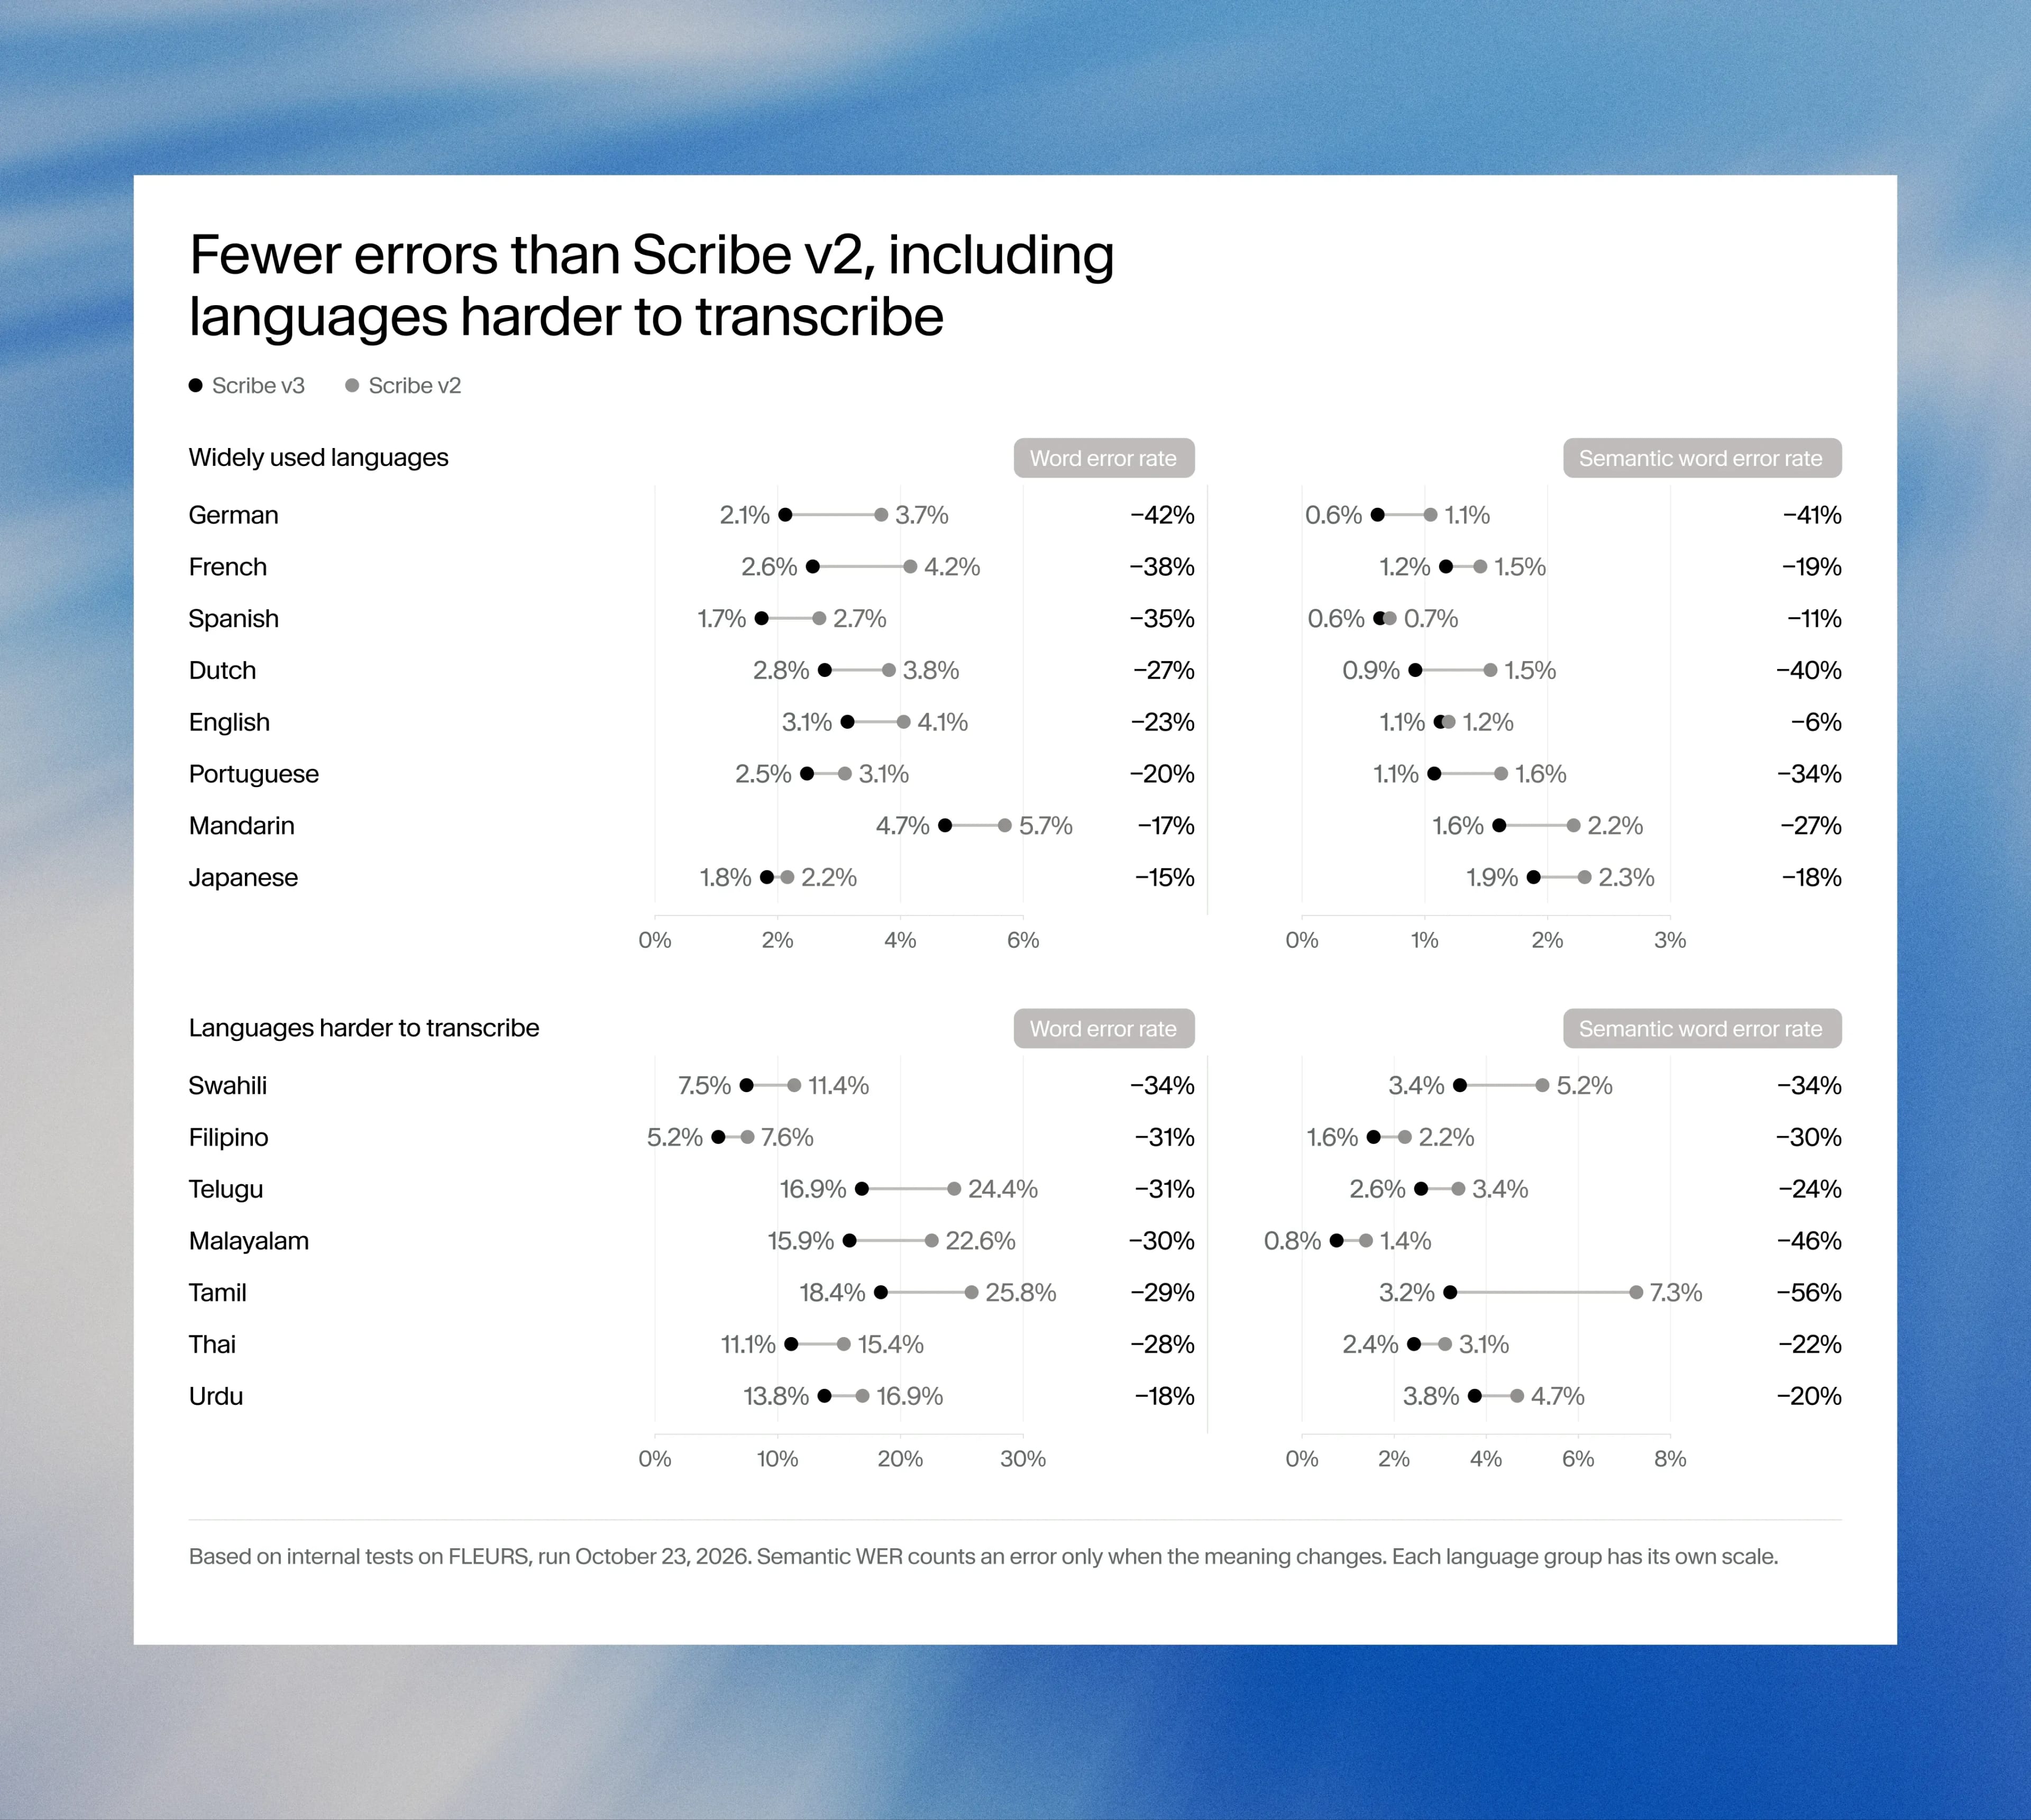
Podajemy wskaźnik błędów słownych (WER) obok semantycznego WER, który liczy błąd tylko wtedy, gdy zmienia się znaczenie transkrypcji.
W 102 językach w FLEURS Scribe v3 zmniejsza WER o 27% w porównaniu z Scribe v2 i poprawia wyniki w każdym testowanym języku. W językach łatwiejszych do transkrypcji niemiecki poprawił się o 42%, hiszpański o 35%, a angielski o 23%. Poprawa jest większa w językach trudniejszych do transkrypcji: suahili o 34%, tamilski o 29%, a tajski o 28%.
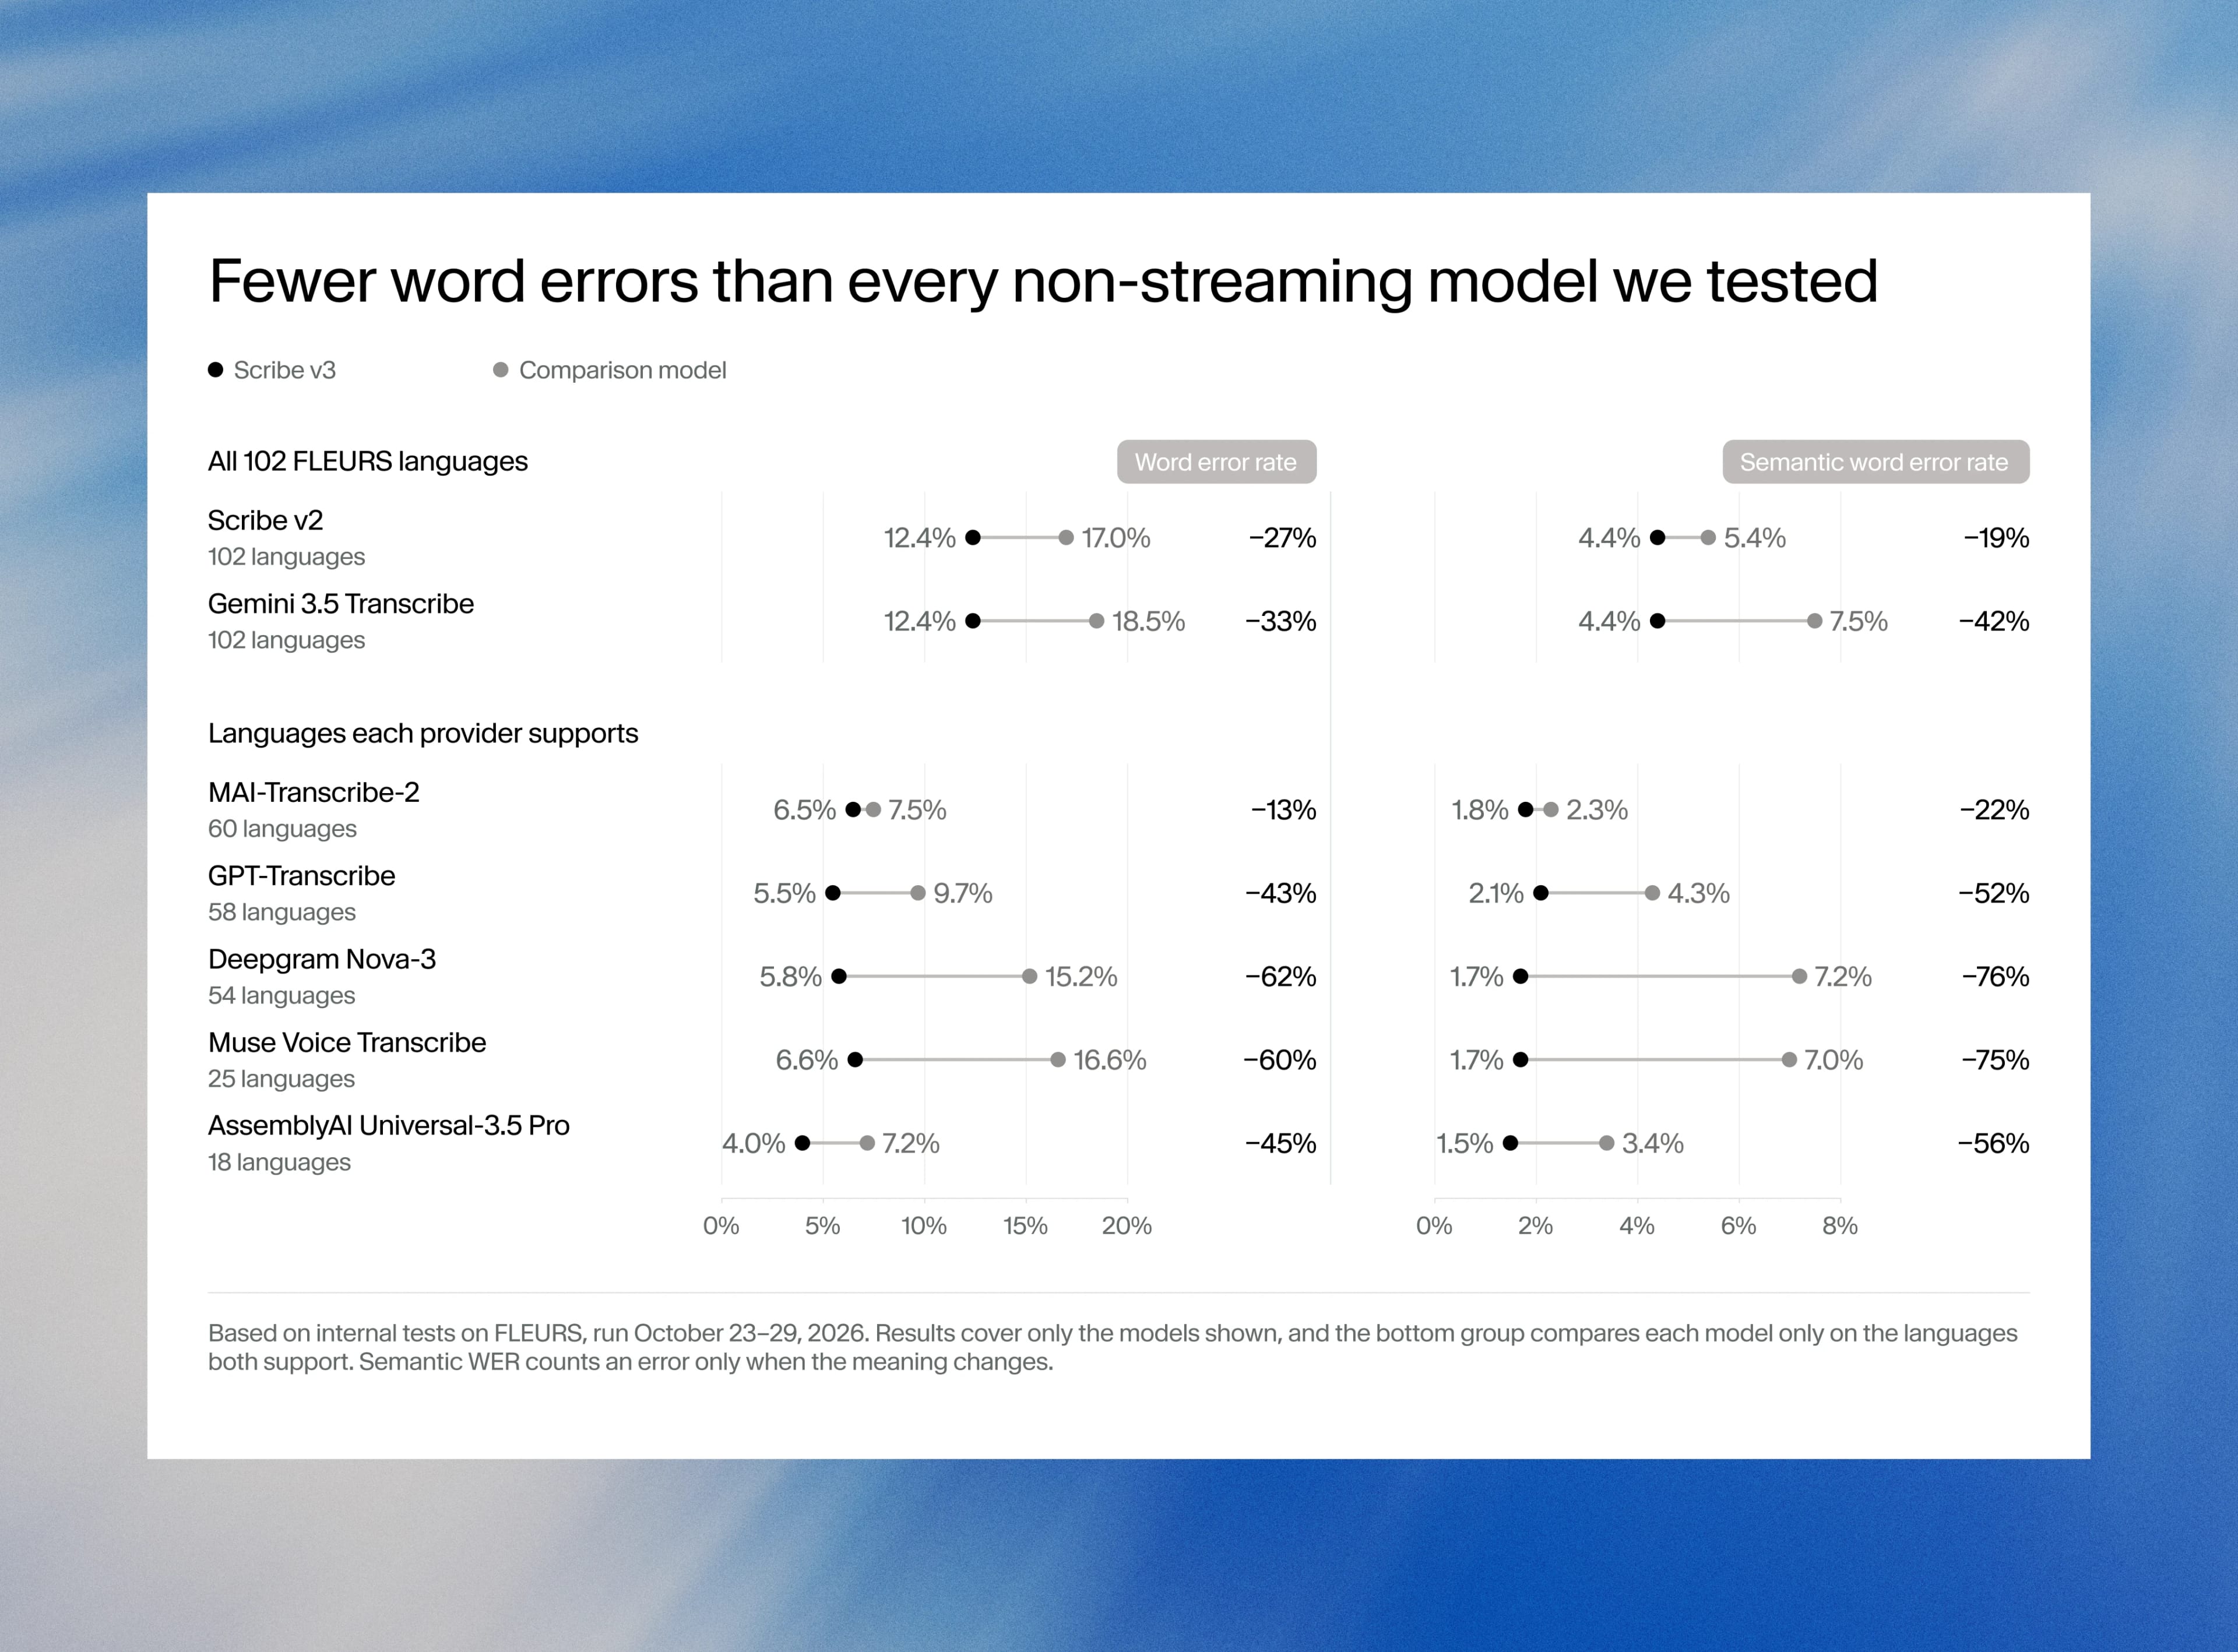
Scribe v3 popełnia też mniej błędów słownych niż każdy inny testowany przez nas model wsadowy (niestreamingowy), przy porównaniu w językach obsługiwanych przez oba modele.
Diarizacja mówców w czasie rzeczywistym
W angielskiej części naszego 16-językowego zbioru danych z rzeczywistych sytuacji Scribe v3 Live osiąga błąd diarizacji na poziomie 3,1%, wobec 5,9–7,3% dla innych testowanych przez nas modeli realtime.
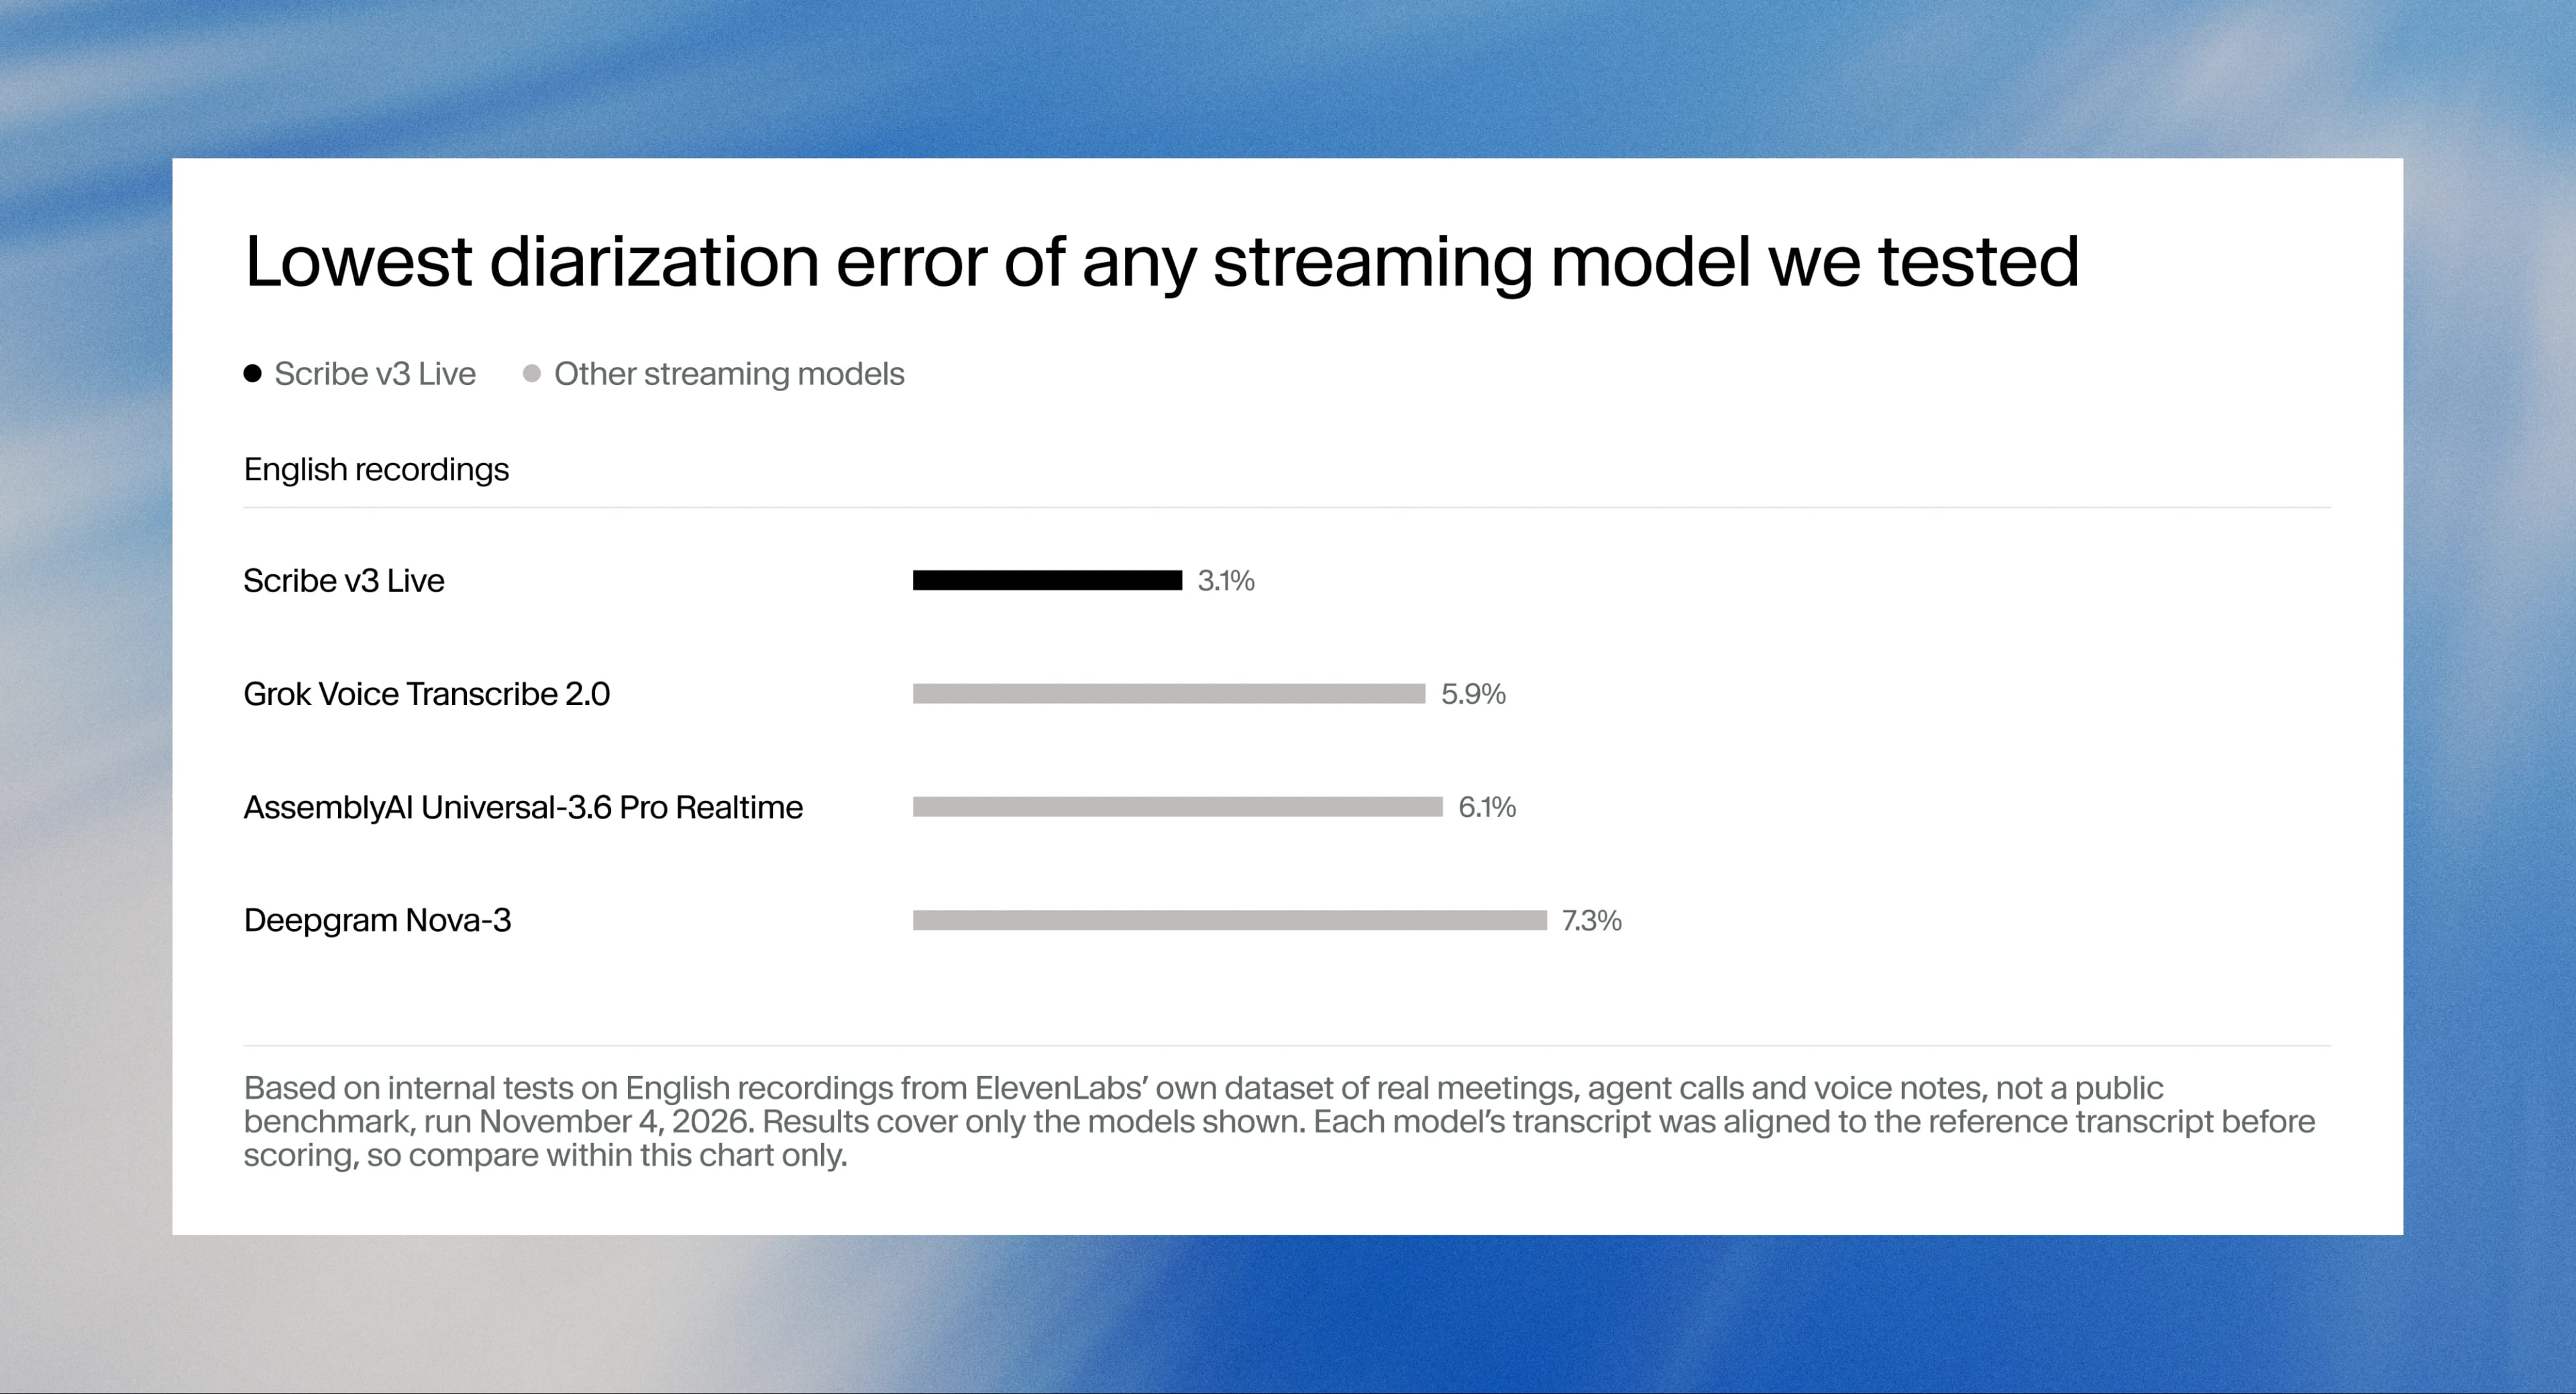
Standardowe wyniki diarizacji uwzględniają też błędy transkrypcji, takie jak pominięte słowa, a modele realtime pomijają więcej słów niż modele wsadowe. Aby zmierzyć tylko to, czy każde słowo przypisano właściwemu mówcy, przed oceną dopasowaliśmy transkrypcję każdego modelu do wzorca. Obniża to wskaźnik błędów każdego modelu, więc tych wyników nie można porównywać z wynikami diarizacji wsadowej powyżej.
Dokładność wielojęzyczna w czasie rzeczywistym
W przypadku modeli realtime na pierwszym miejscu podajemy semantyczny WER. Model streamingowy zapisuje tekst, zanim usłyszy całe zdanie, a każdy dostawca inaczej formatuje po drodze liczby, interpunkcję i wielkość liter. Standardowy WER liczy te różnice jako błędy, nawet gdy znaczenie jest takie samo, dlatego semantyczny WER jest uczciwszym porównaniem.
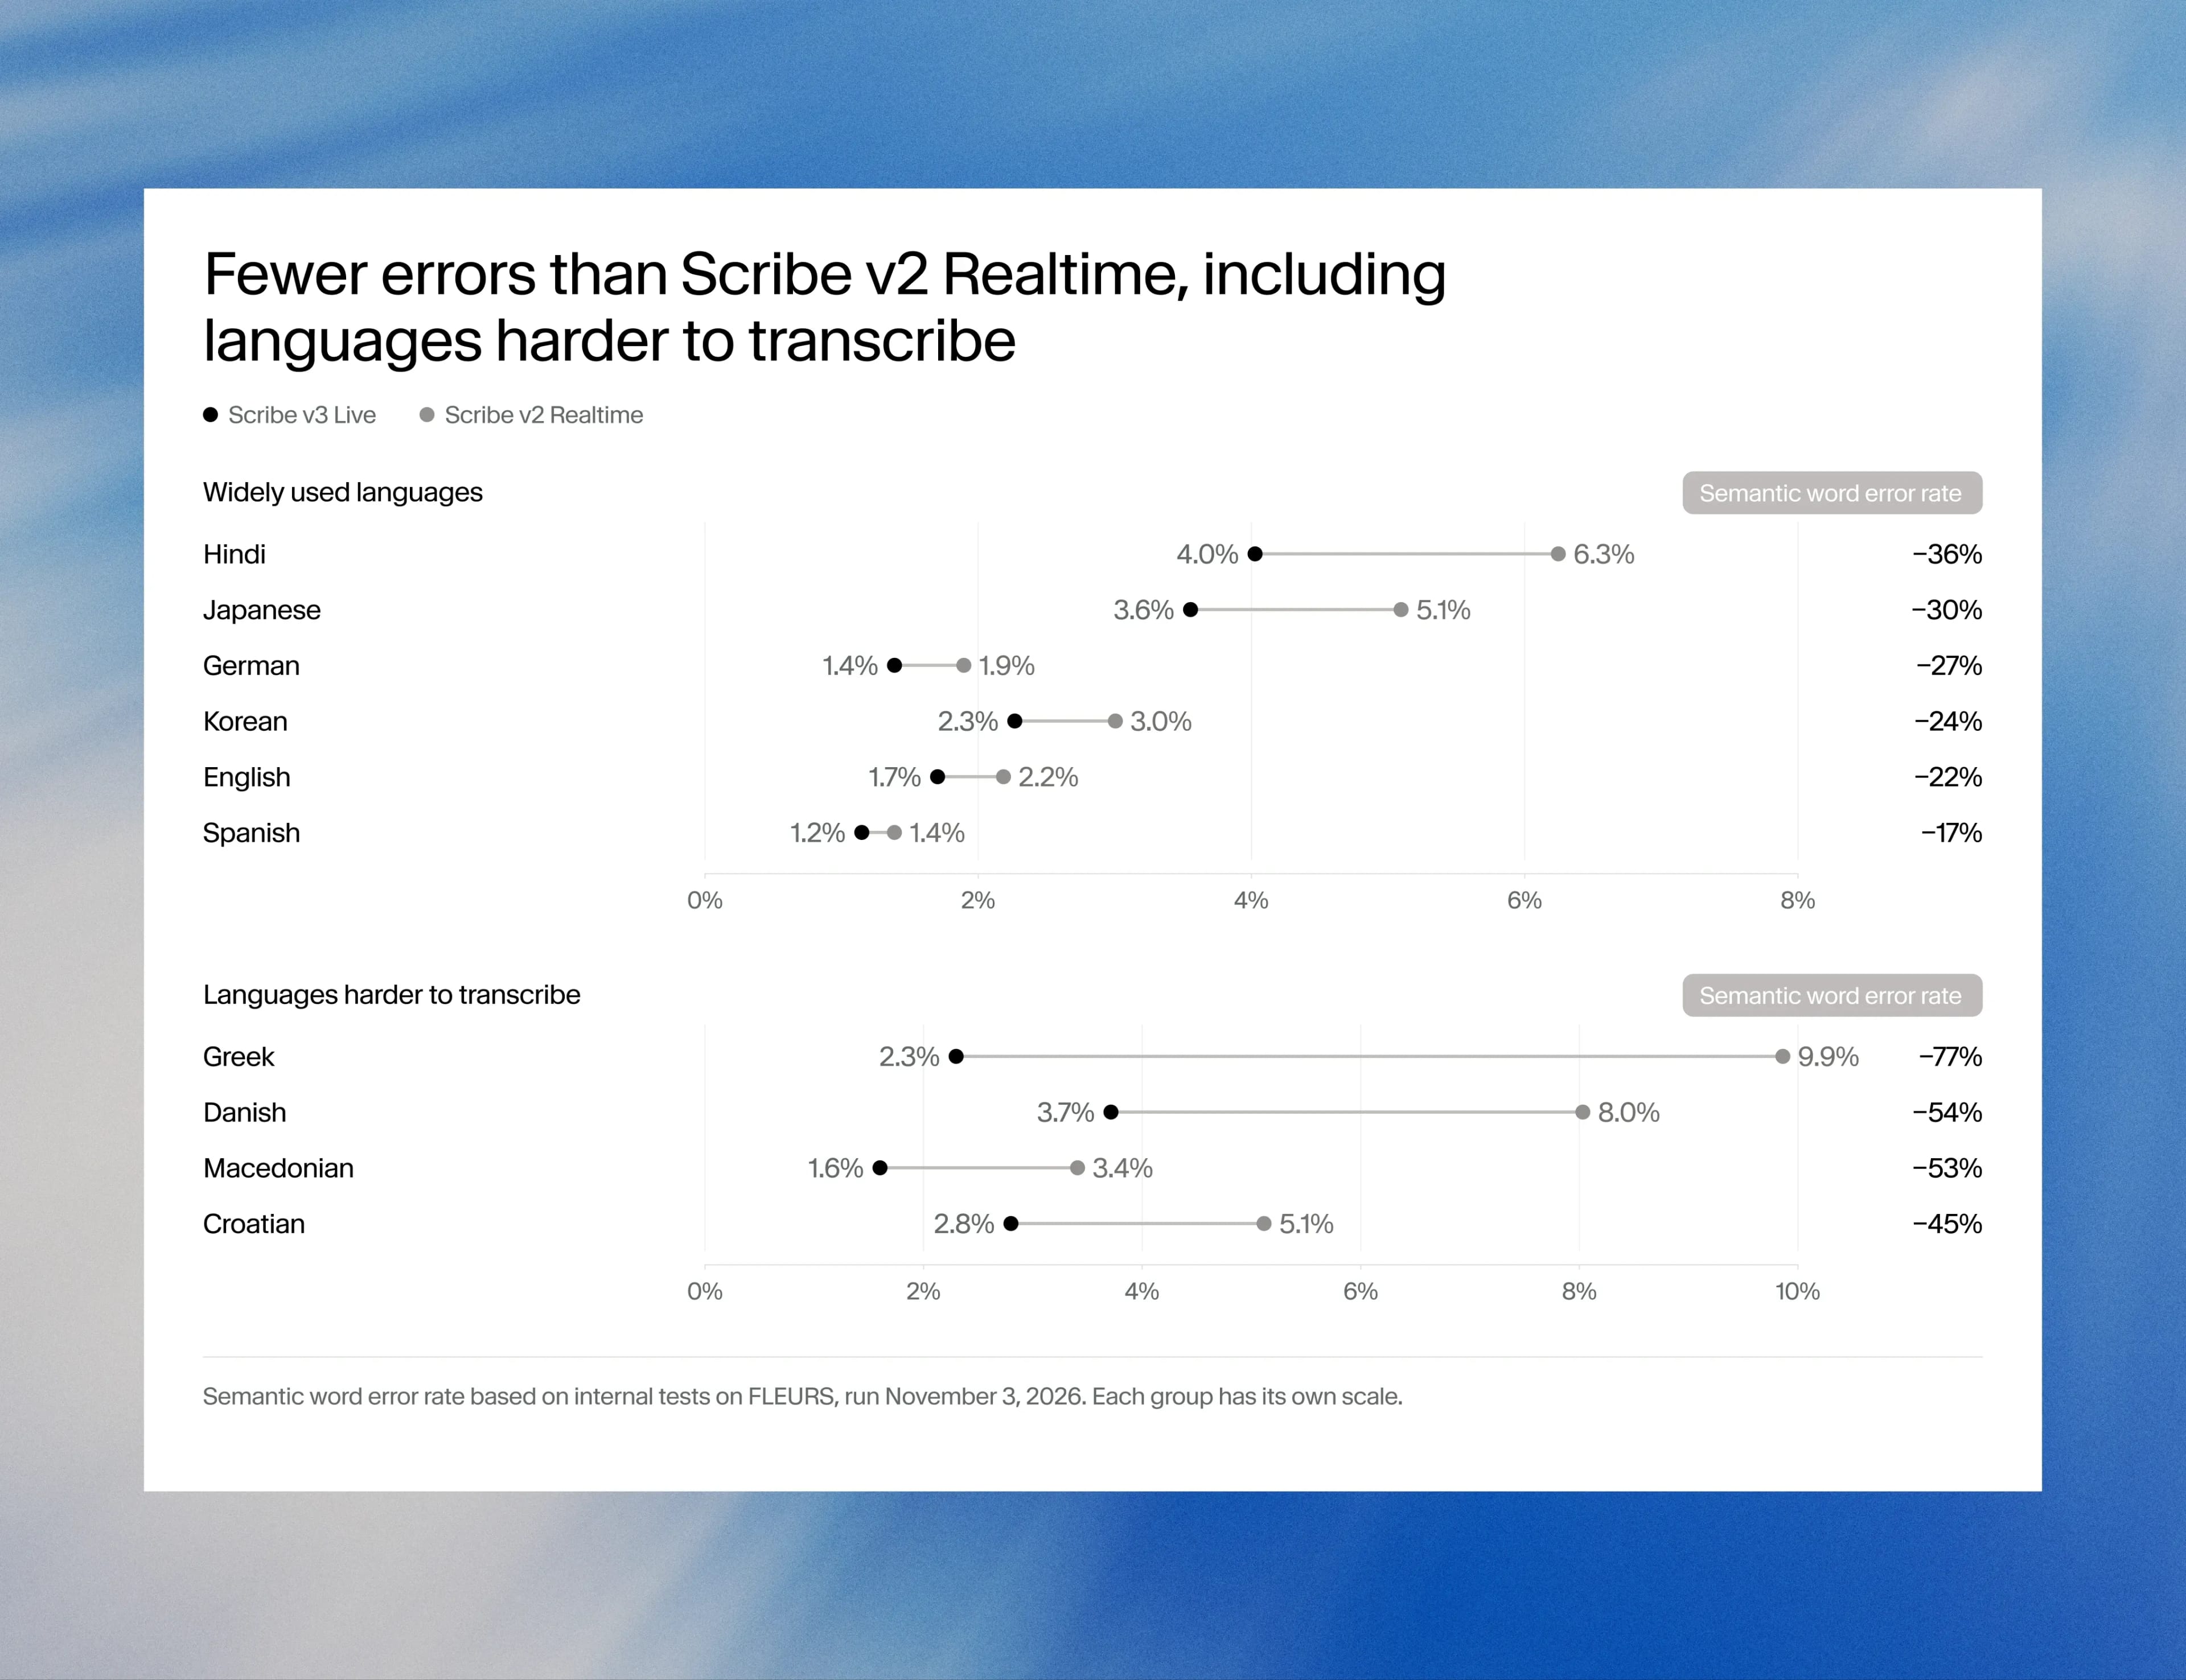
W 102 językach Scribe v3 Live zmniejsza semantyczny WER o 43%, a WER o 31% w porównaniu z Scribe v2 Realtime. Poprawia wyniki w każdym języku i ma niższy wskaźnik błędów niż każdy inny testowany przez nas model realtime.
Największa poprawa występuje tam, gdzie transkrypcja realtime dotąd pozostawała w tyle: grecki poprawia się o 77%, duński o 54%, chorwacki o 45%, a hindi o 36%.
Uwaga o metodzie: każdy język ocenialiśmy osobno przed wyliczeniem średniej, więc wszystkie 102 języki mają równą wagę. W wielu opublikowanych wynikach wszystkie klipy łączy się w jeden wynik, co zwykle daje niższe wartości, dlatego wyników mierzonych różnymi metodami nie można bezpośrednio porównywać.
Ile warte jest kilka punktów dokładności
Każdemu premierowemu modelowi towarzyszą wartości procentowe — temu także — lecz na papierze trudno ocenić, co kilka punktów oznacza w rzeczywistych sytuacjach. Godzinne spotkanie przy 150 słowach na minutę to około 9000 słów, więc różnica między wskaźnikiem błędów słownych 4% a 2% to 180 błędnych słów, czyli trzy na każdą minutę mówienia. Błąd diarizacji mierzy się czasem, a nie słowami, więc na tym samym spotkaniu każdy punkt oznacza 36 sekund wypowiedzi przypisanej do niewłaściwej osoby.
Koszt tych błędów zależy od tego, gdzie wystąpią. W transkrypcji podcastu błędne słowo to literówka, ale w rozmowie o wynikach finansowych „piętnaście” usłyszane jako „pięćdziesiąt” trafia do modelu analityka. Błędy skupiają się też wokół nazw, liczb, akronimów i żargonu — czyli dokładnie tych słów, które podsumowanie lub agent musi rozpoznać poprawnie.
Poprawnie za pierwszym razem w ElevenAgents
Agenci głosowi odczuwają to najmocniej, ponieważ pojedyncza źle usłyszana cyfra może uniemożliwić weryfikację rozpoczynającą rozmowę. Eneco, dostawca energii dla ponad 2 milionów domów i firm w Holandii, korzysta ze swojego agenta głosowego w ElevenAgents i przetestował na nim Scribe v3 Live przed premierą. W prawdziwych rozmowach z klientami agent poprawnie rozpoznawał holenderskie kody pocztowe za pierwszym razem o 40% częściej, a numery domów o 15% częściej.
„ElevenLabs to prawdziwy partner Eneco. Wspólnie z ich inżynierami wdrożeniowymi dalej ulepszamy naszego agenta głosowego” — powiedział Ruud Huigsloot, Senior Product Manager w Eneco. „Wspaniale widzieć tak wyraźne rezultaty już na tym etapie i z entuzjazmem czekamy na dalszą współpracę.”
Stworzone dla firm
Scribe v3 i Scribe v3 Live działają domyślnie w USA, a dla klientów biznesowych z wymogami dotyczącymi rezydencji danych są oferowane w odizolowanych środowiskach w UE, Indiach i Singapurze. Zero Retention Mode usuwa audio i tekst zaraz po zakończeniu żądania. Oba modele są objęte naszymi programami SOC 2, ISO 27001 i PCI DSS Level 1, kwalifikują się do HIPAA z umową Business Associate Agreement i są dostępne do prywatnego wdrożenia.
Zacznij już dziś
Scribe v3 Live jest dostępny w ElevenAgents, a v3 i v3 Live są domyślnymi modelami w aplikacji ElevenLabs. Zarejestruj się, aby go wypróbować.
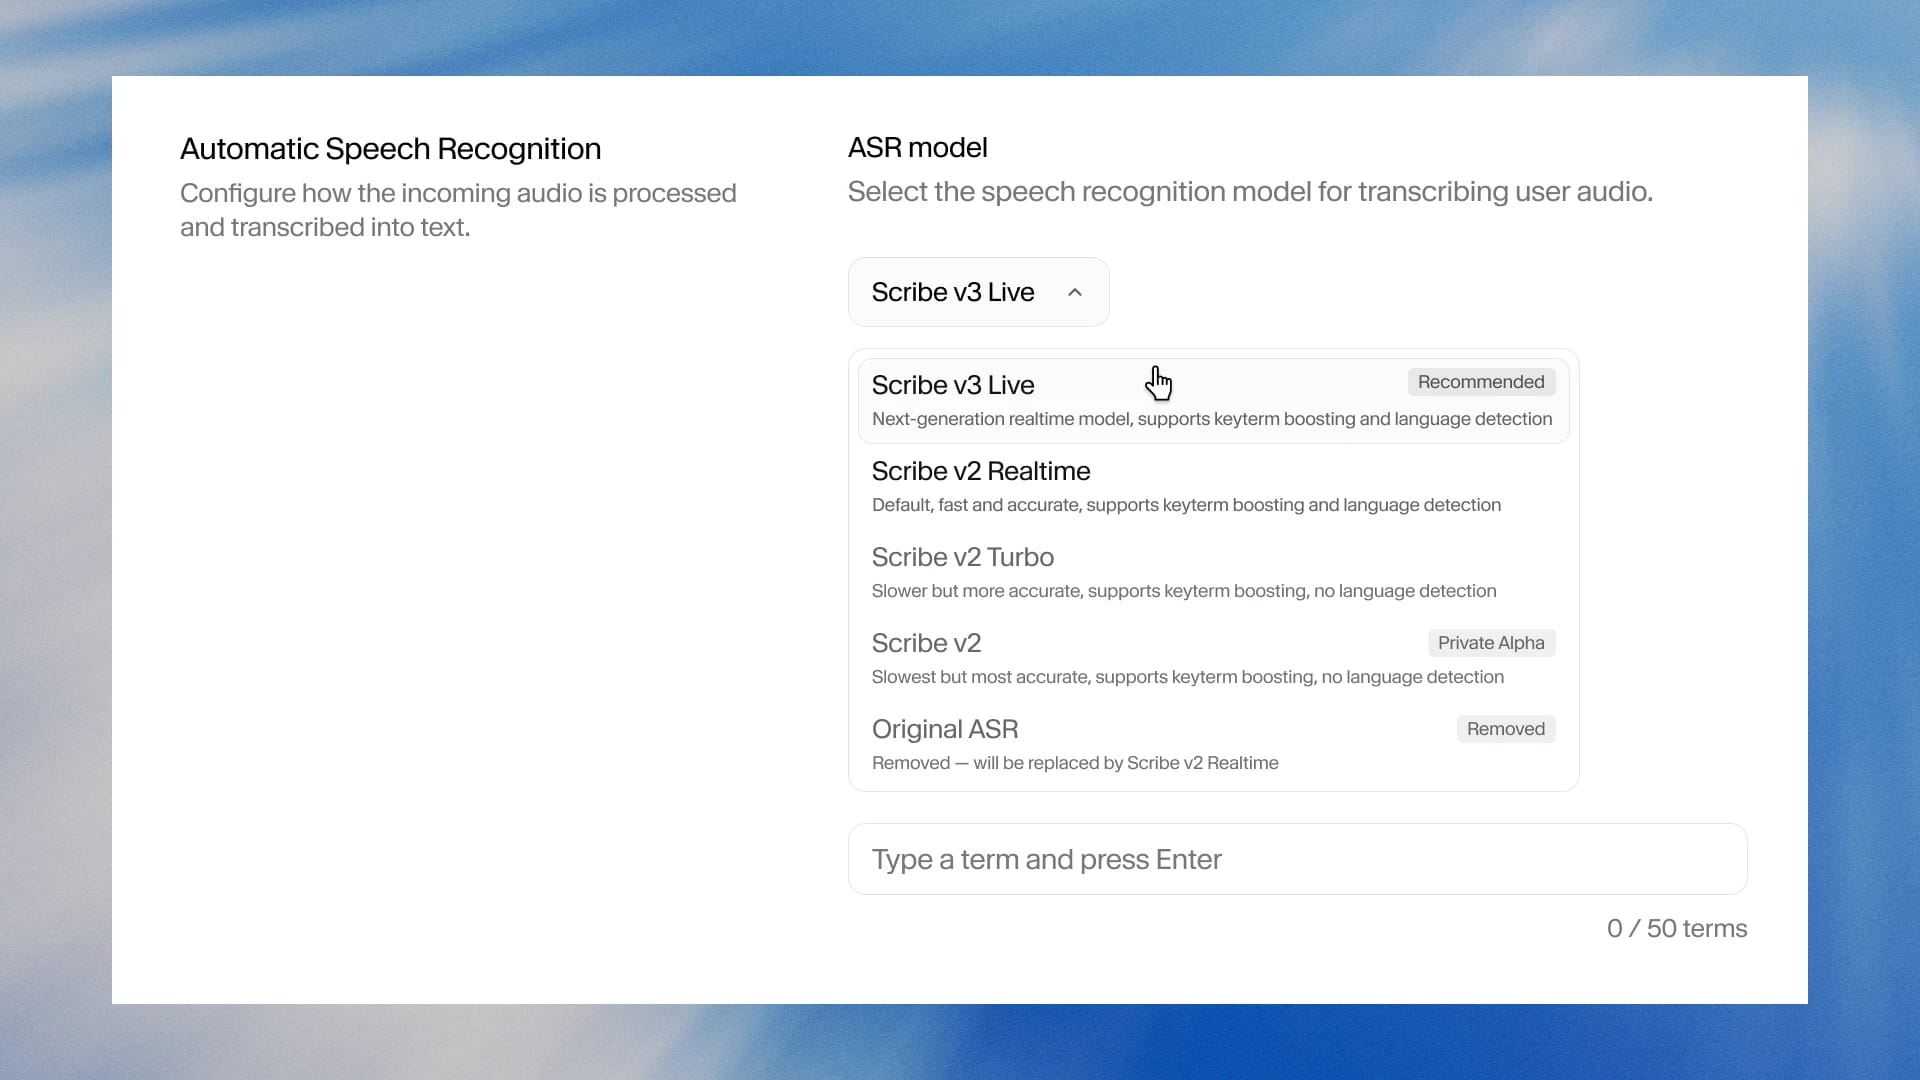
Oba modele są już dostępne także w ElevenAPI. Istniejące integracje można zaktualizować, zmieniając identyfikator modelu na scribe_v3 lub scribe_v3_live.
Dla zespołów medycznych udostępniamy też wersję Scribe v3 Live zoptymalizowaną pod rozmowy medyczne w ElevenAgents.