대화형 AI 지연 시간이란 무엇이며, 무엇이 영향을 미치나요?
- 게시일
- 최종 업데이트
대화형 AI에서 대화형 AI의 지연 시간은 좋은 애플리케이션과 뛰어난 애플리케이션을 가르는 요소입니다.
대화형 AI는 본질적으로 인간과 대화하는 것과 같은 느낌을 재현하고자 합니다. 이를 위해 동일한 감정 표현의 폭, 음높이, 리듬을 모방합니다. 여기에 말을 멈춘 순간부터 AI 에이전트가 응답을 시작하는 순간까지 자연스럽게 느껴지는 지연을 더하면, 실제 인간의 소통 방식에 기반한 지연 시간 목표가 만들어집니다.
대규모로 대화형 AI 에이전트를 배포하려는 기업은 이러한 자연스러운 경험을 구현하려면 지연 시간을 최대한 줄여야 합니다. 이 글에서는 대화형 AI 지연 시간이 무엇인지, 전체 파이프라인에서 지연이 발생하는 원인은 무엇인지, 그리고 이를 줄이는 방법을 개괄적으로 살펴봅니다.
요약
- 대화형 AI 지연 시간은 사용자가 말을 멈춘 순간부터 에이전트의 첫 마디를 듣는 순간까지의 전체 엔드투엔드 지연 시간입니다.
- 700ms를 넘는 에이전트는 부자연스럽게 느껴질 수 있으며, 1,200ms를 넘으면 이탈률이 높아집니다.
- 지연 시간은 대화형 AI 파이프라인의 모든 단계에서 누적됩니다.
- ElevenAgents는 단일 통합 아키텍처에서 전체 파이프라인을 처리하여, 기업이 저지연 대화형 AI를 쉽게 활용할 수 있도록 합니다.
대화형 AI 지연 시간이란 무엇인가요?
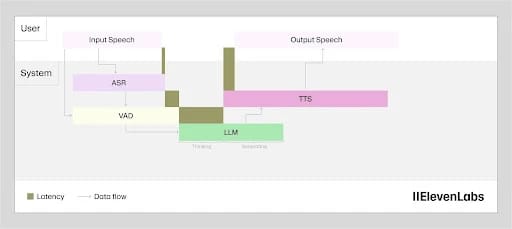
대화형 AI 지연 시간이란 말을 한 뒤 시스템이 응답하기까지 걸리는 총시간을 말합니다. 최신 AI 모델에서 지연 시간은 ms 단위로 측정됩니다. 내부적으로 총 지연 시간은 엔드투엔드 파이프라인의 일부를 담당하는 여러 개별 프로세스로 구성됩니다.
일반적인 대화형 AI 파이프라인은 다음과 같습니다.
- 사용자가 말합니다
- 음성이 음성-텍스트 변환 모델로 전사됩니다
- 전사본이 응답을 생성하는 LLM 모델로 전달됩니다
- 그런 다음 LLM의 텍스트가 텍스트 음성 변환 모델로 오디오로 합성됩니다
- 이후 오디오가 사용자에게 재생됩니다
이 모든 단계는 대화형 AI 시스템에 지연 시간을 더합니다. 따라서 지연 시간을 논의할 때는 몇 가지 서로 다른 약어를 구분할 필요가 있습니다.
모델 추론 지연 시간
모델 추론 지연 시간은 모든 외부 요인을 제외하고 내부적으로 측정한, 모델이 출력을 생성하는 데 소요하는 시간입니다. 일반적인 입력에서 엔진이 얼마나 빠르게 작동하는지를 나타내는 모델별 측정값입니다. 예를 들어 Flash v2.5의 모델 추론 지연 시간은 약 75ms입니다. 이를 통해 경쟁사 모델 간 속도를 비교할 수 있습니다.
다만 이것은 사용자가 실제로 경험하는 지연 시간 수치가 아니라는 점을 기억해야 합니다. 이는 모델이 출력을 생성하는 데 걸리는 총시간만을 나타냅니다.
LLM 첫 토큰 생성 시간
대규모 언어 모델(LLM)의 첫 토큰 생성 시간(TTFT)은 대규모 언어 모델이 프롬프트를 처리하고 처음으로 사용할 수 있는 출력 토큰을 생성하기까지 걸리는 총시간입니다.
TTS 생성은 LLM에서 첫 토큰이 도착하면 시작됩니다. 따라서 이는 LLM이 TTS 모델 실행을 시작하도록 프롬프트하는 데 걸리는 시간을 측정합니다. 대부분의 엔드투엔드 대화형 AI 시스템에서 LLM TTFT는 전체 지연 시간 중 상당한 비중을 차지합니다.
TTS 첫 오디오 생성 시간(TTFA)
TTS 첫 오디오 생성 시간(TTFA)은 첫 TTS 요청부터 첫 오디오 청크가 실제로 모델에서 나올 때까지의 시간을 측정합니다. 모델 추론 지연 시간을 설명하는 방식이지만, 특히 TTS 엔진에 해당합니다.
엔드투엔드 첫 오디오 생성 시간(TTFA)
엔드투엔드 TTFA는 전체 대화형 AI 지연 시간입니다. 이는 음성 인식, LLM TTFT, TTS, TTFA 및 단계 간의 모든 네트워크 전송을 포함한 파이프라인 각 부분의 합입니다. 대화형 AI 지연 시간을 전체적으로 논의할 때, 이것이 사용자가 체감하는 지표입니다.
사용자가 말을 하면 에이전트의 응답을 듣기 전까지 엔드투엔드 TTFA를 기다리게 됩니다. 이는 종합적인 측정값으로, 파이프라인의 어느 부분이든 개선하면 함께 개선됩니다.
대화형 AI 지연 시간이 중요한 이유
사용자가 AI 에이전트와 대화할 때 지연 시간은 그 경험을 평가하는 핵심 요소가 됩니다. 지연 시간이 짧으면 응답 대기 시간이 줄어들어 대화가 자연스럽게 느껴지고 에이전트도 더 유능해 보입니다.
응답 품질이 같더라도 지연 시간이 긴 에이전트는 인위적이고 덜 유능하게 느껴집니다. 기업의 경우 불과 수백 ms 차이도 영원처럼 느껴질 수 있으며, 고객 지원 에이전트가 투박하고 비효율적으로 느껴지게 합니다.
대화형 AI 지연 시간이 실제로 중요한 이유를 보여주는 몇 가지 시나리오는 다음과 같습니다.
- 500ms 미만: 대화형 에이전트가 반응성이 뛰어나고 매끄럽게 느껴집니다. 사용자는 말을 멈춘 때와 첫 응답을 받는 때 사이의 지연을 알아차리지 못할 수 있어, 대화가 자연스럽게 이어집니다.
- 500ms~1000ms: 사용자가 말을 멈춘 때와 응답을 받는 때 사이의 지연이 체감되기 시작할 수 있습니다. 약간 길기 때문에 사용자는 같은 말을 반복하거나, 에이전트가 실제로 이해했는지 확인하려고 잠시 멈추는 등 미리 대응하려 할 수 있습니다.
- 1000ms 초과: 지연이 느리게 느껴지기 시작하며, 일부 사용자는 AI 에이전트가 대화 속도를 완전히 따라가지 못한다고 느낄 수 있습니다. 전사본에는 간헐적인 끼어들기나 상담원 연결 요청이 나타날 수 있습니다. 경우에 따라 사용자는 통화를 중단할 수 있습니다.
이러한 각 임계값은 실제 비즈니스 성과로 이어집니다.
지연 시간 범위의 낮은 쪽에서는 고객 서비스 에이전트가 들어오는 질문을 자연스럽게 처리하고, 추가 도움 없이 사용자의 문의 해결을 도울 수 있습니다. 이는 상담원의 부담을 덜고 고객 만족도를 높게 유지합니다. 반대로 지연 시간이 길면 지나치게 오래 망설이는 것처럼 보이는 에이전트로 인해 고객을 답답하게 만들 수 있습니다.
다른 글에서 음성 에이전트 지연 시간 예산 벤치마크를 정의하여 P50 및 P95 값 모두에서 우수한 지연 시간이 어떤 모습인지 설명했습니다.
대화형 AI 지연 시간의 원인은 무엇인가요?
대화형 AI 지연 시간은 여러 프로세스를 포괄하는 용어이며, 각 구간이 전체에 기여합니다. 따라서 저지연을 위한 병목 현상은 단순히 더 나은 모델을 선택해서 해결되는 문제가 아니라 시스템 수준의 문제입니다. 여러 모델이 파이프라인에서 상호작용하기 때문입니다.
개발자를 위해 음성 에이전트 지연 시간 최적화에 관한 심층 기술 가이드를 작성했습니다. 이를 활용해 엔드투엔드 첫 오디오 생성 시간(TTFA)의 모든 단계를 개선할 수 있습니다.
핵심 파이프라인 외에도 전화 통신 및 함수 호출 같은 요소는 모델 인프라 내부에 속하지 않더라도 지연 시간을 더합니다.
다음은 대화형 AI 지연 시간에 영향을 주는 모든 요소의 개요입니다.
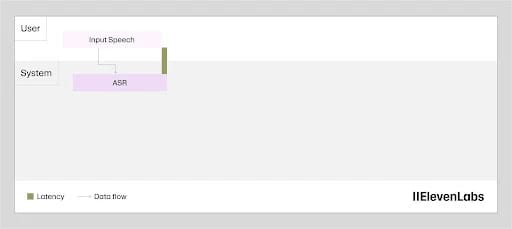
자동 음성 인식
음성 인식 지연 시간은 전사본을 생성하는 데 걸리는 시간이 아닙니다. 사용자가 말하는 동안 전사 프로세스는 백그라운드에서 실행되므로, 발화가 끝날 때쯤에는 텍스트가 대부분 준비되어 있습니다.
여기서의 지연 시간은 실제로 발화가 끝난 시점과 전사본이 확정되어 다음 단계로 전달되는 시점 사이의 간격입니다. Scribe v2 Realtime은 지속적인 스트리밍으로 턴이 끝나는 즉시 출력이 준비되도록 하여 이 간격을 약 150ms로 줄입니다.
턴 테이킹 및 엔드포인팅
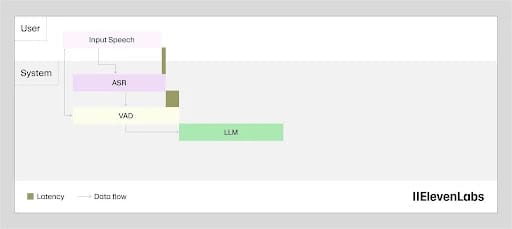
음성 활동 감지기(VAD)는 음성 인식과 언어 모델 사이에 위치합니다. 이 기능의 역할은 사용자가 실제로 말을 끝냈는지 판단하는 것입니다.
오류를 방지하기 위해 VAD는 턴이 끝났다고 판단하기 전에 일정 기준 이상의 지속적인 무음을 기다립니다. 이 대기 시간은 언어 모델이 단어를 처리하기 전에 추가되는 지연 시간입니다. 이 작은 추가 지연은 시간을 더하지만, 사용자가 아직 말하고 있는 동안 시스템이 응답을 시작하는 것을 방지합니다.
기술적으로 말해 다른 모든 대화형 AI 구성 요소의 지연 시간이 0이라면, 턴 테이킹에 따른 지연 시간은 좋은 요소가 될 것입니다. 사람은 말에 응답하기 전에 잠시 뜸을 들입니다. 기계도 비슷하게 잠시 멈추면 상호작용에 현실감이 더해집니다. 하지만 대화형 AI의 다른 구성 요소에서도 이미 지연 시간이 발생하므로, 지연 시간은 최소화하는 것이 이상적입니다.
언어 모델 처리
음성-텍스트 변환(STT) 엔진에서 전사본이 준비되면 언어 모델이 응답을 생성합니다. 여기서 지연 시간은 전체 응답을 생성하는 시간이 아니라 토큰 생성을 시작하는 데 걸리는 시간입니다. 토큰은 도착하는 즉시 TTS 단계로 직접 스트리밍되므로, 가장 중요한 것은 TTFT입니다.
모델 선택 외에도 프롬프트 길이와 지식 기반의 크기 모두 이 단계에 영향을 줍니다. LLM이 고려해야 하는 컨텍스트가 많을수록 시간이 더 오래 걸립니다. 이러한 시스템을 대규모로 설계할 때는 속도를 유지하기 위해 유용한 지식 기반과 간결한 프롬프트 사이에서 적절한 균형을 찾아야 합니다.
음성 합성
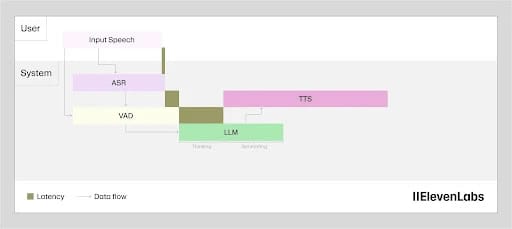
TTS 지연 시간은 언어 모델에서 첫 토큰을 받은 때부터 오디오가 시작될 때까지의 시간입니다. 토큰은 사람의 말이 재생되는 속도보다 빠르게 도착하므로 합성 모델은 전체 응답을 기다리지 않습니다. TTS 지연 시간은 엄격히 말해 첫 오디오 청크까지의 시간입니다.
이 단계는 이전에는 대화형 AI 지연 시간에 가장 크게 기여하는 단일 요소였으며, 구형 모델은 음성 생성을 시작하는 데 2~3초가 걸렸습니다. ElevenLabs의 Flash v2.5는 이를 직접 해결하여 약 75ms 지연 시간의 음성 합성을 제공하고, 이 병목을 수 초에서 1초의 일부 수준으로 줄입니다.
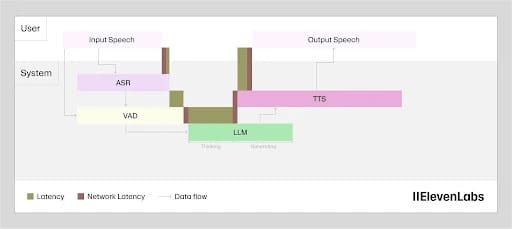
네트워크 지연 시간
한 위치에서 다른 위치로 데이터를 전송하면 항상 지연 시간이 추가되며, 지리적 거리는 왕복 네트워크 지연 시간을 더욱 악화시킵니다.
여러 구성 요소가 함께 엔드투엔드 응답을 처리하기 때문에, 여러 네트워크 홉에서 상당한 지연 시간이 누적될 수 있습니다.
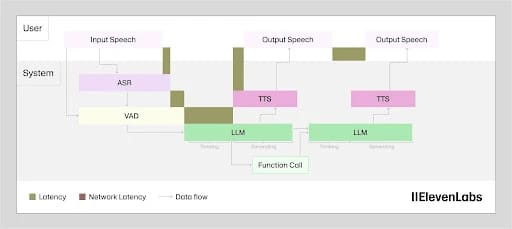
함수 호출
함수 호출은 LLM 단계에서 API 왕복을 추가합니다. 빠른 내부 조회는 수십 ms를 더하지만, 결제 처리 업체나 재고 시스템은 수 초를 더할 수 있습니다. 지연 시간은 호출되는 서비스에 전적으로 좌우되므로, 이 단계는 직접 최적화하기 가장 어렵습니다.
가장 효과적인 방식은 도구 호출이 완료되기 전에 LLM이 응답하도록 프롬프트하는 것입니다. "확인해 드릴게요"와 같은 문구는 외부 호출이 처리되는 동안 무음 상태로 두는 대신 사용자의 참여를 유지합니다. 도구가 병렬로 실행되는 동안 음성 응답이 시작됩니다.
대화형 AI 지연 시간을 줄이는 방법
대화형 AI 지연 시간을 줄이려면 영향도 순서에 따라 각 파이프라인 단계를 해결해야 합니다. 개별 개선도 지연 시간에 영향을 미치지만, 가장 큰 변화를 보려면 전체 파이프라인을 종합적으로 다뤄야 합니다.
다음은 대화형 AI 지연 시간을 전반적으로 줄이는 데 도움이 되는 몇 가지 원칙입니다.
- TTS 모델 선택: Flash v2.5와 같은 속도 최적화 TTS 모델은 Eleven v3 및 Eleven v4와 같은 품질 최적화 모델과 다른 아키텍처를 사용합니다. 실시간 음성 에이전트의 경우, 지연 시간 목표를 충족하는 최고 품질의 모델을 선택해야 하며, 이는 거의 항상 속도에 최적화된 모델입니다.
- LLM 모델 선택: 일반적으로 더 작고 빠른 LLM은 더 큰 모델보다 첫 토큰 생성 시간이 짧습니다. 작업에 필요한 품질 기준을 충족하는 가장 빠른 LLM을 선택하는 일은 TTS 모델 선택만큼 중요합니다.
- 스트리밍: 스트리밍 TTS는 합성이 진행되는 동안 오디오를 청크 단위로 반환하므로, 모델이 나머지를 생성하는 동안 사용자는 첫 마디를 들을 수 있습니다. 이 개념은 LLM 출력에도 적용됩니다. 언어 모델이 후속 문장을 생성하는 동안 첫 문장에서 TTS 합성을 시작하면 파이프라인의 지연 시간을 줄일 수 있습니다.
- 시스템 프롬프트 설계: 사용자는 시스템 프롬프트 간소화를 통해 지침을 모든 의사결정 단계에 포함하는 대신 절차나 워크플로로 옮길 수 있습니다. 이렇게 하면 모델이 각 턴에서 추론해야 하는 컨텍스트의 양이 줄어듭니다.
- 가드레일: 스트리밍 모델에서 가드레일을 실행하면 검사 완료까지 재생을 차단하는 대신, 가드레일 검사가 완료되기 전에 출력을 재생할 수 있습니다.
- 모델 공동 배치: ElevenLabs Agents 스택처럼 가능한 경우 공동 배치된 모델을 사용하면 구성 요소를 가까이 유지하여 별도로 호스팅되는 모델 간 홉으로 인한 지연 시간을 방지할 수 있습니다.
- 지리적 위치: 서버와 사용자 간 거리가 가까우면 엔드투엔드 TTFA에 대한 네트워크 기여분이 직접 줄어들어 지연 시간을 크게 낮출 수 있습니다.
이러한 요소 외에도 지연 시간 최적화 기술 가이드에서 자세한 내용을 확인할 수 있습니다.
ElevenAgents로 저지연 대화형 AI 시작하기
대화형 AI 지연 시간은 에이전트를 구축하고 배포할 때 반드시 고려해야 할 매우 중요한 요소입니다. ElevenAgents는 프로세스에 지연 시간 최적화를 기본으로 적용합니다. 시간 절감을 위한 오버랩 기법부터 개별 구성 요소의 낮은 모델 추론 지연 시간까지, ElevenAgents는 비즈니스를 위한 저지연 대화형 AI 스택을 구축합니다.
궁극적인 목표는 현실감을 만드는 것입니다. 사용자는 컴퓨터 프로그램의 이점을 누리면서도 사람과 대화하는 편안함을 느껴야 합니다. 하위 프로세스를 개선하면 이제 이것이 가능합니다.
ElevenAgents에 대해 자세히 알아보거나 영업팀에 문의하여 오늘 시작하세요.
대화형 AI 지연 시간 FAQ

Jack Limebear는 Growth 팀에서 블로그와 인사이트 페이지의 콘텐츠 작가이자 전략가로 활동하고 있습니다. ElevenLabs에 합류하기 전에는 빠르게 성장하는 SaaS 스타트업부터 포춘 500대 기업까지 다양한 조직에서 10년 넘게 콘텐츠 전략을 이끌었습니다. 케임브리지 대학교에서 영문학 석사 학위를 취득했습니다.