Scribe v2 Medical अब सभी के लिए उपलब्ध है
- लेखक
- Min Kim
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
क्लिनिकल ऑडियो, सटीक स्पीच रिकग्निशन की सबसे कठिन परीक्षाओं में से एक है। दवाओं के नाम लंबे, दुर्लभ और आसानी से गड़बड़ होने वाले होते हैं (hydroxyzine और hydralazine में सिर्फ़ एक गलत सुना गया शब्दांश का अंतर है)। शब्दावली भी सघन होती है, जिसमें डोज़, यूनिट, शरीर-रचना और पैथोलॉजी के शब्द तेज़ी से लगातार आ सकते हैं। दांव भी ज़्यादा हैं, क्योंकि ट्रांसक्रिप्शन की गलती से मरीज़ की देखभाल प्रभावित हो सकती है।
इसीलिए ElevenLabs आज जारी कर रहा है Scribe v2 मेडिकल, हमारा क्लिनिकल ऑडियो के लिए फ़ाइन-ट्यून किया गया स्पीच टू टेक्स्ट मॉडल, जो अब ElevenAPI पर सभी के लिए उपलब्ध है। ElevenLabs के टेस्ट में, यह मेडिकल ASR बेंचमार्क पर सबसे कम वर्ड एरर रेट (WER) हासिल करता है और हमारे बेस Scribe v2 मॉडल की तुलना में क्लिनिकल ऑडियो पर WER को 18% कम करता है।
जनरल-पर्पज़ मॉडल रोज़मर्रा की बातचीत संभालने में अच्छे होते हैं, लेकिन जहां क्लिनिकल वर्कफ़्लो को उनकी सबसे ज़्यादा ज़रूरत होती है, वहां उनका प्रदर्शन कमज़ोर पड़ जाता है। हमने सार्वजनिक बेंचमार्क पर, जिन्हें कोई भी दोहरा सकता है, दवाओं के नामों और क्लिनिकल डिक्टेशन पर केंद्रित Scribe v2 का मेडिकल फ़ाइन-ट्यून प्रशिक्षित किया।
क्लिनिकल उपयोग के मामलों के लिए Scribe v2 Medical एक स्पष्ट विकल्प है
Eka Medical ASR बेंचमार्क
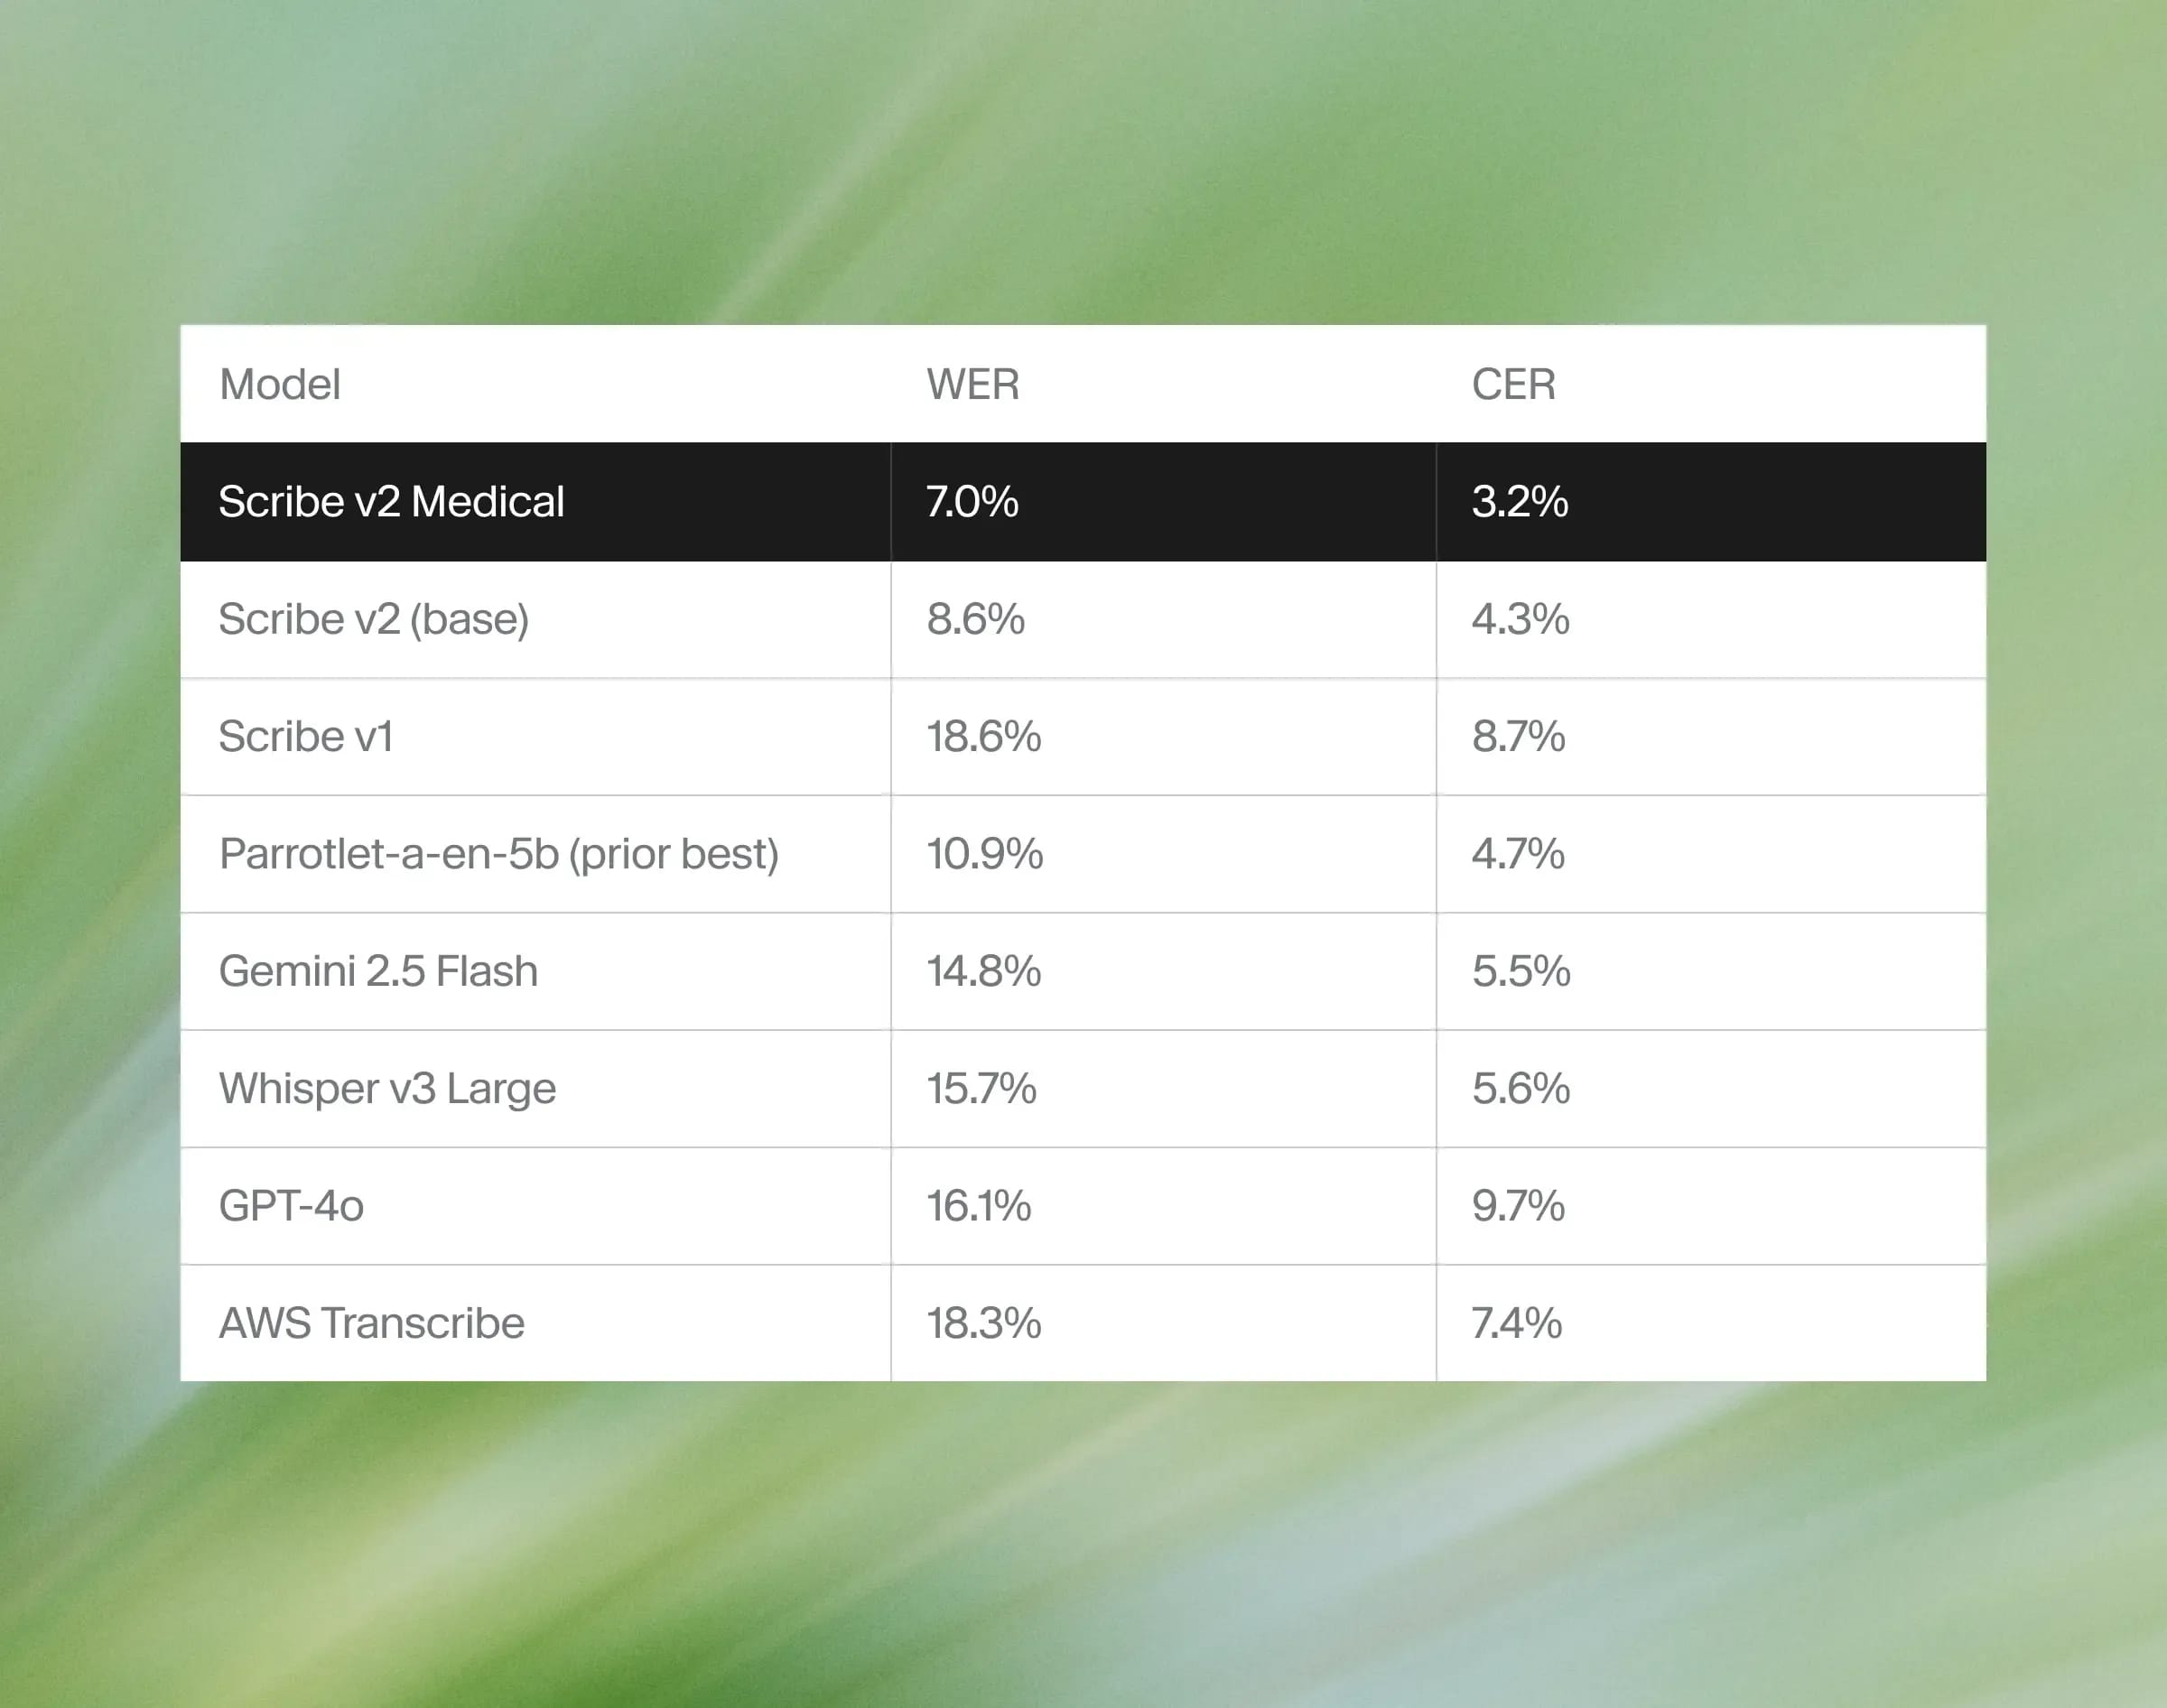
आंतरिक टेस्ट में, Scribe v2 Medical ने ElevenLabs के टेस्ट में प्रकाशित हर नतीजे से कम WER हासिल किया Eka Medical ASR बेंचमार्क पर। इस मूल्यांकन डेटासेट में 3,619 अंग्रेज़ी क्लिनिकल ऑडियो सैंपल हैं — अलग-अलग दवा और स्थिति के नाम, क्लिनिकल वाक्य, और क्लिनिशियन व मरीज़ों की बातचीत सहित — जिनमें हर टर्म के लिए एनोटेशन और डेटासेट कार्ड पर प्रकाशित लीडरबोर्ड शामिल है।
Omi Health मेडिकल स्पीच टू टेक्स्ट बेंचमार्क
प्रदर्शन सिर्फ़ एक बेंचमार्क तक सीमित नहीं है। Omi हेल्थ के पास 30 स्पीच टू टेक्स्ट सिस्टम का एक सार्वजनिक लीडरबोर्ड है, जिन्हें 1,513 क्लिनिकल अंग्रेज़ी क्लिप्स (57 परामर्शों में 7.2 घंटे) पर स्कोर किया गया है।
Omi ने इस बेंचमार्क पर Scribe v2 Medical का सीधे मूल्यांकन किया। टेस्ट किए गए सभी 30 सिस्टम में इसका ओवरऑल WER सबसे कम है (5.88%), और यह बेस Scribe v2 की तुलना में डोज़ की सटीकता में काफ़ी सुधार करता है (86.2% बनाम 79.8%)।
Omi का बेंचमार्क 25 सितंबर को Scribe v2 Medical के नतीजों के साथ अपडेट होगा, और ऊपर दिए गए आंकड़े उस अपडेट से पहले उनकी अनुमति से साझा किए गए हैं।
प्रोडक्शन में ग्राहक
ग्राहक पहले से ही प्रोडक्शन में Scribe v2 Medical इस्तेमाल कर रहे हैं और क्लिनिकल ऑडियो में सुधार देख रहे हैं।
"Deepgram से ElevenLabs Scribe v2 Medical पर स्विच करने के बाद, क्लिनिकल टर्मिनोलॉजी पर हमें कहीं ज़्यादा सटीकता मिल रही है, और इससे टीम के काम करने का तरीका बदल गया है," CareCo के सीईओ और संस्थापक Mendel Erlenwein ने कहा। "जब हमारे कोऑर्डिनेटर ट्रांसक्रिप्ट पर भरोसा कर पाते हैं, तो वे नोट्स ठीक करने में कम समय और मरीज़ों से फोन पर बात करने में ज़्यादा समय दे सकते हैं। हमारे मरीज़ जटिल उपचार-पद्धतियों पर हैं, और केयर टीम जो नोट पढ़ती है, उसका सही होना ज़रूरी है।"
जो सुधार सबसे ज़्यादा मायने रखते हैं
पूरे ट्रांसक्रिप्ट का WER कभी-कभी क्लिनिकल सेटिंग में सबसे अहम बात छिपा सकता है, क्योंकि क्लिनिकल बातचीत भी मुख्य रूप से सामान्य बोलचाल से बनी होती है। Eka हर सैंपल में मेडिकल टर्म को एनोटेट करता है, इसलिए सिर्फ़ उन टर्म पर स्कोर करना संभव है। सिर्फ़ मेडिकल टर्म के WER में, Scribe v2 Medical बेस मॉडल की तुलना में 14% कम गलतियां करता है (9.5% बनाम 11.1%), और सबसे बड़ा सुधार तब दिखता है जब टर्म पूरे वाक्यों में आते हैं (7.5% बनाम 9.9%)।
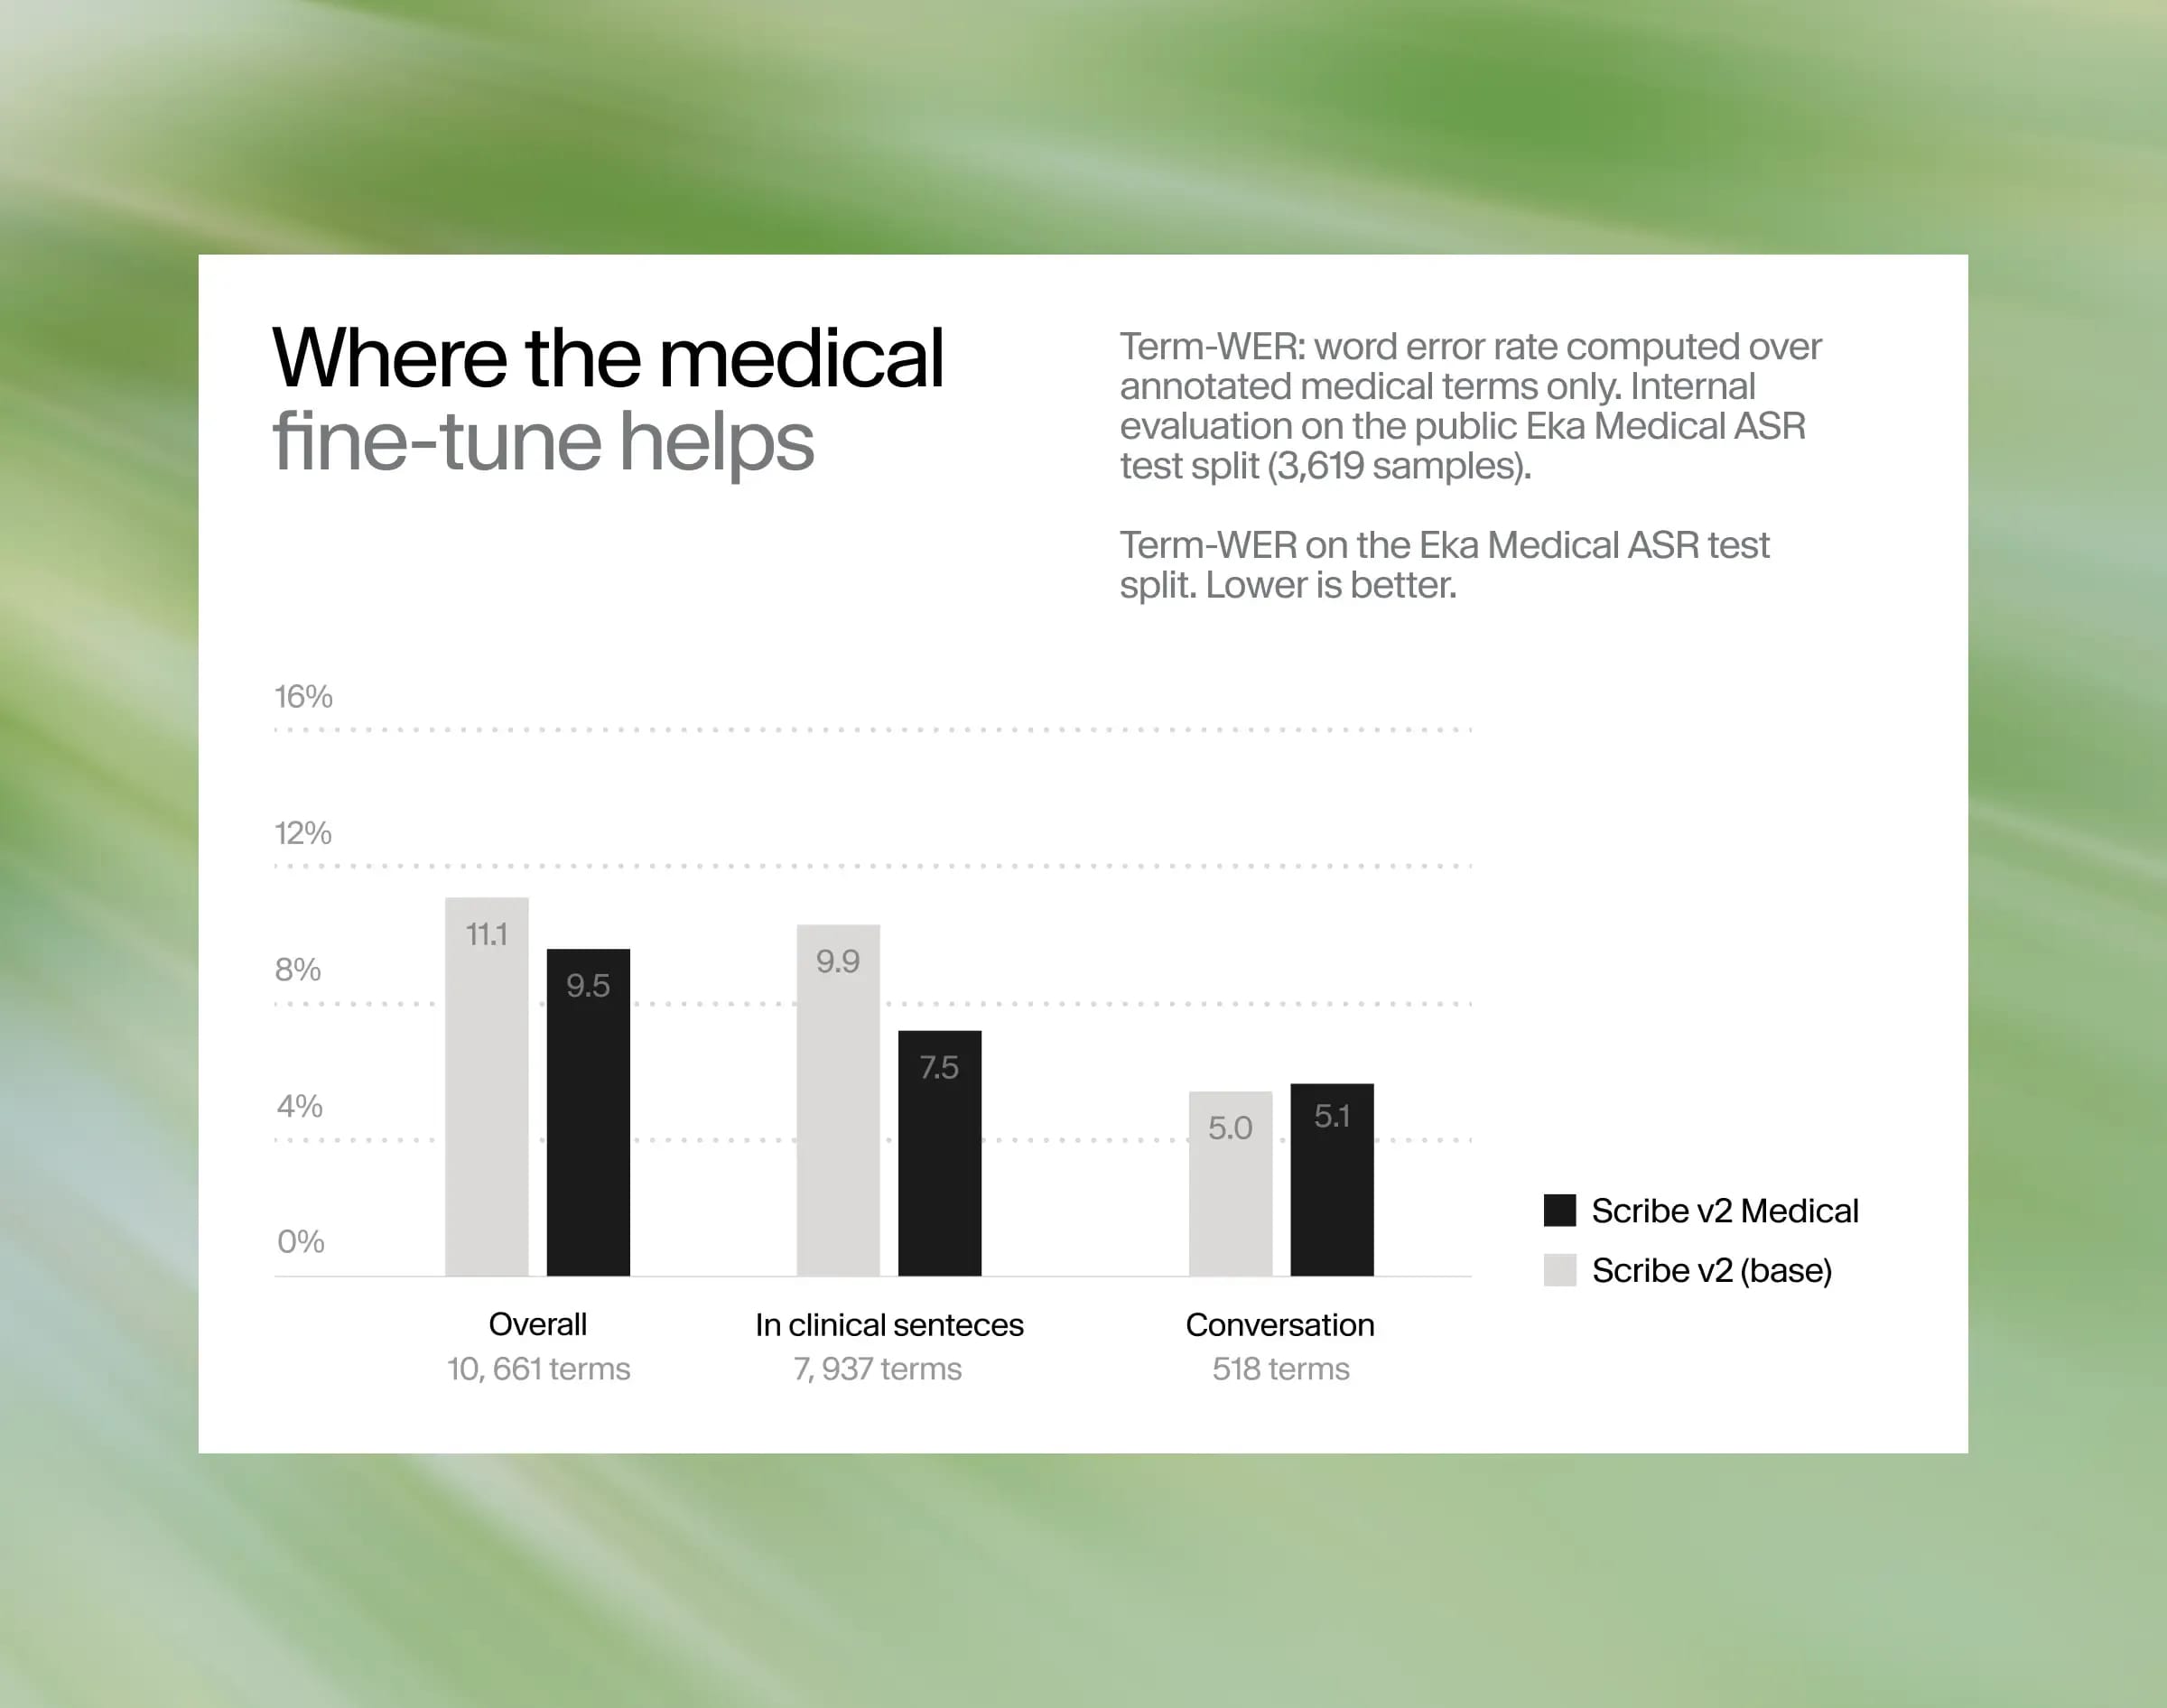
इसी डेटा से एक सावधानी यह भी सामने आती है कि अलग-अलग एक-शब्द वाले क्लिप (बिना किसी आसपास के संदर्भ के बोला गया सिर्फ़ एक दवा का नाम) Scribe v2 Medical समेत लीडरबोर्ड के हर मॉडल के लिए सबसे कठिन स्थिति बने हुए हैं। अलग-थलग टर्म पर इसका WER 14.3% था, जबकि यही टर्म वाक्यों में आने पर 7.5% था। बिल्कुल संदर्भ न होने पर, गलत सुना गया शब्दांश यादगार गलतियां पैदा कर सकता है:
- etodolac (एक NSAID) → "It'll do the luck"
- levomilnacipran (एक एंटीडिप्रेसेंट) → "Leave me alone now, Sephora."
- methdilazine (एक एंटीहिस्टामिन) → "Let's play our scene."
इन गलतियों को कम करने का एक तरीका है कीटर्म प्रॉम्प्टिंग, जिससे आप दवाओं के नाम या मेडिकल वाक्यांशों को हाइलाइट कर सकते हैं, ताकि मॉडल उनके सफल ट्रांसक्रिप्शन की ओर झुके।
मुख्य बेंचमार्क से आगे
v2 Medical की सटीकता सिर्फ़ अंग्रेज़ी तक सीमित नहीं है।
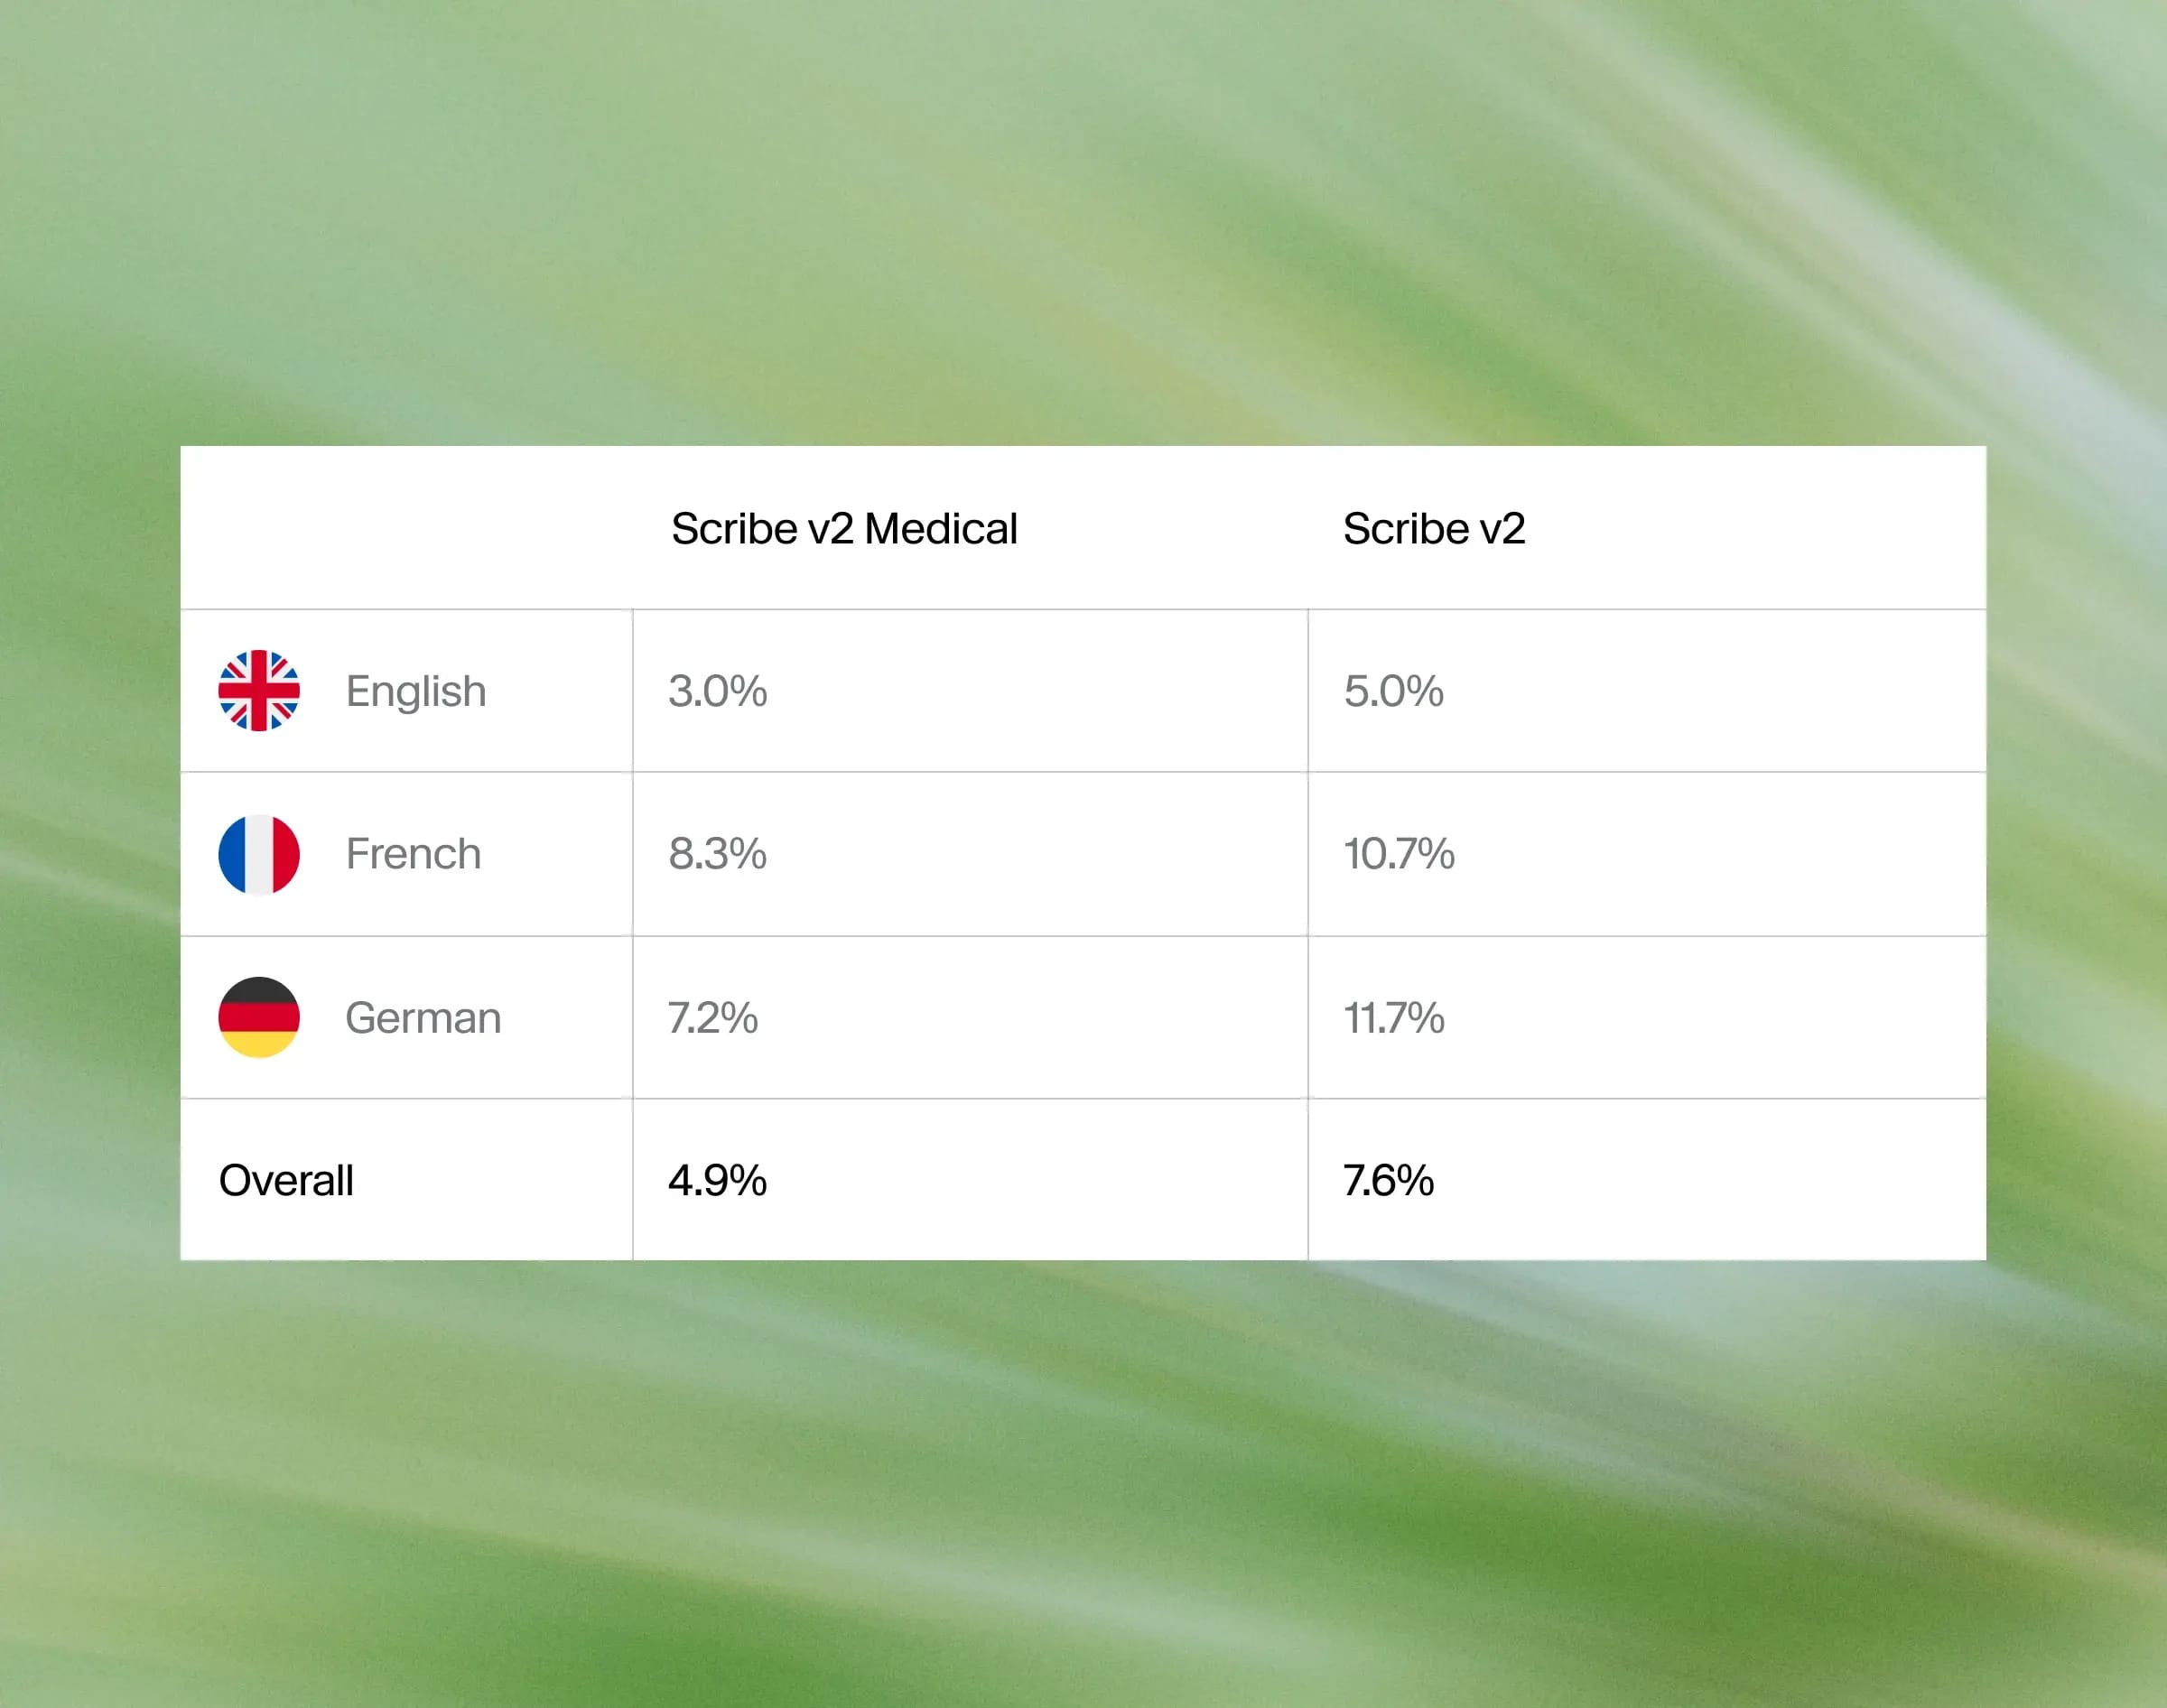
पर Corti का MedDictate बेंचमार्क, जो एक सार्वजनिक क्लिनिकल डिक्टेशन डेटासेट है, Scribe v2 Medical बेस Scribe v2 मॉडल की तुलना में WER को लगभग 36% कम करता है, और यह सुधार तीनों भाषाओं में बना रहता है:
टीम ने यह भी सत्यापित किया कि मेडिकल फ़ाइन-ट्यून दूसरे क्षेत्रों के प्रदर्शन को कम नहीं करता। CommonVoice से लिए गए रोज़मर्रा के गैर-मेडिकल भाषण के 6,000 सैंपल पर, राउंड करने पर Scribe v2 Medical का स्कोर बेस Scribe v2 के बराबर है — दोनों में 5.3% WER। इसलिए v2 Medical के साथ आपको एक विशेष मेडिकल मॉडल के फ़ायदे मिलते हैं — बिना इस बेंचमार्क पर सटीकता खोए।
सुरक्षित स्वास्थ्य जानकारी के लिए बनाया गया
Scribe v2 Medical उन एंटरप्राइज़ ग्राहकों के लिए HIPAA-eligible है, जिनके पास Business Associate Agreements (BAA) हैं और ज़ीरो रिटेंशन मोड (ZRM) सक्षम है।
स्पीच टू टेक्स्ट API अनुरोधों के लिए ZRM सक्षम होने पर, हर अनुरोध पूरा होते ही ऑडियो इनपुट और टेक्स्ट आउटपुट तुरंत हटा दिए जाते हैं। ElevenLabs इनमें से किसी को भी सुरक्षित नहीं रखता, और आपके एप्लिकेशन को पूरा API रिस्पॉन्स मिलता है तथा ट्रांसक्रिप्ट कैसे रखे जाएं, इसका नियंत्रण आपके पास होता है।
शुरू करें
Scribe v2 Medical स्पीच टू टेक्स्ट API पर उपलब्ध है। बस नया मॉडल id पास करें: scribe_v2_medical
मॉडल बैच स्पीच टू टेक्स्ट एंडपॉइंट पर चलता है।