Scribe v2 Medical अब सभी के लिए उपलब्ध है
- लेखक
- Min Kim
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
क्लिनिकल ऑडियो, सटीक स्पीच रिकग्निशन की सबसे कठिन परीक्षाओं में से एक है। दवाओं के नाम लंबे, दुर्लभ और आसानी से गड़बड़ हो सकते हैं (hydroxyzine और hydralazine में सिर्फ़ एक गलत सुने गए सिलेबल का अंतर है)। शब्दावली घनी होती है, जिसमें डोज़, यूनिट, शरीर रचना और पैथोलॉजी के शब्द तेज़ी से लगातार आ सकते हैं। दांव भी अधिक होता है, क्योंकि ट्रांसक्रिप्शन की गलती मरीज़ के चार्ट में दर्ज हो सकती है।
इसीलिए आज ElevenLabs जारी कर रहा है Scribe v2 मेडिकल, हमारा क्लिनिकल ऑडियो के लिए फाइनट्यून किया गया स्पीच टू टेक्स्ट मॉडल, जो अब ElevenAPI पर सभी के लिए उपलब्ध है। नीचे दिए गए आकलनों में, इसकी वर्ड एरर रेट (WER) लगातार तुलना किए गए मॉडलों में सबसे कम में से एक रही है। साथ ही, यह हमारे बेस Scribe v2 मॉडल की तुलना में क्लिनिकल ऑडियो पर WER को लगभग 35% कम करता है।
सामान्य उपयोग के मॉडल रोज़मर्रा की बातचीत को अच्छी तरह संभालते हैं, लेकिन जहाँ क्लिनिकल वर्कफ़्लो को उनकी सबसे ज़्यादा ज़रूरत होती है, वहाँ उनका प्रदर्शन कमज़ोर पड़ सकता है। हमने Scribe v2 का एक मेडिकल फाइनट्यून ट्रेन किया है, जो दवाओं के नामों और क्लिनिकल डिक्टेशन पर केंद्रित है तथा सार्वजनिक बेंचमार्क पर आधारित है जिन्हें कोई भी दोहरा सकता है।
Scribe v2 Medical को क्लिनिकल उपयोग के मामलों के लिए ऑप्टिमाइज़ किया गया है
क्लिनिकल डिक्टेशन (MedDictate)
Corti का MedDictate बोले गए क्लिनिकल नोट्स के ट्रांसक्रिप्शन की जाँच करता है, जिनमें अंग्रेज़ी, फ़्रेंच और जर्मन में दवाओं के नाम, डोज़ और यूनिट लगातार आते हैं। हमारे आकलन में, Scribe v2 Medical की कुल WER हमारे परीक्षण किए गए मॉडलों में सबसे कम रही और यह बेस Scribe v2 से लगभग 35% कम है।
मॉडल
EN
FR
DE
कुल WER
Scribe v2 मेडिकल
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (बेस)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 मेडिकल*
5.5%
-
-
-
*केवल अंग्रेज़ी (24 क्लिप) - Deepgram Nova-3 Medical फ़्रेंच या जर्मन को सपोर्ट नहीं करता।
चिकित्सीय शब्दावली (MedTerm)
MedTerm भी Corti द्वारा प्रकाशित डेटासेट है। इसमें उन्हीं तीन भाषाओं में 600 सैंपल वाला क्लिनिकल टर्मिनोलॉजी बेंचमार्क शामिल है, जिसमें हर सैंपल के मेडिकल शब्दों को एनोटेट किया गया है। इन एनोटेशन से पूरे ट्रांसक्रिप्ट की WER के अलावा दो आयामों पर मॉडलों को स्कोर करना संभव होता है। टर्म रिकॉल, एनोटेट किए गए उन मेडिकल शब्दों का प्रतिशत है जो ट्रांसक्रिप्ट में सही दिखाई देते हैं (जितना अधिक, उतना बेहतर)। टर्म-WER सिर्फ़ उन शब्दों की एरर रेट है और उनके आसपास की सामान्य बातचीत को नज़रअंदाज़ करती है (जितनी कम, उतना बेहतर)।
Scribe v2 Medical, दोनों आयामों पर परीक्षण किए गए हर मॉडल से आगे है और तीनों भाषाओं में हर दूसरे प्रदाता से बेहतर है:
मॉडल
टर्म रिकॉल ↑
टर्म-WER ↓
Scribe v2 मेडिकल
77.7%
10.4%
Scribe v2 (बेस)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 मेडिकल*
72.5%
13.6%
Eka Medical ASR बेंचमार्क
Eka Medical ASR बेंचमार्क में 3,619 अंग्रेज़ी क्लिनिकल ऑडियो सैंपल हैं — जिनमें अलग-अलग दवा और बीमारी के नाम, क्लिनिकल वाक्य तथा चिकित्सकों और मरीज़ों के बीच बातचीत शामिल है — साथ ही हर टर्म के एनोटेशन और डेटासेट कार्ड पर प्रकाशित लीडरबोर्ड भी है।
प्रकाशित डेटासेट में Gemini 2.5 Flash और GPT-4o जैसे पुराने मॉडल शामिल हैं, इसलिए हमने नए मॉडलों के साथ इसका आकलन किया। SemWER (सेमांटिक WER) यह स्कोर करता है कि मॉडल ने फ़ॉर्मैटिंग की परवाह किए बिना सही सामग्री सुनी या नहीं ("mg" और "milligrams" को एक ही उत्तर माना जाता है), और kwWER (कीवर्ड WER) यही स्कोरिंग केवल एनोटेट किए गए मेडिकल कीवर्ड पर लागू करता है।
मॉडल
semWER
kwWER
Scribe v2 मेडिकल
6.50%
6.02%
Scribe v2 (बेस)
7.35%
7.04%
Deepgram Nova-3 मेडिकल
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Eka हर सैंपल के मेडिकल शब्दों को एनोटेट करता है, जिससे सिर्फ़ मेडिकल शब्दों पर बेस मॉडल की तुलना में Scribe v2 Medical के सुधार को अधिक बारीकी से स्कोर करना संभव होता है। Scribe v2 Medical, बेस मॉडल से 15% कम गलतियाँ करता है (9.5% बनाम 11.1%), और सबसे बड़ा सुधार तब दिखता है जब शब्द पूरे क्लिनिकल वाक्यों में आते हैं (7.5% बनाम 9.9%)।
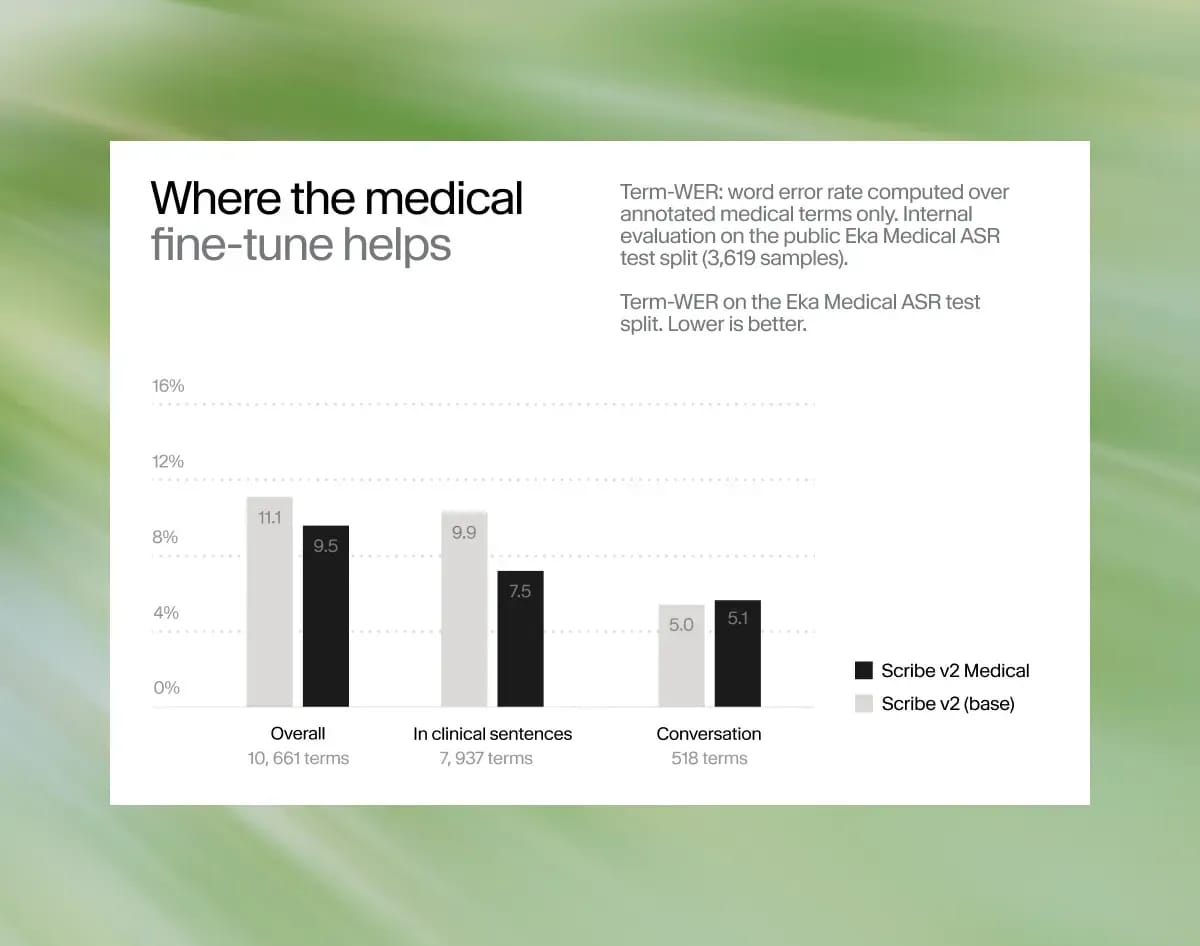
इसी डेटा से एक चेतावनी यह मिलती है कि अलग-अलग, एक शब्द वाली क्लिप (बिना किसी आसपास के संदर्भ के बोला गया सिर्फ़ दवा का नाम), Scribe v2 Medical सहित लीडरबोर्ड के हर मॉडल के लिए सबसे कठिन मामला बनी रहती हैं। अलग-अलग टर्म पर इसका WER 14.3% था, जबकि वाक्यों में यही टर्म आने पर 7.5% था। बिल्कुल भी संदर्भ न होने पर, गलत सुना गया एक सिलेबल यादगार गलतियाँ करवा सकता है:
- etodolac (एक NSAID) → "It'll do the luck"
- levomilnacipran (एक एंटीडिप्रेसेंट) → "Leave me alone now, Sephora."
- methdilazine (एक एंटीहिस्टामिन) → "Let's play our scene."
इन गलतियों को कम करने का एक तरीका है कीटर्म प्रॉम्प्टिंग, जिससे आप दवाओं के नाम या मेडिकल वाक्यांशों को हाइलाइट करके मॉडल को उनका सही ट्रांसक्रिप्शन करने की दिशा में झुका सकते हैं।
प्रोडक्शन में ग्राहक
ग्राहक पहले से ही प्रोडक्शन में Scribe v2 Medical का उपयोग कर रहे हैं और क्लिनिकल ऑडियो में सुधार देख रहे हैं।
“Deepgram से ElevenLabs Scribe v2 Medical पर स्विच करने के बाद, हमें क्लिनिकल टर्मिनोलॉजी में कहीं अधिक सटीकता मिल रही है, और इससे टीम के काम करने का तरीका बदल गया है,” CareCo के सीईओ और संस्थापक Mendel Erlenwein ने कहा। “जब हमारे कोऑर्डिनेटर ट्रांसक्रिप्ट पर भरोसा करते हैं, तो वे नोट्स ठीक करने में कम समय और मरीज़ों से फ़ोन पर बात करने में ज़्यादा समय लगा सकते हैं। हमारे मरीज़ जटिल उपचार योजनाओं पर हैं, और केयर टीम जो नोट पढ़ती है, उसका सही होना ज़रूरी है।”
सामान्य बातचीत पर भी बेहतरीन प्रदर्शन
टीम ने यह भी सत्यापित किया कि मेडिकल फाइनट्यून अन्य क्षेत्रों में प्रदर्शन को कम नहीं करता। Common Voice से लिए गए रोज़मर्रा के गैर-मेडिकल भाषण के 6,000 सैंपल पर, राउंड करने पर Scribe v2 Medical का स्कोर बेस Scribe v2 जितना ही है: दोनों मामलों में 5.3% WER। इसलिए v2 Medical के साथ, इस बेंचमार्क पर सटीकता से समझौता किए बिना आपको एक विशेषज्ञ मेडिकल मॉडल के फ़ायदे मिलते हैं।
संरक्षित स्वास्थ्य जानकारी के लिए बनाया गया
Scribe v2 Medical, Business Associate Agreements वाले एंटरप्राइज़ ग्राहकों के लिए HIPAA-eligible है और इसमें ज़ीरो रिटेंशन मोड (ZRM) सक्षम है।
स्पीच टू टेक्स्ट API अनुरोधों के लिए ZRM सक्षम होने पर, हर अनुरोध पूरा होते ही ऑडियो इनपुट और टेक्स्ट आउटपुट तुरंत हटा दिए जाते हैं। ElevenLabs इनमें से कुछ भी नहीं रखता और आपके एप्लिकेशन को पूरा API रिस्पॉन्स मिलता है तथा वह तय करता है कि ट्रांसक्रिप्ट कैसे रखे जाएँ।
शुरू करें
Scribe v2 Medical स्पीच टू टेक्स्ट API पर उपलब्ध है। बस नया मॉडल id दें: scribe_v2_medical
यह मॉडल बैच स्पीच टू टेक्स्ट एंडपॉइंट पर चलता है।