Resumen del webinar: Da voz humana a tu chatbot de texto
- Publicado
- Última actualización
EscucharEscucha este artículo
Los agentes de chat se han convertido en una parte habitual de la infraestructura de software empresarial. La mayoría de empresas ya tienen uno o están creando uno. Lo que menos han resuelto es qué ocurre cuando un usuario prefiere simplemente hablar.
La voz cambia la interacción de formas que importan más allá de la comodidad. Usuarios expresan frustración, urgencia y confusión mediante el tono de maneras que el texto elimina por completo. Un cliente que escribe «mi pedido no ha llegado» y otro que lo dice con ansiedad audible están enviando señales distintas, y el agente que solo puede leer la transcripción trabaja con solo la mitad de la información.
La pregunta que la mayoría de equipos se plantea ahora no es si añadir voz, sino cómo hacerlo sin reconstruir todo lo que ya funciona.
En Taller en directo: Dale a tu chatbot de texto una voz que suene humana, Paul Asjes (Experiencia de Desarrollador), Bhargavi Bhatt (Experiencia de Cliente) y Fergal Burnett (Marketing de Producto, ElevenAPI) explicaron las realidades técnicas de añadir voz a un agente existente y cómo es realmente una integración funcional.
Por qué crear con voz es más difícil de lo que parece
Uno de los principales retos es la gestión de turnos. Las personas sabemos cuándo alguien ha terminado de hablar por la entonación, el ritmo y el contexto. Sin embargo, la detección de actividad de voz (el enfoque estándar) solo detecta el silencio.
El resultado suele ser un sistema que interpreta cada pausa como una invitación a hablar: interrumpe, corta a mitad de una idea y responde a las vacilaciones naturales como si fueran frases completas.
Es funcional técnicamente, pero no funciona en una conversación.
El contexto es la otra mitad del problema. Pasar el historial de conversación a un LLM en cada turno es necesario, pero no suficiente. Las mismas palabras adquieren un significado distinto según cómo se digan: «estoy bien» dicho con alivio y «estoy bien» dicho con frustración tienen la misma transcripción, pero son interacciones diferentes. Un sistema de voz que ignore esa dimensión siempre sonará un poco extraño, por buenos que sean los modelos individuales.
También está la carga de ingeniería. Los equipos que gestionan su propia orquestación de voz acaban manteniendo la lógica de turnos, la gestión de interrupciones y el análisis de latencia como trabajo continuo. No es algo que se crea una sola vez.
Cómo añadir voz a un agente existente
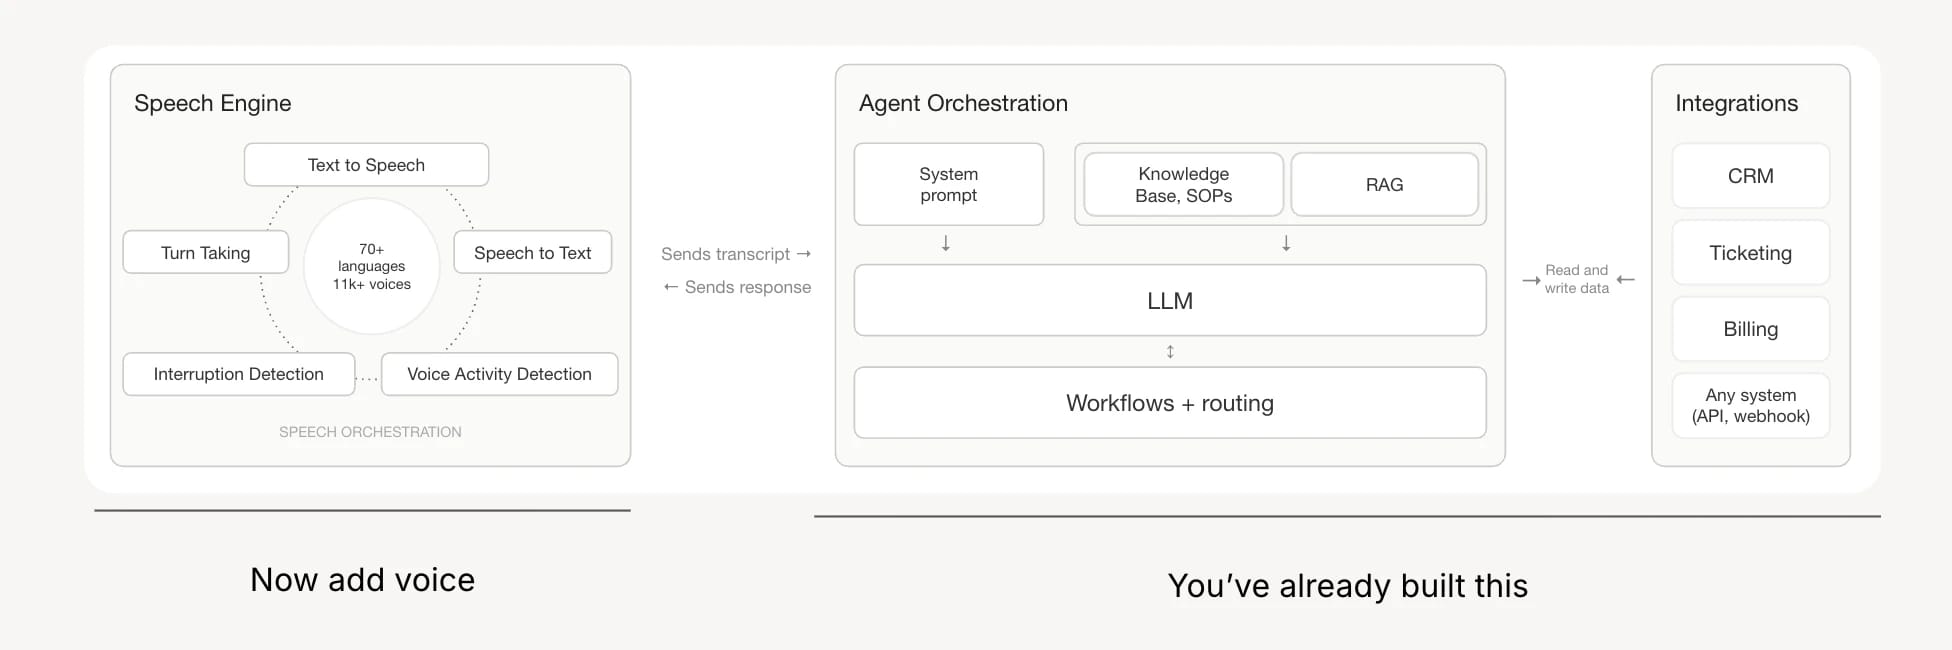
El enfoque más limpio es una arquitectura con dos WebSockets.
- Una conexión se establece entre el cliente y la API de ElevenLabs, y otra entre tu servidor y la API de ElevenLabs
- El usuario habla al micrófono, el audio se envía a la API de ElevenLabs, donde se transcribe y se manda a tu servidor
- Tu servidor proporciona al LLM todo el historial de conversación que recibe de la API de ElevenLabs y la respuesta en streaming vuelve para sintetizar el audio
- Esto puede empezar antes de que el LLM termine de generar, lo que mantiene baja la latencia hasta el primer byte
El punto clave de la integración es el método onTranscript , que se activa al final de cada turno y pasa al LLM el historial completo de la conversación.
Una contextualUpdate al inicio de la sesión conserva lo que haya ocurrido en la parte de texto de la conversación antes de que el usuario cambiara a voz. Esto permite que un único agente funcione en ambas modalidades sin perder el contexto.
Algunas cosas que conviene tener en cuenta al crear:
- La elección del LLM importa más en voz que en chat. Los modelos de razonamiento profundo introducen pausas que en el audio se perciben como vacilaciones poco naturales, aunque la calidad de la respuesta sea mayor. Para voz en tiempo real, los modelos más rápidos casi siempre ganan en calidad percibida.
- Para audio, WebRTC mejor que WebSockets. WebRTC incluye cancelación de eco y ruido, algo especialmente importante en móviles o entornos ruidosos. Usar WebSockets para transportar audio implica gestionar eso por tu cuenta.
- No pidas a usuarios que seleccionen un idioma. Rompe el flujo de la conversación. Detectar el idioma durante los primeros segundos de voz y fijarlo es un patrón mejor, y permite cambiar de idioma de forma fluida sin que el usuario tenga que hacer nada.
- Separa tu modelo de gestión de turnos del LLM. Usar el LLM para decidir cuándo un usuario ha terminado de hablar añade latencia y coste en cada turno. Un modelo especializado en gestión de turnos se encarga de ello más rápido y con mayor precisión, y merece la pena tratarlo como un componente distinto de la arquitectura.
Cuánta infraestructura gestionar
La respuesta adecuada depende de lo que ya tengas. Si cuentas con un agente de chat que funciona, añadirle una capa de voz (manteniendo intactos tu LLM, la orquestación y la lógica de negocio) suele ser el camino más rápido y con menos riesgo.
No estás reconstruyendo nada. Estás añadiendo una interfaz de audio a algo que ya funciona.
Si las necesidades incluyen telefonía, gestión de canales de despliegue, pruebas integradas y analítica, tiene sentido delegar una mayor parte de la infraestructura en una plataforma de agentes de voz. Ambos enfoques no son excluyentes: los equipos pueden empezar con una capa de voz ligera e incorporar capacidades de plataforma a medida que el caso de uso madura.
Demostración: añadir voz a un chatbot existente
Esta demostración muestra a un usuario que está en mitad de una conversación con un chatbot de planificación de viajes basado en texto, pidiendo recomendaciones de barrios y comida para un viaje a Japón.
Qué cubrimos:
- Se añadió una capa de voz al chatbot sin realizar cambios en el agente subyacente.
- El usuario pasó de escribir a hablar a mitad de la conversación, y el agente mantuvo todo el contexto en ambas modalidades.
- El usuario habló en neerlandés; el agente detectó el cambio de idioma automáticamente
- Cuando se interrumpió al agente y se le pidió que volviera al inglés a mitad de una frase, lo hizo y terminó la respuesta con un ligero acento neerlandés, sin que se le indicara.
- Durante toda la conversación, la detección de interrupciones permitió al usuario hablar de forma natural mientras el agente hablaba, sin que este terminara su turno.
Por qué importa:
La demostración no mostraba un agente de voz creado específicamente para ello. Mostraba un agente de texto que ya funcionaba, con una capa de voz añadida encima. La gestión del contexto, la detección de idioma y el comportamiento ante interrupciones procedían de la capa de voz; el agente de texto subyacente no cambió.
Mira la sesión completa
Mira el webinar completo aquí.
Paul forma parte del equipo de crecimiento para desarrolladores en ElevenLabs, con base en Valencia, España, donde trabaja como ingeniero de experiencia para desarrolladores, centrado en la promoción y herramientas de la plataforma. Antes de unirse a ElevenLabs, lideró Developer Relations en Stripe, trabajó en DX en WorkOS y pasó años creando aplicaciones web full-stack y herramientas para desarrolladores.