
O que é um banco de dados vetorial? Como a busca por IA encontra significado
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Um banco de dados vetorial é um sistema de armazenamento que permite que modelos de IA consultem e recuperem dados não estruturados com base na similaridade semântica. Ele ajuda a IA a gerar respostas com conhecimento além dos dados de treinamento.
Bancos de dados vetoriais armazenam informações em um formato que os LLMs podem processar facilmente. Eles fornecem aos modelos de IA informações adicionais para gerar respostas relevantes e precisas.
Este guia explica o que é um banco de dados vetorial, como ele funciona, casos de uso comuns, tipos, exemplos e como ele se compara a bancos de dados relacionais e de grafos.
Resumo
- Um banco de dados vetorial armazena representações de características aprendidas como embeddings vetoriais em um espaço multidimensional.
- Ao contrário dos bancos de dados tradicionais, que dependem da correspondência de palavras-chave, os bancos de dados vetoriais recuperam dados semanticamente semelhantes quando consultados.
- Um banco de dados vetorial armazena documentos internos que ajudam a IA de voz e o atendimento ao cliente a fornecer respostas contextualizadas usando um sistema RAG.
- Aplicações como chatbots, mecanismos de busca com IA e IA conversacional se beneficiam da busca semântica e dos tipos de dados não estruturados compatíveis com bancos de dados vetoriais.
- Bancos de dados vetoriais diferem de bancos de dados de grafos. Bancos de dados de grafos conectam entidades relacionadas para oferecer suporte a consultas de múltiplos saltos usando algoritmos de travessia de grafos, enquanto bancos de dados vetoriais são adequados para consultas diretas que exigem contexto adicional.
O que é um banco de dados vetorial e o que ele armazena?
Um banco de dados vetorial armazena dados como representações numéricas chamadas embeddings, permitindo buscas semânticas de baixa latência para modelos de IA. Diferentemente de um banco de dados tradicional, que armazena informações em linhas e colunas, um banco de dados vetorial agrupa embeddings em um espaço multidimensional com base em similaridades semânticas.
Em IA, o termo “dimensão” descreve características ou atributos aprendidos de um objeto específico. Por exemplo, você pode imaginar um cachorro com dimensões como cor do pelo e raça. Na prática, as dimensões individuais de um embedding aprendido raramente correspondem a uma única característica legível.
Aplicações de IA generativa, especialmente aquelas conectadas a uma fonte externa de conhecimento, usam um banco de dados vetorial para acelerar a recuperação de informações. Em vez de procurar uma correspondência direta de palavra-chave em um banco de dados tradicional, o sistema de recuperação encontra os embeddings mais semelhantes no banco de dados vetorial.
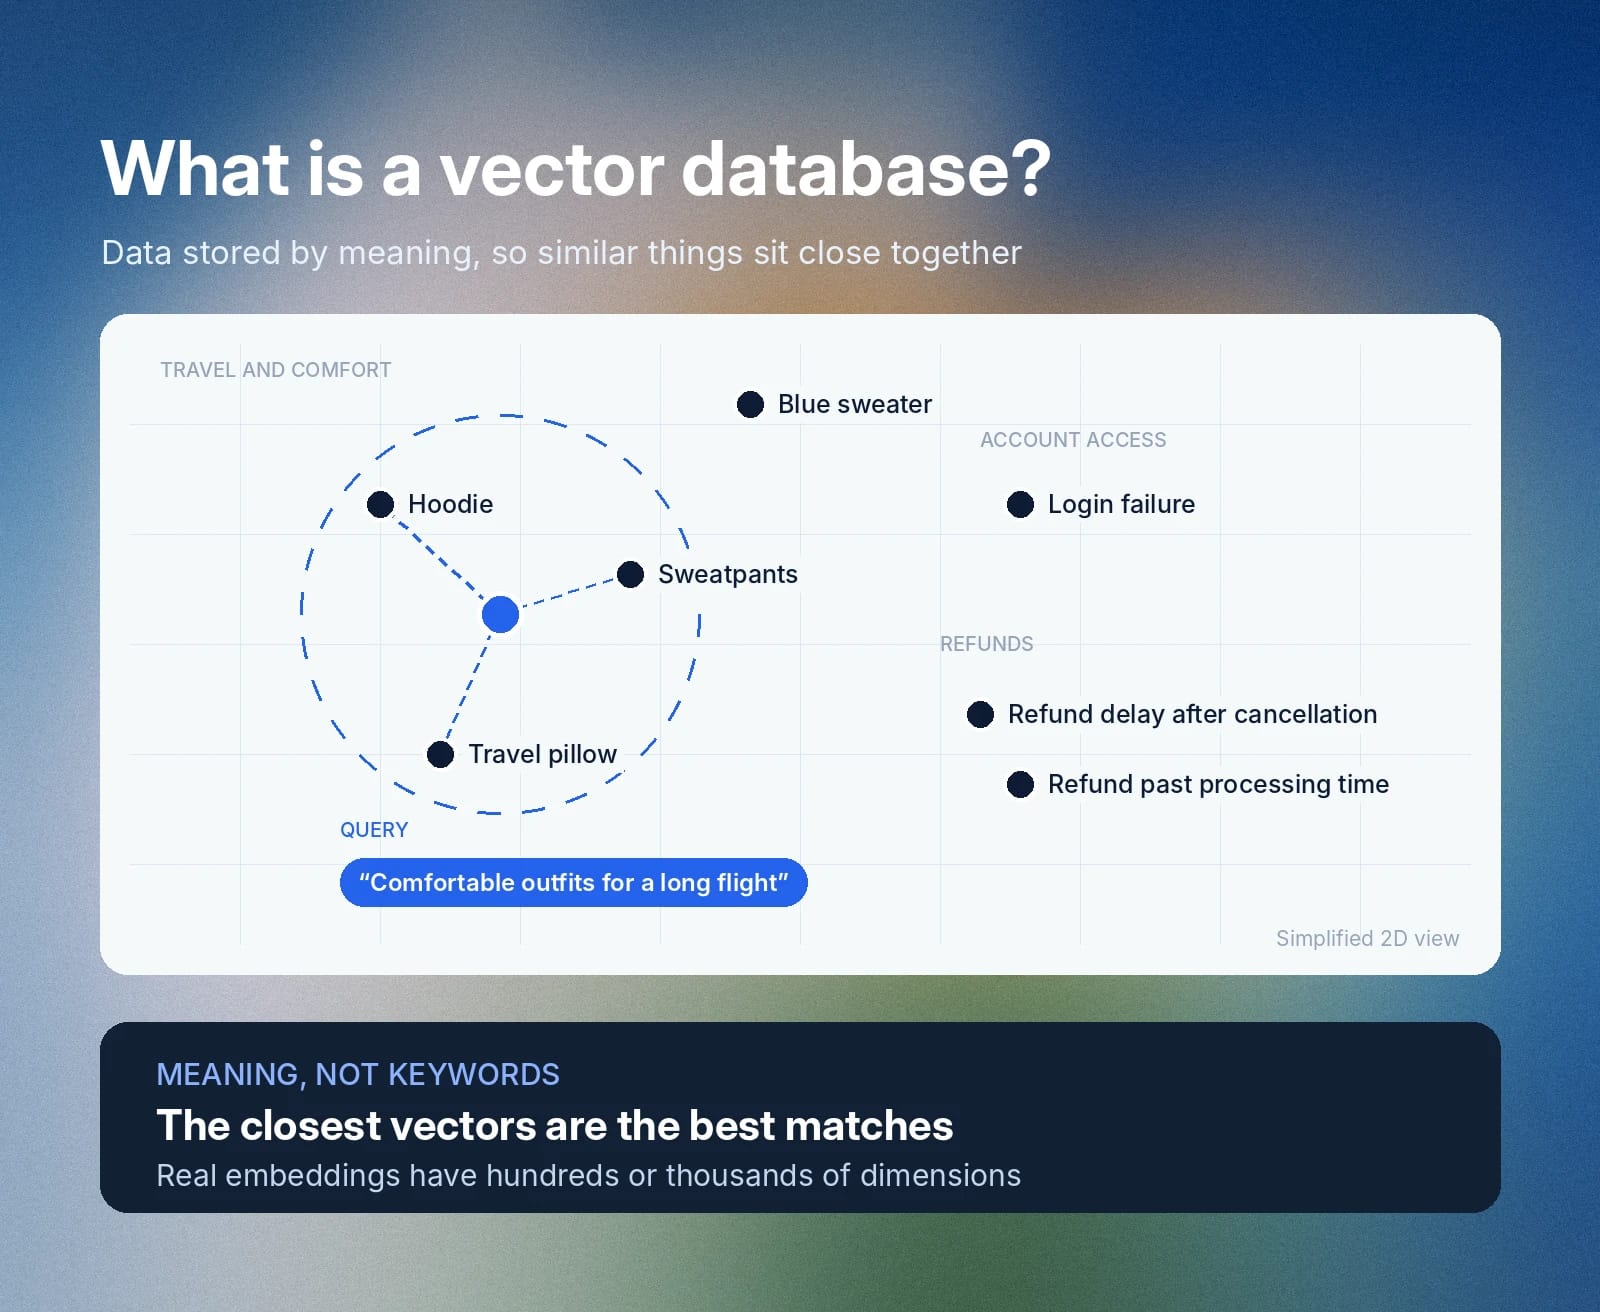
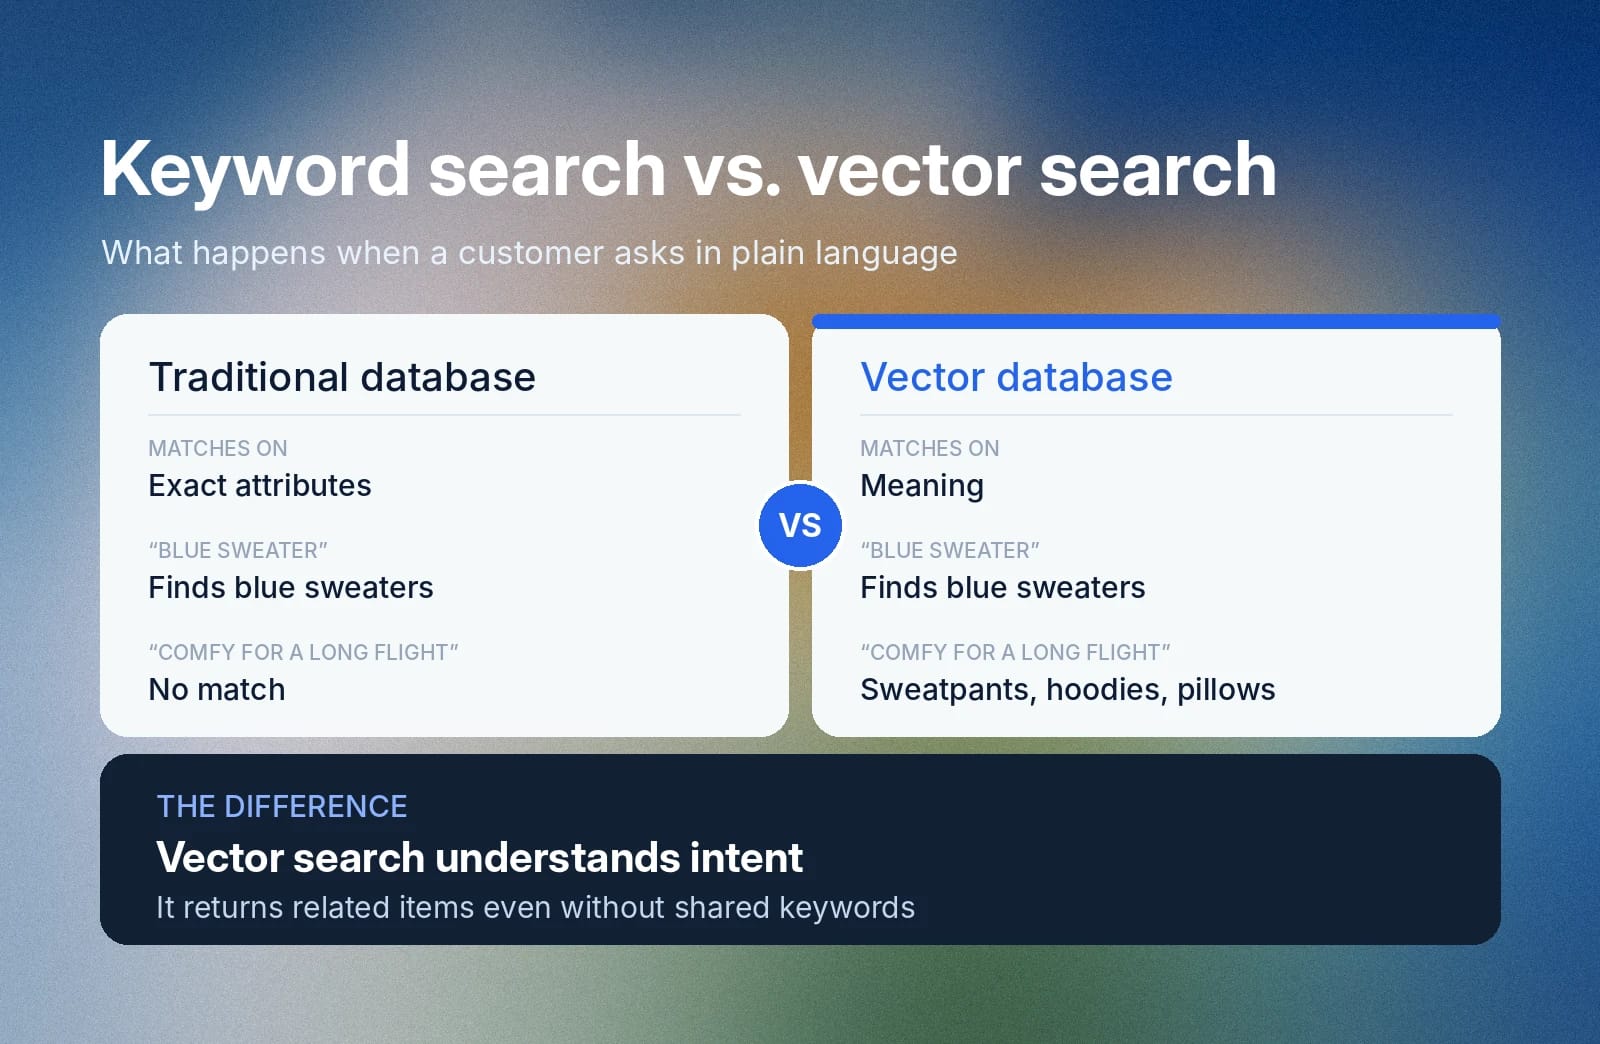
Vamos supor que um cliente ligue e peça que você recomende um “suéter azul”. Com um banco de dados tradicional, você procura produtos que correspondam aos atributos “azul” e “suéter”. Porém, se o cliente quiser “roupas confortáveis para um voo longo”, um banco de dados tradicional não conseguiria retornar uma resposta.
Por outro lado, um banco de dados vetorial capta o significado semântico da solicitação. Ao mapeá-la para o espaço vetorial, o sistema retorna itens como calças de moletom, moletons e travesseiros de viagem, que têm representações de características muito relacionadas. Essa capacidade de associar significados é o que diferencia um banco de dados vetorial de um tradicional.
Embeddings vetoriais: transformando voz, texto e imagens em números
Embeddings vetoriais são matrizes de números que representam dados não estruturados, como texto, imagens e vídeo, para que os modelos de IA possam processá-los facilmente.
Um vetor é a representação matemática de números em diferentes dimensões. No entanto, um vetor não capta o contexto, a estrutura e o significado de um conjunto de dados específico.
Por exemplo, uma lista de números decimais [0.82, 0.14, 0.67] é um vetor, mas o que ela representa é determinado pelo modelo de embedding.
Embeddings capturam qualidades dos dados e as armazenam como um vetor em um espaço multidimensional. Eles dão significado ao que, de outra forma, seria apenas uma lista de números. Cada número do vetor é uma dimensão da representação aprendida.
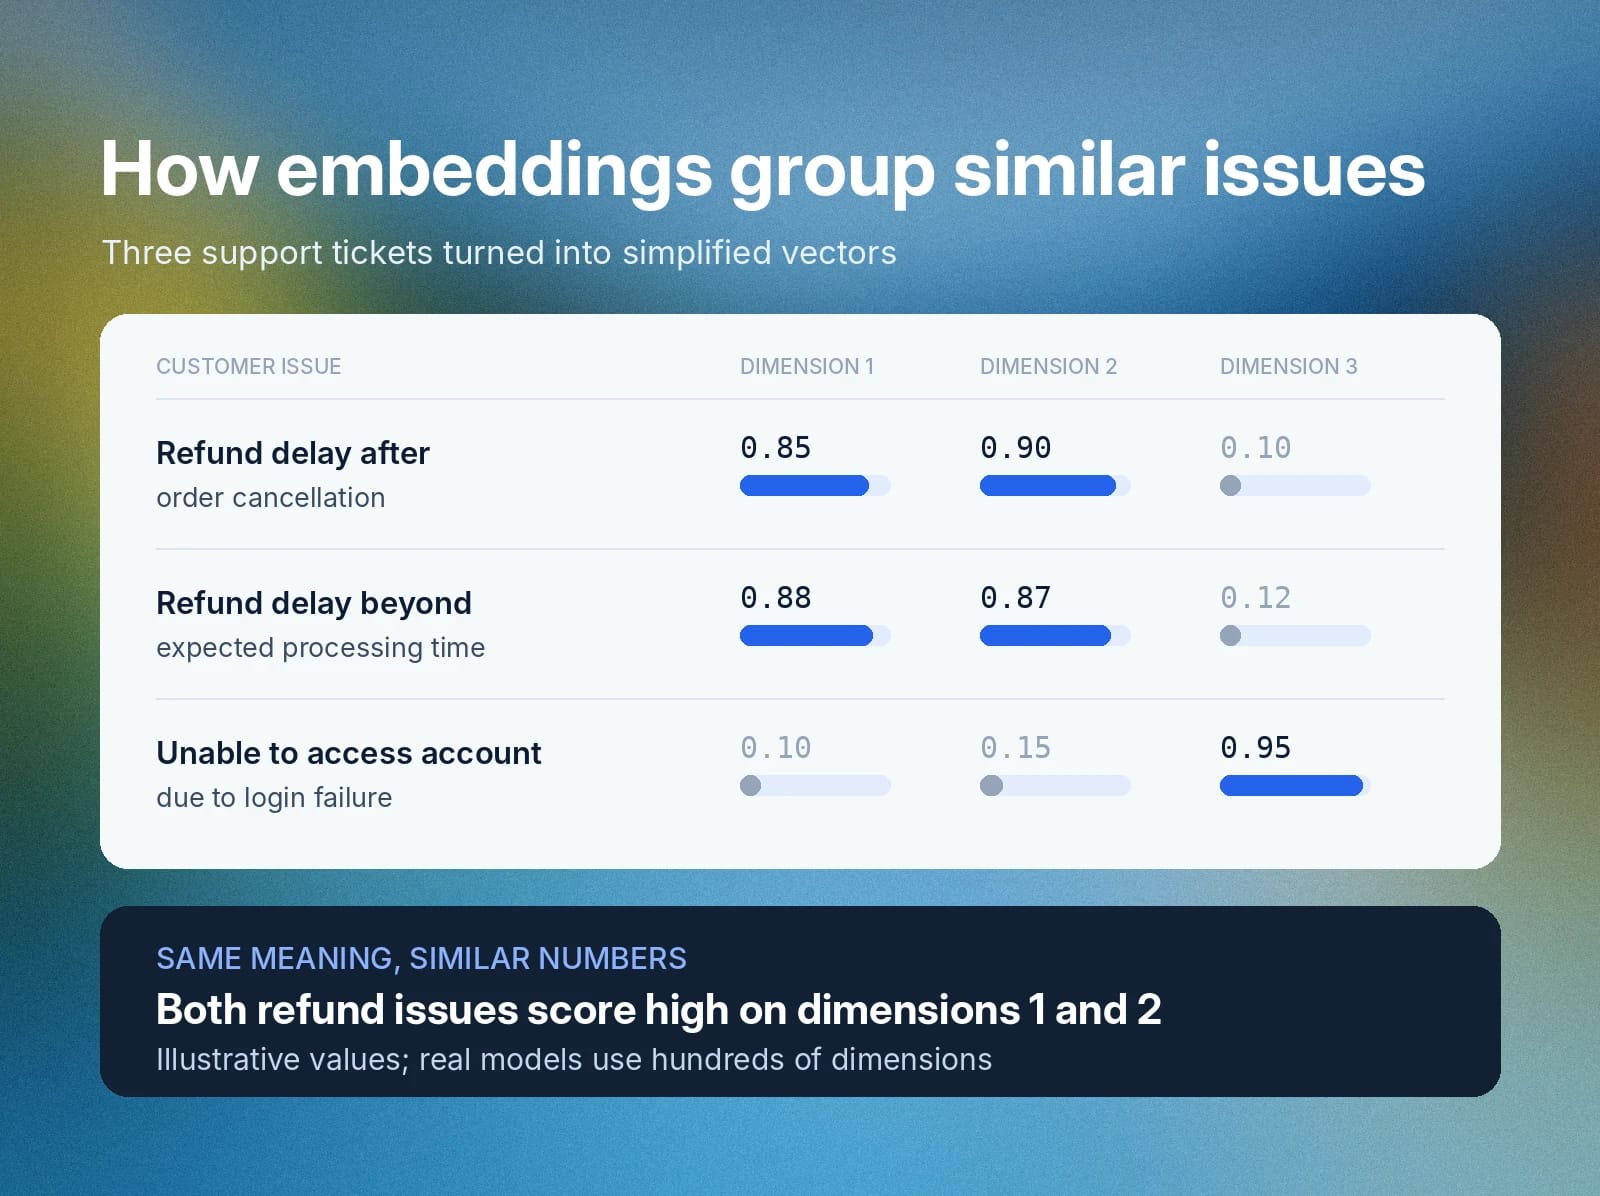
Vamos supor que você queira armazenar casos de clientes em um banco de dados vetorial. Usando um modelo de embedding, você converte os tipos de tickets em embeddings com valores distintos entre as dimensões. Os valores abaixo foram simplificados para fins ilustrativos.
Problema do cliente
Embeddings
Atraso no reembolso após cancelamento do pedido
[0.85, 0.90, 0.10]
Atraso no reembolso além do prazo de processamento previsto
[0.88, 0.87, 0.12]
Não foi possível acessar a conta devido a uma falha de login
[0.10, 0.15, 0.95]
Os dois problemas de reembolso, apesar de terem causas diferentes, apresentam números maiores na primeira e na segunda dimensão, enquanto o problema de login tem seu maior número na terceira. Modelos de embedding normalmente produzem centenas ou milhares de dimensões, por isso os bancos de dados vetoriais são desenvolvidos para compará-las rapidamente.
Como funcionam os bancos de dados vetoriais?
Bancos de dados vetoriais transformam dados não estruturados em embeddings, armazenam-nos em um espaço multidimensional e facilitam a busca por similaridade semântica. Embeddings estreitamente relacionados tendem, em certa medida, a ter uma distância menor no espaço vetorial.
Quando o banco de dados vetorial recebe uma consulta, ele usa algoritmos de vizinho mais próximo aproximado (ANN) para recuperar os embeddings mais semelhantes sem examinar todo o banco de dados.
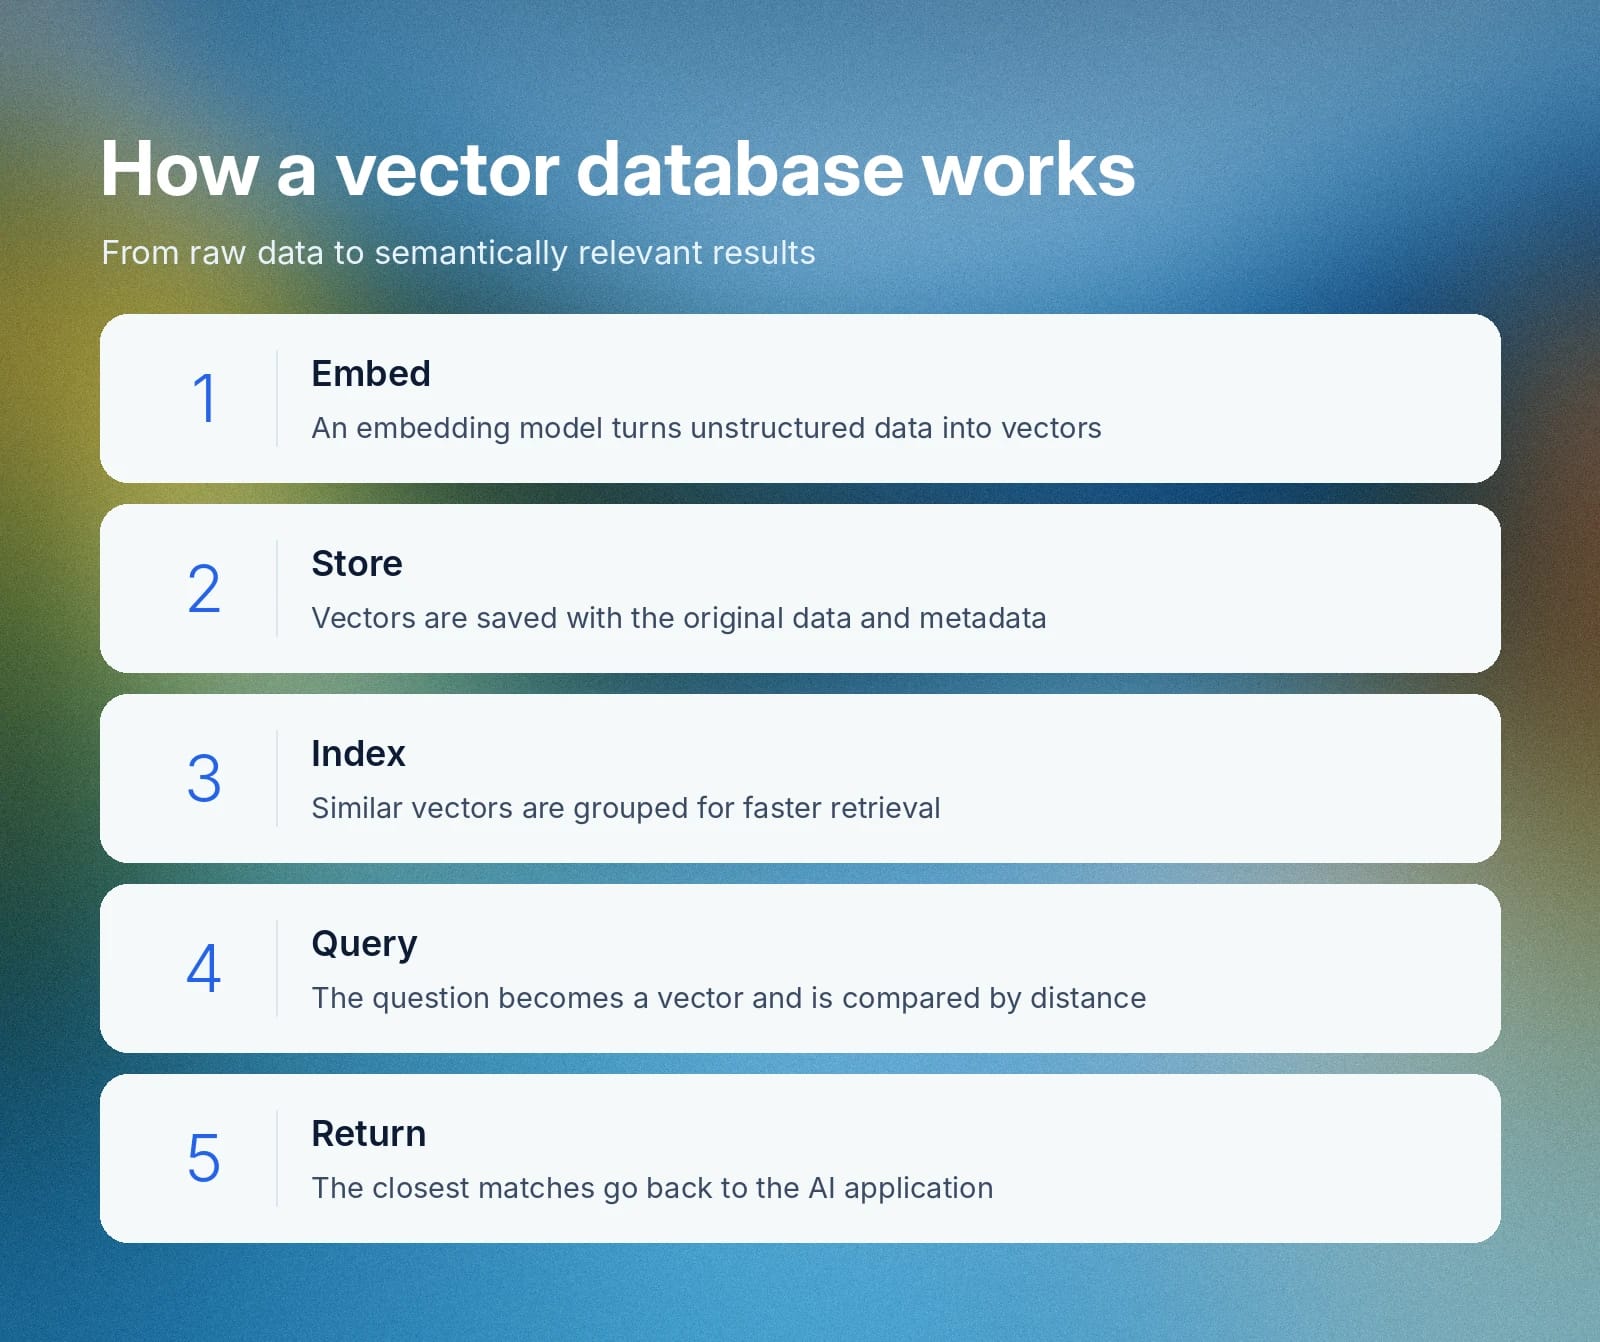
Estas são as etapas para configurar e recuperar dados de um banco de dados vetorial.
Armazenamento de embeddings
Primeiro, um modelo de embedding converte dados não estruturados em embeddings. Cada embedding representa características que carregam o significado semântico do objeto do mundo real. Depois, o sistema armazena os embeddings, junto com os dados originais e os metadados, no banco de dados vetorial.
Como embeddings com significados semelhantes ficam próximos no espaço vetorial, o banco de dados consegue recuperar correspondências relevantes medindo a distância entre os vetores.
Indexação para recuperação mais rápida
A indexação é um processo que organiza os embeddings vetoriais para melhorar a eficiência da recuperação. Bancos de dados vetoriais usam diversas técnicas de indexação para agrupar embeddings estreitamente relacionados. Por exemplo, um banco de dados vetorial pode usar uma estrutura de lista, grafo ou árvore, dependendo dos requisitos de recuperação.
Além da indexação, o banco de dados vetorial pode comprimir os dados usando uma técnica chamada quantização de produto. A quantização de produto comprime embeddings em códigos compactos, economizando memória com uma pequena perda de precisão na busca.
Consulta de dados semanticamente relevantes
Ao receber uma consulta, o banco de dados vetorial a transforma em um embedding. Em seguida, compara o embedding da consulta com aqueles armazenados no banco de dados multidimensional de vetores usando técnicas como similaridade de cosseno, produto escalar e distância euclidiana.
Com base nos resultados, o banco de dados vetorial retorna embeddings com a pontuação de similaridade semântica mais próxima, que aplicações de IA generativa usam para complementar suas respostas. Juntos, armazenamento, indexação e consulta permitem que o banco de dados retorne resultados relevantes rapidamente.
Como a busca vetorial e a busca por similaridade retornam resultados relevantes
A busca por similaridade é uma categoria ampla de sistemas de correspondência de informações. Ela inclui abordagens baseadas em palavras-chave, que correspondem às palavras exatas de uma consulta, e a busca vetorial, que faz correspondência por significado.
A busca vetorial usa um banco de dados vetorial para retornar respostas semanticamente relacionadas. Em vez de realizar uma busca exata por palavras-chave, ela compara a distância entre a consulta e os candidatos a resposta para escolher o resultado mais adequado.
Com frequência, o banco de dados vetorial usa metadados para pré-filtrar os embeddings antes de executar uma busca por similaridade. Por exemplo, ele restringe a busca filtrando embeddings dentro de um período específico. Assim, a recuperação é mais rápida.
Casos de uso de bancos de dados vetoriais para IA de voz e atendimento ao cliente
Bancos de dados vetoriais ajudam equipes de atendimento ao cliente a implementar IA de voz e chatbots que respondem com conhecimento preciso sobre produtos. Em um sistema de atendimento ao cliente baseado em IA, o banco de dados vetorial armazena bases de conhecimento proprietárias, como guias de produtos, políticas empresariais e casos de clientes.
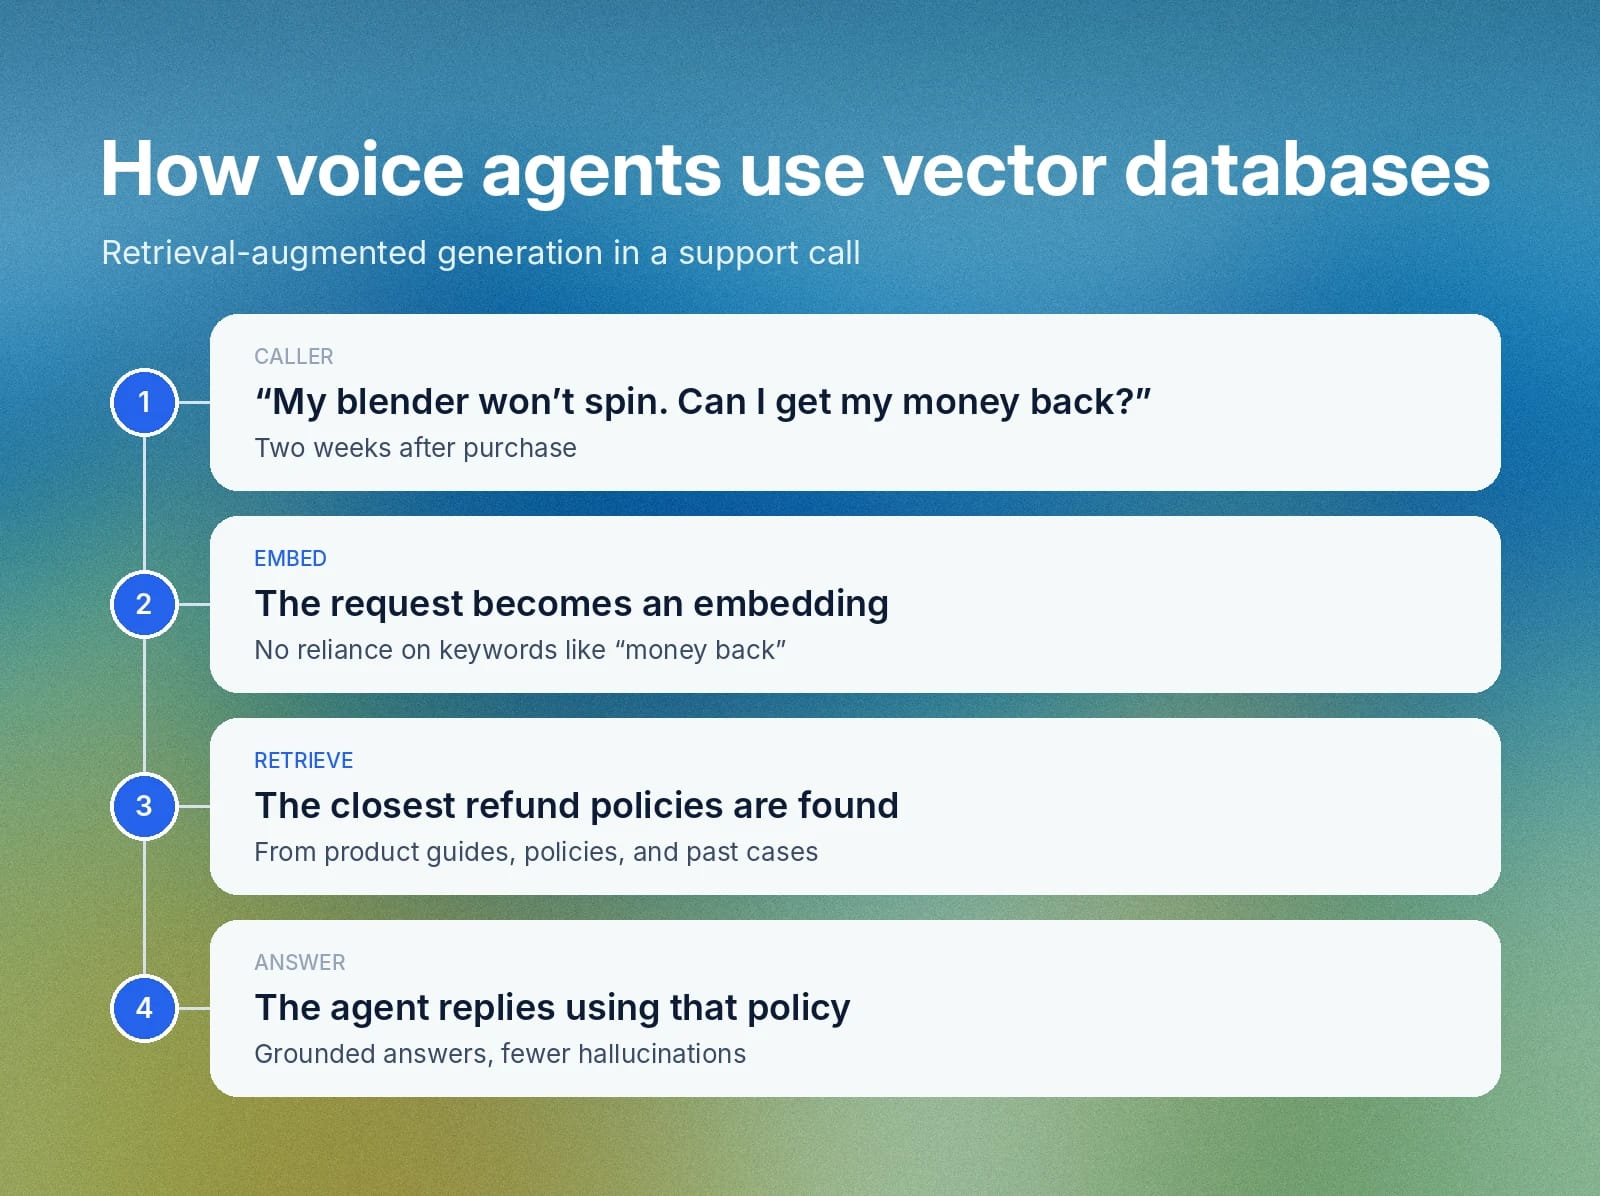
O agente de IA se conecta ao banco de dados vetorial usando um sistema de geração aumentada por recuperação (RAG) .
Quando o agente de voz com IA recebe uma consulta, ele verifica se tem informações suficientes para responder ao cliente. Se não tiver dados atuais ou suficientes, o RAG recupera dados semanticamente correspondentes para complementar a resposta.
Vamos supor que um agente de voz receba a seguinte reclamação: “Meu liquidificador não gira depois de duas semanas. Posso receber meu dinheiro de volta?” Em vez de buscar palavras-chave exatas como “não gira” e “dinheiro de volta”, o RAG transforma a solicitação em um embedding. Em seguida, recupera políticas de reembolso com o significado mais próximo.
Ao recuperar documentos internos relevantes, um sistema RAG apoiado por um banco de dados vetorial ajuda a reduzir alucinações em agentes de voz, embora não as elimine. Em vez de tentar adivinhar, agentes de IA e humanos podem usar documentos internos para resolver as consultas dos clientes.
Banco de dados vetorial vs. banco de dados relacional: principais diferenças
Um banco de dados relacional usa linhas e colunas, além de um esquema fixo, para armazenar dados. Já um banco de dados vetorial usa embeddings, que representam dados não estruturados.
Bancos de dados relacionais são adequados para correspondências exatas e consultas estruturadas, como encontrar todos os pedidos feitos em uma determinada data. Já os bancos de dados vetoriais recuperam os embeddings armazenados com significado mais próximo de uma consulta, o que é mais eficaz para perguntas em linguagem natural.
Na maioria das vezes, as equipes usarão ambos, pois cada um tem seu papel no trabalho com dados.
Banco de dados vetorial vs. banco de dados de grafos: quando usar cada um
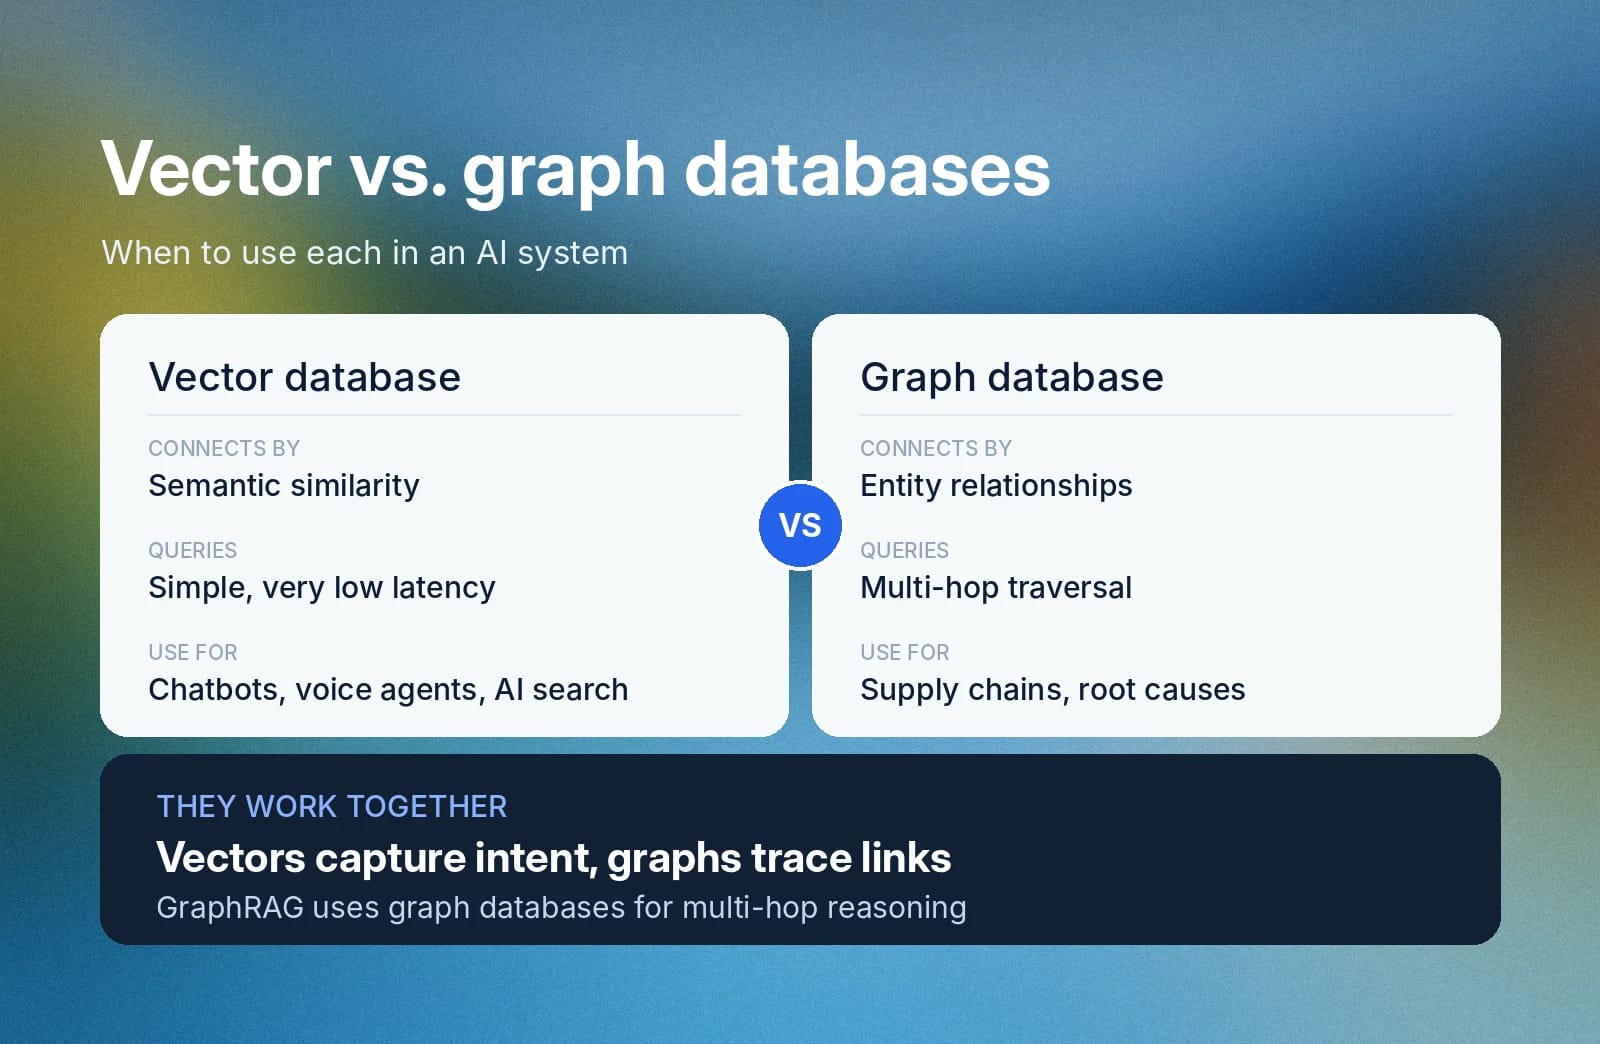
Bancos de dados de grafos usam grafos de conhecimento para conectar entidades diferentes de maneiras que refletem sua hierarquia e seus relacionamentos. Sistemas de IA como o GraphRAG usam bancos de dados de grafos para responder a consultas que exigem raciocínio de múltiplos saltos.
Quando você consulta um banco de dados de grafos, ele encontra o ponto de dados inicial e usa um algoritmo de travessia de grafos para localizar entidades relacionadas. Por exemplo, nomes de clientes podem ser vinculados sequencialmente a datas de renovação e tickets de suporte.
Por outro lado, bancos de dados vetoriais armazenam dados não estruturados com representações numéricas baseadas em seu significado semântico. Eles permitem que sistemas RAG realizem correspondências simples de consultas com latência muito baixa. Por exemplo, um banco de dados vetorial apresenta a política de reembolso ao processar “Quero um reembolso”.
Bancos de dados vetoriais e de grafos são úteis para sistemas de IA. Você pode usar ambos juntos:
- Use um banco de dados vetorial quando quiser potencializar um chatbot, agente de voz ou mecanismo de busca com IA que precise captar a intenção em linguagem humana.
- Use um banco de dados de grafos quando quiser resolver problemas de interdependência, como rastrear cadeias de suprimentos, recomendar produtos relevantes ou realizar análise de causa raiz.
Quais tipos de bancos de dados vetoriais estão disponíveis?
Em geral, há dois tipos de bancos de dados vetoriais, diferenciados pelo estilo de arquitetura.
- Banco de dados vetorial independente: São bancos de dados independentes, desenvolvidos para essa finalidade, que oferecem suporte a buscas multidimensionais por similaridade com baixa latência. Muitas aplicações de IA generativa se conectam a bancos de dados vetoriais independentes para escalar cargas de trabalho intensivas de consulta.
- Extensão de banco de dados vetorial: Bancos de dados existentes podem incorporar recursos de busca vetorial para permitir a recuperação baseada em semântica para modelos de IA. Esses bancos de dados mantêm sua arquitetura original, como um esquema SQL baseado em linhas, mas oferecem suporte a tipos de dados vetoriais.
A escolha entre eles depende principalmente de você precisar de um sistema dedicado para grandes cargas de trabalho de consulta ou de querer adicionar um elemento de busca semântica a um banco de dados que já utiliza.
Exemplos de bancos de dados vetoriais
Veja dois exemplos de bancos de dados vetoriais:
- Bancos de dados vetoriais independentes: Pinecone é um serviço gerenciado de banco de dados vetorial. Milvus, Weaviate, Qdrant e Chroma são bancos de dados vetoriais de código aberto.
- Extensões de bancos de dados vetoriais: O pgvector adiciona busca por similaridade vetorial ao PostgreSQL, e o MongoDB Atlas Vector Search a adiciona ao MongoDB.
A opção mais adequada depende da sua escala e de quanta infraestrutura você deseja gerenciar.
Comece a usar o ElevenAgents para agentes de voz prontos para recuperação
O ElevenAgents permite que agentes de voz recuperem informações da sua própria base de conhecimento para oferecer respostas conversacionais e contextualizadas. Com o RAG, o agente recupera o conteúdo semanticamente mais semelhante dos documentos, URLs ou textos que você adiciona à base de conhecimento. Você pode definir a recuperação como “Sob demanda”, para que o agente pesquise a base de conhecimento apenas quando decidir que precisa dela.
É compreensível que implementar RAG aumente a latência de geração de respostas. No entanto, graças aos nossos avanços de engenharia, reduzimos a latência mediana do RAG do ElevenAgents de 326 ms para 155 ms.
Comece a usar o ElevenAgents e saiba como configurar sua base de conhecimento aqui.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.


