
Guia prático: frameworks de agentes open source e ElevenAgents
- Escrito por
- Akhil Chauhan
- Publicado
- Última atualização
OuvirOuça este artigo
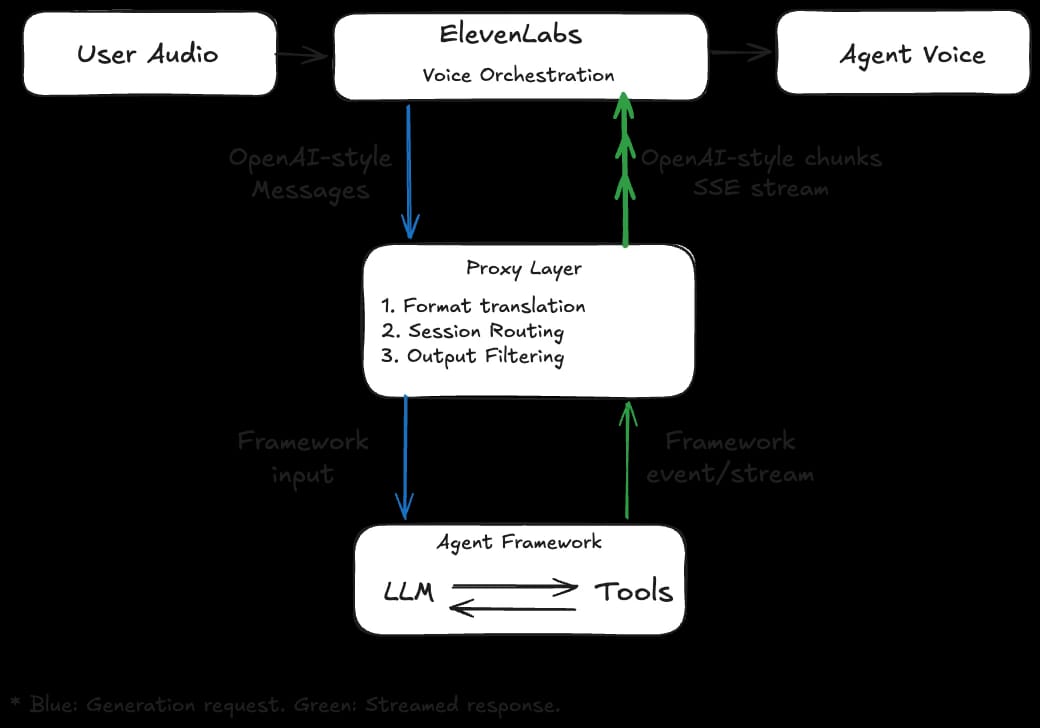
No nosso post anterior sobre Integração de agentes externos à orquestração de voz da ElevenLabs, explicamos como as equipes podem conectar sua orquestração existente de agentes baseados em texto à ElevenLabs por meio do Custom LLM. Com base nesse fundamento, este guia mostra como os principais frameworks de agentes open source podem ser adaptados e implantados por trás da interface Custom LLM. O resultado é uma arquitetura flexível, em que a voz é adicionada a sistemas de agentes consolidados sem comprometer o gerenciamento de estado, a orquestração de ferramentas ou o controle específico da aplicação. Em todos os frameworks, seguimos o mesmo padrão de três etapas: criar uma solicitação de geração, extrair a resposta final em texto e reformatá-la no formato Server-Sent Events (SSE) compatível com OpenAI. A ElevenLabs oferece suporte aos formatos Chat Completions e Responses. Embora este guia aborde quatro frameworks amplamente adotados, os padrões se aplicam a qualquer runtime capaz de produzir saída em streaming compatível com OpenAI.
Configuração geral
Os exemplos desta seção usam Python e FastAPI, mas qualquer stack que lide com solicitações HTTP POST e respostas SSE em streaming funcionará. Quando a orquestração de voz da ElevenLabs detecta um provável fim de turno, ela envia uma solicitação de geração ao endpoint Custom LLM configurado. Esta seção apresenta os principais componentes dessa camada de tradução: a ponte ou proxy que faz a orquestração de voz e o framework de agentes falarem a mesma língua.
Naturalmente, os clientes podem escolher cada framework pela familiaridade geral ou por sua capacidade de atender a um objetivo específico. O LlamaIndex, por exemplo, foi originalmente desenvolvido para simplificar a configuração de Retrieval-Augmented Generation (RAG), enquanto o CrewAI foi criado para automatizar tarefas definidas na era dos agentes. Objetivos de design diferentes produzem estruturas de resposta diferentes, e cada uma exige um tratamento específico. Transmitir chunks à medida que o LLM os gera, em vez de esperar por um turno completo, é essencial porque permite que o modelo de Text-to-Speech (TTS) comece a gerar fala mais cedo, reduzindo assim a latência percebida. Nosso foco são quatro frameworks populares: LangGraph, Google ADK, CrewAI e LlamaIndex.
Uma observação sobre o código compartilhado
Cada framework precisa transmitir respostas como chunks SSE compatíveis com OpenAI. Apresentamos uma pequena função auxiliar, usada em todos os exemplos, para construir esses chunks.
Com essa base estabelecida, vamos começar com o LangGraph.
LangGraph
O LangGraph modela agentes como grafos, em que os nós representam etapas individuais e as arestas definem o fluxo de controle entre elas. A configuração mínima é simples: inicialize um modelo de chat, defina as ferramentas do agente e crie o runtime do grafo de agentes.
Para cada solicitação de geração, o agente LangGraph recebe o histórico completo da conversa, o que permite manter internamente o estado necessário. O LangGraph oferece suporte à persistência no servidor por meio de Checkpoints, embora não os abordemos aqui para manter a implementação mínima.
Com o gerenciamento de estado resolvido, a próxima decisão específica do LangGraph é o modo de streaming, que oferece duas opções, cada uma adequada a um caso de uso diferente:
- stream_mode="values" fornece snapshots do estado do grafo. É mais simples de implementar, mas inclui um estado de mensagem mais completo em cada resposta, o que aumenta a latência em fluxos conversacionais em tempo real.
- stream_mode="messages" transmite chunks incrementais de mensagens do modelo. Em geral, é a opção preferida para interações por voz em tempo real, pois reduz o tempo até o primeiro áudio na camada de orquestração da ElevenLabs.
Mais especificamente, a implementação de mensagens do loop de agentes inclui etapas intermediárias, como atualizações de chamada de ferramentas, que não devem ser faladas em voz alta. O proxy as filtra e envia apenas o texto de resposta destinado ao usuário para a camada de TTS. Veja um exemplo de turno com uso de ferramenta.
[1] O modelo decide chamar uma ferramenta (tool_calls=["get_price"])[2] A ferramenta é executada e retorna dados (result="$24.99") [3] O modelo produz uma resposta usando o resultado (content="Custa $24.99")
Naturalmente, apenas os chunks da etapa 3 devem ser encaminhados no stream SSE. Na prática, duas verificações tratam essa filtragem no loop de streaming: uma para manter apenas eventos langgraph_node == "model" e outra para ignorar conteúdo vazio. Juntas, essas verificações garantem que apenas o texto do assistente destinado ao usuário seja encaminhado à ElevenLabs como SSE. Reunindo esses conceitos, apresentamos uma implementação leve do proxy de solicitações.
Isso garante que apenas chunks do modelo destinados ao usuário sejam encaminhados à ElevenLabs. Como o LangGraph torna visível a execução interna de ferramentas por meio do stream de estado, a filtragem é explícita e controlada pelo proxy.
Agora, vamos explorar as particularidades de trabalhar com o Agent Development Kit (ADK) do Google
Google ADK
O ADK do Google abstrai o loop de runtime com algumas primitivas principais: Agent, Runner e SessionService. O Runner do ADK fica entre a camada HTTP e a definição do agente. Ele gerencia o roteamento de mensagens, a orquestração de ferramentas, o ciclo de vida das sessões e o streaming de eventos.
Com o agente, o backend de sessões e o runner inicializados, o proxy resolve ou cria uma sessão do ADK para cada solicitação recebida. No ADK, session_id controla a persistência de memória: reutilizar o mesmo session_id entre turnos mantém automaticamente o histórico, as chamadas de ferramentas e as respostas anteriores. Como a identidade da conversa fica na camada anterior da ElevenLabs, o proxy faz esse mapeamento explicitamente. Ao passar o identificador correto para a solicitação de geração, o SDK consegue lidar internamente com o contexto anterior. Passamos o identificador arbitrário durante o início da conversa por meio de parâmetros extras enviados no corpo da solicitação.
Com a mensagem e a sessão preparadas, o runner pode ser chamado. As chamadas e os resultados de ferramentas ainda aparecem como eventos internos do ADK durante a execução, mas são tratados como etapas intermediárias de orquestração, e não como saída destinada ao usuário. Isso elimina a necessidade de um filtro manual em comparação com frameworks em que chamadas de ferramentas aparecem como texto visível ao usuário.
O handler abaixo é uma implementação simplificada que inclui a resolução de sessão e a lógica de buscar ou criar diretamente no código.
Agora, vamos analisar o CrewAI, que por design é mais centrado em tarefas.
CrewAI
O CrewAI foi projetado para orquestrar workflows multiagente em torno de tarefas estruturadas (pesquisar, escrever, resumir), em vez de loops de diálogo abertos. Os agentes são definidos com uma função, um objetivo e um histórico. A execução é centrada em objetos Task, cada um com uma descrição clara e uma saída esperada.
Diferentemente do modelo de loop de agentes usado no LangGraph e no ADK, o CrewAI normalmente constrói uma Task e uma Crew por solicitação para definir a unidade de trabalho daquele turno da conversa. Mantemos o contexto conversacional inserindo os turnos anteriores na próxima tarefa por meio de um placeholder. A variável {crew_chat_messages} é preenchida em cada solicitação com o histórico acumulado da conversa e, depois, interpolada na descrição da tarefa durante a execução. Também buscamos produzir texto limpo e pronto para fala, filtrando explicitamente padrões de rastreamento intermediários (Thought, Action, Action Input, Observation) e emitindo apenas o texto da resposta final.
O handler abaixo reúne a construção de tarefas por solicitação, a interpolação do histórico, o streaming no nível da Crew, a filtragem de rastreamento e a formatação da saída.
Agora, vamos analisar o LlamaIndex, que segue um caminho diferente e se concentra em um modelo nativo de streaming orientado a eventos.
LlamaIndex
Diferentemente dos outros frameworks abordados neste post, o LlamaIndex foi projetado para conectar LLMs a fontes de dados externas, como repositórios de documentos, índices e pipelines de recuperação. Sua camada de agentes, FunctionAgent, se apoia nessa base para recuperar informações e raciocinar sobre contexto estruturado, em vez de diálogo aberto ou execução de tarefas.
Para preservar a continuidade da conversa, o proxy transforma as mensagens recebidas em mensagens de chat do LlamaIndex e, em seguida, as separa entre o turno mais recente do usuário (user_msg) e os turnos anteriores (chat_history). O campo event.delta de cada evento AgentStream contém o próximo fragmento de texto, que é mapeado diretamente para um chunk delta.content no estilo OpenAI. Deltas não vazios podem ser encaminhados como estão, tornando esta a ponte de streaming mais simples do guia. O stream contém tanto eventos de orquestração, como chamadas de ferramentas e resultados, quanto eventos de fala, como deltas de texto do assistente. Para manter a saída de voz limpa, o proxy mantém apenas eventos AgentStream e ignora deltas vazios.
[1] AgentStream (delta='') ← ignorado[2] ToolCall ← ignorado[3] ToolCallResult ← ignorado[4] AgentStream (delta='It') ← encaminhado ✓[5] AgentStream (delta=' costs') ← encaminhado ✓[6] AgentStream (delta=' $49.99')← encaminhado ✓
Essa separação mantém a mecânica intermediária das ferramentas fora da saída falada, preservando ao mesmo tempo a fala incremental de baixa latência. O handler pronto para uso abaixo reúne essas etapas.
O LlamaIndex é menos prescritivo sobre os padrões de runtime conversacional de ponta a ponta do que os frameworks com camadas de orquestração integradas mais robustas. Em implantações de produção, isso normalmente exige que os clientes implementem o gerenciamento de sessões, proteções para respostas, a orquestração de ferramentas e o rastreamento.
Conclusão
Cada framework deste guia se conecta à ElevenLabs pelo mesmo contrato: aceitar uma solicitação Completions ou Responses no estilo OpenAI e transmitir chunks SSE de volta. Isso permite que as equipes adicionem a orquestração de voz a uma implementação de agente existente com mudanças mínimas, preservando o que já construíram e habilitando IA conversacional em tempo real. Essa modularidade é um princípio central da plataforma ElevenAgents. Seja para expandir um agente existente ou criar uma solução nativa de voz desde o início, a orquestração de voz do ElevenAgents foi criada para atender às organizações onde elas estão.
Se você já executa um agente com um framework open source e quer habilitar a voz, experimente esta abordagem e conte para nós o que achou.

