Como resolver problemas de precisão em Text to Speech
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
Embora sejam treinados com enormes conjuntos de dados de voz e consigam produzir áudio de alta fidelidade de forma consistente, a maioria dos modelos de Text to Speech (TTS) ainda pode pronunciar palavras incorretamente ou apresentar outros problemas de fala. Pronúncias incorretas acontecem quando um mecanismo de TTS encontra palavras e frases fora do repertório de fala presente em seus dados de treinamento. Isso ocorre com mais frequência em jargões do setor, nomes de marcas ou nomes próprios.
Os mecanismos de TTS também podem gerar uma fala apressada, truncada ou robótica quando os trechos de texto são longos ou pontuados para leitura, em vez de estruturados para serem falados em voz alta.
Você também pode encontrar alguns problemas técnicos comuns ao conectar seus aplicativos a mecanismos de TTS via API.
Neste artigo, vamos explorar essas três categorias de problemas e formas comuns de resolver cada uma.
Resumo
- Em geral, falhas de Text to Speech se dividem em pronúncias vocais incorretas, ritmo/cadência pouco naturais e erros técnicos de execução da API.
- A forma mais eficaz de corrigir pronúncias incorretas é usar dicionários no padrão W3C Pronunciation Lexicon Specification (PLS) ou ajustá-las individualmente com tags fonéticas em linha nos seus roteiros.
- Você pode ajudar a controlar a naturalidade da fala formatando e pontuando seu roteiro corretamente. Um texto formatado para ser falado costuma ser diferente de um texto feito apenas para leitura.
- Você pode diagnosticar falhas de API usando códigos de status HTTP padrão.
- Testar antecipadamente e de forma isolada a pronúncia de nomes de marcas, nomes próprios e frases novas pode evitar uma longa investigação de problemas depois.
Por que o Text to Speech não está funcionando?
De modo geral, os problemas de Text to Speech se encaixam em três categorias.
Tipos de problemas de TTS
Pronúncias incorretas
O modelo de TTS lê palavras ou frases novas de forma incorreta, como o nome da sua marca, jargões do setor, siglas ou homógrafos.
Entonação & cadência pouco naturais
A fala gerada é monótona, faz pausas em pontos estranhos ou passa rapidamente por trechos que exigem uma entrega mais lenta.
Falhas de integração & API
Seu aplicativo não gera fala por um ou mais motivos técnicos, como IDs de voz ausentes, limites de carga de trabalho ou chaves de API inválidas.
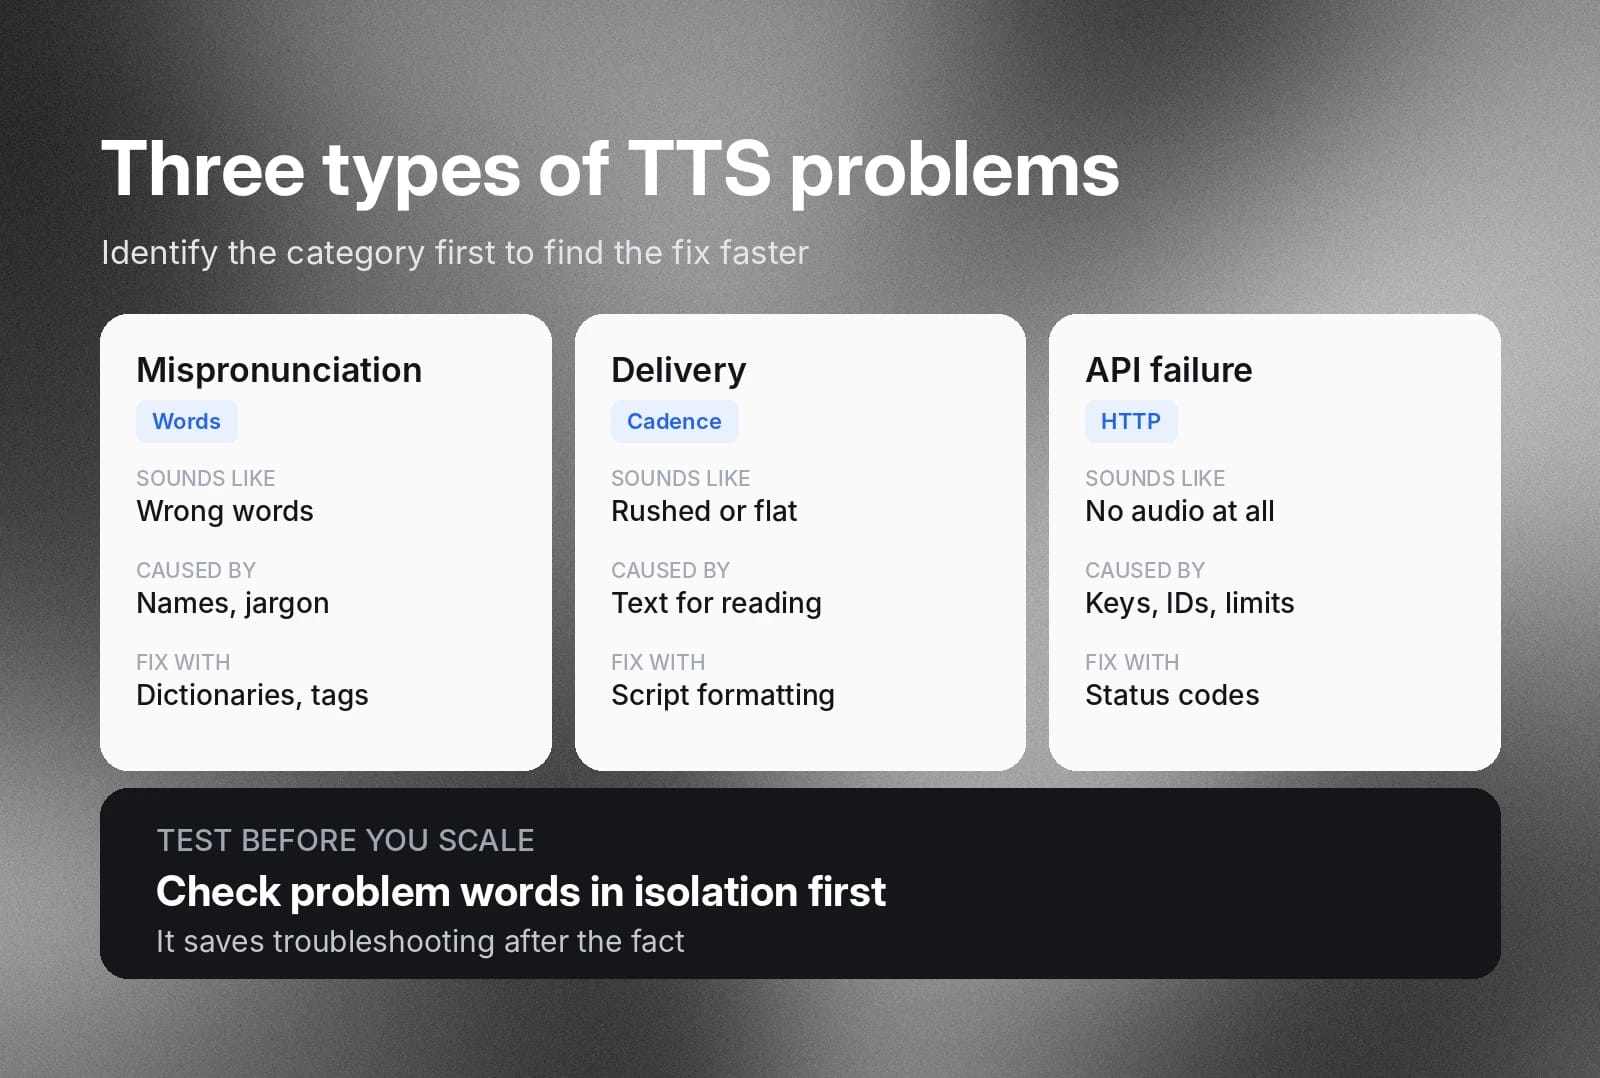
Este guia explica cada um desses três problemas em mais detalhes para que você entenda exatamente qual questão de qualidade de saída ou problema técnico está enfrentando. Entendê-los ajuda você a identificar a solução certa mais rápido.
Como resolver problemas de precisão em Text to Speech: pronúncia incorreta e entonação pouco natural
Engenheiros treinam modelos modernos de voz neural com enormes conjuntos de dados de fala. Eles conseguem gerar fala natural com quase incontáveis combinações de palavras. No entanto, nenhum conjunto de dados de treinamento é universal. Sempre haverá pronúncias incomuns e palavras obscuras ou nomes próprios que o modelo não falará corretamente.
Isso não acontece com frequência, mas todas as pessoas que usam modelos de TTS regularmente devem estar preparadas para lidar com a situação quando ela ocorrer. Primeiro, é importante entender por que essas pronúncias incorretas acontecem.
Causas comuns de erros de fala
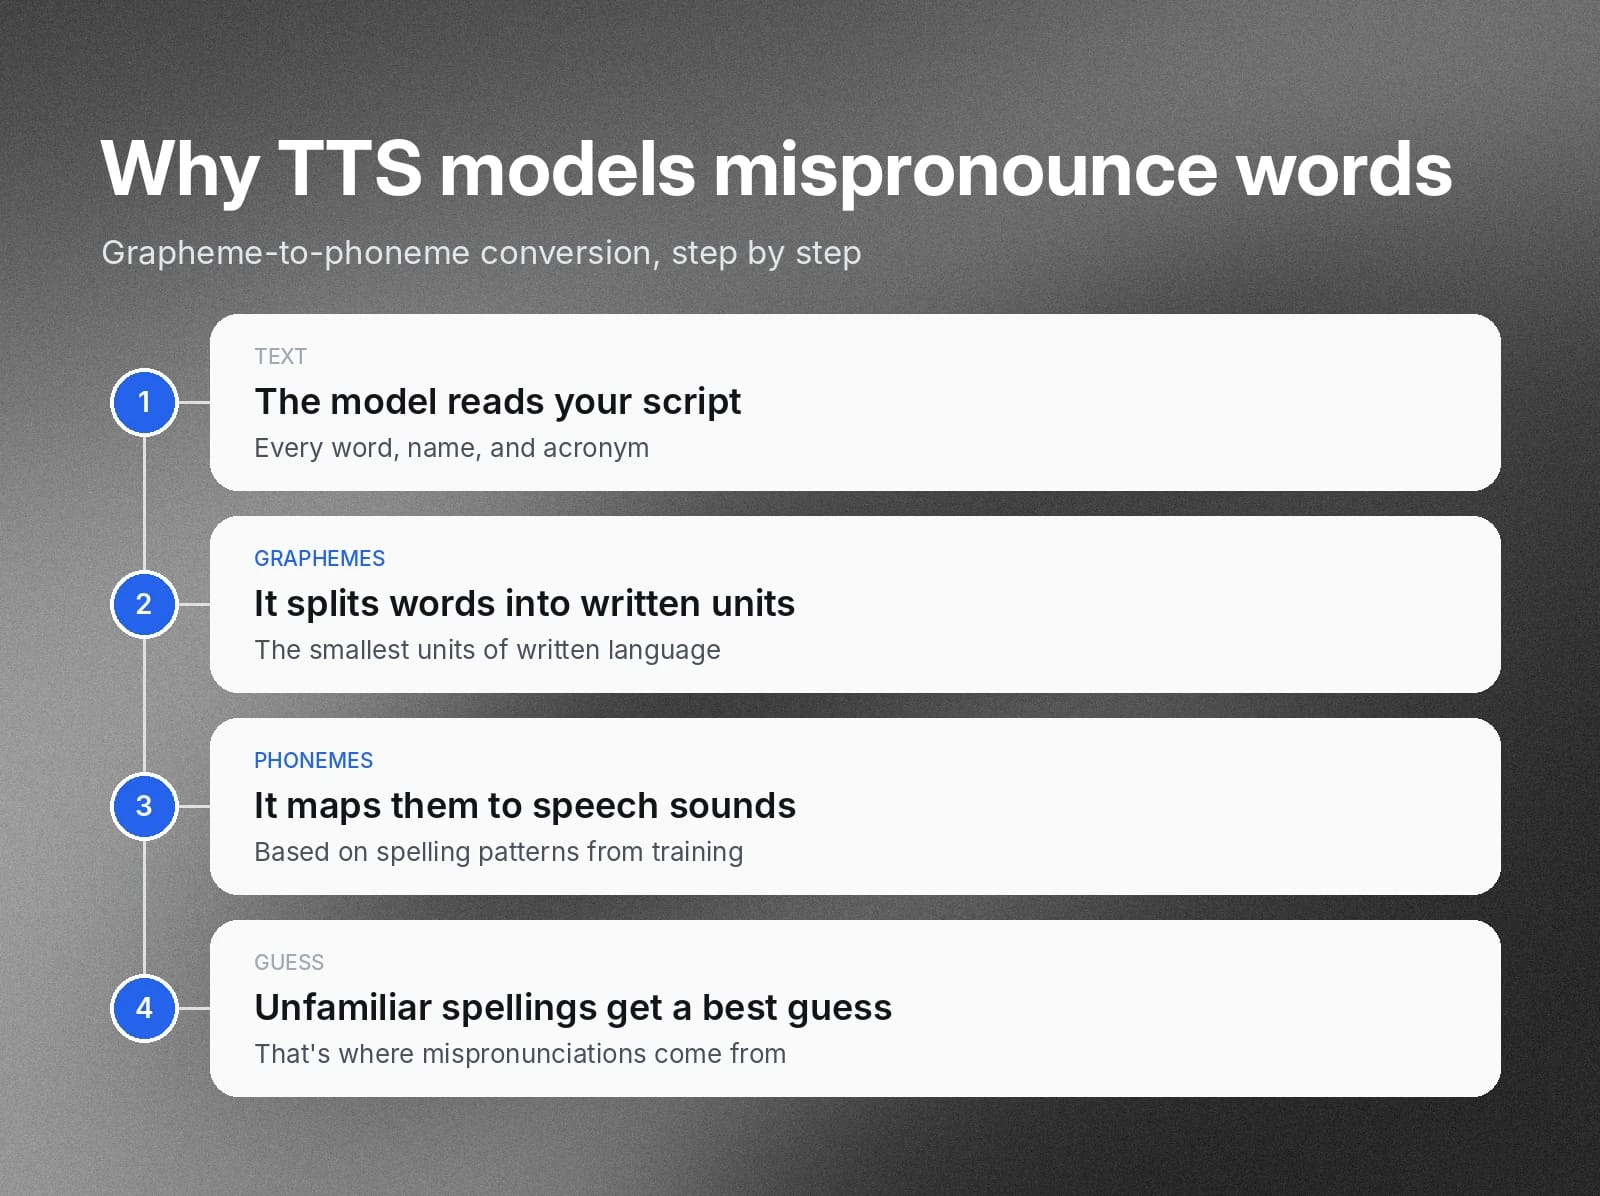
Os modelos de síntese de fala funcionam convertendo texto em fala por meio de um processo chamado conversão grafema-fonema (G2P). Fonemas são as menores unidades de som falado. Grafemas são as menores unidades da linguagem escrita, geralmente uma letra, que representam um fonema.
Quando o texto de entrada não corresponde aos padrões ortográficos que os modelos encontraram nos dados de treinamento, eles fazem sua melhor estimativa da pronúncia fonética. Às vezes, isso leva a pronúncias incorretas.
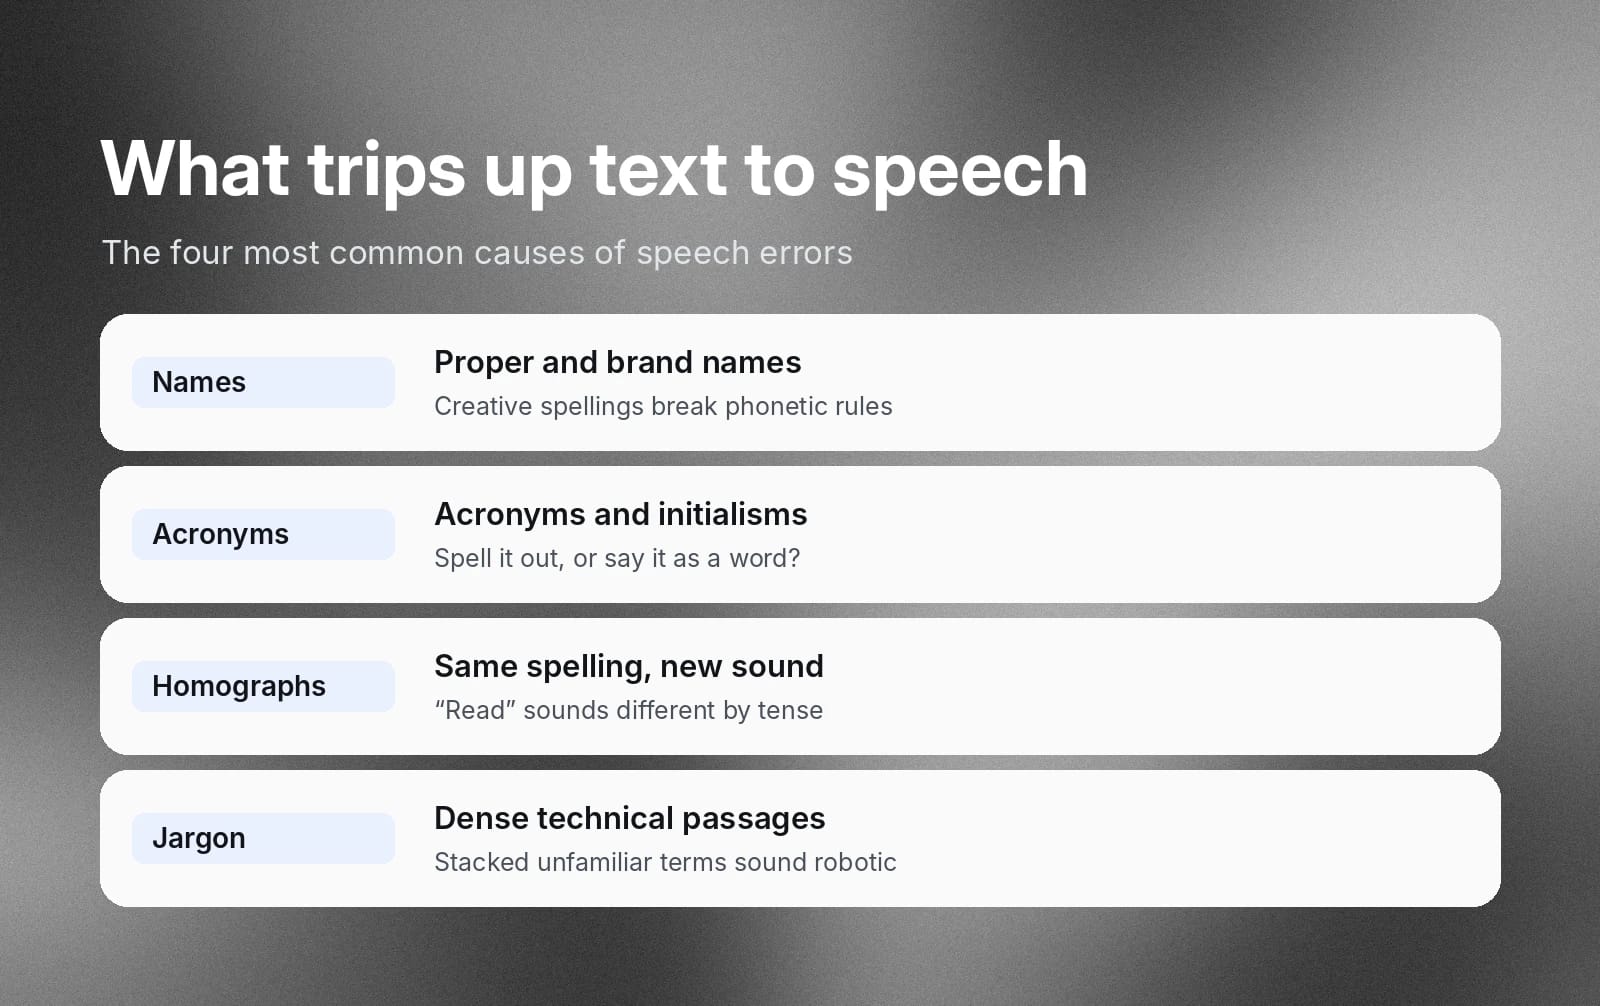
Nomes próprios e nomes de marcas
Empresas costumam usar grafias criativas para nomes de marcas. Elas chamam a atenção, mas muitas vezes também confundem modelos de síntese de fala. O mesmo pode acontecer com nomes e sobrenomes criativos, pelo mesmo motivo.
Quando um modelo encontra um nome desconhecido, ele tenta aplicar as regras fonéticas básicas que aprendeu. A fala gerada pode ficar muito diferente do que você deseja.
Siglas & acrônimos
Pense na sigla NASA. Imagine que você nunca a viu antes, como poderia acontecer com um modelo de fala. Você a pronunciaria “N.A.S.A.” ou “nassa?” E uma API de software? Seria “A.P.I.” ou “api”? E se sua empresa estiver vendendo uma nova ferramenta de software com uma nova sigla? Você pode ter certeza de que ela não está nos dados de treinamento de um modelo de fala. Então, o modelo teria de adivinhar como você quer que ela seja pronunciada, a menos que você forneça instruções personalizadas.
Homógrafos
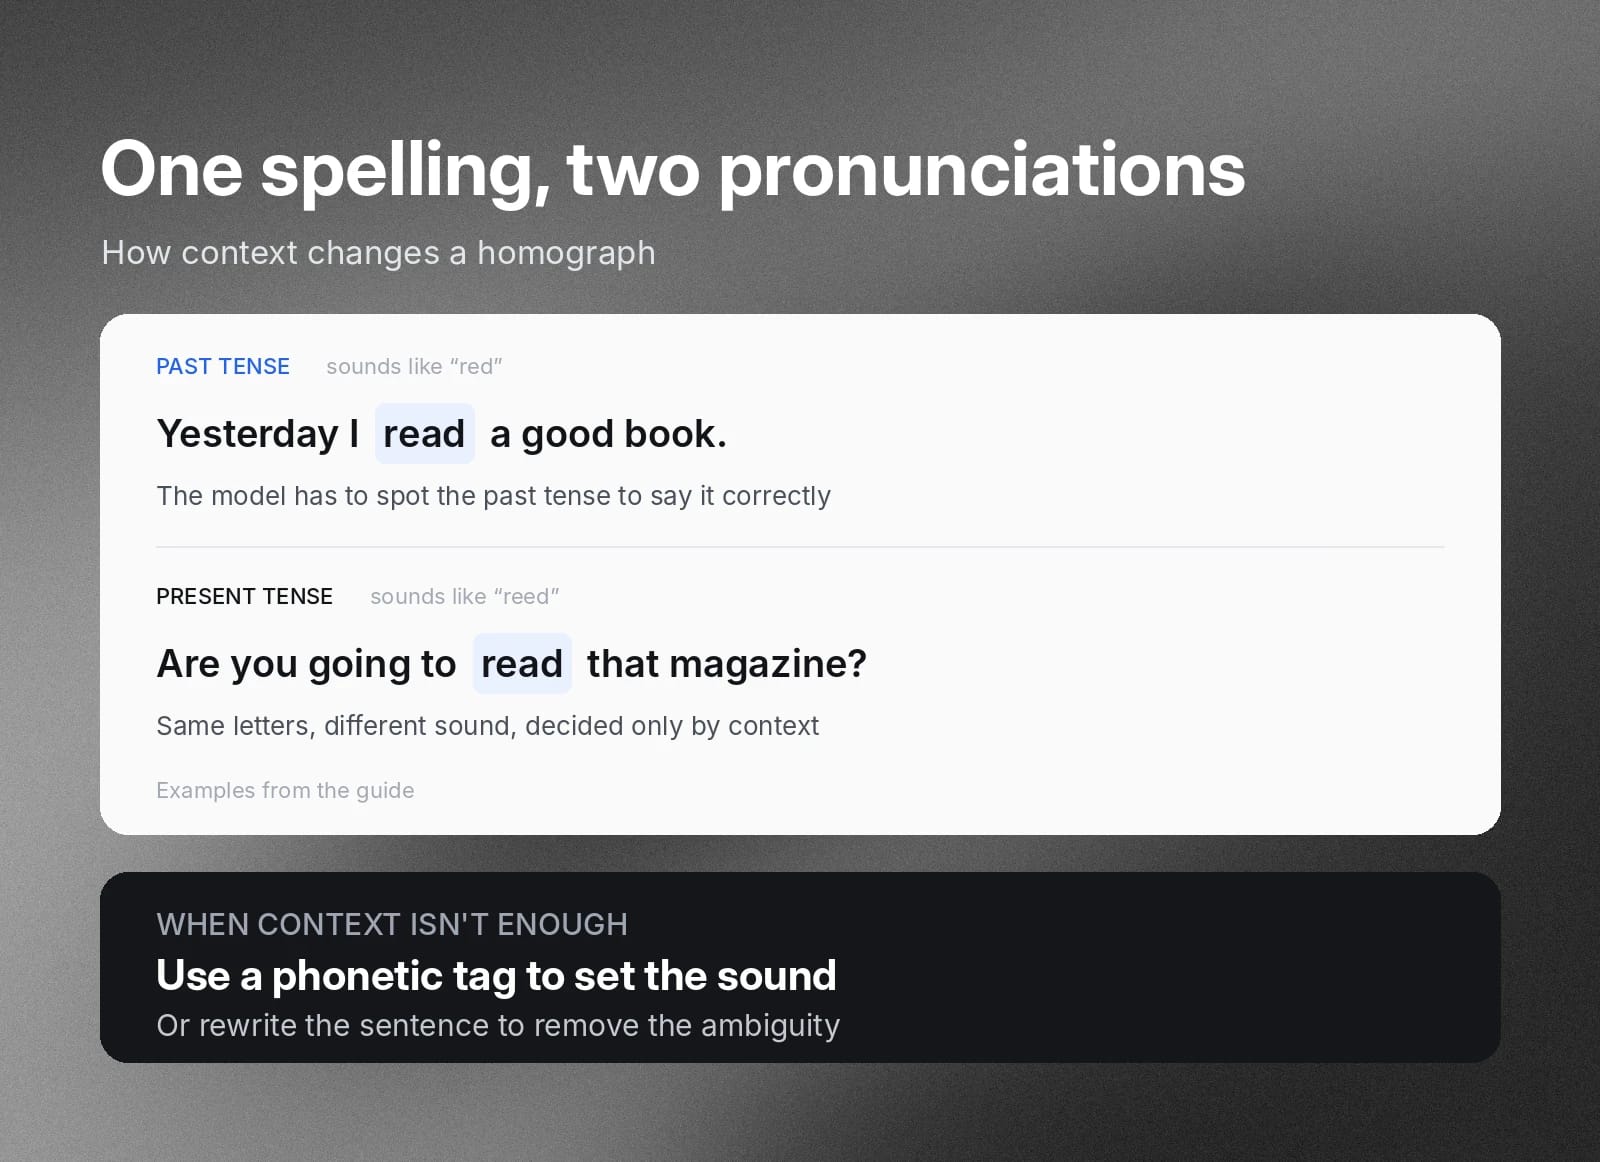
Homógrafos são palavras que têm a mesma grafia, mas pronúncias diferentes dependendo do contexto. Por exemplo, a palavra em inglês “read” é escrita da mesma forma, mas é pronunciada de maneira diferente no passado e no presente.
- “Ontem eu li um bom livro.”
- “Você vai ler aquela revista?”
Um modelo de fala precisa ter compreensão contextual suficiente para determinar como pronunciar homógrafos da maneira que você deseja.
Padrões de ênfase pouco naturais
Frases longas cheias de jargão técnico podem reunir rapidamente palavras obscuras, pronúncias específicas e siglas. Um erro que sozinho passaria despercebido pode rapidamente se tornar parte de uma fala monótona e robótica, enquanto o modelo tenta interpretar muitas palavras e construções desconhecidas.
Duas formas de controlar a pronúncia da voz
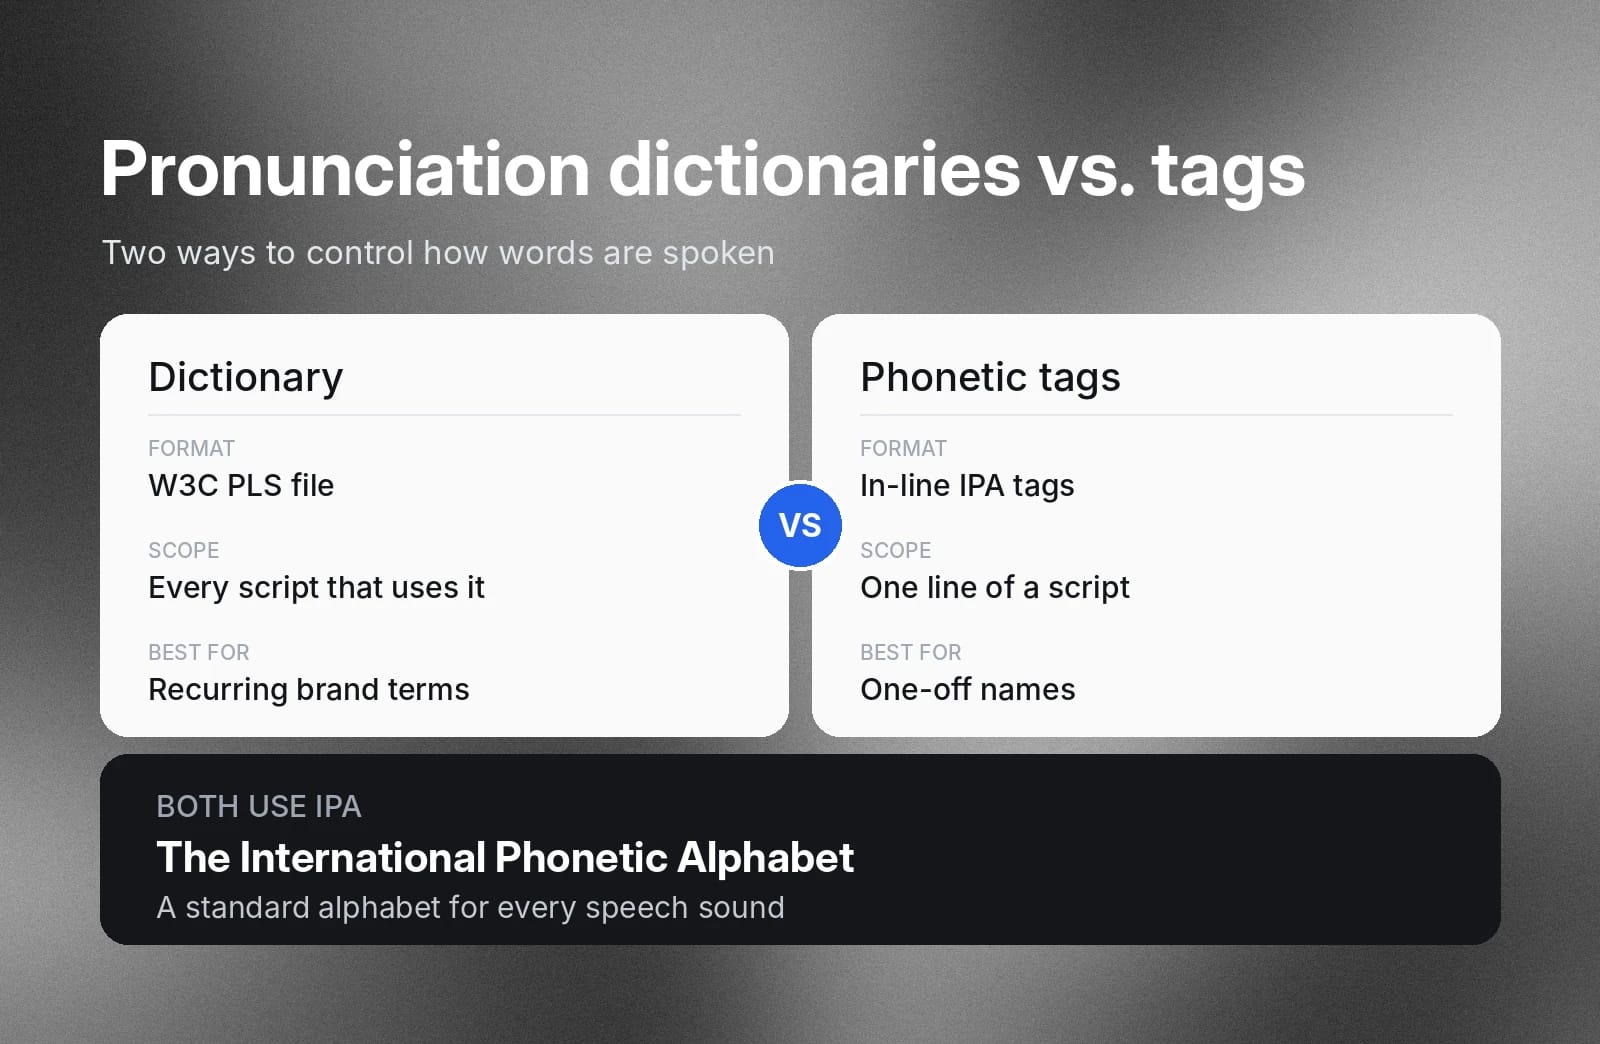
Você não precisa reescrever completamente seus roteiros para evitar esses cenários. Os modelos modernos de fala neural incluem duas ferramentas para corrigi-los de forma eficiente, caso a caso: dicionários de pronúncia e tags fonéticas no roteiro.
Dicionários de pronúncia para Text to Speech
Os dicionários são ideais quando você tem um conjunto de pronúncias personalizadas que se repetem regularmente nos seus projetos de TTS. Por exemplo, se sua empresa vende dispositivos médicos e seus roteiros contêm com frequência termos técnicos, procedimentos médicos e outros conteúdos específicos da área.
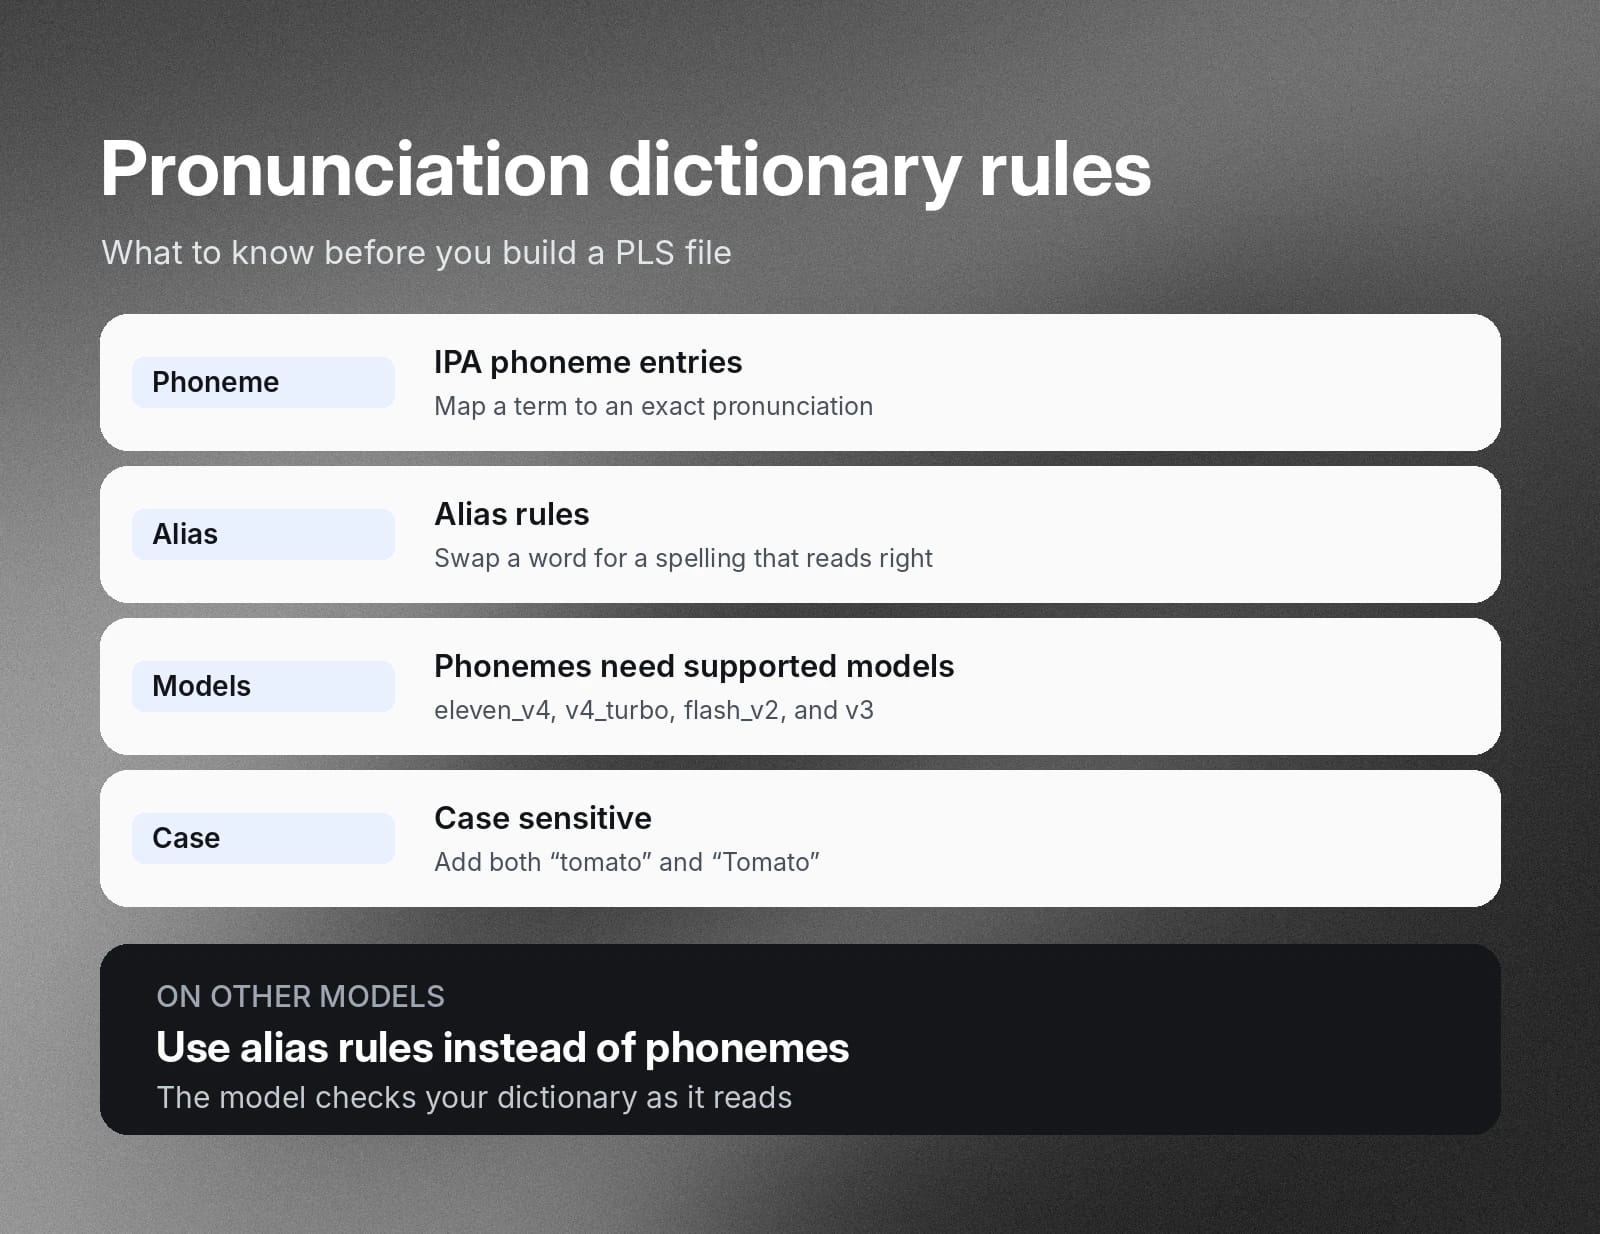
O formato padrão W3C Pronunciation Lexicon Specification (PLS) fornece uma estrutura para associar esses termos a pronúncias fonéticas específicas usando a notação do Alfabeto Fonético Internacional (IPA). O Alfabeto Fonético Internacional é um alfabeto padronizado de todos os sons de fala possíveis. O modelo de fala consulta seu dicionário enquanto lê o roteiro e usa as pronúncias listadas sempre que encontra palavras presentes nele. As entradas de fonemas funcionam apenas com os modelos eleven_v4, eleven_v4_turbo, eleven_flash_v2 e eleven_v3. Em outros modelos, use regras de alias. Os arquivos PLS diferenciam maiúsculas de minúsculas, então adicione tanto “tomato” quanto “Tomato” se precisar dos dois.
Tags fonéticas no roteiro
Tags fonéticas geralmente são a melhor opção quando você precisa ajustar linhas específicas de um roteiro. Em vez de criar um dicionário, você usa tags fonéticas em linha que orientam o modelo de fala a pronunciar uma palavra como deseja, de acordo com o IPA.
Por exemplo, digamos que você esteja escrevendo o roteiro de um podcast e queira mencionar uma especialista do setor duas ou três vezes. Em vez de adicionar o nome dela ao seu dicionário de pronúncia corporativo, basta marcá-lo com a pronúncia correta quando o usar no roteiro.
Escreva e formate roteiros que soem naturais quando falados em voz alta
Dicionários e tags são úteis para lidar com problemas em palavras individuais na fala gerada, mas não resolvem aspectos gerais de entrega, cadência e dinâmica da fala. Ao escrever um roteiro, é importante elaborar o texto sabendo que ele será falado em voz alta. Suas escolhas de palavras, formas de expressão e pontuação muitas vezes devem ser diferentes das de um texto feito apenas para leitura.
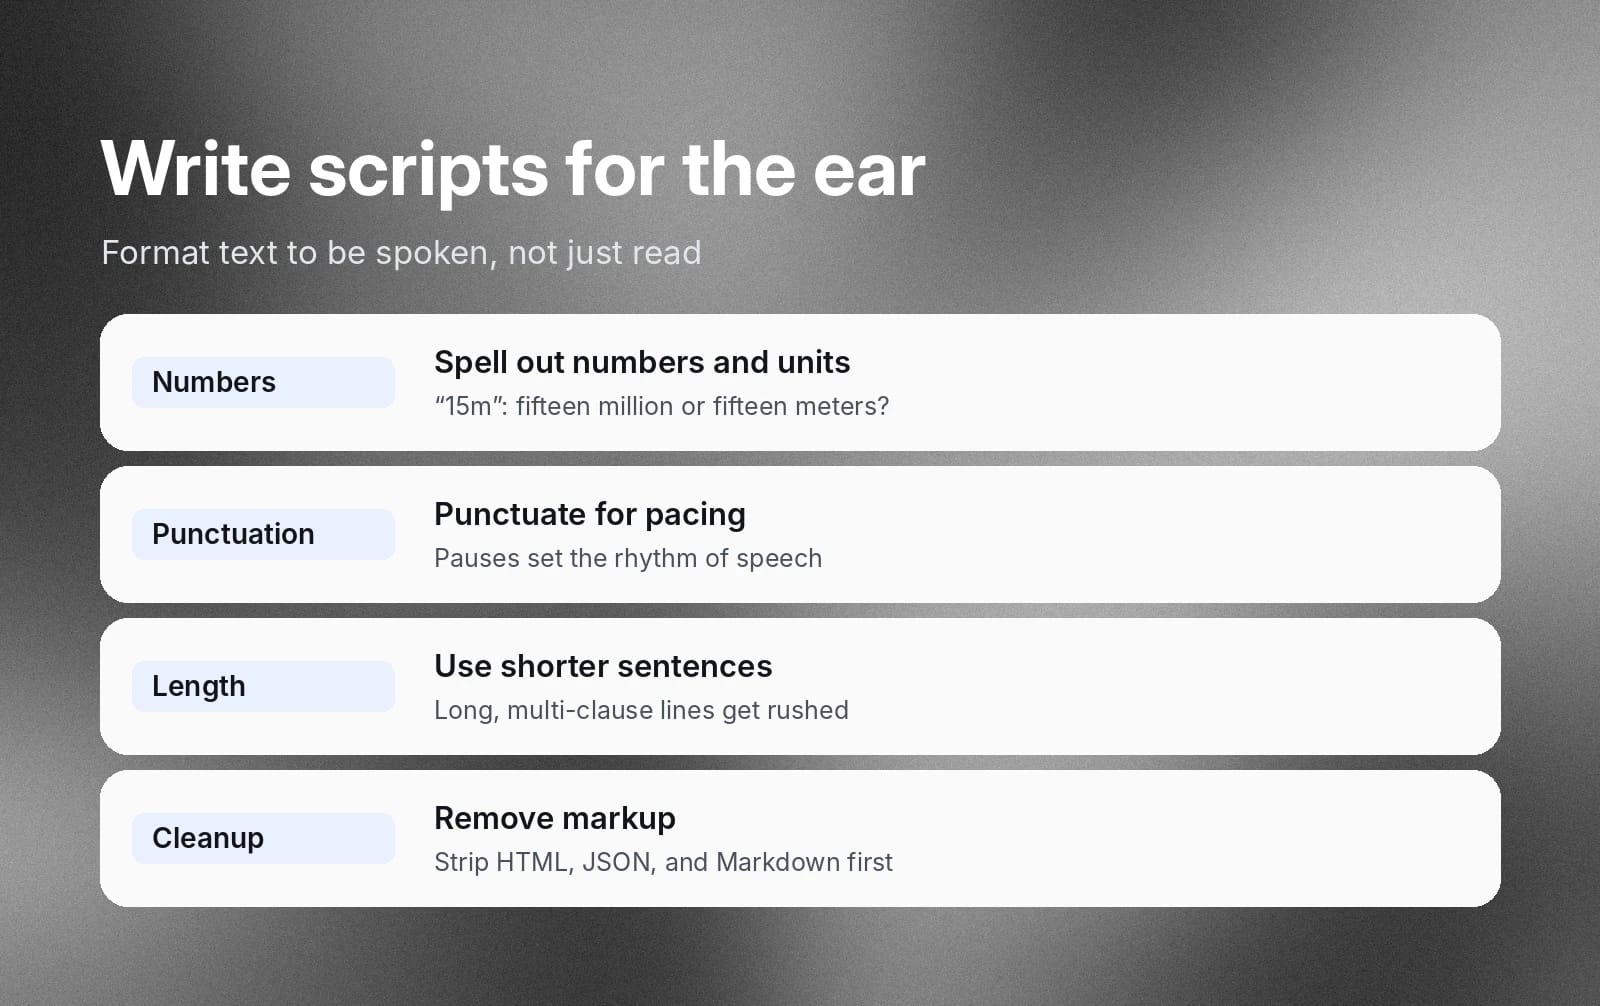
Escreva para o ouvido, não para os olhos
Escreva seu roteiro com a mentalidade de quem escreve uma fala: “Como quero que isso seja dito em voz alta? Onde fazemos uma pausa para criar um efeito dramático? Onde aceleramos?” Essas perguntas se aplicam tanto a um roteiro para modelos avançados de fala neural quanto a um roteiro escrito para uma pessoa.
Escreva números, moedas e datas por extenso
Você não quer deixar ambiguidades nos seus roteiros. Modelos de fala neural entendem bem o contexto, mas funcionam melhor quando não precisam adivinhar. Abreviações e formas reduzidas são itens comuns que podem causar dificuldades.
Por exemplo, um roteiro pode dizer: “Você está procurando um valor próximo de 15m.” O autor quer que o mecanismo de TTS diga “quinze milhões” ou “quinze metros”? Escreva por extenso para que o modelo não precise adivinhar pelo contexto.
Use pontuação comum para controlar o ritmo
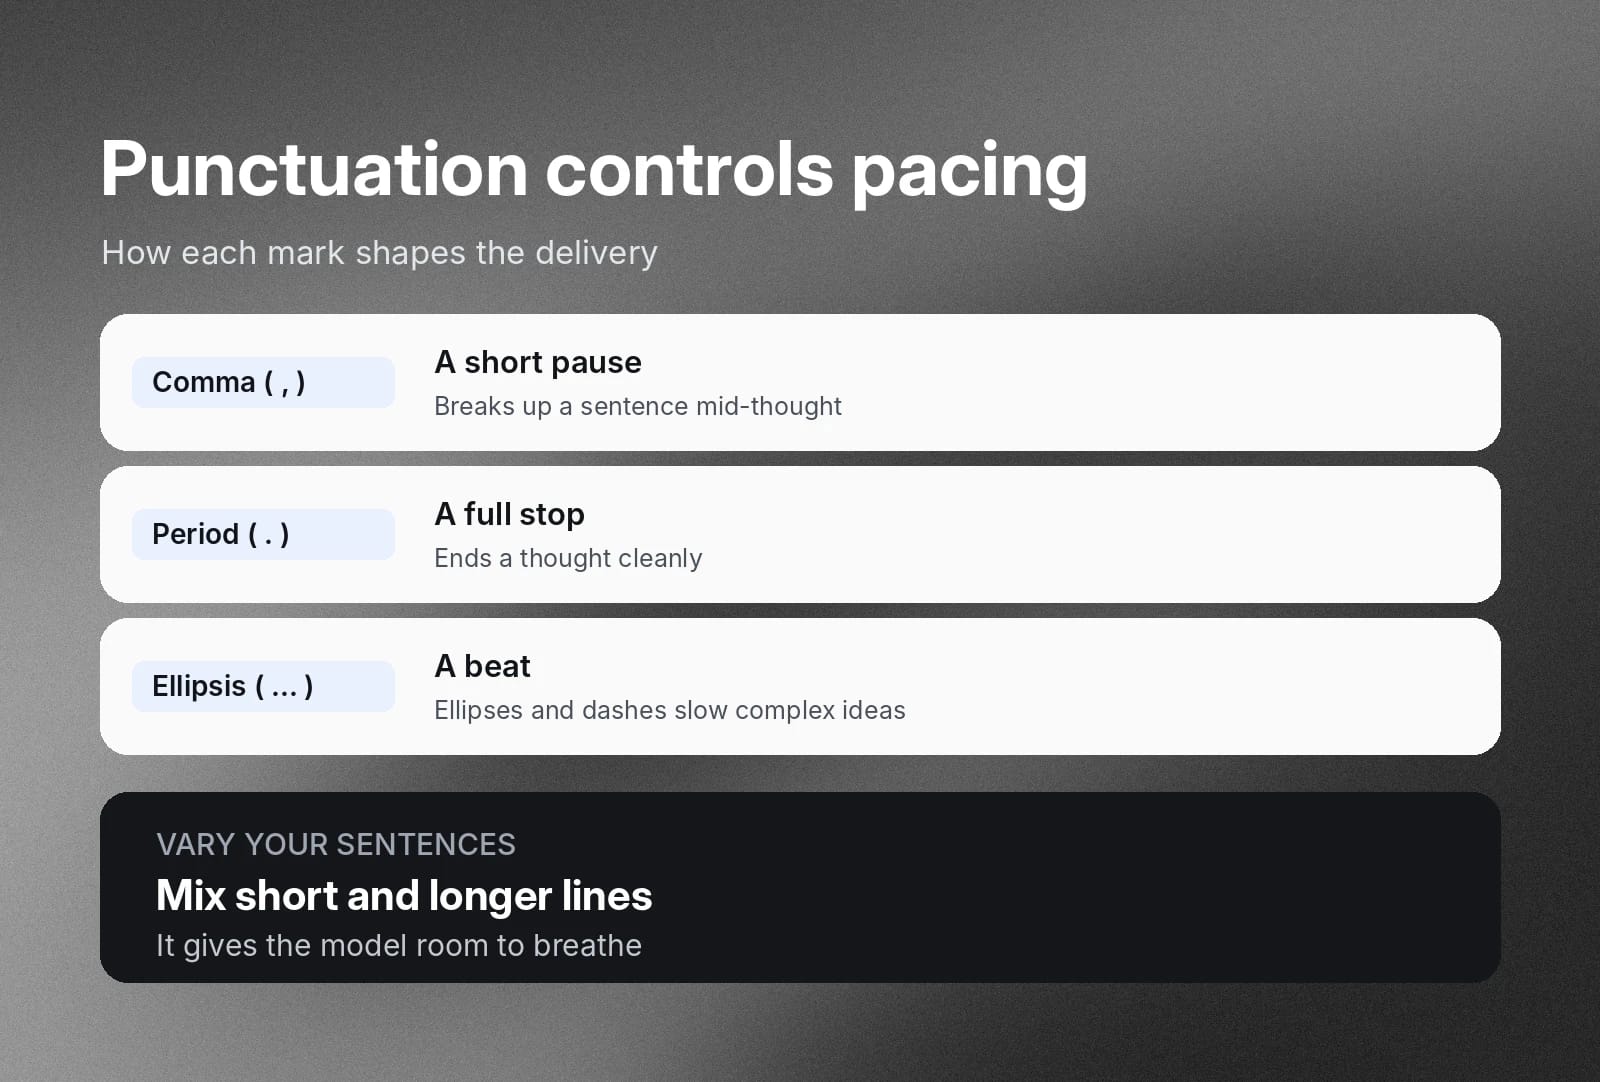
A pontuação tem um papel importante no texto escrito, mas é ainda mais relevante na síntese de Text to Speech. A pontuação controla o ritmo. Ela representa diferentes tipos de pausa que você pode usar para separar ideias complexas ou simplesmente manter uma cadência natural mais agradável de ouvir.
- Use vírgulas para pausas curtas no meio da frase.
- Use pontos finais para encerrar uma ideia.
- Use reticências e travessões para criar uma pausa no meio de ideias complexas, evitando que seu modelo soe apressado.
Frases curtas são frases melhores
Os modelos têm mais chances de tropeçar ou acelerar em frases longas, condicionais e com várias orações. Divida-as em declarações mais curtas e de comprimentos variados. Isso dá mais espaço para o modelo respirar e evita que ele se apresse ao tentar encontrar a cadência de frases longas e contínuas.
Remova artefatos de formatação e Markdown
Se você estiver sintetizando fala extraída de um sistema de gerenciamento de conteúdo ou outro sistema empresarial, ela poderá conter HTML, JSON, Markdown ou outra formatação. Remova esses elementos e formate o conteúdo como texto para obter uma fala mais natural. Os modelos de fala podem ter dificuldade para entender quando devem ignorar essas tags, lê-las literalmente ou incorporá-las ao contexto da saída.
Você pode explorar pronúncias incorretas e outros problemas em mais detalhes no guia de solução de problemas da ElevenLabs.
Corrija erros comuns da API da ElevenLabs
Equipes que produzem áudio de voz em escala normalmente conectam seus aplicativos a um modelo de síntese de fala por API. Isso torna a produção mais eficiente no geral, mas adiciona uma camada técnica que você precisa gerenciar além da fala gerada pelo modelo.
A referência de códigos de erro da API da ElevenLabs aborda os códigos de resposta em detalhes, mas aqui estão os quatro códigos de status HTTP mais comuns ao solucionar problemas de integrações de Text to Speech e como resolvê-los.
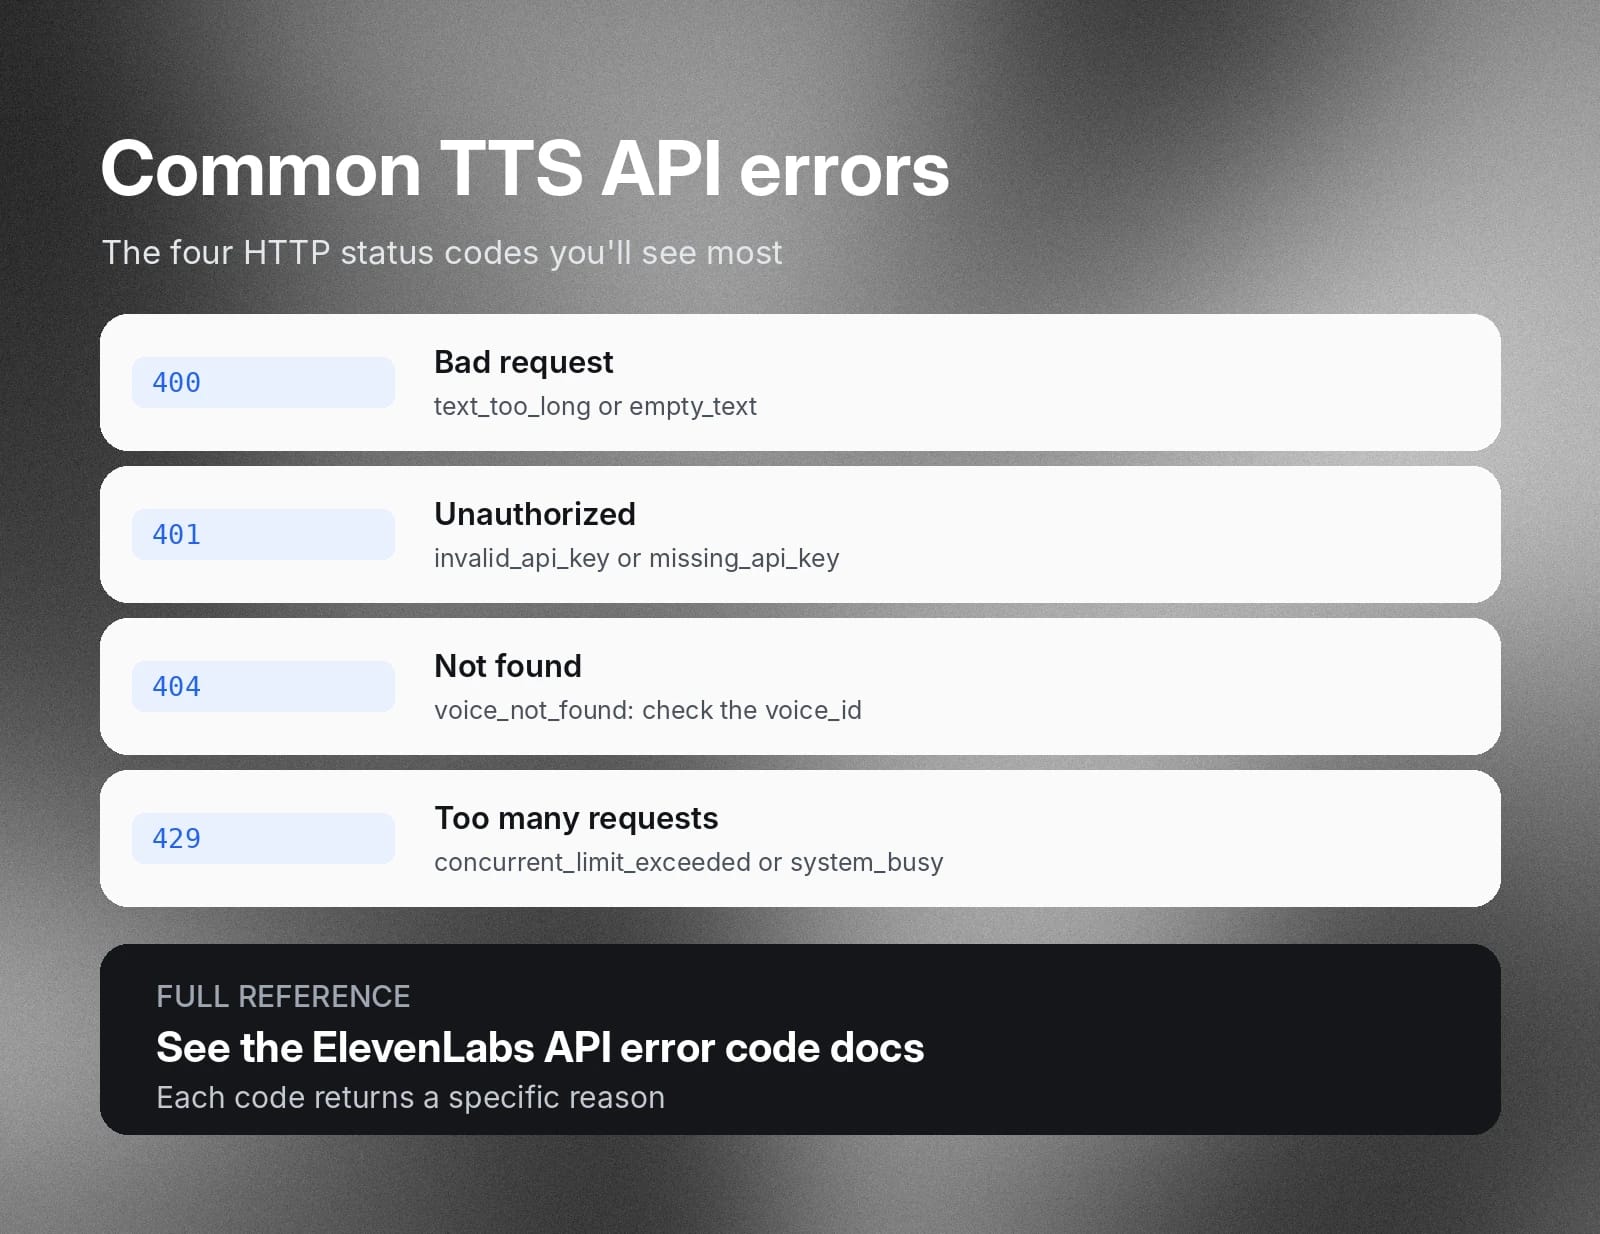
400 Bad Request (erros de payload)
Uma resposta com código de status 400 de uma API de modelo de fala significa que seu aplicativo enviou dados que o modelo não conseguiu processar. Em fluxos de trabalho de TTS, isso geralmente ocorre por exceder limites de caracteres ou enviar entradas em branco por engano.
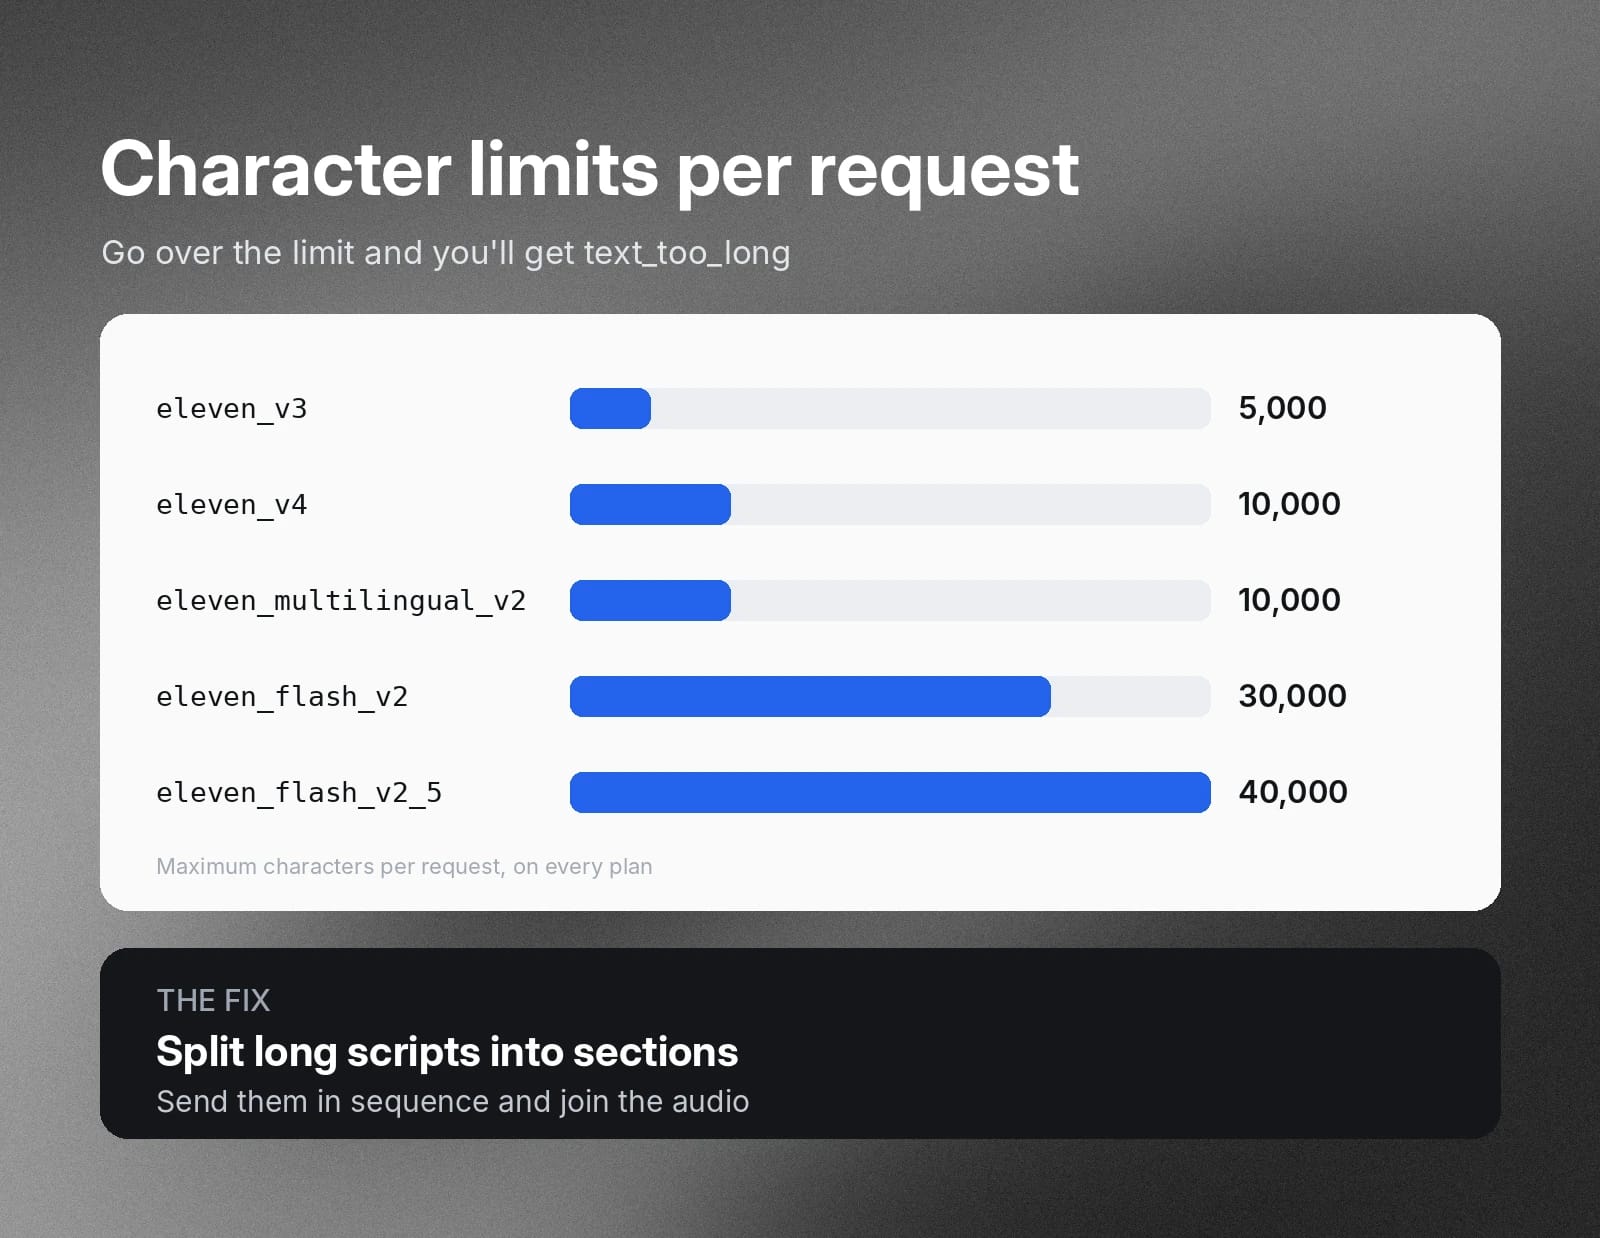
Limite de caracteres excedido (text_too_long)
Toda solicitação de TTS enviada tem um limite de caracteres definido pelo modelo. Se você tentar enviar mais texto do que o limite permitido pelo modelo, o servidor de TTS retornará esse erro. Os limites por solicitação são de 10.000 caracteres para eleven_v4 e eleven_multilingual_v2, 5.000 para eleven_v3, 30.000 para eleven_flash_v2 e 40.000 para eleven_flash_v2_5, em todos os planos. Para resolver esse problema, divida roteiros mais longos em várias seções que o modelo possa processar sequencialmente.
Texto de entrada vazio
Um mecanismo de TTS rejeitará qualquer payload que contenha strings vazias (empty_text). Inclua etapas de limpeza no seu pipeline de entrada para remover linhas vazias, evitando que o servidor rejeite um payload que, de outra forma, seria válido.
401 Unauthorized (problemas de autenticação)
Um código de erro 401 significa que o gateway da API rejeitou suas credenciais e seu payload não foi enviado ao modelo. Isso acontece quando há um problema com a chave de API.
Chave de API inválida
Sua solicitação ao servidor do modelo precisa incluir uma xi-api-key válida. Caso contrário, o servidor retornará um erro 401. Verifique se sua chave está presente na solicitação e se não foi revogada, expirou ou foi truncada dos cabeçalhos durante a implantação. A API retorna invalid_api_key quando a chave está incorreta e missing_api_key quando nenhuma chave é enviada.
404 Not Found (incompatibilidade de identificador de voz)
Você recebe um erro 404 quando o endpoint não encontra o recurso de TTS especificado na solicitação de URL. Isso pode acontecer se você enviar o parâmetro voice_id incorreto ou se ele estiver ausente da URL da solicitação. Certifique-se de que recebeu o voice_id correto para usar. Verifique se ele está presente nos parâmetros de caminho e se não há erros de digitação. A API retorna voice_not_found quando o ID de voz não existe.
429 Too Many Requests
Esse erro tem duas causas distintas: você atingiu o limite de solicitações simultâneas do seu nível de serviço ou a plataforma de TTS está limitando solicitações para gerenciar um pico de tráfego.
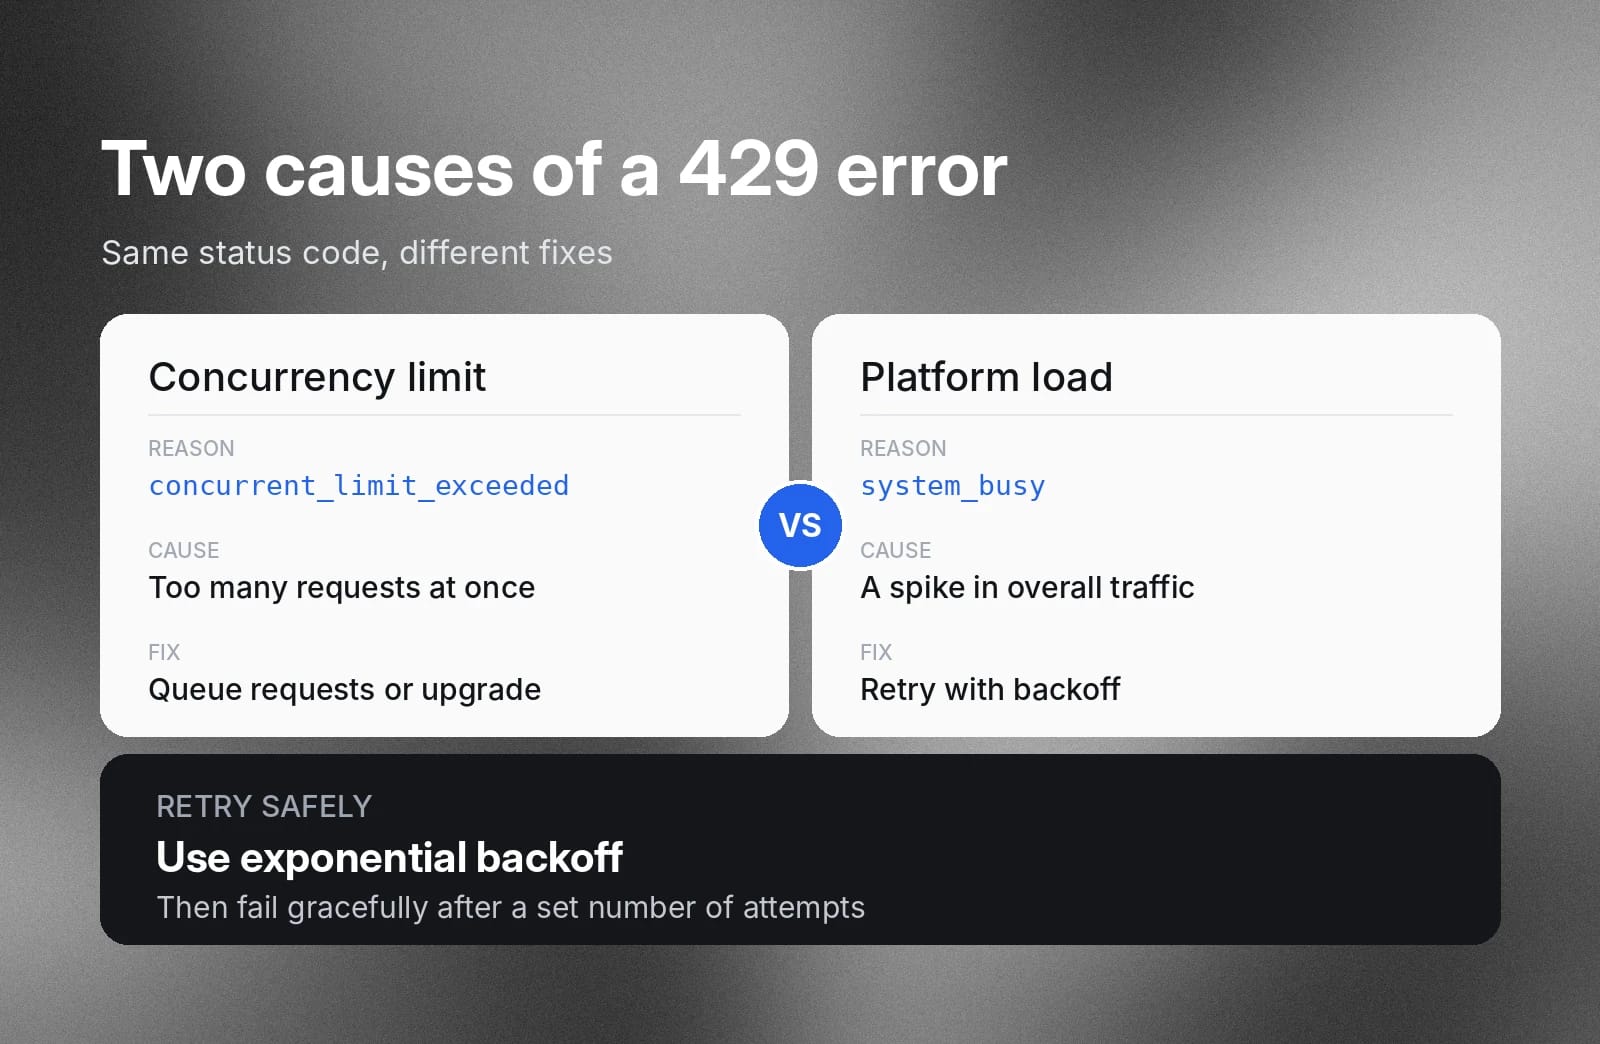
Limites de simultaneidade (concurrent_limit_exceeded)
Cada nível de assinatura de um mecanismo de TTS define um número fixo de solicitações simultâneas que você pode enviar. Se seus aplicativos ultrapassarem esse limite, o servidor retornará esse tipo de erro 429.
Crie uma camada de fila assíncrona usando um serviço como o Redis para controlar seus payloads enviados e evitar que excedam os limites do seu nível. Ou avalie se uma assinatura de nível superior tem um bom custo-benefício.
Picos de carga da plataforma (system_busy)
Sob alta carga, um servidor de TTS pode limitar solicitações recebidas para manter o desempenho. Implemente uma lógica de novas tentativas automática no cliente de API do seu aplicativo. Garanta que ele possa tentar novamente com espera exponencial e falhar de forma controlada após um número máximo de tentativas.
Teste vozes, idiomas e configurações antes de publicar
Um teste rápido no app web geralmente não oferece controle de qualidade suficiente para payloads de TTS em grande escala. O custo de execuções com problemas pode aumentar rapidamente. Teste seu roteiro em uma série de iterações controladas antes de enviá-lo. Essa preparação antecipada ajuda você a produzir áudio de voz da mais alta qualidade com mais eficiência.
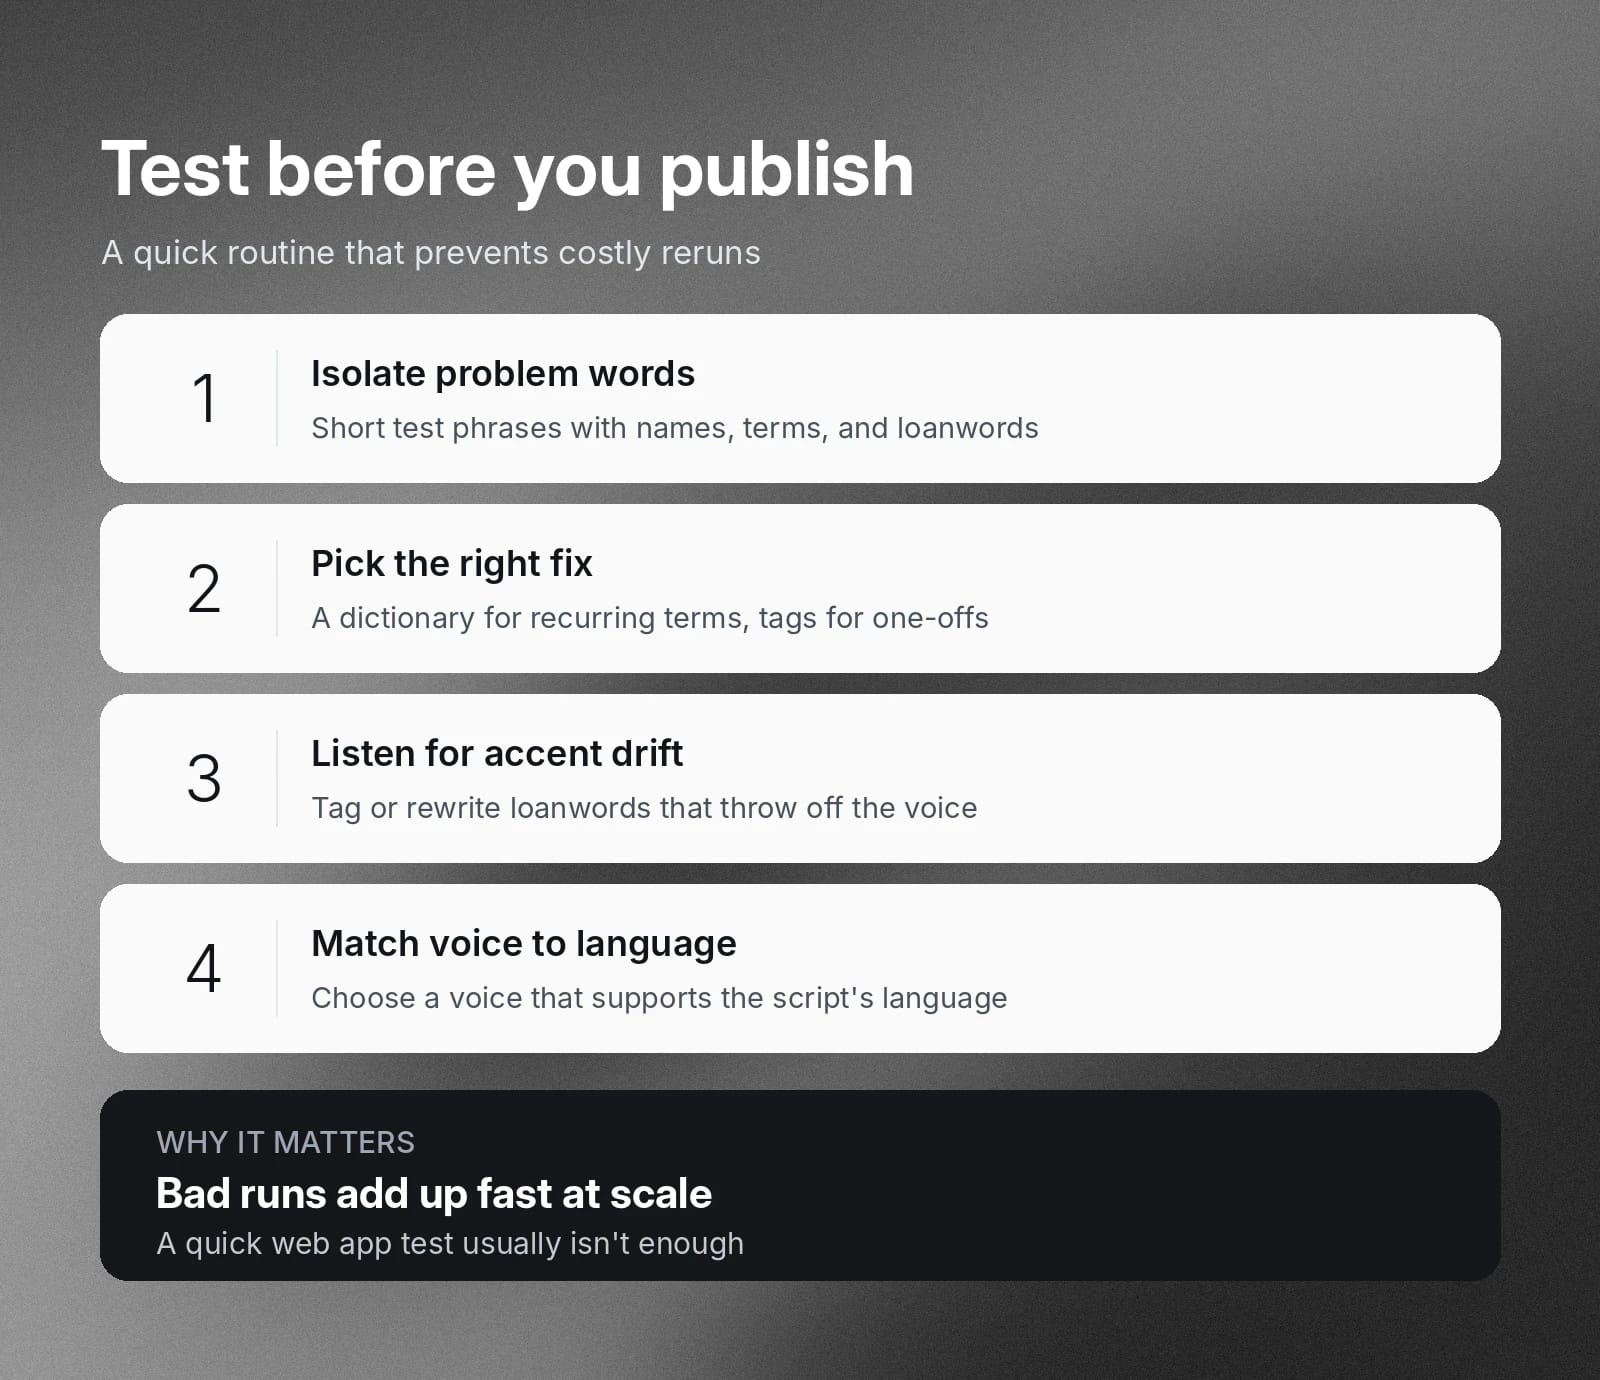
Teste palavras problemáticas isoladamente
Em geral, seus problemas estarão em trechos específicos ou apenas em certas palavras ou nomes, e não serão algo abrangente. Crie frases de teste de cinco a dez palavras que contenham os nomes das suas marcas, termos técnicos ou frases em idiomas estrangeiros. Com base nas saídas, decida se deseja usar um dicionário de pronúncia ou apenas tags fonéticas para cada caso.
Identifique possíveis desvios de idioma ou sotaque
Às vezes, os modelos de fala podem adotar uma cadência estranha ou lenta no meio da frase. Isso costuma acontecer quando o modelo precisa adivinhar como pronunciar um trecho diferente do que viu no treinamento.
- Estrangeirismos: textos que usam estrangeirismos pouco conhecidos podem confundir o mapeamento de grafemas de um modelo, fazendo com que toda a fala seguinte soe com um sotaque estranho. Use tags fonéticas no estrangeirismo ou reescreva o texto.
- Fala truncada em outros idiomas: um modelo otimizado para inglês pode gaguejar ou soar robótico ao ler um roteiro traduzido. Selecione um perfil de voz que também ofereça suporte ao idioma nativo.
Comece a usar a ElevenAPI para gerar fala com mais confiabilidade
Quando você sabe o que observar, gera conteúdo de voz de alta qualidade mais rápido e com menos dificuldades. Saiba como lidar com problemas de saída e questões técnicas de API que podem interromper a produção.
Saiba mais sobre como gerar conteúdo de TTS preciso e de alta qualidade com a ElevenAPI ou obtenha sua chave de API hoje mesmo para começar.
Perguntas frequentes sobre problemas de Text to Speech

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.