Scribe v3 Live Medical helpt conversationele agents klinische details correct te begrijpen
- Geschreven door
- John Durovsik
- Gepubliceerd
LuisterenLuister naar dit artikel
Een spraakagent handelt op basis van wat die tijdens een live gesprek hoort. Wanneer een patiënt zegt dat die sitagliptine gebruikt voor diabetes, kan de agent dit toevoegen aan de medicatielijst zodat de zorgverlener het kan beoordelen. Maar medicijnnamen zijn gemakkelijk verkeerd te verstaan. In onze tests zagen we dat een spraakmodel sitagliptine transcribeerde als citalopram, een antidepressivum. Voor veel mensen zijn deze gesprekken de eerste stap om hun zorgteam te bereiken, en een agent kan alleen helpen als die hen goed verstaat.
Vandaag brengt ElevenLabs Scribe v3 Live Medical uit, waarmee medische transcriptie beschikbaar komt voor live gesprekken. Het is gebouwd op Scribe v3 Live, ons nieuwste realtime Speech to Text-model, en geoptimaliseerd voor klinische taal. Het is nu beschikbaar in ElevenAgents.
Waarom live gesprekken medische transcriptie nodig hebben
ElevenLabs biedt al medische transcriptie voor opgenomen audio, zoals dicteeropnamen en opnamen van consulten. Maar veel van wat zorgteams bouwen, werkt realtime: van afspraken plannen en medische informatielijnen tot controles op zorgdekking via de telefoon en opvolging van claims. Die gesprekken kunnen niet wachten tot een opname is afgelopen.
Medicijnnamen en doseringen komen zelden voor in alledaagse spraak, waardoor een algemeen realtime model deze woorden eerder verkeerd herkent. Scribe v3 Live Medical is onze eerste medische transcriptie die is gebouwd voor agents en brengt de klinische focus van Scribe v2 Medical naar realtime gesprekken. In onze tests met PriMock57, een openbare set gesimuleerde live doktersbezoeken, maakte Scribe v3 Live Medical minder fouten dan elk ander medisch model dat we hebben geëvalueerd.
Gesprekken waarin klinische details belangrijk zijn
Scribe v3 Live Medical is ontworpen voor gesprekken met patiënten, leden en zorgverleners waarin de details klinisch zijn, zoals een medicijn tijdens de intake, een procedure bij een voorafgaande machtiging of een symptoom tijdens een vervolgafspraak. Veel zorgagents behandelen ook gesprekken zonder klinische details, zoals het verzetten van een afspraak of vragen naar openingstijden. Scribe v3 Live Medical verbetert de nauwkeurigheid voor klinische details en behoudt de nauwkeurigheid voor alledaagse spraak, zodat teams het voor elk gesprek kunnen gebruiken.
Tools voor klinische gesprekken
Laad maximaal 10.000 aangepaste termen
Zorgteams kunnen maximaal 10.000 eigen termen toevoegen, en Scribe v3 Live Medical gebruikt de lijst alleen wanneer een beller er een lijkt uit te spreken. Dat is genoeg voor een regionaal zorgsysteem om de naam van elke zorgverlener en kliniek op al zijn locaties te laden, of voor een farmaceutisch bedrijf om zijn volledige portfolio met merk- en generieke namen te laden. Met een geladen lijst van aangepaste termen maakte Scribe v3 Live Medical in onze tests tot 48% minder fouten bij medische termen.
Wacht tot bellers zijn uitgesproken
Bellers lezen een lidnummer of geboortedatum vaak in delen voor, waarbij ze tussen groepen cijfers pauzeren terwijl ze die op een pasje opzoeken. Een agent die elke pauze als het einde van een beurt beschouwt, valt midden in een nummer in en de beller moet opnieuw beginnen. Scribe v3 Live Medical herkent wanneer een nummer nog niet compleet is, zodat de agent op de rest wacht voordat die antwoordt.
Volg patiënten in verschillende talen
Patiënten en mantelzorgers kunnen tijdens een gesprek van taal wisselen, bijvoorbeeld om een symptoom gemakkelijker in hun moedertaal te beschrijven. Scribe v3 Live Medical ondersteunt meer dan 90 talen en volgt die wisselingen, zodat spraak in een tweede taal wordt getranscribeerd in plaats van weggelaten.
Wat zorgteams ervaren
Teams bouwen al agents met Scribe v3 Live Medical.
“De interactie-ervaring met Eleven v4 Turbo en Scribe v3 Live Medical is fenomenaal”, zegt Idin Jafari, Director, Digital Strategy & Innovation bij Pfizer. “De agent klinkt realistisch en herkent de merk- en generieke namen die in onze gesprekken voorkomen nauwkeuriger.”
Bij gesprekken met patiënten werkt die nauwkeurigheid door in wat zorgteams na het gesprek beoordelen.
“ElevenLabs blijft de lat hoger leggen, waardoor Vintage Labs sneller kan werken. Ons VIA-platform voert gesprekken voor en na procedures voor grote academische zorgsystemen. Met Scribe v3 Live Medical begrijpt het patiënten beter: hun medicatie, procedures en de namen van hun artsen”, zegt Shantanu Ghorai, Founder & COO van Vintage Labs AI. “Beurtdetectie wacht tot patiënten hun geboortedatum hebben afgemaakt voordat er wordt geantwoord, en de meertalige modus blijft bij wanneer bellers overschakelen naar het Spaans. Verpleegkundigen kunnen de gesprekssamenvatting nu vertrouwen zonder de opname opnieuw af te spelen.”
Hoe we Scribe v3 Live Medical hebben geëvalueerd
We hebben Scribe v3 Live Medical getest tegenover realtime Speech to Text-modellen van toonaangevende aanbieders, waaronder gespecialiseerde medische modellen en modellen voor algemeen gebruik, allemaal op dezelfde opnamen. We gebruikten twee openbare benchmarks van gesprekken tussen arts en patiënt, vergeleken Scribe v3 Live Medical met Scribe v3 Live voor medische en alledaagse spraak, en testten medische termen in het Engels, Frans en Duits. De resultaten zijn in het Engels, tenzij anders vermeld.
We rapporteren de word error rate (WER), het aandeel woorden dat onjuist is getranscribeerd, en semantische WER, die alleen fouten telt die de betekenis veranderen. Semantische WER beschouwt “20 mg” en “twintig milligram” als een overeenkomst, waardoor de scores lager uitvallen dan bij WER.
Opmerking: deze resultaten komen uit interne tests van ElevenLabs met geselecteerde aanbieders in realtime modus, waarbij elk model in de best beschikbare configuratie is gebruikt. Ze omvatten niet elk beschikbaar model.
Consulten in de eerstelijnszorg (PriMock57)
PriMock57 omvat 57 gesimuleerde live consulten in de eerstelijnszorg van elk ongeveer 9 minuten, tussen zorgverleners en acteurs die patiënten spelen. De gesprekken waren aan beide kanten niet gescript. Acteurs werkten met casuskaarten over symptomen, medische voorgeschiedenis en huidige medicatie, en zorgverleners voerden elk consult zoals een echt consult uit. De gesprekken verliepen via telegeneeskundesoftware, waarbij zorgverleners laptops en patiënten mobiele telefoons gebruikten, in een kantooromgeving met achtergrondgeluid.
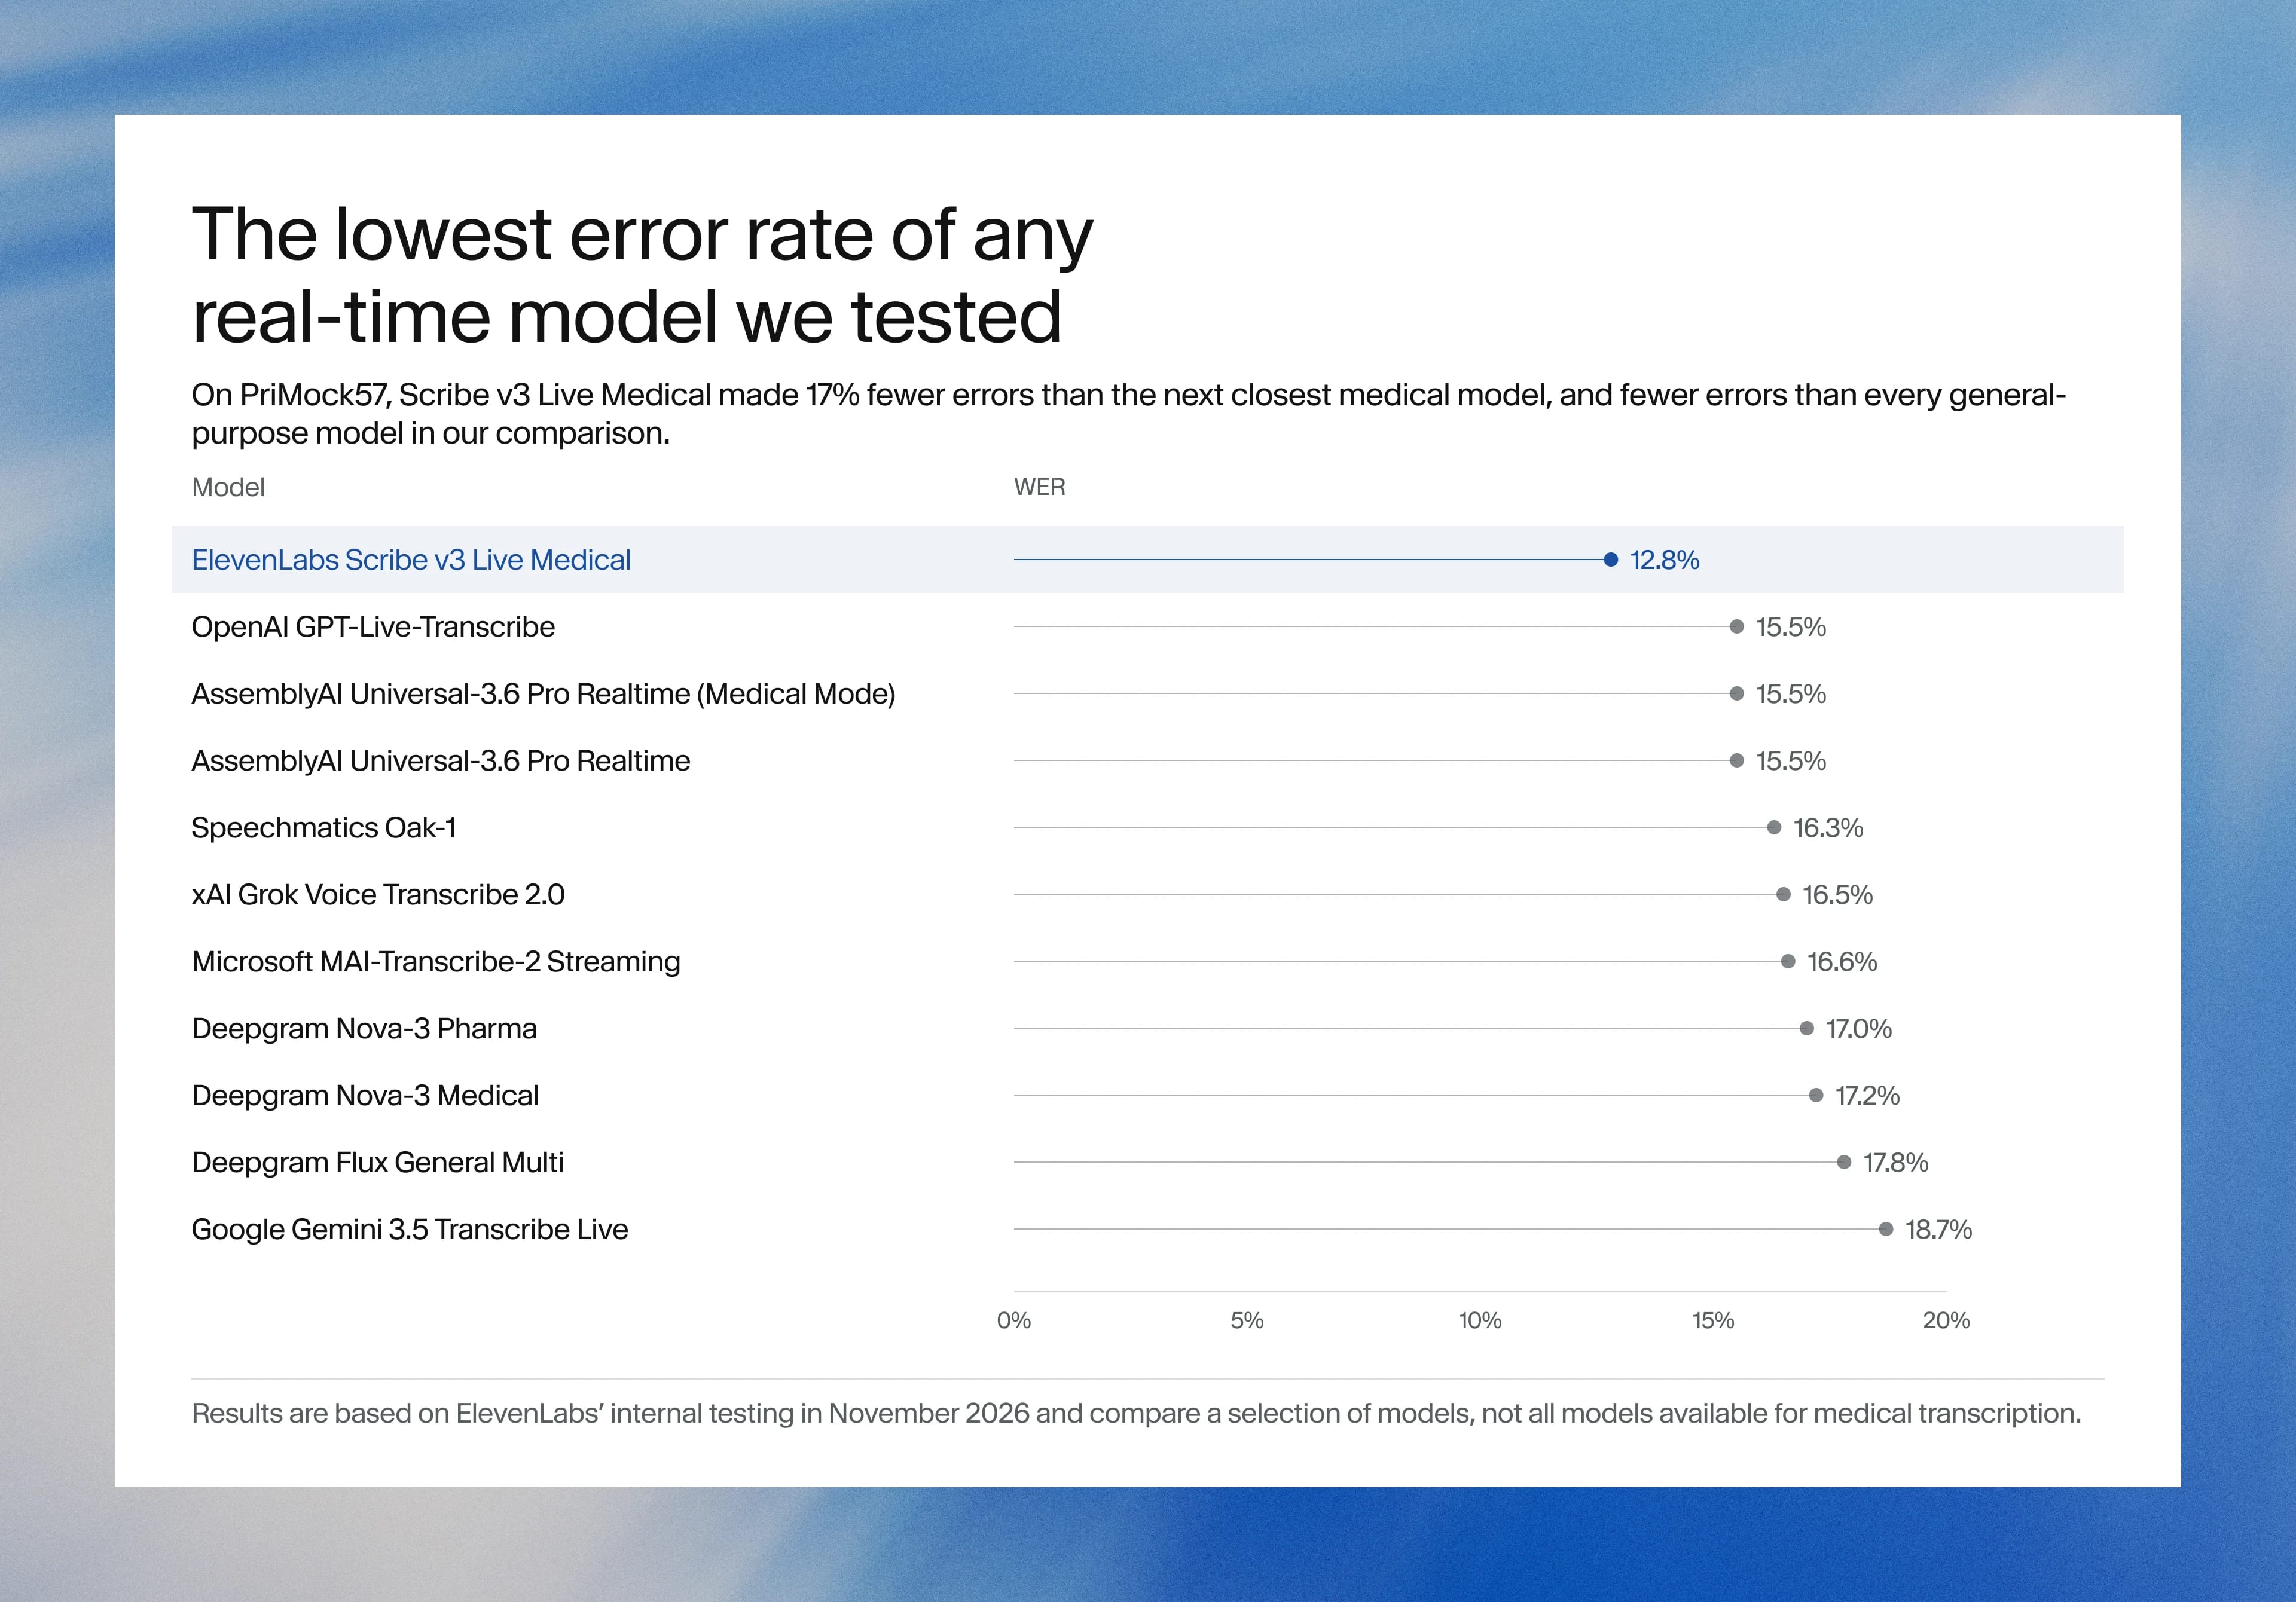
We gebruikten deze benchmark omdat die bevat wat patiëntgesprekken moeilijk te transcriberen maakt: ongescripte gesprekken heen en weer, telefoonaudio met achtergrondgeluid en veel klinische details. Scribe v3 Live Medical had de laagste WER van de medische modellen die we hebben getest (12,8%), met 17% minder fouten dan het model dat daarna het beste scoorde.
Patiëntinterviews (Fareez OSCE)
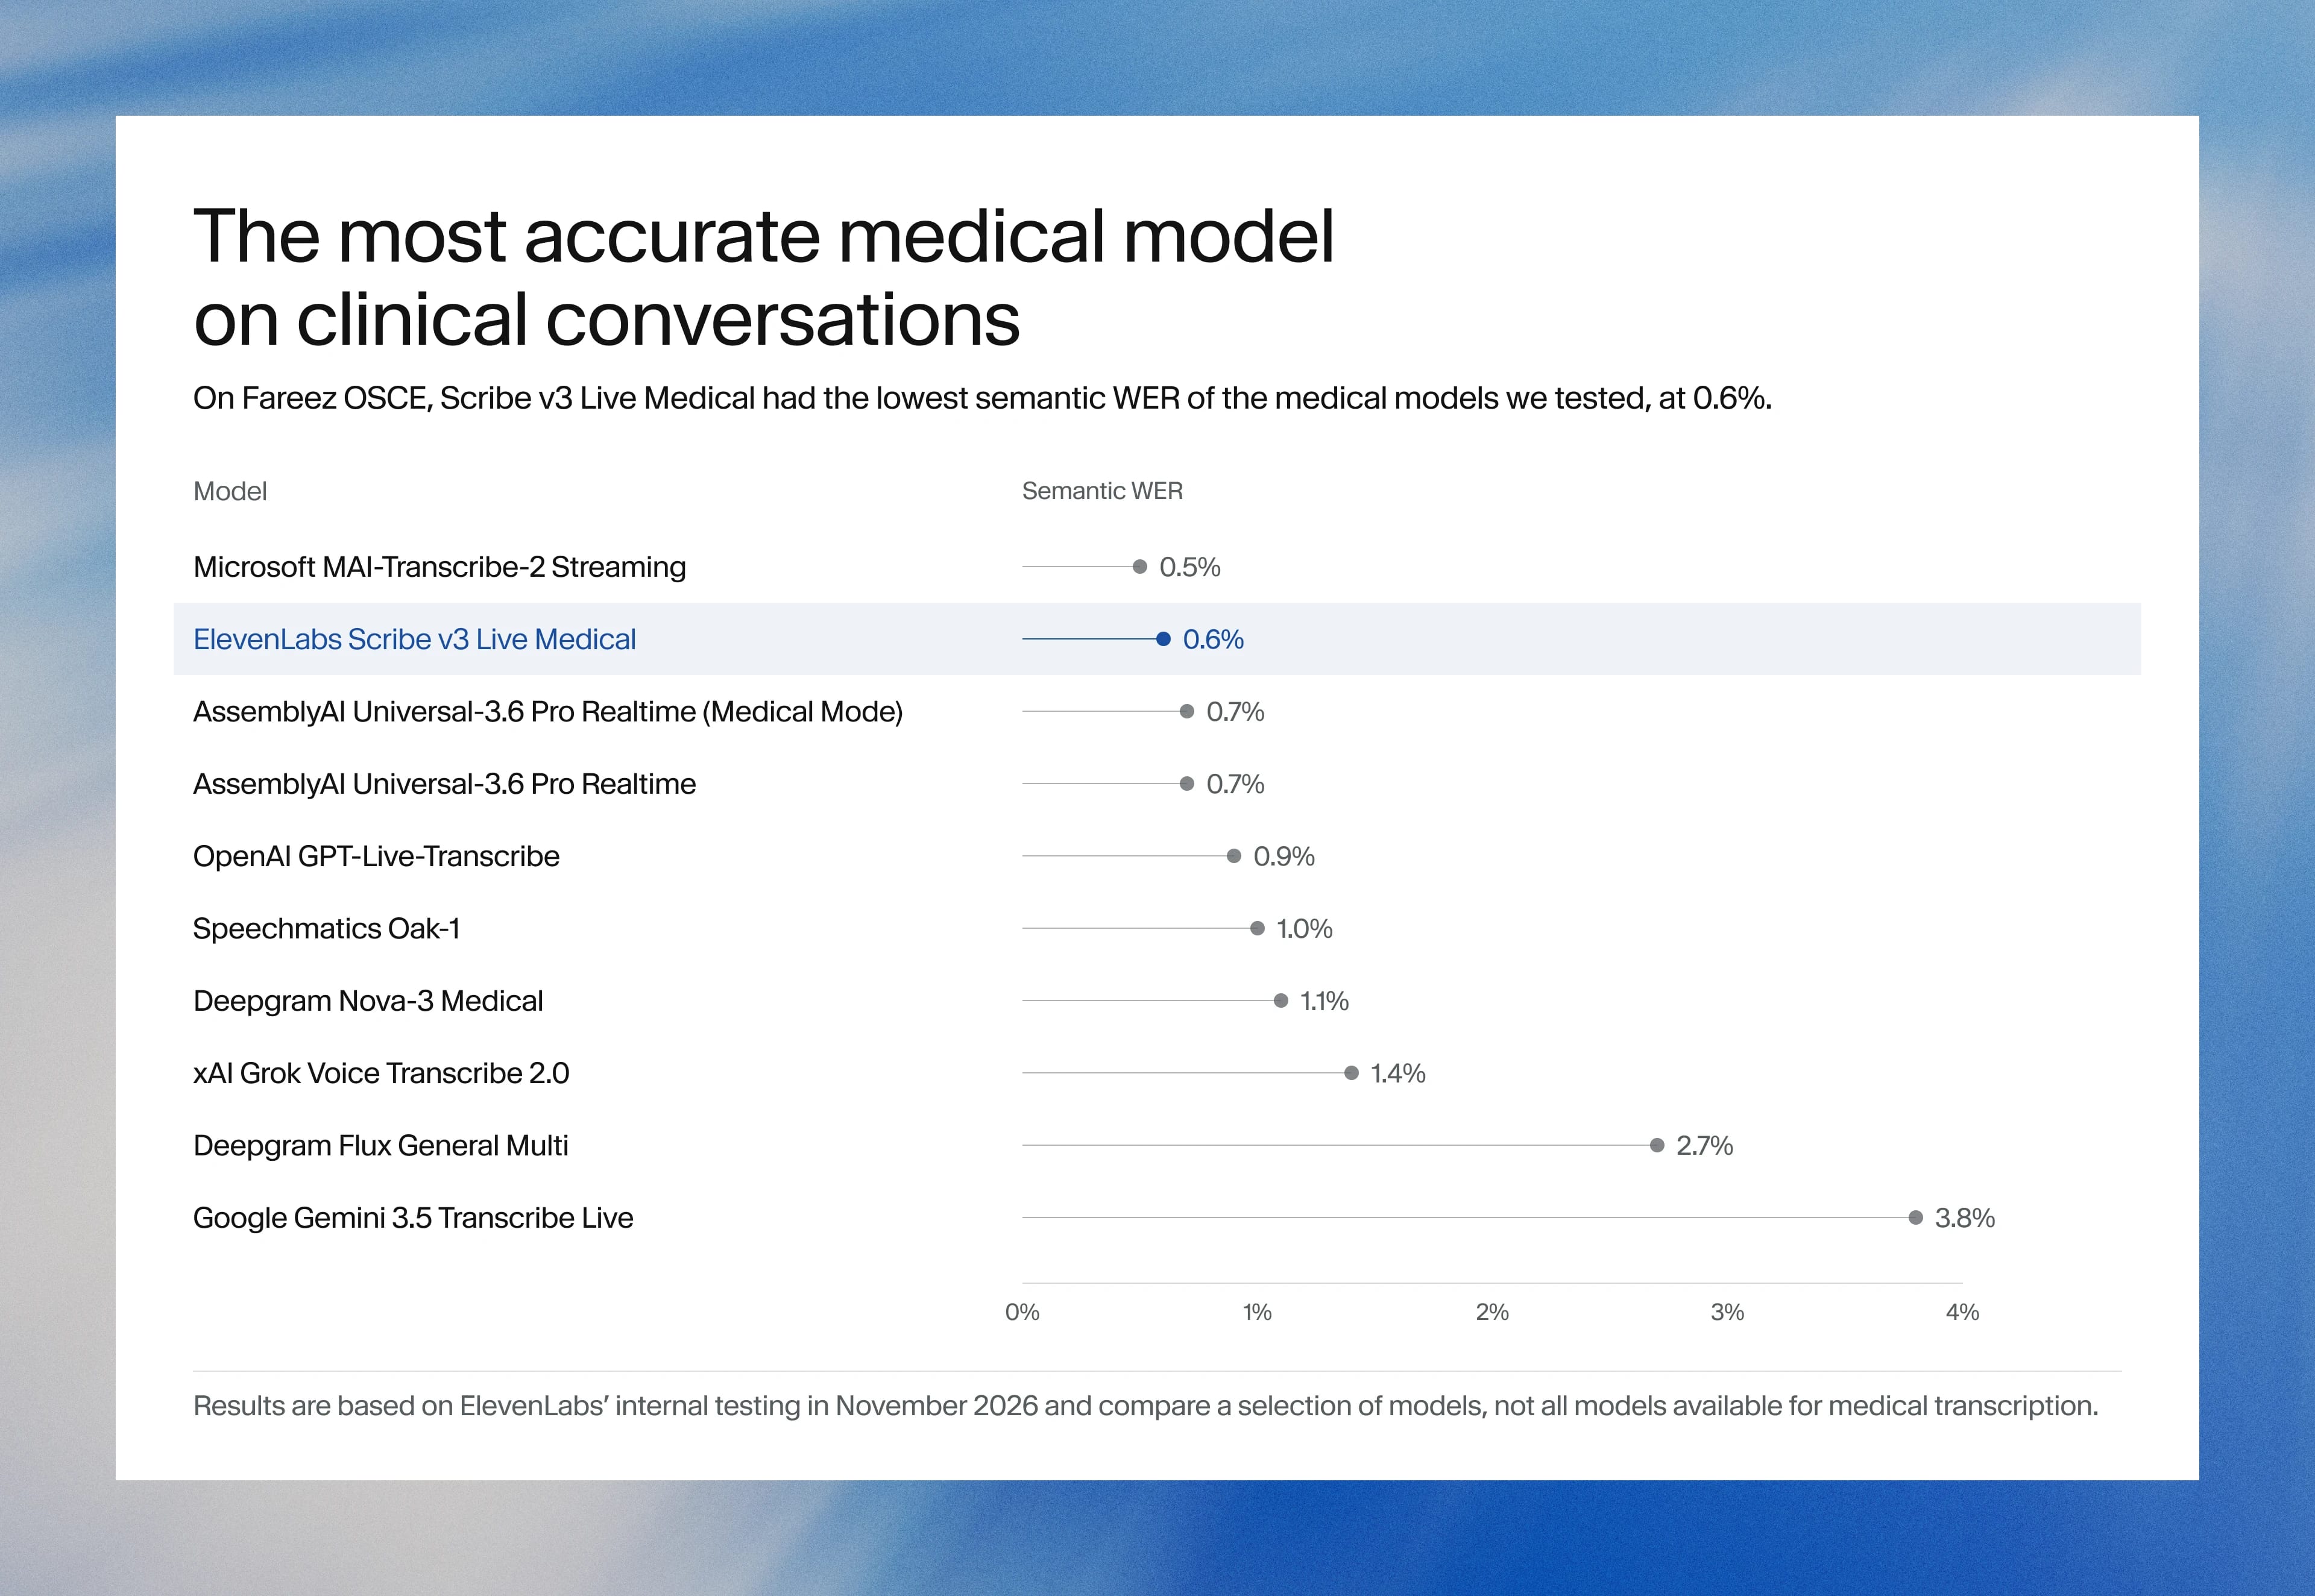
Fareez OSCE omvat 272 opgenomen patiëntinterviews in de vorm die medische opleidingen gebruiken om klinische vaardigheden te toetsen: het Objective Structured Clinical Examination (OSCE). In elk interview vraagt een arts in opleiding of een gevorderde geneeskundestudent iemand die de patiënt speelt naar symptomen en voorgeschiedenis. Omdat een ander team de opnamen in een ander land heeft gemaakt, laat de set zien of de resultaten standhouden bij nieuwe sprekers, opnameopstellingen en omstandigheden. Scribe v3 Live Medical had de laagste semantische WER van de medische modellen die we hebben getest (0,6%).
Vergeleken met Scribe v3 Live
Eka Medical ASR bevat meer dan 3.600 Engelse opnamen van artsen en geneeskundestudenten, gericht op medische termen en medicijnnamen van merken. Scribe v3 Live Medical maakte op Eka Medical ASR 4,7% minder fouten dan Scribe v3 Live (11% tegenover 11,54% semantische WER).
Model
Eka Medical ASR (semantische WER)
Scribe v3 Live Medical
11%
Scribe v3 Live
11.54%
Alledaagse spraak (Common Voice en FLEURS)
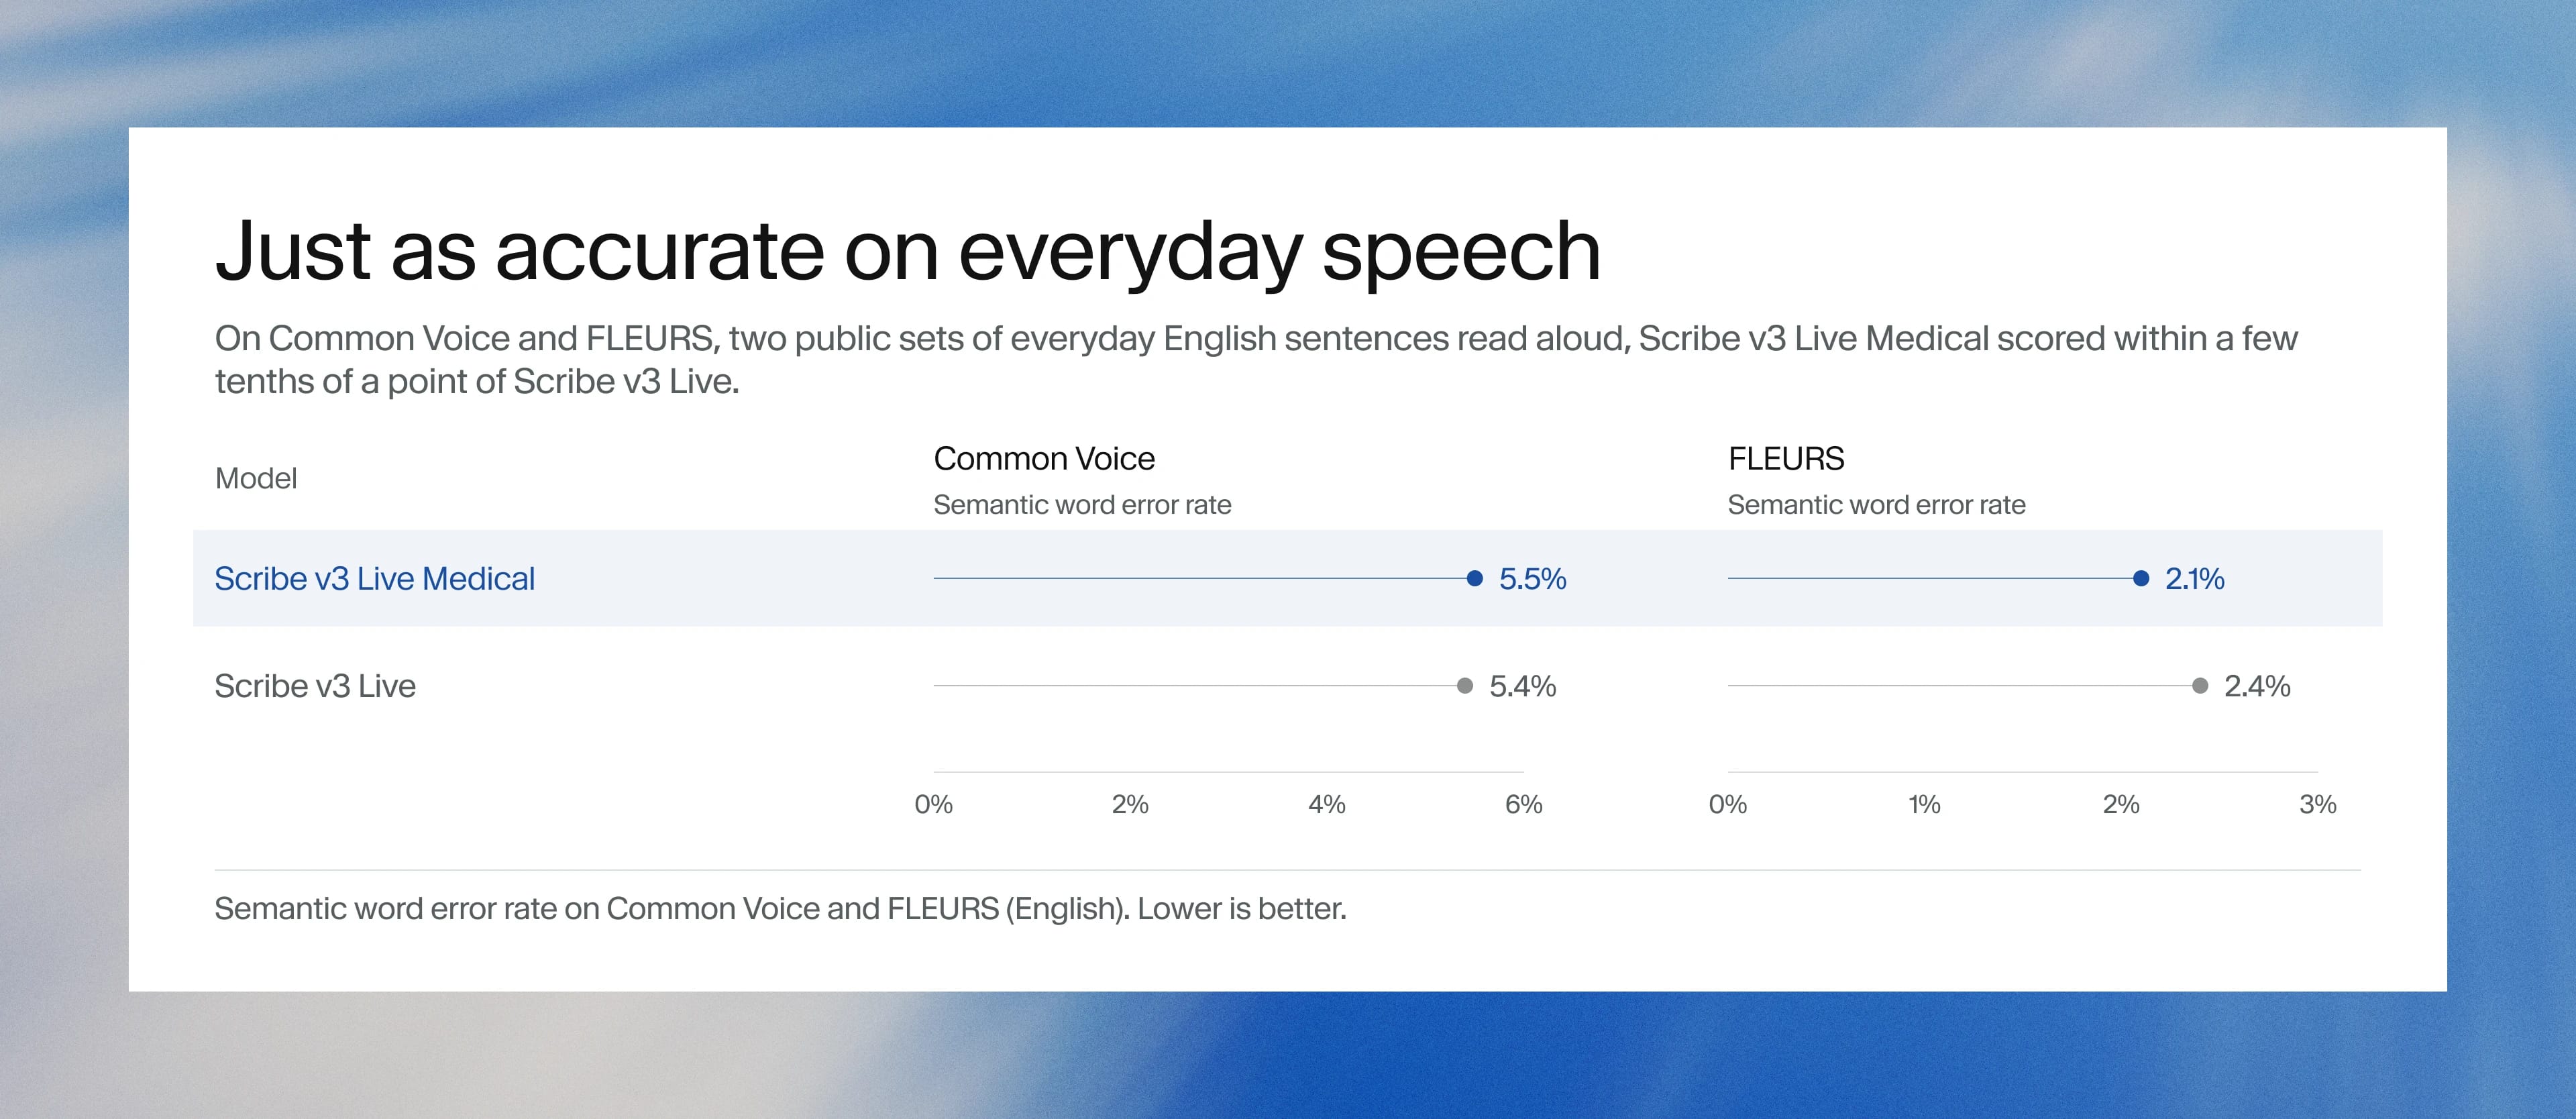
Common Voice is Mozilla’s verzameling zinnen die vrijwilligers hardop hebben voorgelezen, en FLEURS is Google’s verzameling korte, niet-klinische zinnen die in meer dan 100 talen zijn voorgelezen. We beoordeelden beide aan de hand van hun Engelse sets om er zeker van te zijn dat teams die Scribe v3 Live Medical gebruiken niet inleveren op nauwkeurigheid voor alledaagse spraak. Zelfs een zin met een medicijnnaam bestaat grotendeels uit alledaagse woorden, dus een medisch model moet beide goed herkennen.
Scribe v3 Live Medical presteert op beide ongeveer even goed als Scribe v3 Live.
Medische nauwkeurigheid in verschillende talen (MED-Term)
Veel zorgteams helpen patiënten in meer dan één taal. MED-Term, een openbare benchmark van Corti, is een verzameling gesproken beschrijvingen van klinische casussen in het Engels, Frans en Duits, elk opgebouwd rond zeldzame en gespecialiseerde medische termen. We gebruikten deze om te controleren hoe Scribe v3 Live Medical klinische woordenschat buiten het Engels verwerkt. De semantische WER was 2,24% in het Engels, 2,81% in het Duits en 3,24% in het Frans.
Taal
Semantische WER (MED-Term)
Engels
2.24%
Duits
2.81%
Frans
3.24%
Lage latentie bij live gesprekken
Tijdens een live gesprek kan een agent pas reageren zodra die het transcript heeft, dus elke vertraging in de transcriptie wordt een pauze die bellers horen. Scribe v3 Live transcribeert spraak in ongeveer 150 milliseconden en in tests evenaart Scribe v3 Live Medical die latentie, waardoor de klinische focus geen merkbare vertraging toevoegt.
Wat minder fouten betekenen voor zorgteams
Foutpercentages zijn gemakkelijker te beoordelen tijdens een echt gesprek. In een intakegesprek van 10 minuten worden er tussen de beller en de agent ongeveer 1.500 woorden gesproken. Bij de bovenstaande foutpercentages van PriMock57 zou Scribe v3 Live Medical ongeveer 40 woorden meer goed herkennen dan het op één na beste medische model dat we hebben getest. Voor een team dat 1.000 gesprekken per dag afhandelt, zijn dat elke dag ongeveer 40.000 extra woorden die correct worden getranscribeerd. Niet elk woord weegt even zwaar. Een weggelaten “eh” is onschuldig. Een verkeerd verstaan medicijn zet het verkeerde geneesmiddel op een herhaalreceptaanvraag, en een verkeerd cijfer in een lidnummer houdt een controle op zorgdekking op. Beide kunnen leiden tot een terugbelverzoek, een overdracht aan medewerkers of een patiënt die wordt gevraagd zichzelf te herhalen.
Gezondheidsinformatie beschermen
Zorgagents horen tijdens veel gesprekken beschermde gezondheidsinformatie (PHI), waaronder namen, geboortedata, lidnummers, medicatie en symptomen. Scribe v3 Live Medical komt in aanmerking voor HIPAA voor enterprise-klanten met een business associate agreement (BAA) en ingeschakelde Zero Retention Mode.
Scribe v3 Live Medical draait op ElevenAgents, dat valt onder onze complianceprogramma's, waaronder SOC 2 Type II, ISO 27001 en PCI DSS Level 1. Patiëntgegevens worden standaard in de VS opgeslagen. Enterprise-teams die gegevens buiten de VS moeten opslaan, kunnen geïsoleerde omgevingen gebruiken in de EU, India of Singapore.
Aan de slag
Scribe v3 Live Medical is vandaag beschikbaar in ElevenAgents.
Ga naar Instellingen > Automatic Speech Recognition en selecteer het in de modeldropdown.
John werkt in het groeiteam van ElevenAgents, met een focus op de gezondheidszorg.