Maak kennis met Scribe v3 en v3 Live, onze nauwkeurigste Speech to Text-modellen
- Geschreven door
- Min Kim
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Producten die op audio zijn gebouwd, beginnen met een transcript: vergadernotities, spraakagenten, nasynchronisatie, klinische documentatie en omroeparchieven met inhoud van tientallen jaren. Het is belangrijk dat dat transcript meteen klopt, want elke fout werkt door en is later veel duurder om te corrigeren.
Maar audio uit de praktijk is rommelig. Denk aan meerdere mensen die tijdens een vergadering door elkaar praten, een klant in een drukke straat die halverwege een zin pauzeert, of een supportgesprek waarin geen van beide personen hun moedertaal spreekt.
Vandaag introduceert ElevenLabs twee nieuwe Speech to Text-modellen die precies voor deze omstandigheden zijn ontwikkeld:
- Scribe v3 maakt voor opgenomen audio in 102 talen 27% minder woordfouten dan Scribe v2 en heeft de nauwkeurigste sprekerlabels van alle modellen die we hebben getest,
- Scribe v3 Live is de variant met lage latentie voor realtime-audio en maakt 43% minder fouten dan Scribe v2 Realtime. Het bevat ook voor het eerst sprekerdiarisatie (waarbij wordt aangegeven wie wat zei) en verbeterde beurtwisselingdetectie.
Scribe v3 Live is vandaag beschikbaar in ElevenAgents. Beide modellen zijn ook beschikbaar in ElevenAPI, waar je met een wijziging van één regel in de model-ID van Scribe v2 overstapt.
De feedback die Scribe v3 heeft gevormd
Scribe heeft honderden miljoenen uren transcriptie mogelijk gemaakt voor apps voor vergadernotities, contactcenters, tools voor klinische documentatie en spraakagenten. Voor alle toepassingen vroegen de teams die erop bouwen steeds om dezelfde vijf dingen.
Teams voor vergaderingen en notities wilden betere diarisatie bij snelle gesprekken heen en weer en bij drie of meer sprekers. Teams voor spraakagenten vertelden ons dat een stiltemeter bellers onderbreekt wanneer ze midden in een zin pauzeren of langzamer praten om een nummer voor te lezen. Teams die liveproducten bouwen, leverden nauwkeurigheid in voor snelheid, omdat realtime merkbaar slechter presteerde dan batchverwerking. Klanten in India wilden dat Hindi even goed werkte als Engels, zelfs wanneer bellers halverwege een zin tussen beide talen wisselen. En veel teams wilden meer controle over de output, van getallen geschreven als “123” tot lijsten met kerntermen die lang genoeg zijn voor een productcatalogus of een lijst met medicijnnamen.
Sprekerlabels, beurtendetectie en meer controle over de output
Diarisatie die standhoudt in een volle ruimte
In een vergadertranscript is het identificeren van de juiste spreker net zo belangrijk als het herkennen van de juiste woorden. Scribe v3 maakt 17% minder diarisatiefouten dan Scribe v2 bij opnamen met drie of meer sprekers: juist de opnamen waarop de meeste bestaande modellen tekortschieten. Scribe v3 Live brengt diarisatie ook voor het eerst naar realtime-transcriptie, met 39% minder diarisatiefouten dan het op een na beste realtime-model dat we hebben getest.
Beurtendetectie die naar het gesprek luistert
Om gesprekken natuurlijk te laten voelen, moeten spraakagenten nauwkeurig voorspellen wanneer een spreker is uitgesproken. Traditionele systemen voor beurtwisseling doen dat op basis van stiltes. Maar stilte alleen dwingt tot een afweging: een korte drempelwaarde kan mensen onderbreken die midden in een zin pauzeren, terwijl een lange drempelwaarde een agent traag laat aanvoelen. Scribe v3 Live gebruikt zowel de gesprekscontext als de audio, zodat een beller die halverwege een nummer pauzeert niet wordt onderbroken. Dit is dezelfde beurtendetectie die ElevenAgents al gebruikt en die nu beschikbaar is in ElevenAPI.
Meer controle over talen, terminologie en opmaak
Scribe v3 kan aanwijzingen afleiden over welke talen een opname mogelijk bevat en laat je kiezen of getallen als cijfers of woorden worden weergegeven. Keyterm prompting accepteert maximaal 1.000 termen waarvan je weet dat ze aan bod zullen komen, zoals merknamen, afkortingen en jargon. Transcriptbewerkingen passen opmaakregels toe die in gewoon Engels zijn geschreven, zoals “write every date as YYYY-MM-DD.”
Scribe v3 Live voegt een meertalige modus toe voor gesprekken waarin halverwege een zin van taal wordt gewisseld. Het voegt ook een keyterm library toe voor woordenlijsten die te groot zijn voor één lijst. Waar keyterm prompting termen bevat waarvan je weet dat ze aan bod komen, bevat keyterm library duizenden termen die mogelijk aan bod komen. Het model raadpleegt deze alleen wanneer het een waarschijnlijke overeenkomst hoort.
Hoe Scribe v3 presteert
ElevenLabs heeft beide modellen vergeleken met Scribe v2, Scribe v2 Realtime en andere populaire Speech to Text-modellen, waarbij elk model op dezelfde datasets is beoordeeld. Meertalige nauwkeurigheid is gemeten met een interne versie van de FLEURS-benchmark, die korte, heldere voorgelezen spraak in 102 talen test. FLEURS kan diarisatie niet meten, omdat elke clip één spreker heeft. Daarom hebben we ook onze eigen dataset samengesteld met echte vergaderingen, agentgesprekken en spraaknotities in 16 talen. We zullen deze binnenkort open source maken.
Sprekerdiarisatie
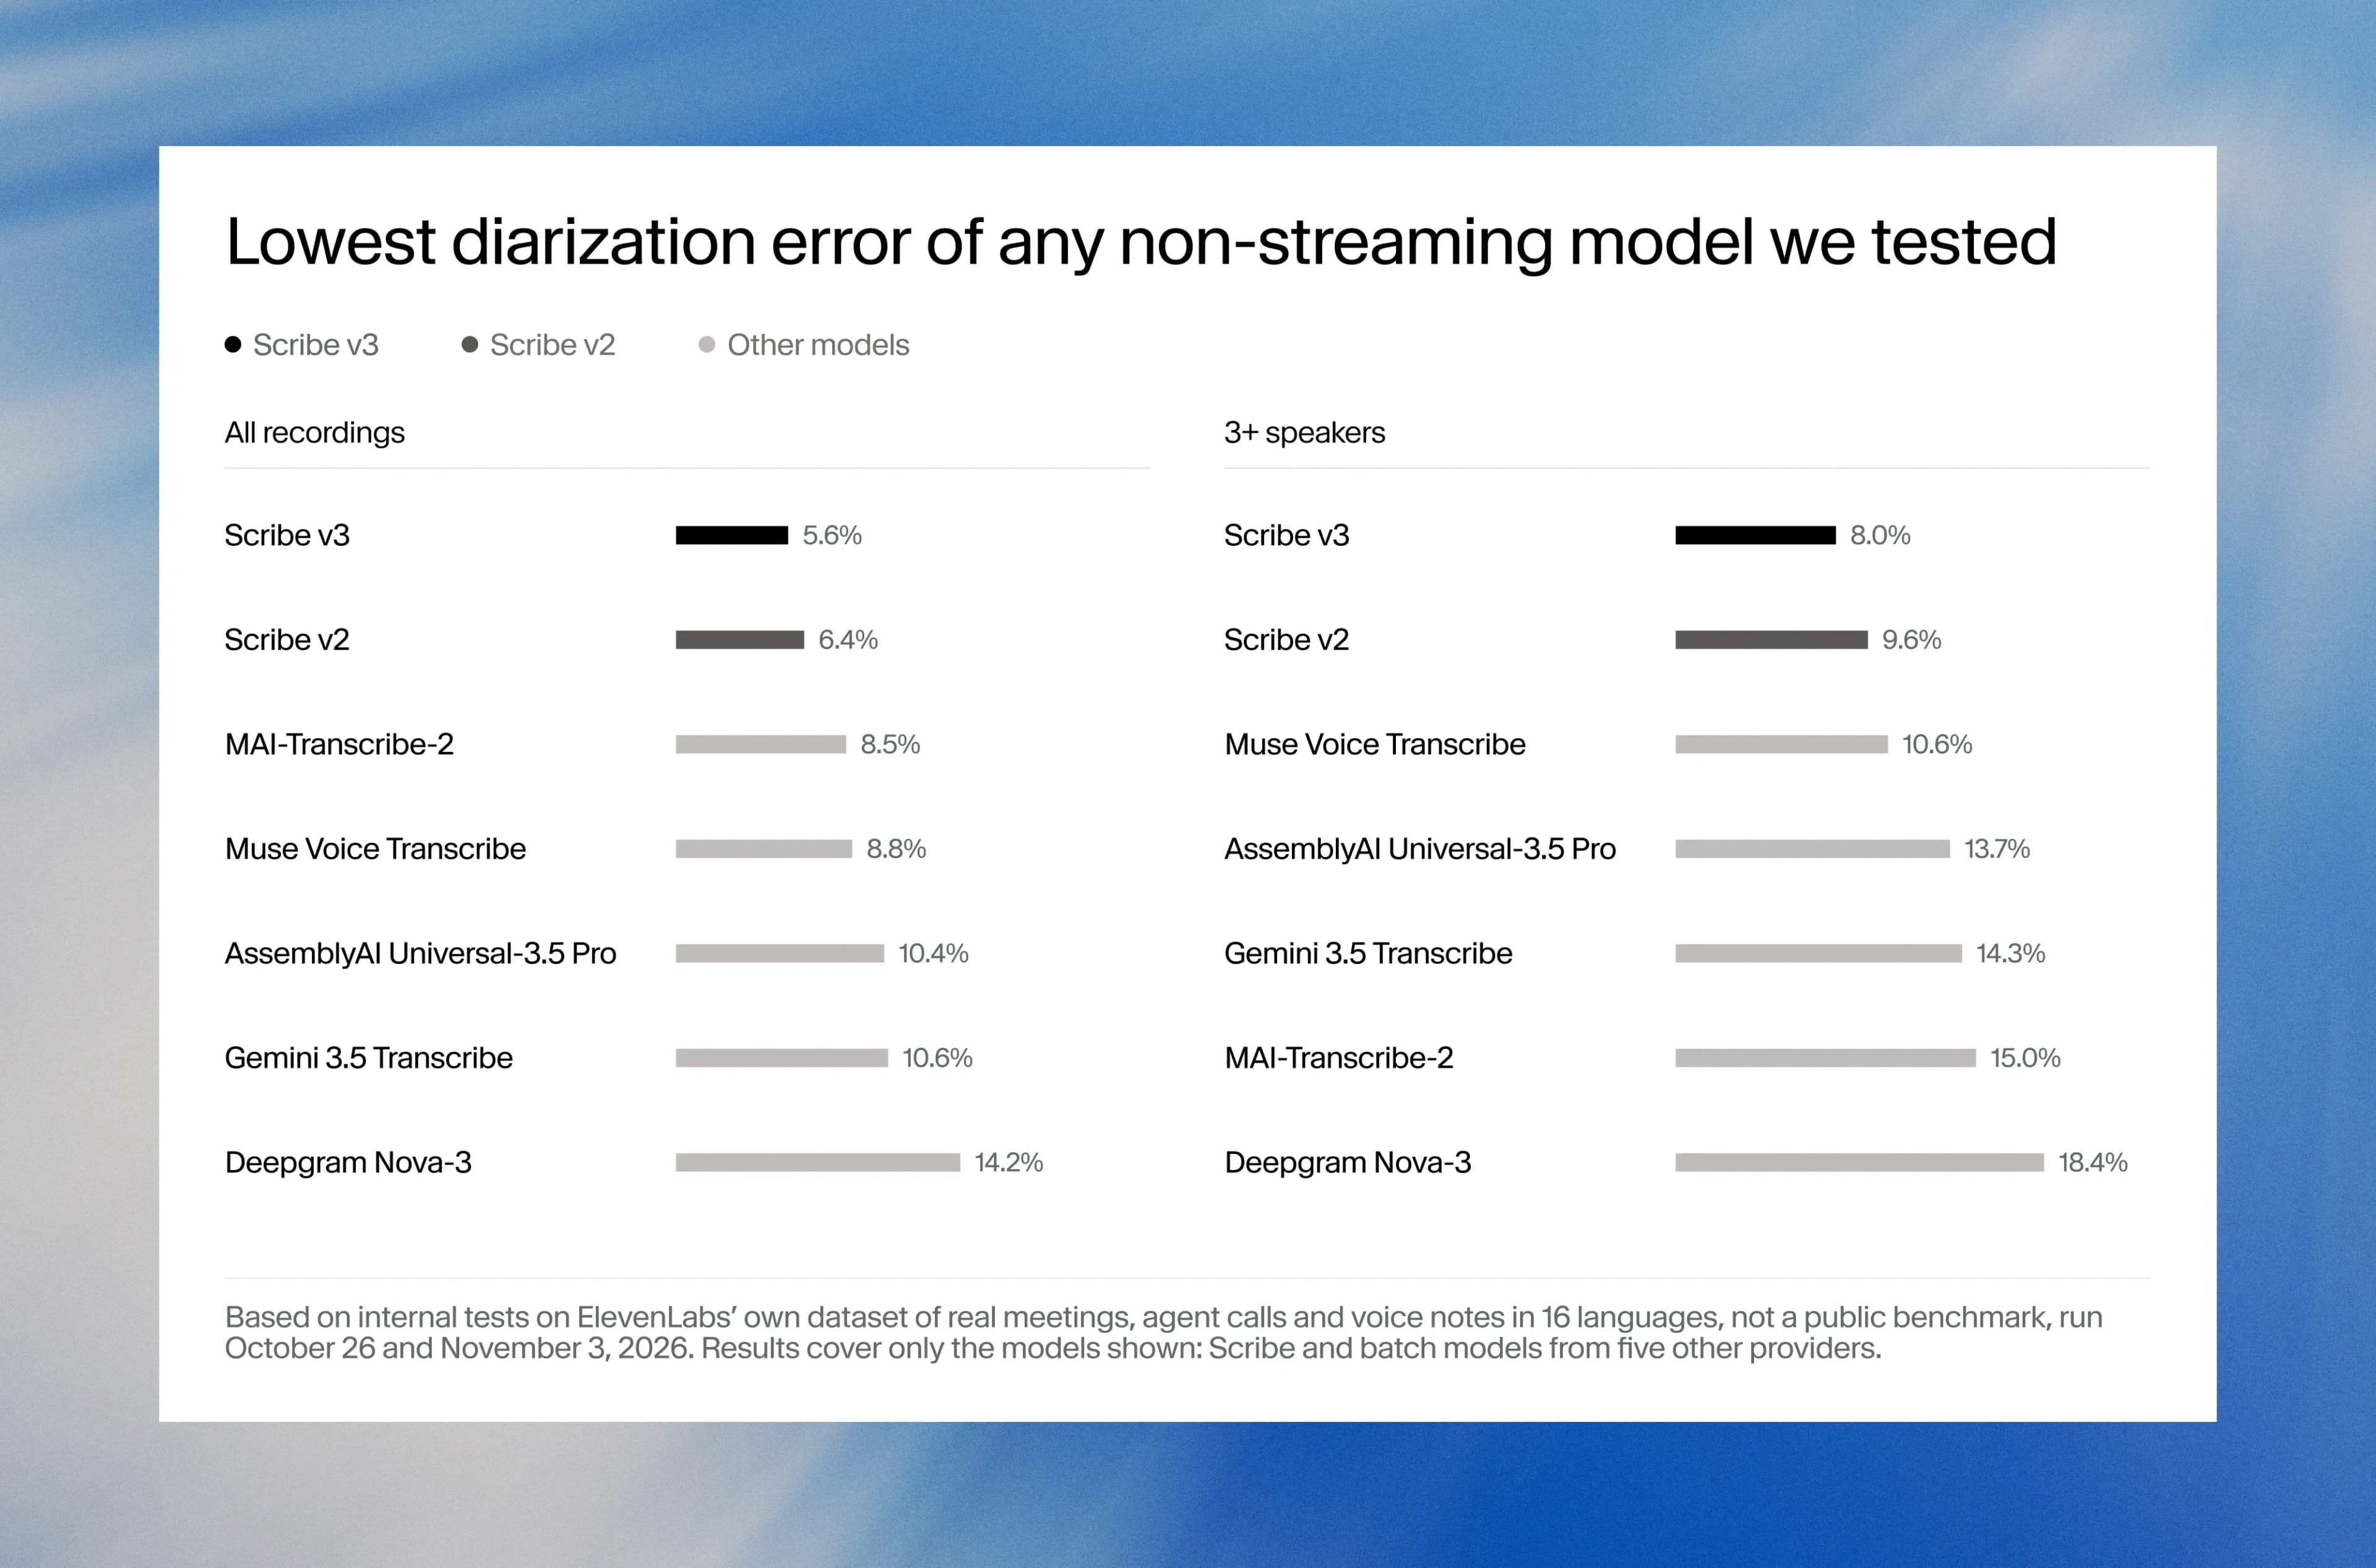
Scribe v3 heeft de laagste diarisatiefout van alle modellen die we hebben getest, met in totaal 12% minder fouten dan Scribe v2 en 17% minder bij opnamen met drie of meer sprekers.
Nauwkeurigheid van meertalige transcriptie
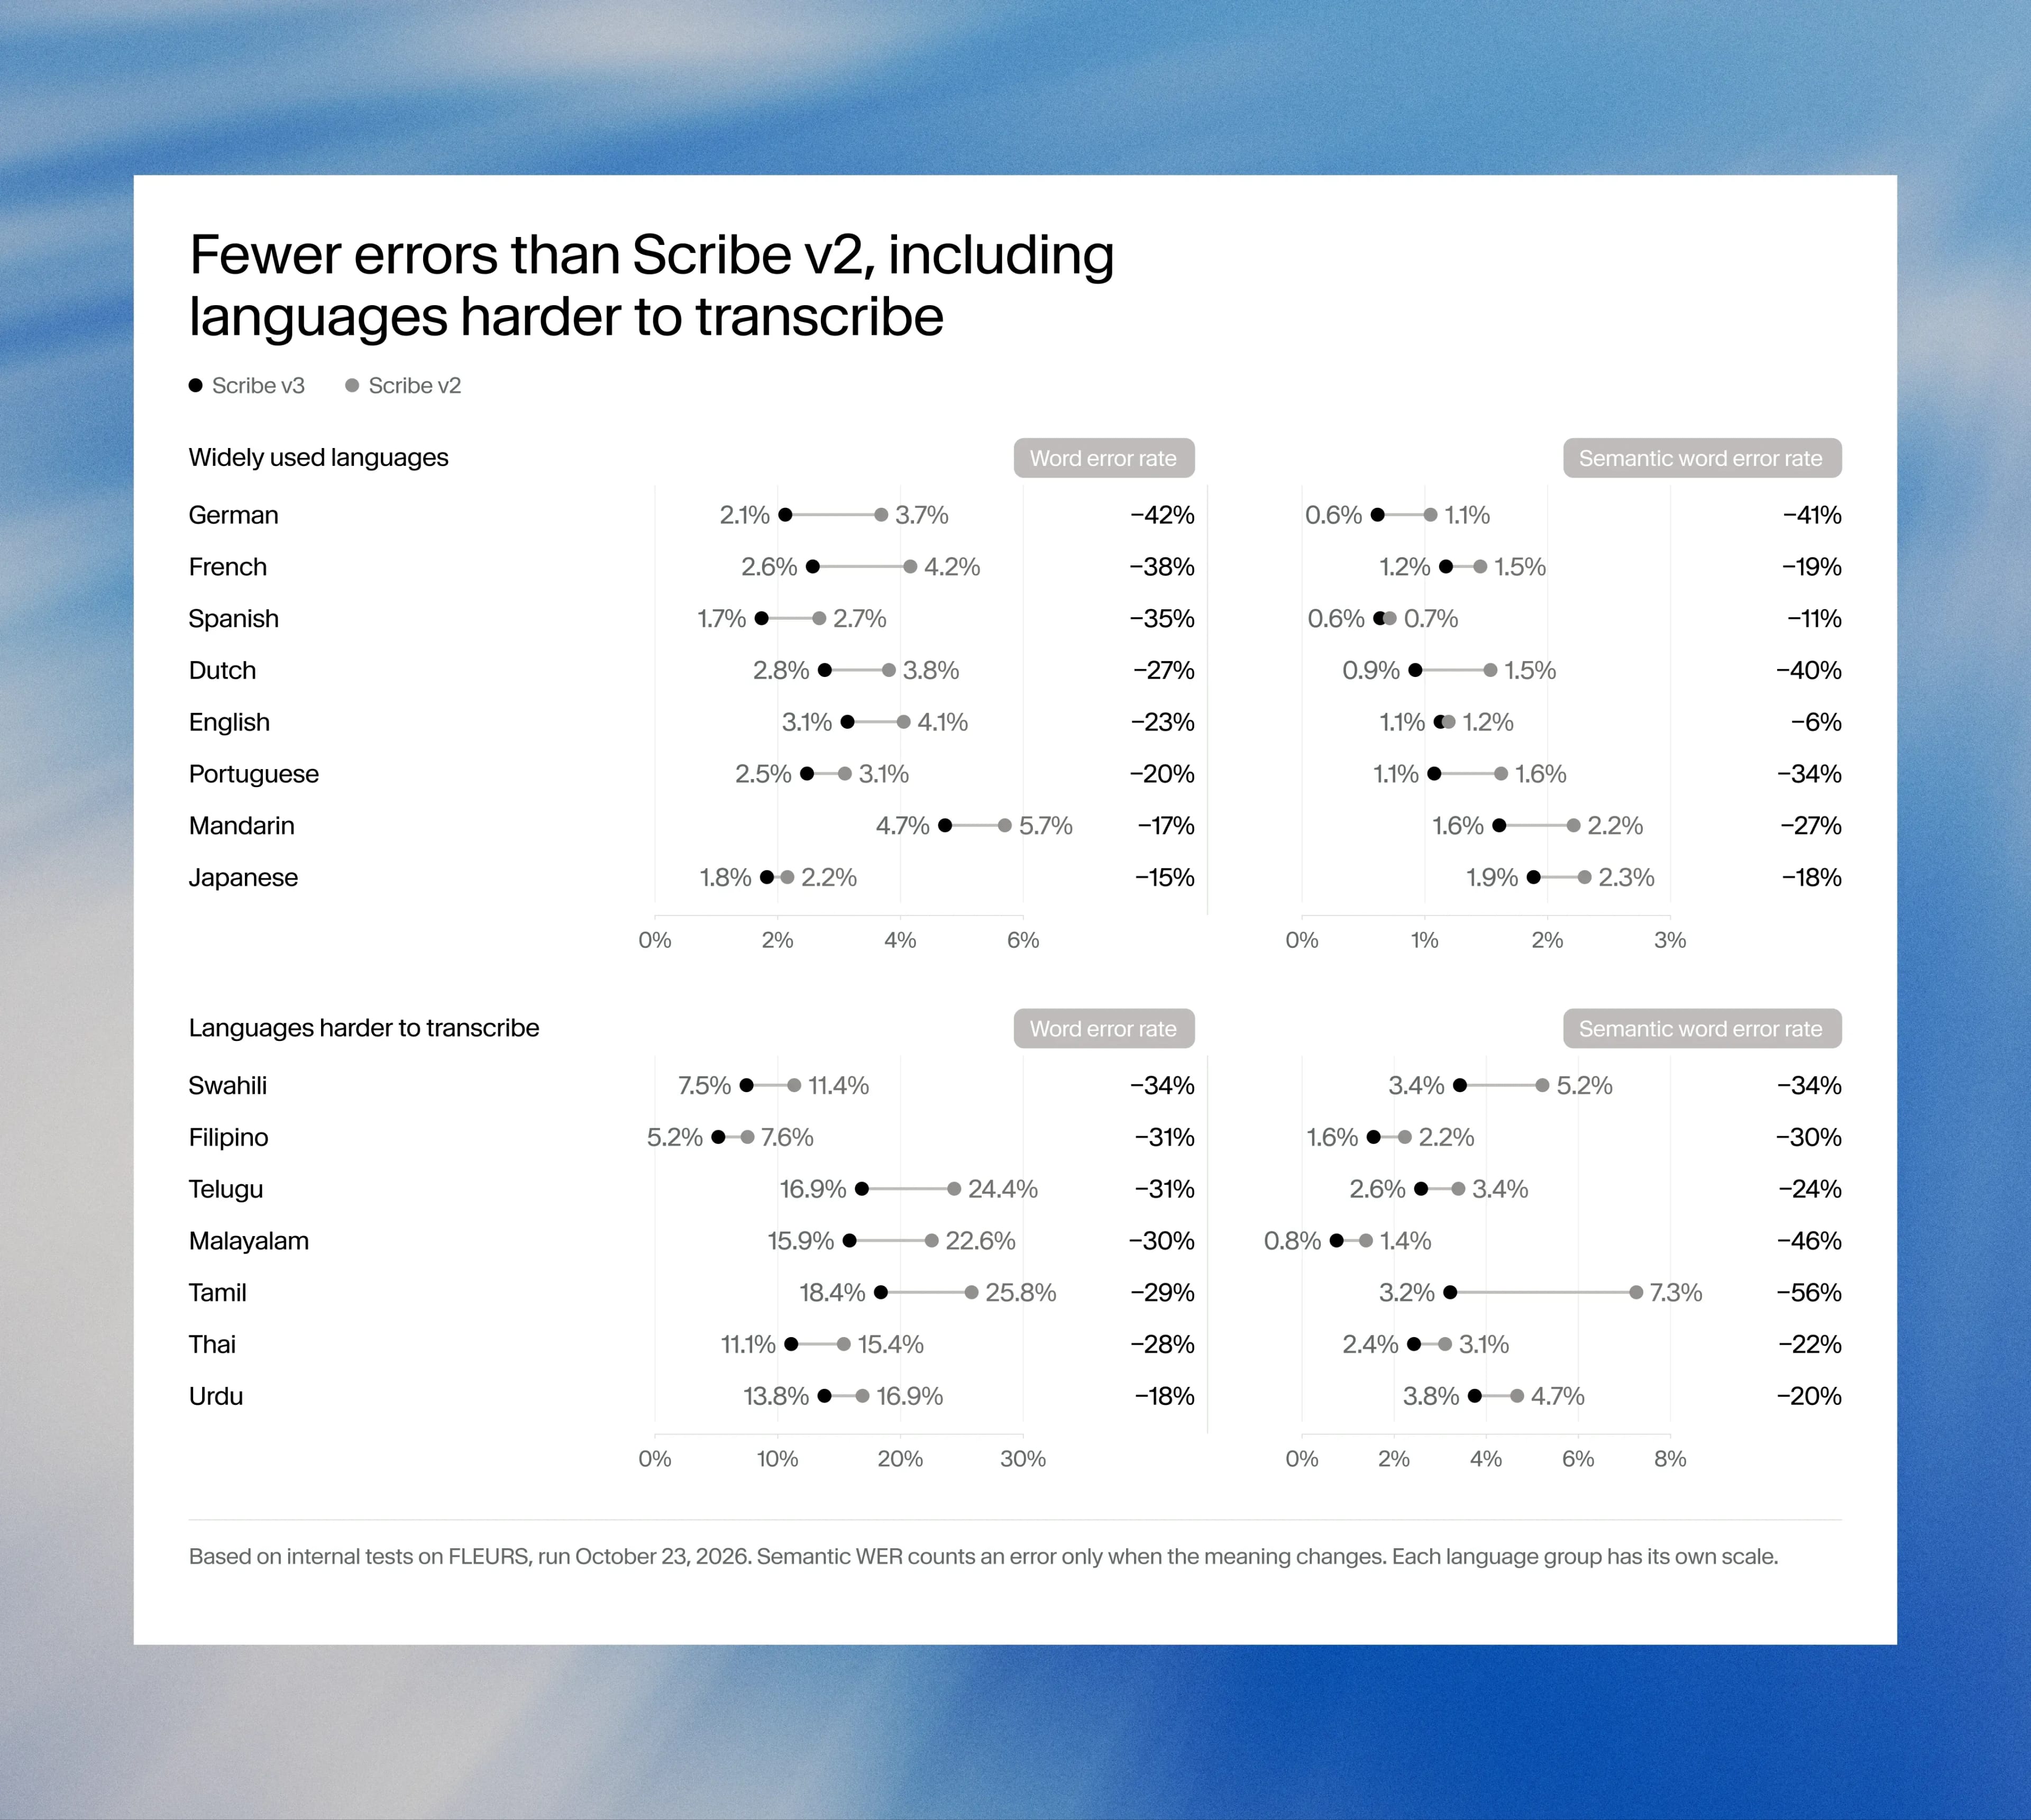
We rapporteren de word error rate (WER) naast semantische WER, waarbij alleen een fout wordt geteld wanneer de betekenis van het transcript verandert.
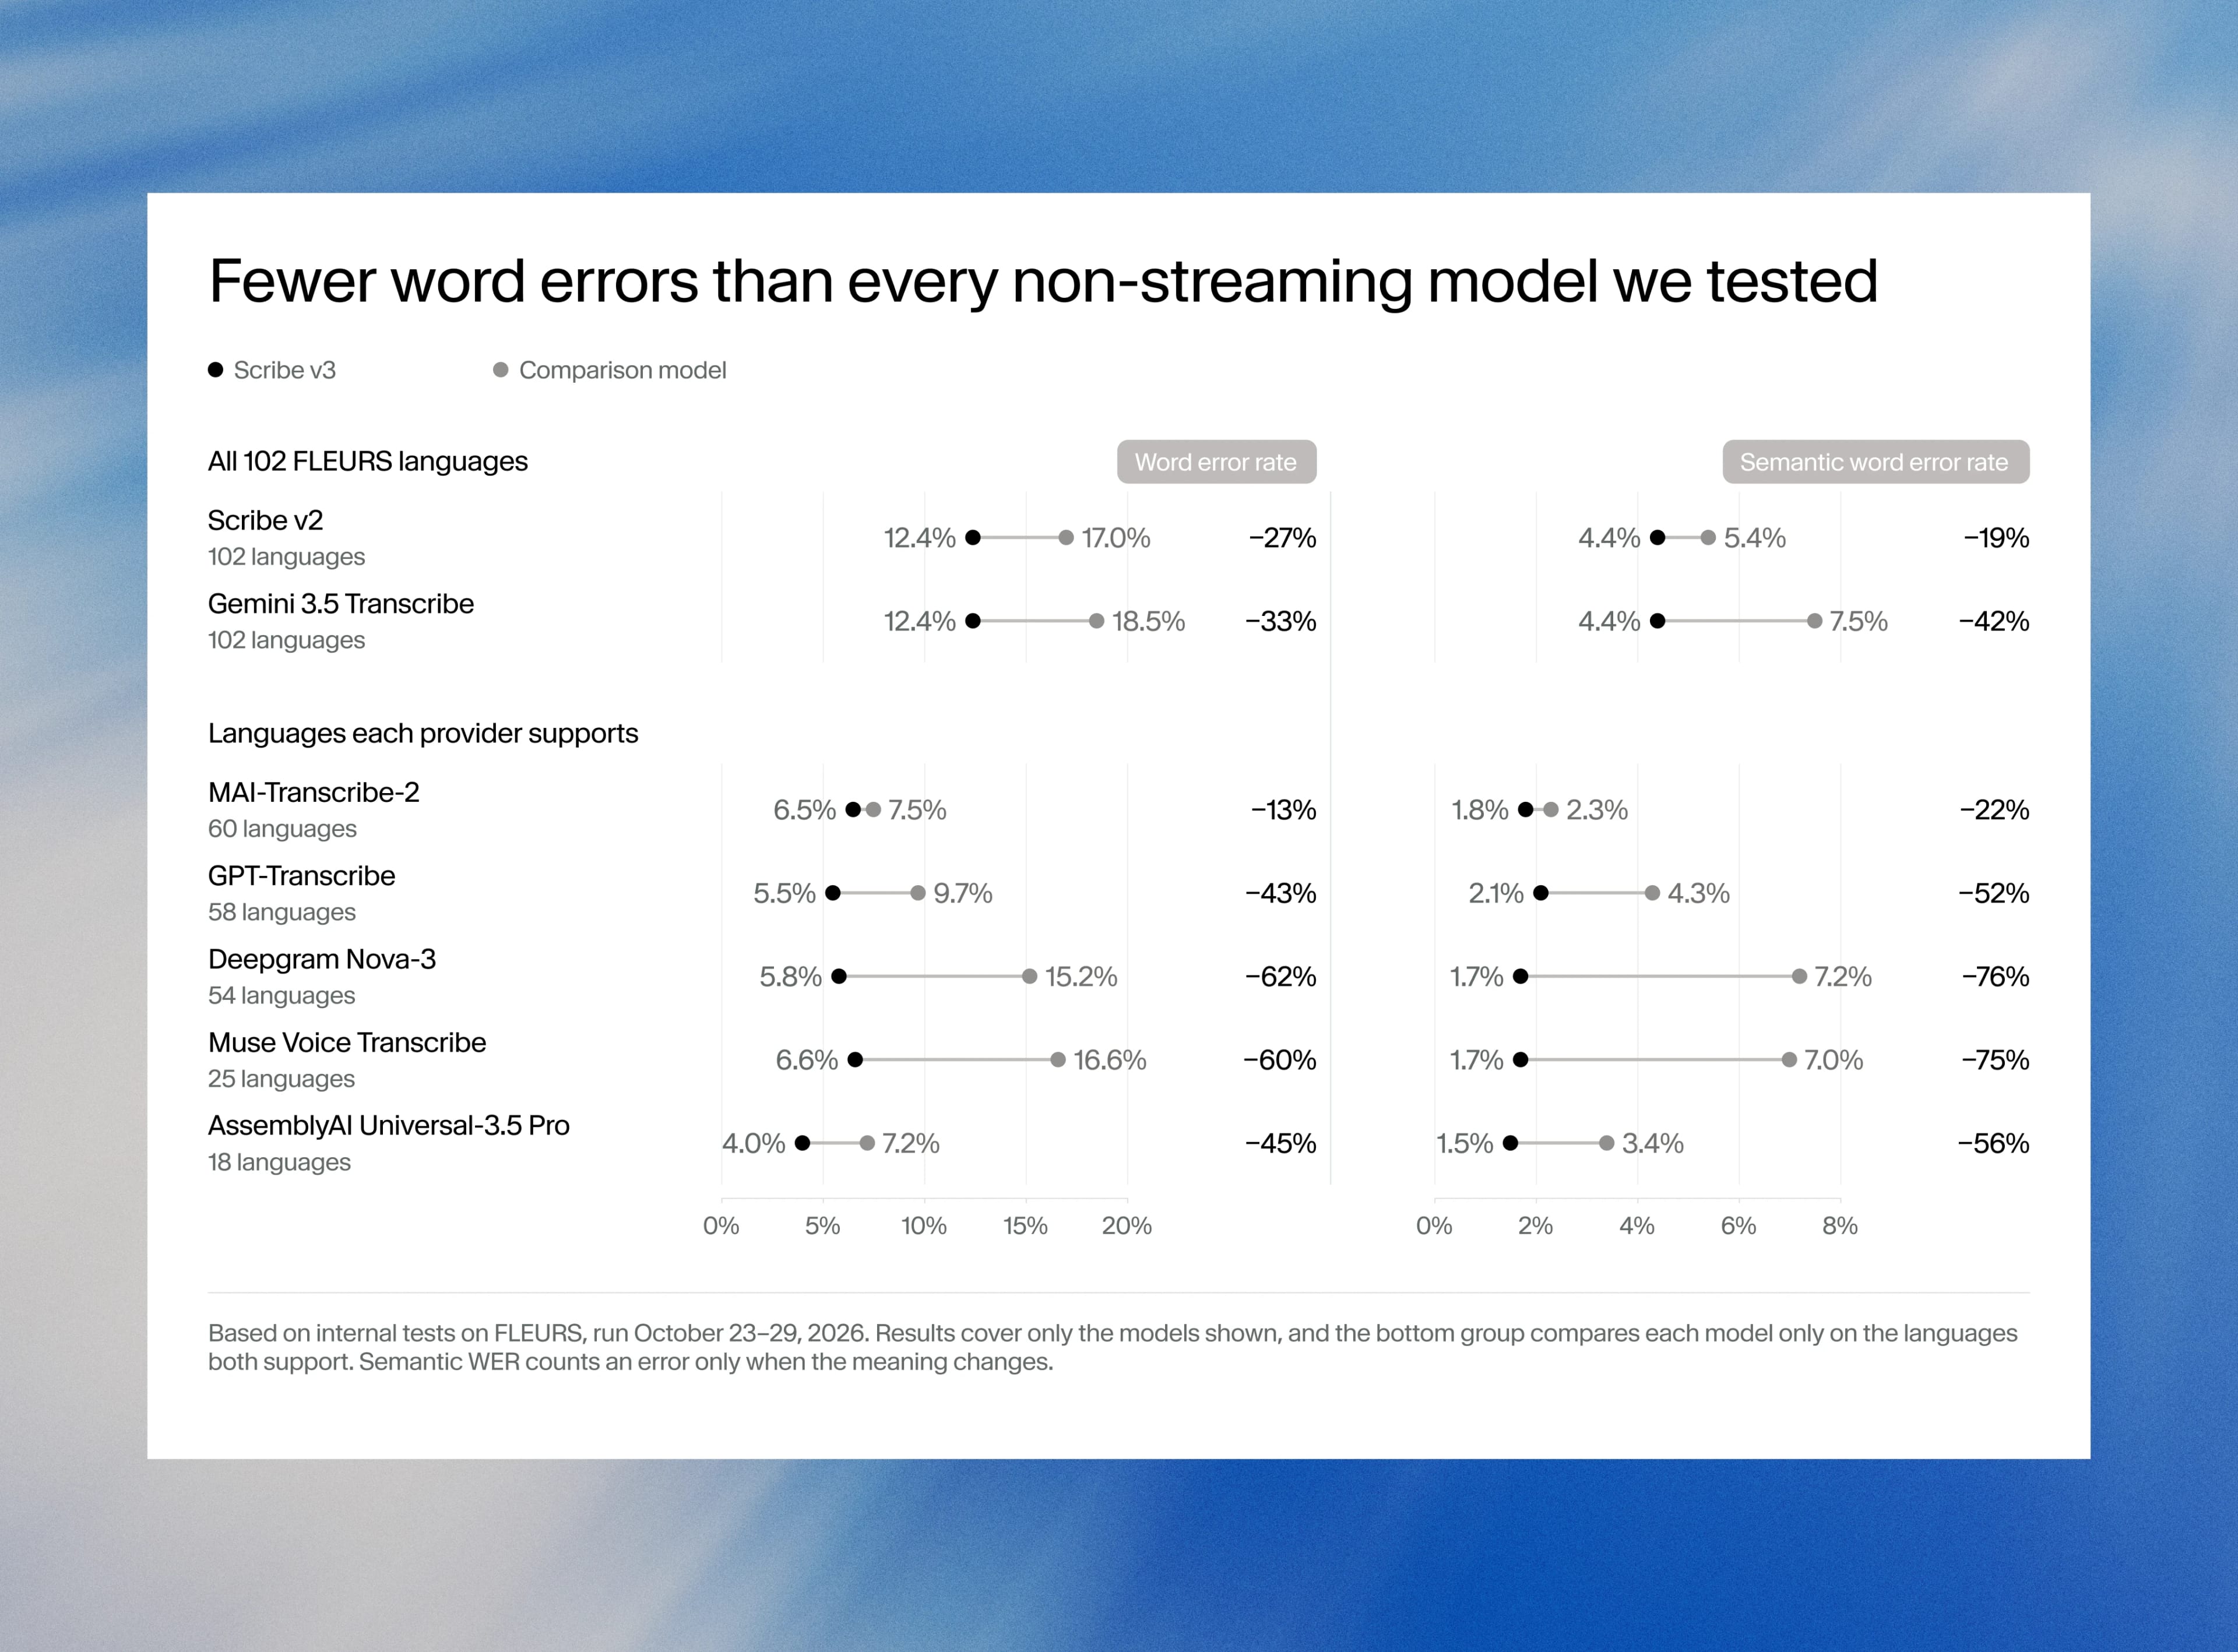
In 102 talen op FLEURS verlaagt Scribe v3 de WER met 27% vergeleken met Scribe v2 en verbetert het in elke geteste taal. In talen die eenvoudiger te transcriberen zijn, verbeterde Duits met 42%, Spaans met 35% en Engels met 23%. De verbeteringen zijn groter in talen die moeilijker te transcriberen zijn: Swahili daalt met 34%, Tamil met 29% en Thai met 28%.
Scribe v3 maakt ook minder woordfouten dan elk ander batchmodel (niet-streaming) dat we hebben getest, waarbij we elk model vergelijken in de talen die beide modellen ondersteunen.
Sprekerdiarisatie in realtime
In het Engelstalige deel van onze praktijkdataset in 16 talen heeft Scribe v3 Live een diarisatiefoutpercentage van 3,1%, vergeleken met 5,9% tot 7,3% voor de andere realtime-modellen die we hebben getest.
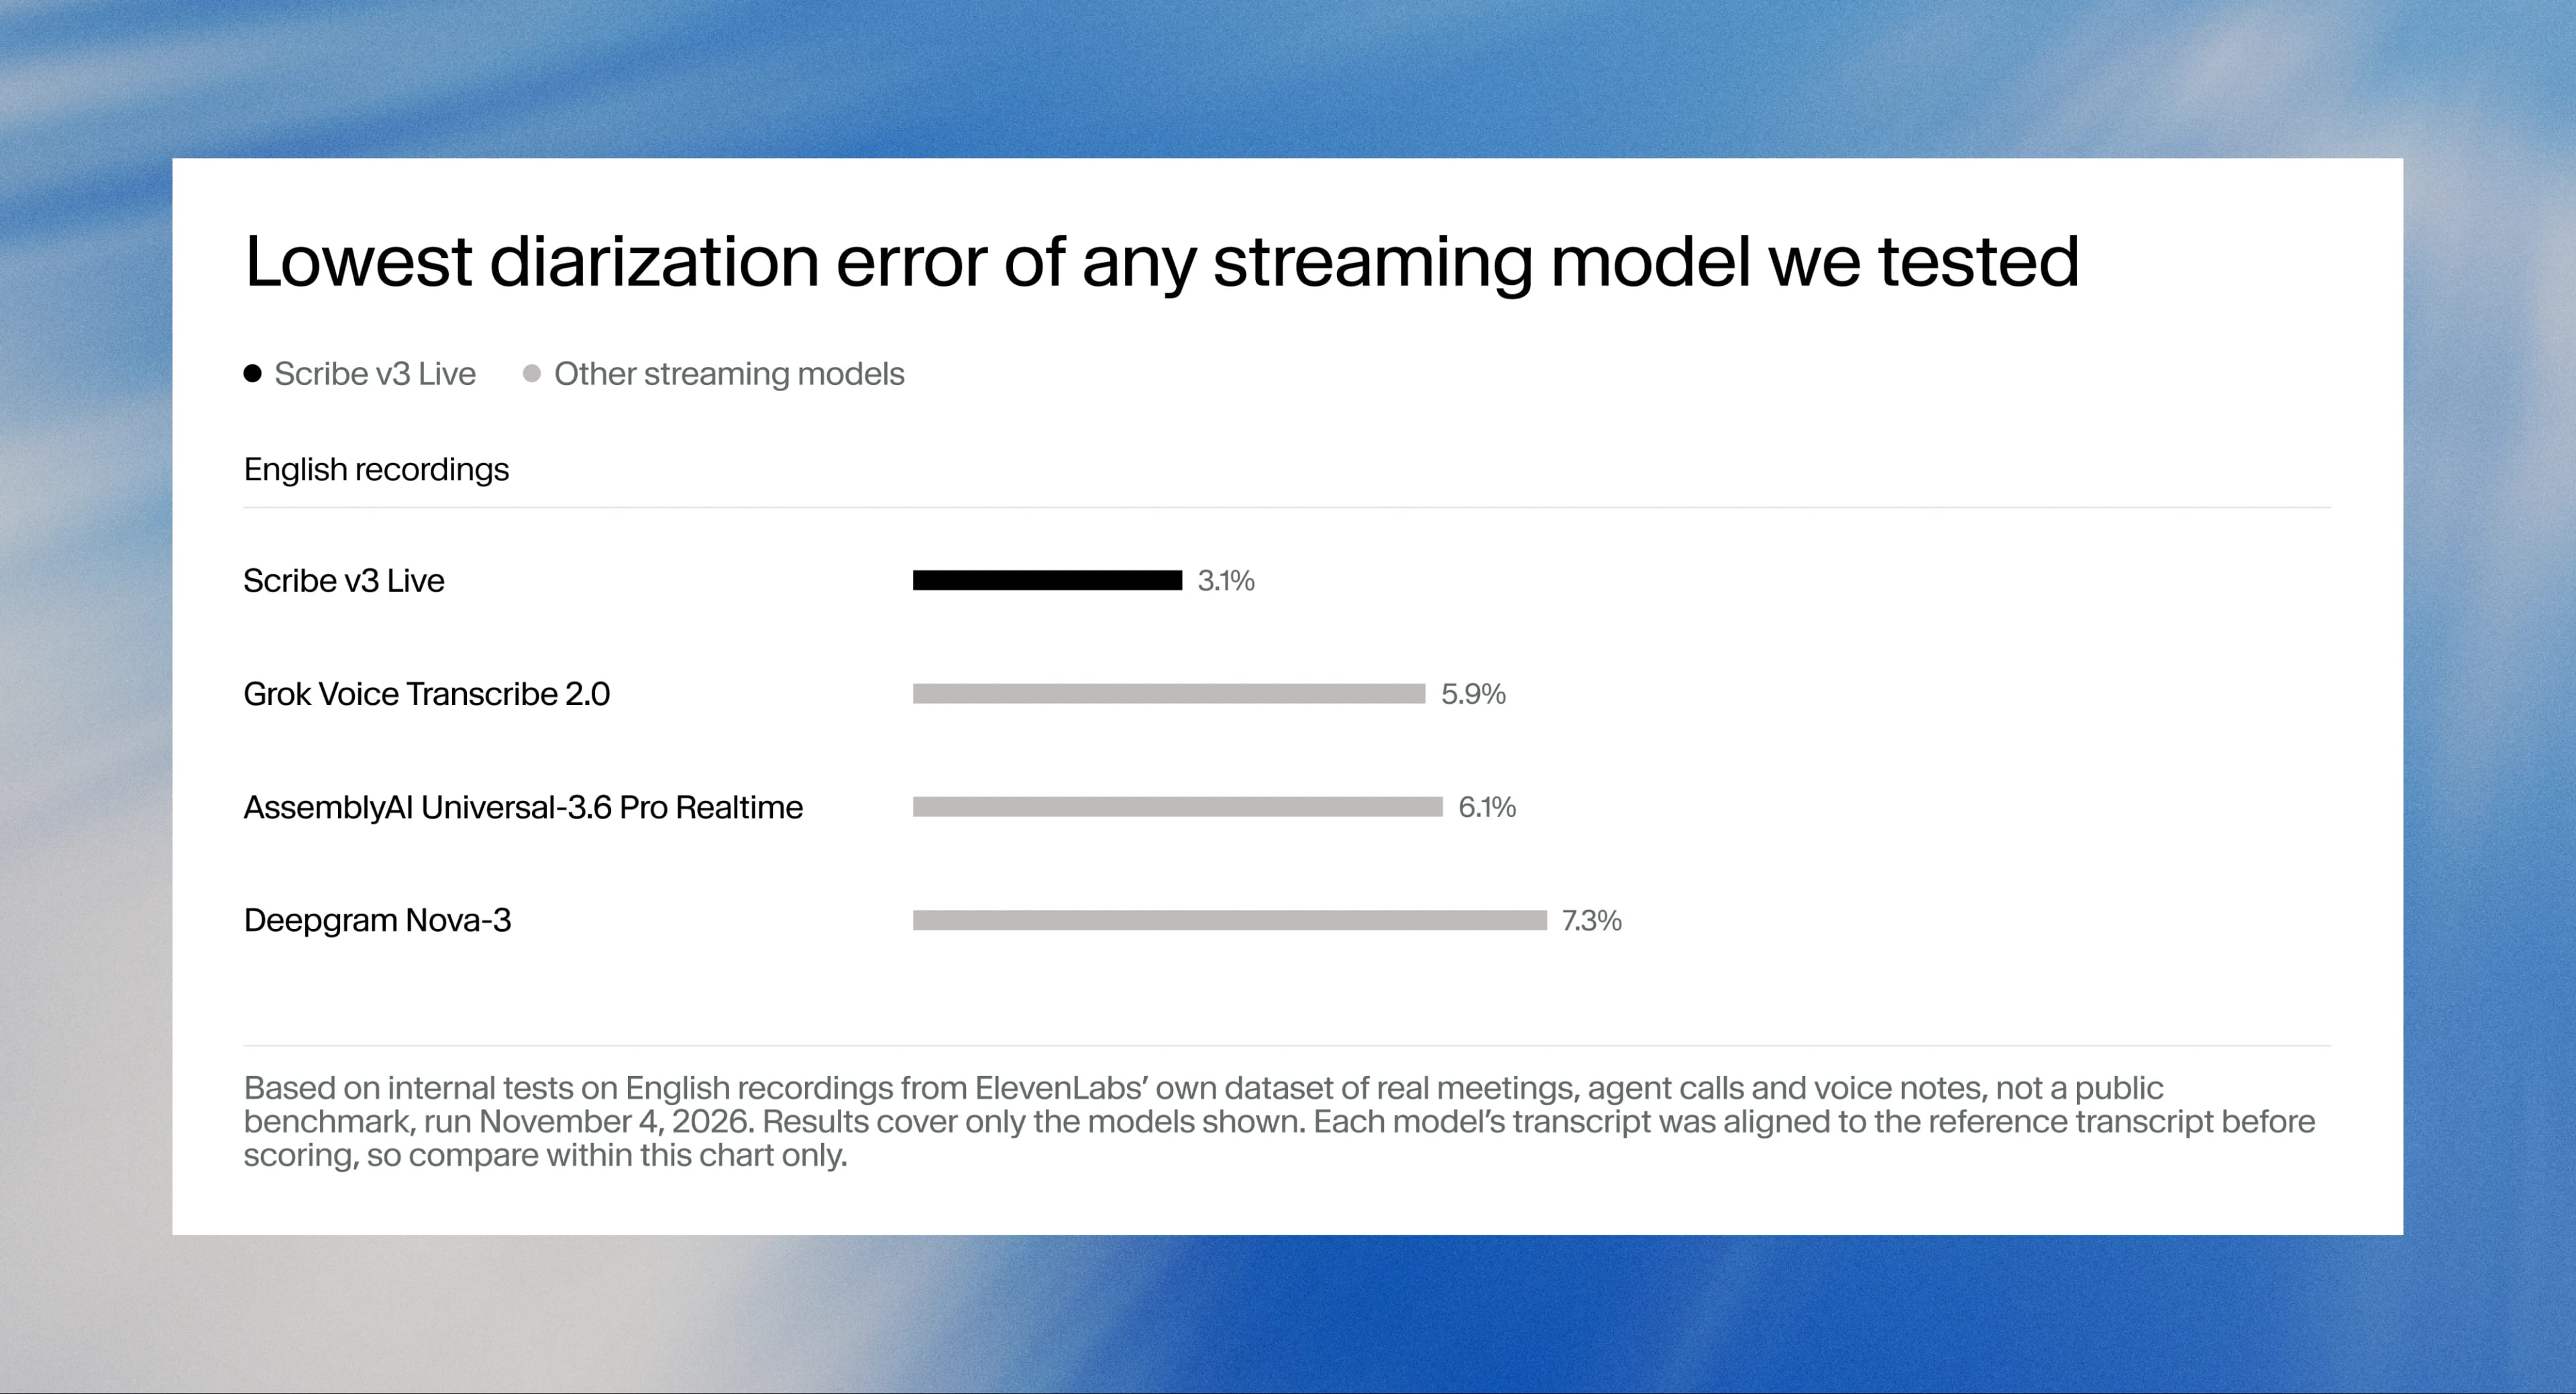
Standaardscores voor diarisatie tellen ook transcriptiefouten mee, zoals gemiste woorden, en realtime-modellen missen meer woorden dan batchmodellen. Om alleen te meten of elk woord aan de juiste spreker is toegewezen, hebben we het transcript van elk model vóór de beoordeling afgestemd op de referentie. Hierdoor daalt het foutpercentage van elk model, dus deze resultaten kunnen niet worden vergeleken met de bovenstaande resultaten voor batchdiarisatie.
Meertalige nauwkeurigheid in realtime
Voor realtime-modellen hanteren we semantische WER als uitgangspunt. Een streamingmodel schrijft tekst voordat het de hele zin heeft gehoord, en elke aanbieder maakt tijdens het proces getallen, interpunctie en hoofdlettergebruik anders op. Standaard-WER telt die verschillen als fouten, ook wanneer de betekenis hetzelfde is. Daarom is semantische WER de eerlijkere vergelijking.
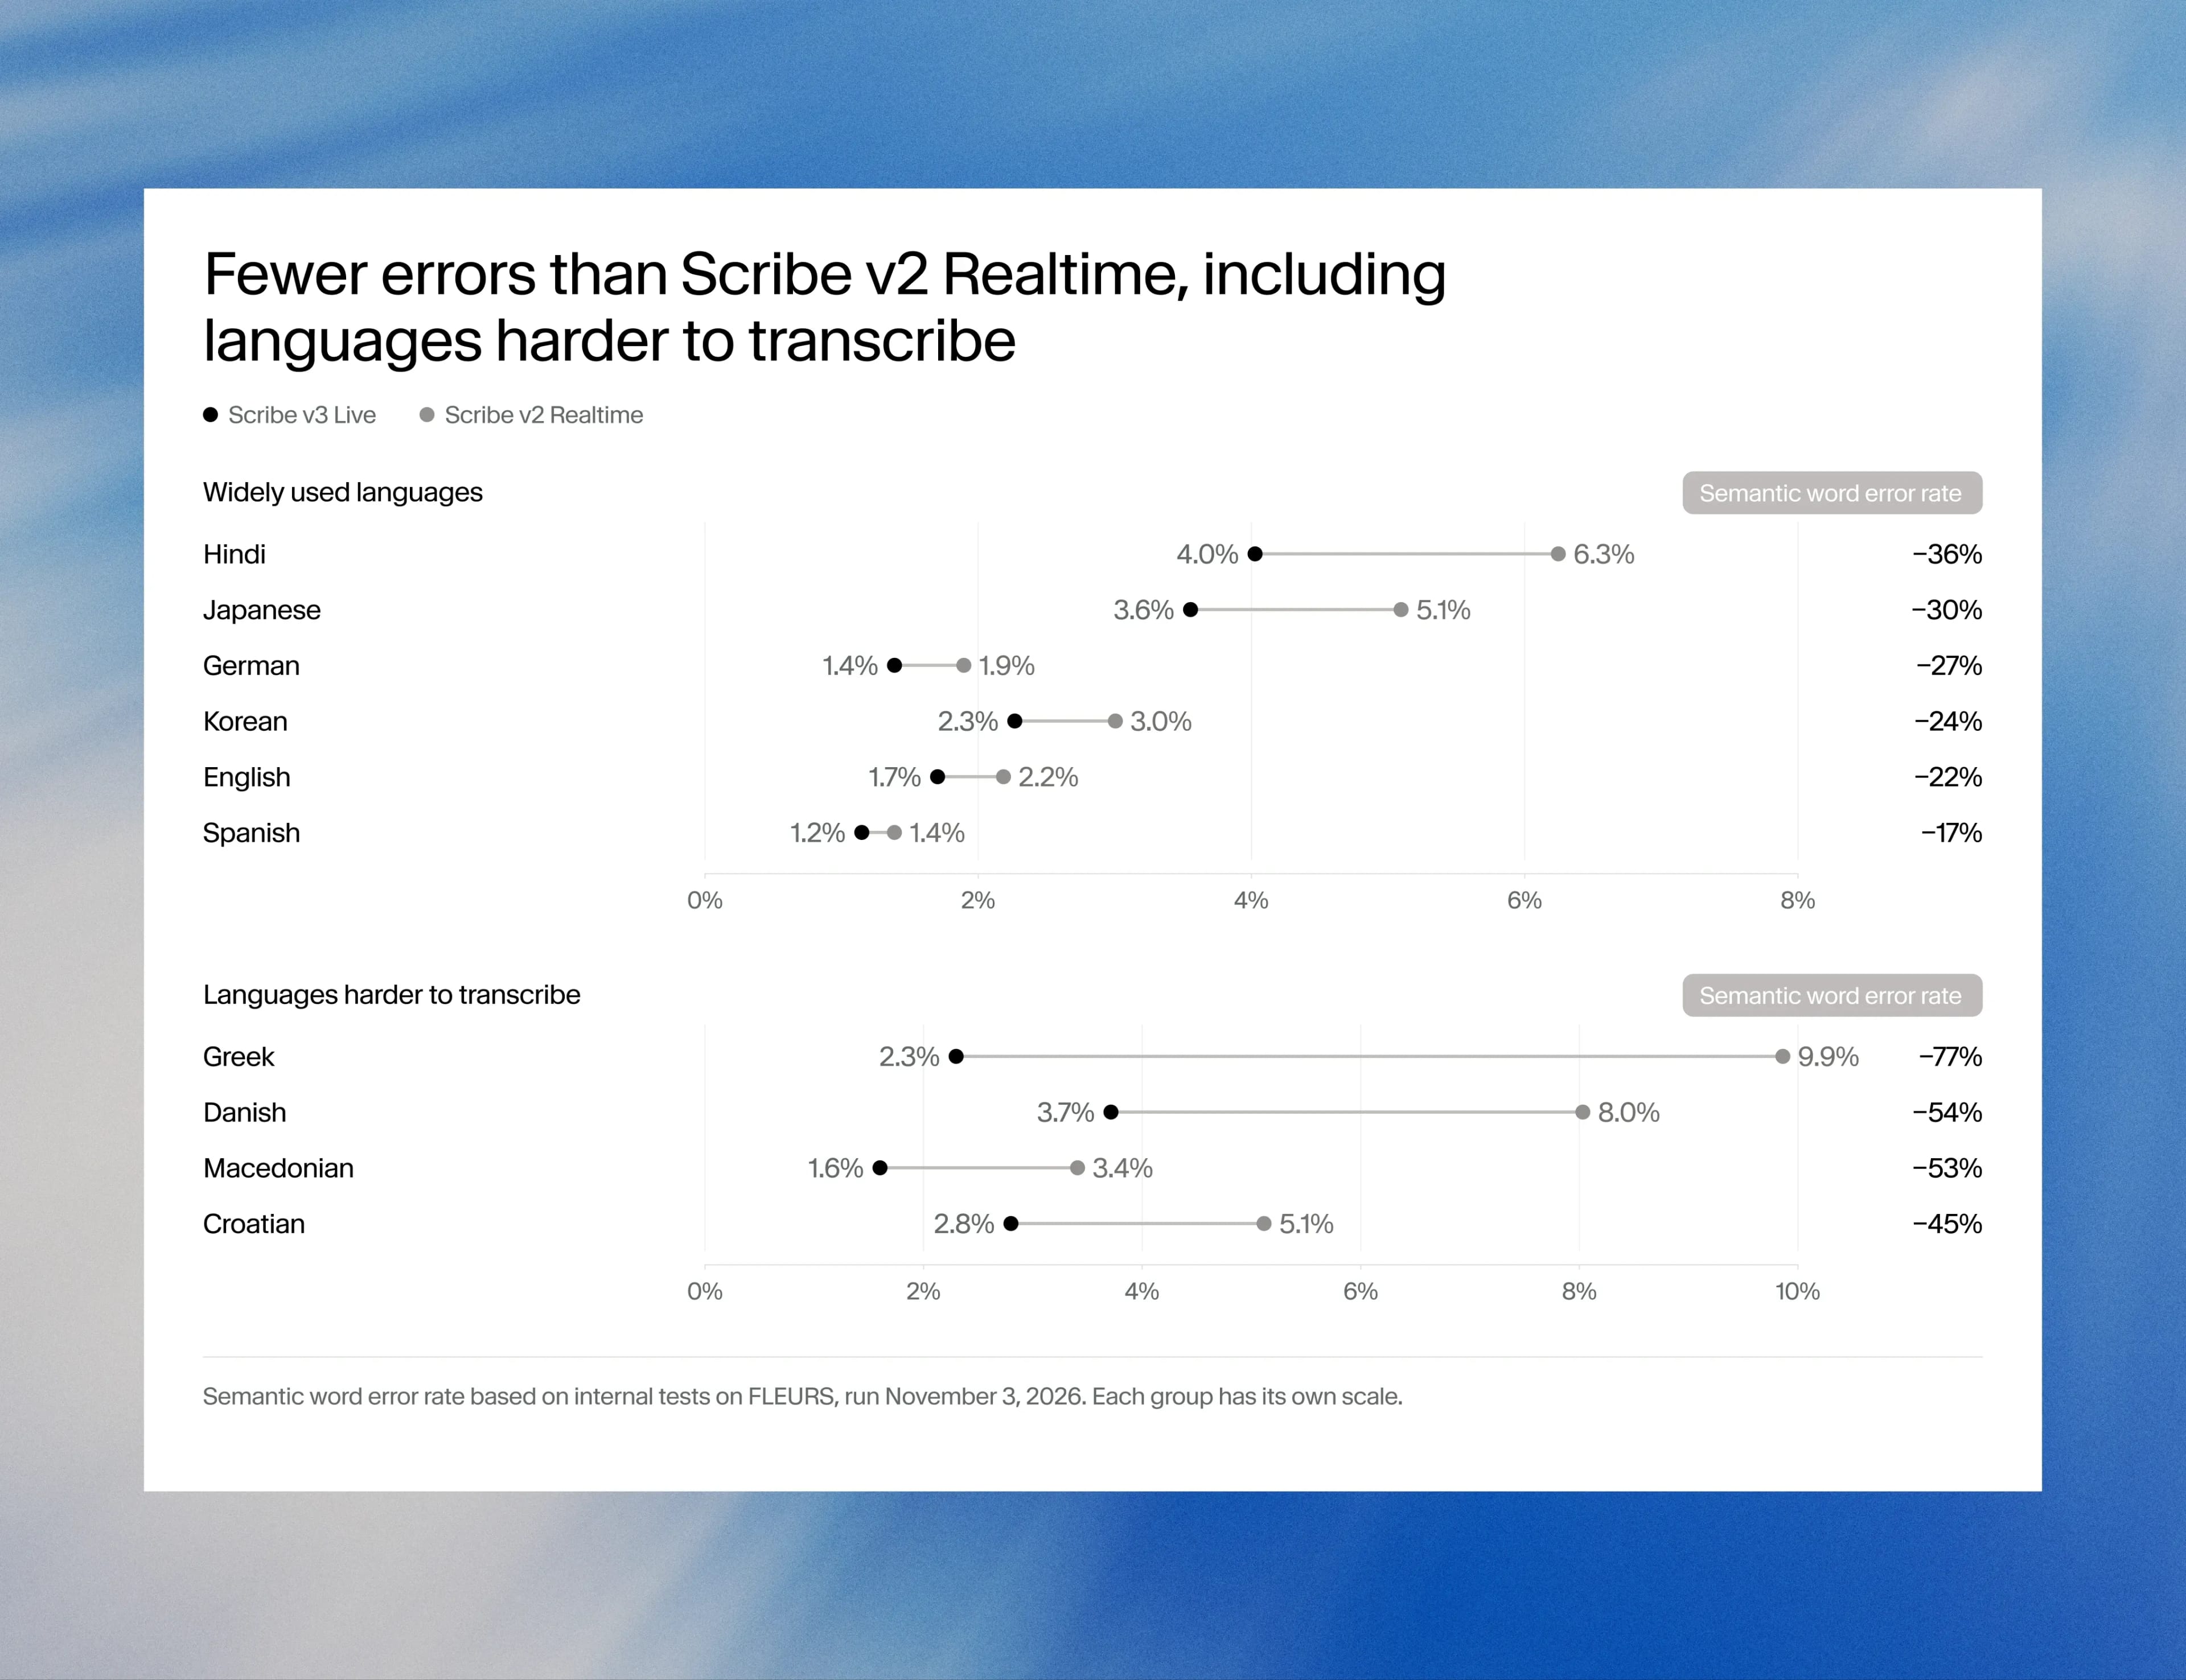
In 102 talen verlaagt Scribe v3 Live de semantische WER met 43% en de WER met 31% vergeleken met Scribe v2 Realtime. Het verbetert in elke taal en heeft een lager foutpercentage dan elk ander realtime-model dat we hebben getest.
De verbeteringen zijn het grootst waar realtime-transcriptie achterbleef: Grieks verbetert met 77%, Deens met 54% en Kroatisch met 45%, terwijl Hindi met 36% verbetert.
Een opmerking over de methode: we hebben elke taal afzonderlijk beoordeeld voordat we het gemiddelde berekenden, zodat alle 102 talen even zwaar meetellen. Veel gepubliceerde resultaten voegen alle clips samen tot één score, wat doorgaans lagere cijfers oplevert. Resultaten die op verschillende manieren zijn gemeten, zijn daarom niet rechtstreeks vergelijkbaar.
Wat enkele punten nauwkeurigheid waard zijn
Elke modellancering gaat gepaard met percentages, deze ook, en op papier is het lastig te zien wat enkele punten betekenen in praktijksituaties. Een vergadering van één uur met 150 woorden per minuut telt ongeveer 9.000 woorden, dus het verschil tussen een woordfoutpercentage van 4% en 2% is 180 verkeerde woorden: drie voor elke minuut dat iemand sprak. Een diarisatiefout wordt gemeten in tijd in plaats van woorden, dus in diezelfde vergadering staat elk punt voor 36 seconden spraak onder de verkeerde naam.
Wat die fouten kosten, hangt af van waar ze terechtkomen. In een podcasttranscript is een verkeerd woord een typefout, maar bij een winstgesprek komt “fifteen” dat als “fifty” is gehoord in het model van een analist terecht. Fouten concentreren zich ook in namen, getallen, afkortingen en jargon: precies de woorden die een samenvatting of agent het meest correct moet herkennen.
Meteen goed in ElevenAgents
Spraakagenten merken dit het sterkst, omdat één verkeerd verstaan cijfer de controle aan het begin van het gesprek kan laten mislukken. Eneco, dat energie levert aan meer dan 2 miljoen huishoudens en bedrijven in Nederland, draait zijn spraakagent op ElevenAgents en heeft Scribe v3 Live vóór de lancering ermee getest. In echte klantgesprekken herkende de agent Nederlandse postcodes bij de eerste poging 40% vaker correct, en huisnummers 15% vaker.
“ElevenLabs is een echte partner voor Eneco. Samen met hun forward deployed engineers werken we eraan om onze spraakagent verder te verbeteren”, zegt Ruud Huigsloot, Senior Product Manager bij Eneco. “Het is geweldig om nu al zulke significante resultaten te zien en we kijken ernaar uit om de samenwerking voort te zetten.”
Ontwikkeld voor enterprise
Scribe v3 en Scribe v3 Live draaien standaard in de VS en worden aangeboden in geïsoleerde omgevingen in de EU, India en Singapore voor enterpriseklanten met vereisten voor dataresidentie. Zero Retention Mode verwijdert audio en tekst zodra een request is voltooid. Beide modellen vallen onder onze SOC 2-, ISO 27001- en PCI DSS Level 1-programma's, komen met een Business Associate Agreement in aanmerking voor HIPAA en zijn beschikbaar voor private deployment.
Ga vandaag aan de slag
Scribe v3 Live is beschikbaar in ElevenAgents en zowel v3 als v3 Live zijn standaard ingesteld in de ElevenLabs-app. Registreren om het te proberen.
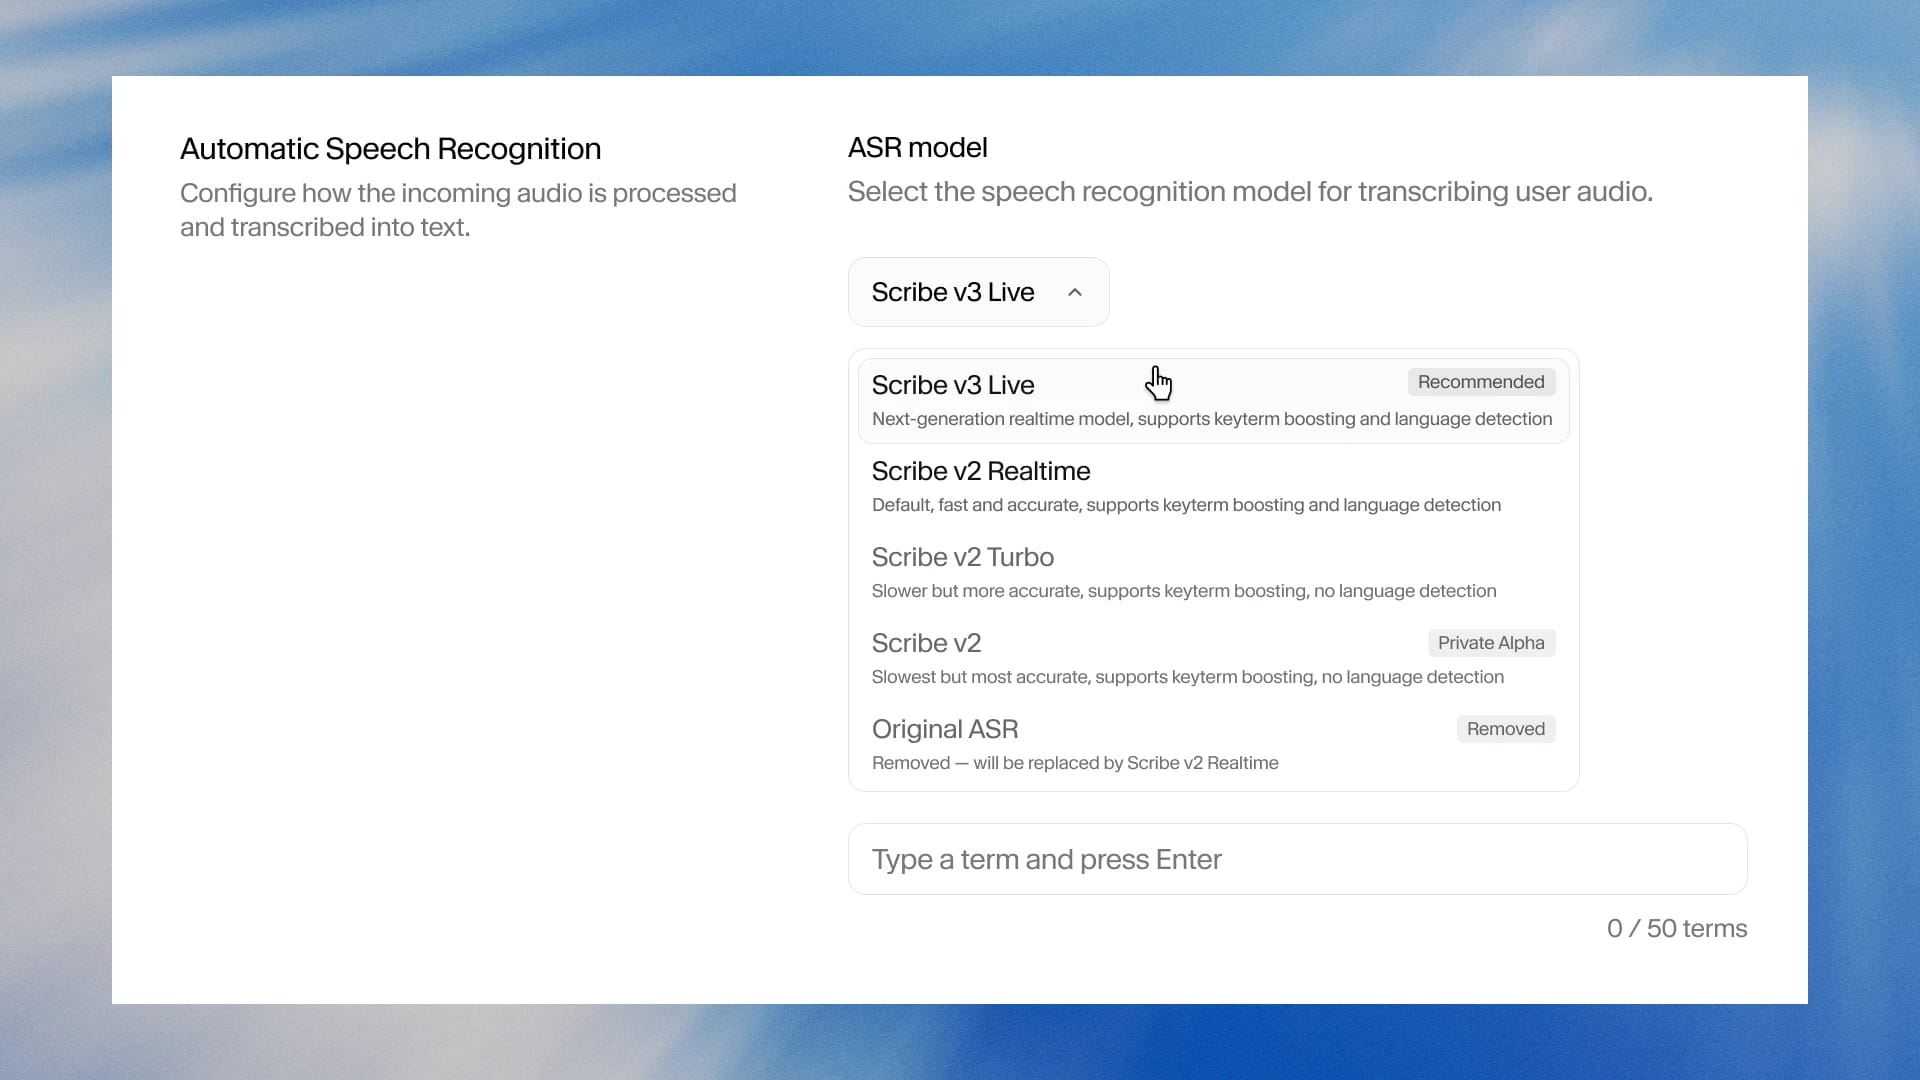
Beide modellen zijn vandaag ook beschikbaar in ElevenAPI. Bestaande integraties worden bijgewerkt door de model-ID te wijzigen in scribe_v3 of scribe_v3_live.
Voor zorgteams brengen we ook een versie van Scribe v3 Live uit die is geoptimaliseerd voor medische gesprekken in ElevenAgents.
Min werkt in het Growth-team bij ElevenLabs en richt zich op ElevenAPI en On-Prem/On-Device. Eerder leidde hij productmarketing bij Stainless als de tweede GTM-medewerker en daarvoor was hij een vroege PMM bij WorkOS, waar hij launches, enablement, content en groei aanstuurde.