
Stemagents bouwen die blijven werken: lessen uit forward deployed engineering
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Bij de meeste organisaties worden puntoplossingen voor support al lange tijd beoordeeld op afwending. Dit betekent het verminderen van het belvolume en het minimaliseren van interacties met live agents. Maar afwending is niet hetzelfde als oplossing, en in de kloof daartussen loopt de klantervaring spaak. Om die kloof te dichten, hebben agents niet alleen toegang tot data nodig, maar ook tot de systemen waarmee ze actie kunnen ondernemen. Daardoor kunnen agents terugbetalingen verwerken, klanten door een checkoutflow begeleiden en een gesprek met alle context overdragen aan een menselijke agent wanneer de situatie daarom vraagt. Zo kunnen enterprises klantinteracties op schaal afhandelen, wat de druk op menselijke supportteams aanzienlijk vermindert en de ervaring aan beide kanten van het gesprek verbetert. In een recente implementatie met Revolut, een fintechbedrijf dat wereldwijd 70 miljoen klanten bedient, leidde dit tot een achtvoudige verkorting van de oplostijd en een slagingspercentage van 99,7% voor gesprekken.
Organisaties moeten veranderingen van deze omvang iteratief aanpakken, nauw verbonden met de kernmissie van het bedrijf en gedragen door sterke steun van het bestuur. Op technisch niveau brengt redeneren in een ongestructureerde omgeving inherente risico's met zich mee die zorgvuldig moeten worden beheerd. Een agent de mogelijkheid geven om acties uit te voeren in Customer Relationship Management (CRM), een bestelling in het kassasysteem aan te passen of een case te escaleren, betekent dat het governancemodel net zo belangrijk is als het model zelf. De focus ligt dan niet op de vraag of agents echt werk aankunnen, maar op welke mechanismen nodig zijn om ze veilig en herhaaldelijk te implementeren.
In dit artikel delen we op basis van onze ervaring wat agents succesvol maakt: van de eerste implementatie tot opschaling naar de volledige klantoperatie van een organisatie.
Agents uitbrengen versus software uitbrengen
Voordat we dieper ingaan op het bouwen van agents, is het nuttig om de implementatie van stemagents te vergelijken met traditionele software, iets wat enterprises al decennialang doen. Vanuit dit perspectief kunnen agents worden opgesplitst in twee afzonderlijke componenten: traditionele software en de core orchestrator.
Software


Core orchestrator
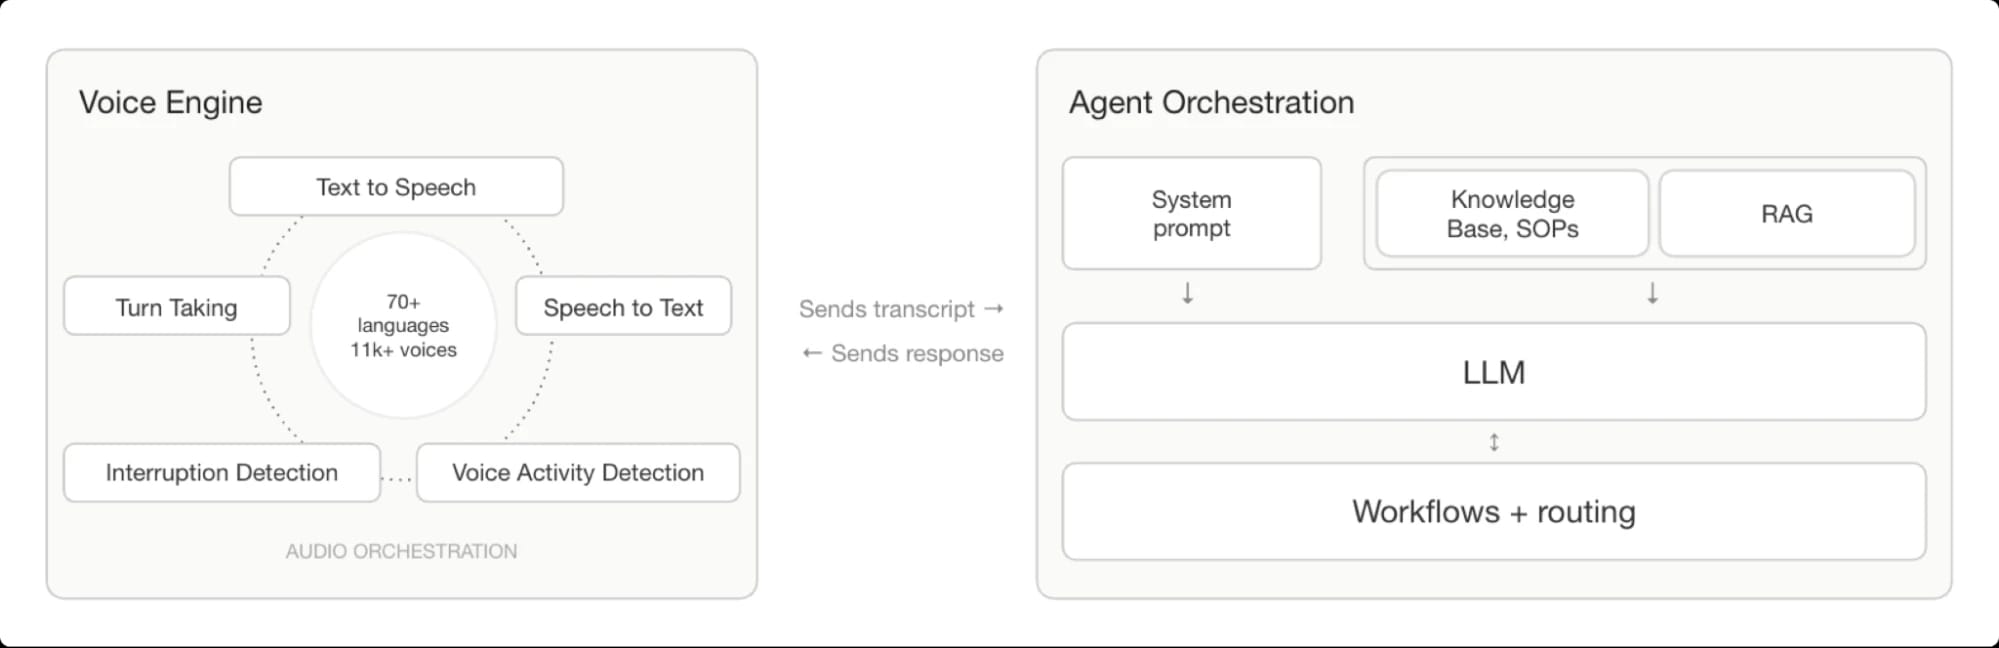
De traditionele softwarecomponenten zijn vooral bedoeld om de levering en prestaties van de agent te verbeteren. Voor ElevenAgents omvat dit functies zoals versiebeheer, A/B-testen, telefonie en eerste bericht-configuratie, naast andere functies. Deze componenten vertonen na implementatie weinig tot geen drift, waardoor hun gedrag zeer voorspelbaar is. Met solide engineeringpraktijken kunnen organisaties snel voortbouwen op deze functies en hun prestaties in productie goed begrijpen aan de hand van een grondige set metrics, traces en logs. Latencyverbeteringen in deze laag volgen bekende patronen: caching, connection pooling, infrastructuurschaling en protocoloptimalisatie zijn allemaal betrouwbare hefbomen met deterministische uitkomsten.
Componenten van de core orchestrator zijn van nature moeilijker te voorspellen, maar bepalen de runtimeprestaties van de agent, zowel wat betreft de kwaliteit van antwoorden als de waargenomen latency. Anders dan traditionele software werken deze componenten met natuurlijke taal en audio, waarbij de invoerruimte in feite onbegrensd is en kleine veranderingen in formulering, context, achtergrondgeluid of gebruikersgedrag in de loop van de tijd tot wezenlijk andere output kunnen leiden. Daardoor is conventioneel testen op zichzelf onvoldoende: een agent kan honderden testcases foutloos doorlopen en toch in productie op moeilijk voorspelbare manieren falen.
Ook latency in deze laag is minder deterministisch. Die wordt beïnvloed door modelinferentietijden, het invoegen van auditieve artefacten, ketens van tool calls en de variabiliteit die inherent is aan generatieve systemen. Deze componenten goed beheren vereist een andere discipline, gebaseerd op evaluatieframeworks, monitoring in productie en de bereidheid om continu te itereren op basis van echte gespreksdata, in plaats van alleen op aannames voorafgaand aan de implementatie.
Dit onderscheid bepaalt hoe organisaties adoptie moeten aanpakken: begin met use cases die relevant zijn voor de organisatie maar weinig risico met zich meebrengen, en schaal vervolgens bewust op naarmate het vertrouwen in het systeem groeit.
Releasecyclus
Voorlopers selecteren
Voor teams die stemagents gaan gebruiken, is het kiezen van de juiste voorlopers een van de belangrijkste vroege beslissingen. Bovendien heeft dit minder met technologie te maken dan de meeste mensen verwachten. Teams die vroeg successen boeken en de eindeloze POC-afgrond vermijden, hebben meestal iets gemeen: ze kunnen de volgende vragen helder beantwoorden.
- Hoe levert deze use case meetbare bedrijfswaarde op? De juiste use case om mee te beginnen is niet de technisch interessantste, maar de use case die het waarschijnlijkst invloed heeft op een resultaat dat het bedrijf al belangrijk vindt. Dit wordt gemeten aan de hand van omzetimpact, kostenbesparing, klanttevredenheid en andere metrics die leiders al bijhouden en waarvoor ze verantwoordelijk zijn. Zonder die directe koppeling aan bedrijfswaarde wordt het lastig om de iteratiecycli te rechtvaardigen die nodig zijn om de agent goed te laten werken, en zal het momentum waarschijnlijk stilvallen voordat de technologie zich kan bewijzen.
- Is het voor gebruikers direct duidelijk wat het bereik en doel van de agent zijn? Onduidelijkheid over het bereik is een van de meest voorkomende oorzaken van drift tussen ontwikkeling en productie. Gebruikers die niet begrijpen wat een agent wel en niet kan, testen de grenzen ervan op manieren die de evaluatiesuite nooit heeft voorzien. Een agent met een duidelijk afgebakend bereik schept vanaf het eerste bericht verwachtingen en handelt verzoeken buiten dat bereik netjes af.
- Hoe zien goede en slechte interacties eruit, en kunnen die worden vastgelegd in een concrete set evaluatiecriteria? Een goede interactie is niet alleen een interactie waarin de agent de taak uitvoert, maar ook een waarin de gebruiker zich gehoord voelt, escalatie op het juiste moment plaatsvindt en de uitkomst aansluit bij de bedrijfsdoelstelling. Evaluatiecriteria vallen in twee categorieën: kwantitatieve metrics die door het platform worden vastgelegd, zoals het taakvoltooiingspercentage en escalatiepercentage, en transcriptgebaseerde criteria waarvoor het gesprek zelf moet worden geanalyseerd. Door de transcriptgebaseerde criteria vroeg te definiëren, krijgt het team een concreet doel om naartoe te werken. Ze bepalen ook een natuurlijke drempel voor go-live. Als je agent consequent aan de evaluatiecriteria voldoet en de platformmetrics zijn gestabiliseerd, kun je met vertrouwen naar productie gaan. Zonder gedefinieerde criteria is go-live een inschatting.
- Wat zijn de afwegingen tussen prestaties en controle, en wat is in deze fase belangrijker? Hoe meer autonomie een agent krijgt, hoe natuurlijker en flexibeler de interacties worden, maar ook hoe groter het risico dat de agent buiten gevalideerde grenzen opereert. Strakkere controle via begrensde prompting en strengere escalatielogica verkleint dat risico, maar kan de agent star laten aanvoelen. Geen van beide uitersten is juist. Organisaties die te vroeg alles vastzetten, eindigen met een opgehemeld IVR-systeem. Organisaties die te snel gaan voordat ze vertrouwen hebben opgebouwd, creëren supportlasten die zwaarder wegen dan de voordelen. Inzicht in de stand van deze knop in elke volwassenheidsfase bepaalt de modelconfiguratie, escalatielogica en hoeveel kennis van de agent in de prompt staat versus in opgehaalde of gestructureerde bronnen.
Met deze vragen beantwoord is een organisatie klaar om van strategie naar uitvoering te gaan en de bouw af te bakenen.
De eerste bouwfase onderbouwen
Bij de overgang naar uitvoering kunnen teams terugvallen op methodologieën die bijna zo oud zijn als software zelf. Test Driven Development (TDD) biedt de structuur om agents tijdens het hele bouwproces te laten aansluiten op de kernmetrics.
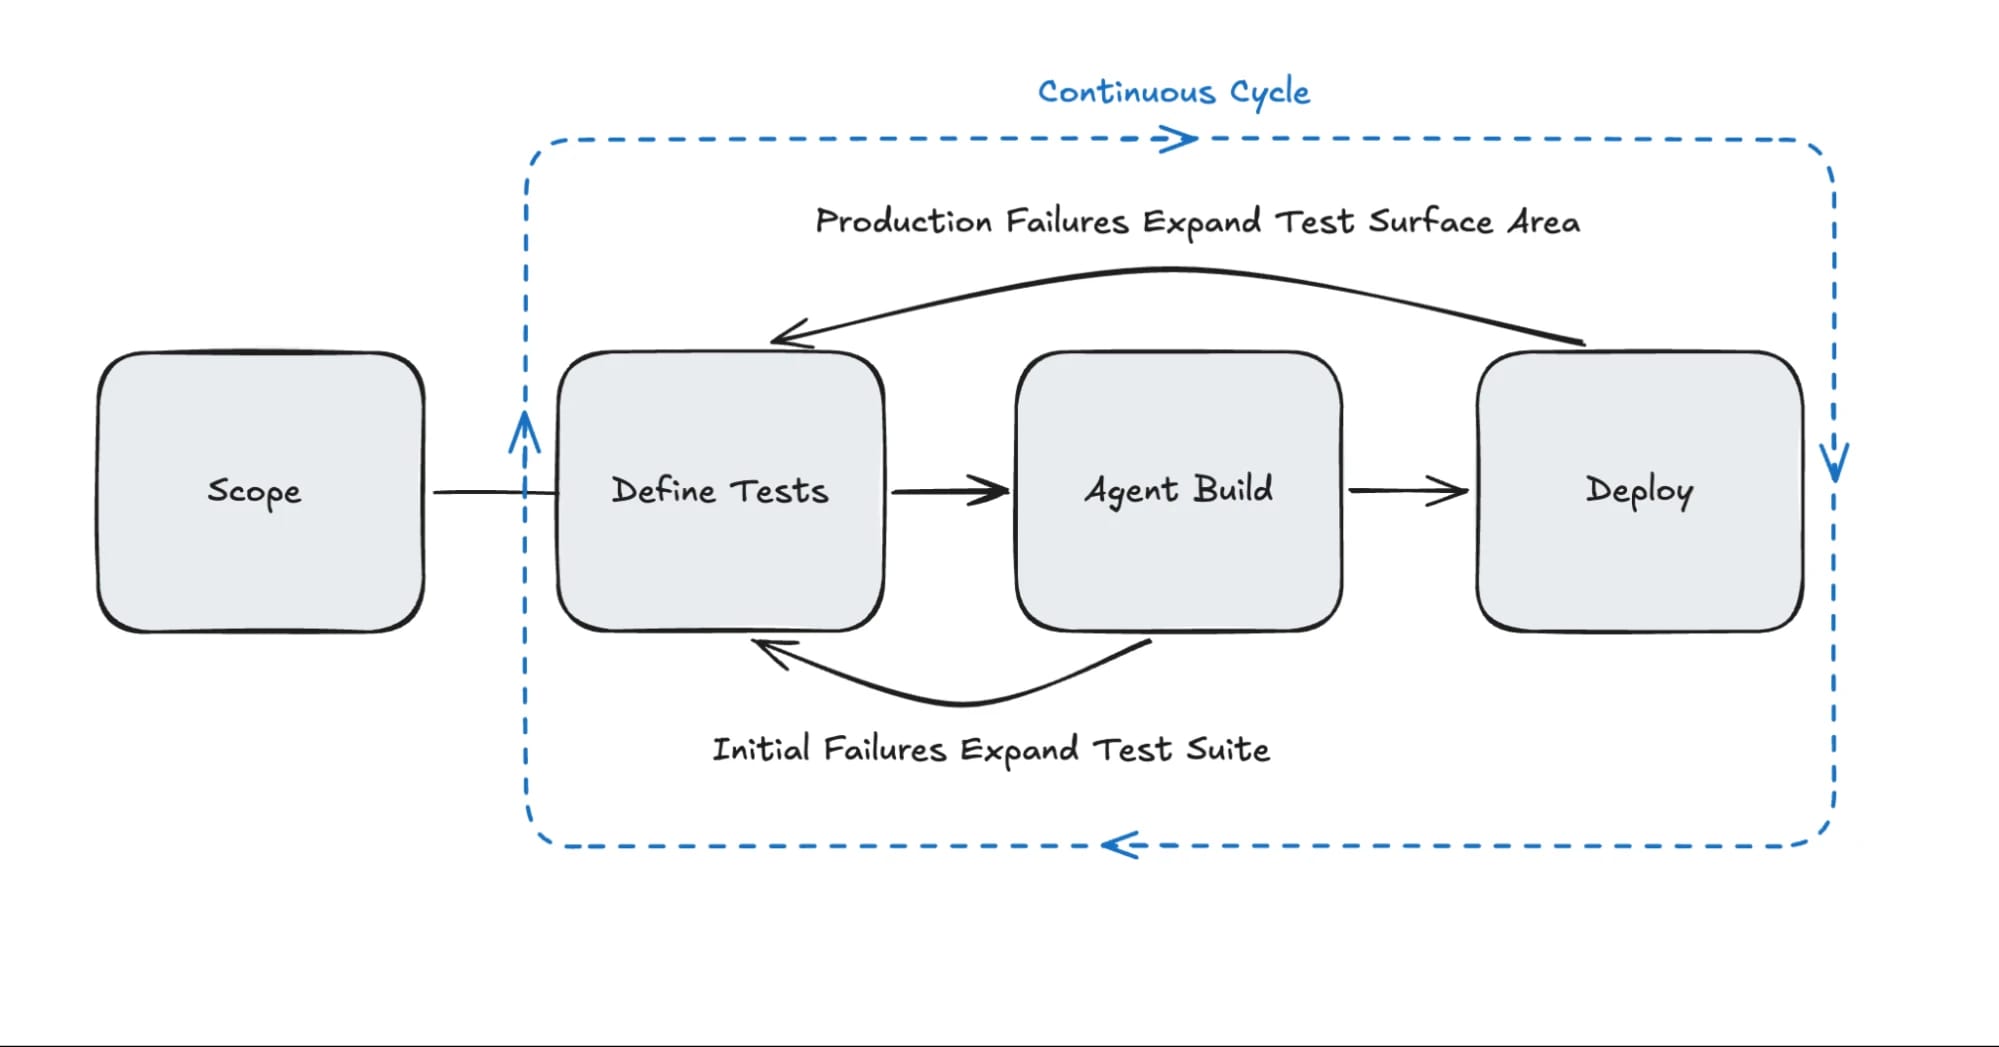
Concreet moeten ontwikkelteams en zakelijke stakeholders samen twee fundamentele artefacten definiëren en opbouwen: Succes-evaluatiecriteria, die vastleggen hoe goed eruitziet, zowel op het niveau van afzonderlijke gesprekken als op geaggregeerd niveau, en Agenttests, die herhaaldelijk specifiek gedrag verifiëren dat de agent naar verwachting moet vertonen. De eerste worden het best geïnformeerd door echte gesprekken met menselijke agents te beoordelen zodra die beschikbaar zijn. De tweede worden stapsgewijs opgebouwd, beginnend met een eerste set verwacht gedrag en uitgebreid zodra nieuw gedrag wordt toegevoegd en edge cases worden ontdekt.
Met een eerste set tests begint de ontwikkeling van de agent bij de system prompt. Hier worden de regels, toon en aanpak van de agent bepaald: wat de agent wel en niet moet doen, en hoe die zich aan de randen van zijn rol moet gedragen. Een goed opgestelde system prompt draait evenveel om structuur als om inhoud. Instructies in duidelijk gelabelde secties scheiden, gerelateerde richtlijnen bij elkaar houden en voorwaardelijke formuleringen vermijden, maken allemaal een wezenlijk verschil in hoe consistent de agent zich gedraagt. In deze fase grijpen we vaak terug op de promptinggids.
Naast de system prompt worden de kerncomponenten van de agent geconfigureerd: de LLM, het text-to-speech-model (TTS) en de stem. De keuze voor een LLM is vooral een afweging tussen latency en prestaties: modellen die zijn geoptimaliseerd voor snelheid leveren doorgaans wat redeneervermogen in, en andersom. Voor TTS hangt de juiste keuze af van wat de use case het meest vereist: expressieve weergave, lage latency of ondersteuning voor meerdere talen. De stem is echter evenzeer een merkbeslissing als een technische beslissing. De stem bepaalt hoe een organisatie op elke beller overkomt en is daarmee een van de weinige configuratiebeslissingen die evenzeer bij merk- en marketingteams hoort als bij de engineers die de agent bouwen. Daardoor kan de stemkeuze parallel aan de rest van het ontwikkelproces plaatsvinden, in plaats van een knelpunt aan het begin of einde te worden. ElevenAgents biedt toegang tot meer dan 10.000 stemmen, en als daar geen passende stem bij zit, kunnen teams er zelf een klonen of maken.
Van hieruit kunnen agents optioneel worden uitgebreid met een Knowledge Base, tools en kanaalconfiguraties. Elke toevoeging biedt nieuwe mogelijkheden, maar introduceert ook nieuwe onderdelen om te testen. Of het nu gaat om telefonie-integratie, toegang tot externe databases of de mogelijkheid om namens een klant actie te ondernemen: het is verstandig deze beslissingen aan de evaluatiecriteria te toetsen voordat je het bereik uitbreidt. Wanneer tools worden toegevoegd, geven de system prompt en toolbeschrijving expliciete richtlijnen over wanneer en hoe je elke tool aanroept, zodat de agent ze consistent en in de juiste context gebruikt.
Met deze fundamenten is de agent klaar om te worden getest.
Op weg naar productiegereedheid
Nu de tests en evaluatiecriteria uit de onderbouwingsfase worden uitgevoerd op een gebouwde agent, wordt ontwikkeling een korte cyclus: voeg meer tests toe, identificeer fouten, werk de system prompt of configuratie bij en voer opnieuw uit. De meeste fouten in deze fase zijn geen modelfouten, maar promptfouten. Een instructie die op zichzelf duidelijk leek, blijkt dubbelzinnig wanneer de agent deze midden in een gesprek tegenkomt. Er komen edge cases naar boven waarop de eerste testsuite niet was voorbereid. Elk daarvan wordt een nieuwe Next Turn-test die vanuit het gesprek zelf kan worden gemaakt. De vraag wanneer je moet stoppen met itereren heeft een concreet antwoord: wanneer de agent bij meerdere uitvoeringen consequent aan de evaluatiecriteria voldoet en platformmetrics zoals het taakvoltooiingspercentage en escalatiepercentage binnen acceptabele bandbreedtes zijn gestabiliseerd. Daarom is het zo belangrijk om deze criteria vóór de bouw te definiëren. Zonder die criteria is gereedheid een inschatting en verschuift de finishlijn voortdurend.
In de praktijk merken de meeste teams dat een kleine set terugkerende foutpatronen het merendeel van de problemen veroorzaakt. De meest voorkomende zijn ambiguïteit in de prompt, waarbij de agent tegenstrijdige of onvoldoende gespecificeerde instructies krijgt en terugvalt op onvoorspelbaar gedrag; verkeerd gebruik van tools, waarbij de agent een tool in de verkeerde context aanroept of nalaat die aan te roepen wanneer dat wel nodig is; en escalatiedrift, waarbij de agent te agressief escaleert of gesprekken vasthoudt die hadden moeten worden overgedragen. Voor elk van deze problemen bestaat een oplossing op promptniveau. De relevante instructie aanscherpen, een expliciet voorbeeld toevoegen of de escalatiedrempel aanpassen is meestal voldoende. Het risico zit in het niet opmerken ervan vóór go-live.
Teams maken deze fout het vaakst door een geslaagde testsuite als garantie te zien in plaats van als signaal. Een suite die alleen het ideale verloop afdekt, slaagt gemakkelijk en zegt weinig. Dekking van weigeringen, koerswijzigingen midden in gesprekken, dubbelzinnige invoer en interacties met veel tools geeft de resultaten waarde. Ook missen teams die simulatietests overslaan en alleen vertrouwen op tests op turnniveau een categorie fouten die alleen tijdens een volledig gesprek zichtbaar wordt, zoals contextdrift, waarbij de agent eerdere turns uit het oog verliest, of opstapelende fouten, waarbij een kleine misstap vroeg in het gesprek tot een slechte uitkomst leidt. Zodra terugkerende foutpatronen zijn opgelost en de agent de lange staart aan edge cases netjes afhandelt, in plaats van perfect, neemt de marginale waarde van verdere iteratie in staging af. Dan komt het waardevollere signaal uit echte gesprekken.
Go-live betekent niet dat de iteratie voorbij is. Het betekent dat het leren verschuift van synthetische tests naar transcripten uit productie. De evaluatiecriteria die go-live bepaalden, worden de basislijn waartegen live prestaties worden gemeten, en de cyclus gaat vanaf daar verder.
Feedbackloops, evaluatie en weten wanneer je moet stoppen met itereren
Zodra tests zijn gedefinieerd en worden uitgevoerd, worden gaten in de pipeline snel zichtbaar. Via Gespreksanalyse kunnen teams precies vaststellen op welk moment een interactie verkeerd ging en dat signaal gebruiken om een nieuwe test te maken en te bepalen wat er moet veranderen. De meest voorkomende ingrepen zijn op promptniveau: beschrijvingen van tool calls aanscherpen, explicietere instructies voor edge cases toevoegen of escalatievoorwaarden verduidelijken die in de praktijk dubbelzinnig bleken. Soms zit het probleem dieper en moet de onderliggende modelconfiguratie opnieuw worden bekeken als de latency of redeneerkwaliteit tekortschiet voor wat de use case vereist.
De belangrijkste discipline in deze fase is veranderingen valideren in plaats van ervan uitgaan dat ze werken. Een oplossing die één fout verhelpt, kan ongemerkt een andere introduceren. ElevenAgents ondersteunt versiebeheer, zodat teams nieuwe iteraties kunnen testen bij een klein percentage van de gebruikers voordat ze worden uitgerold naar de bredere populatie. Zo kun je bevestigen dat verbeteringen de resultaten daadwerkelijk verbeteren, in plaats van de foutmodus naar een andere plek te verplaatsen.
Wat kan er misgaan
De fout met de grootste gevolgen in deze fase is het overslaan van gefaseerde roll-outs per vertakking en wijzigingen rechtstreeks doorvoeren voor de volledige gebruikerspopulatie. Zonder gefaseerde roll-outs kun je de impact van een specifieke wijziging niet isoleren, en op schaal is het daardoor bijna onmogelijk om te begrijpen wat verbeteringen of regressies in je platformmetrics daadwerkelijk veroorzaakt. De volledige gebruikersbasis als testomgeving behandelen is niet alleen riskant; het neemt ook de observability weg die je nodig hebt om met vertrouwen vervolgbeslissingen te nemen.
Naast de roll-outstrategie zijn er nog twee andere foutmodi waarvoor je moet waken. De eerste is te veel gewicht toekennen aan recente fouten. Wanneer een opvallend gesprek misgaat, ontstaat vanzelf de neiging om het onmiddellijk en breed te patchen. Maar reactieve promptwijzigingen die worden doorgevoerd zonder de volledige testsuite uit te voeren, veroorzaken vaak regressies in gedrag dat eerder stabiel was. Elke wijziging, hoe klein ook, moet als een nieuwe iteratie worden behandeld en dienovereenkomstig worden getest. De tweede is evaluatiedrift. Na verloop van tijd kunnen teams onbewust de lat verlagen voor wat als een geslaagde test geldt, vooral onder druk om te releasen. De evaluatiecriteria die tijdens de afbakening zijn gedefinieerd, moeten het anker blijven. Als ze te streng beginnen te voelen, is de juiste reactie om ze opnieuw te bekijken en bewust bij te werken, niet om de normen informeel te laten afbrokkelen.
Met vertrouwen opschalen
Meer traffic toelaten is een vertrouwensbeslissing, geen tijdsgebonden beslissing. Het signaal om uit te breiden is dat de agent bij meerdere testuitvoeringen consequent aan de evaluatiecriteria voldoet, de platformmetrics zijn gestabiliseerd en gefaseerde roll-outs per vertakking geen wezenlijke regressie ten opzichte van de controlegroep hebben laten zien.
Een veelgestelde vraag in deze fase is hoeveel traffic voldoende is om een conclusie te trekken. Batches met minder dan 100 gesprekken per vertakking leveren te veel variatie op om uitkomsten betrouwbaar te beoordelen. Een slagingspercentage van 60% bij 25 gesprekken en een slagingspercentage van 60% bij 100 gesprekken vertegenwoordigen heel verschillende niveaus van vertrouwen. Naast een vastgesteld aantal moet de batch ook groot genoeg zijn om het volledige bereik aan realistische invoer bloot te leggen, waaronder waarschijnlijke edge cases, minder voorkomende intenties en foutmodi die alleen bij volume optreden en zelden in kleine steekproeven voorkomen.
Meer traffic versterkt zowel wat werkt als wat niet werkt. Uitbreiden voordat de belangrijkste foutpatronen zijn aangepakt, creëert een supportlast die moeilijk terug te draaien is.
Herhaal het proces
Weten waar je moet stoppen is net zo belangrijk als weten wat je moet oplossen. Iteratie heeft afnemende opbrengsten, en het juiste signaal om te pauzeren is wanneer de agent consequent voldoet aan de evaluatiecriteria die tijdens de afbakening zijn vastgesteld. Op dat moment brengen verdere wijzigingen meer risico dan voordeel met zich mee.
Hoe "consequent aan criteria voldoen" eruitziet, verschilt per context. Teams met beperkte toegang tot data of onvolledige integraties kunnen merken dat escalatiepercentages rond de 50% een realistische bovengrens zijn totdat die beperkingen zijn opgelost. Waar de toegang tot data goed is, streven de best presterende implementaties doorgaans naar taakvoltooiing boven 80% en escalatie onder 20%. Belangrijker dan een afzonderlijk getal is stabiliteit: consistente prestaties gedurende meerdere weken traffic in productie, zonder wezenlijke regressie tussen testuitvoeringen, is het echte signaal. Wanneer de marginale winst van de volgende iteratie kleiner is dan het risico op regressie, is het tijd om te stoppen.
Dat betekent niet dat het werk klaar is. Wanneer er nieuwe vereisten ontstaan, begint het proces opnieuw vanaf het begin. De afbakeningsvragen uit de eerste bouwfase blijven voor de tweede even relevant. Het verschil is dat teams die aan een tweede cyclus beginnen, dat doen met een testsuite, een evaluatiebasislijn en operationele ervaring die de eerste cyclus vanaf nul moest opbouwen. Dat cumulatieve voordeel onderscheidt organisaties die blijvende waarde halen uit stemagents van organisaties die vast blijven zitten in een proof of concept.
Conclusie
De teams die we de kloof tussen afwending en oplossing hebben zien dichten, zijn de teams die definiëren hoe goed eruitziet voordat ze beginnen met bouwen, discipline houden tijdens de iteratiecyclus en elke implementatie behandelen als de basis voor de volgende. Conversationele agents zijn geen eenmalige implementatie: echte gesprekken brengen edge cases aan het licht die geen enkele testsuite volledig voorziet, en het verbeterwerk stopt niet bij go-live.
ElevenAgents is rond deze realiteit gebouwd. Agent Testing, Conversation Analysis en gefaseerde roll-outs per vertakking vormen de basis die een proof of concept verandert in een systeem dat klantproblemen op schaal daadwerkelijk oplost, in plaats van ze alleen af te wenden. Dat is de kloof die het waard is om te dichten.
Nicolas works on the Forward Deployed Engineering team at ElevenLabs partnering with customers to bring their agents to production. He previously spent four years at AWS focusing on regulated industries and the public sector.


