Stream、ElevenLabsでマルチモーダルAIエージェントを構築
- 公開日
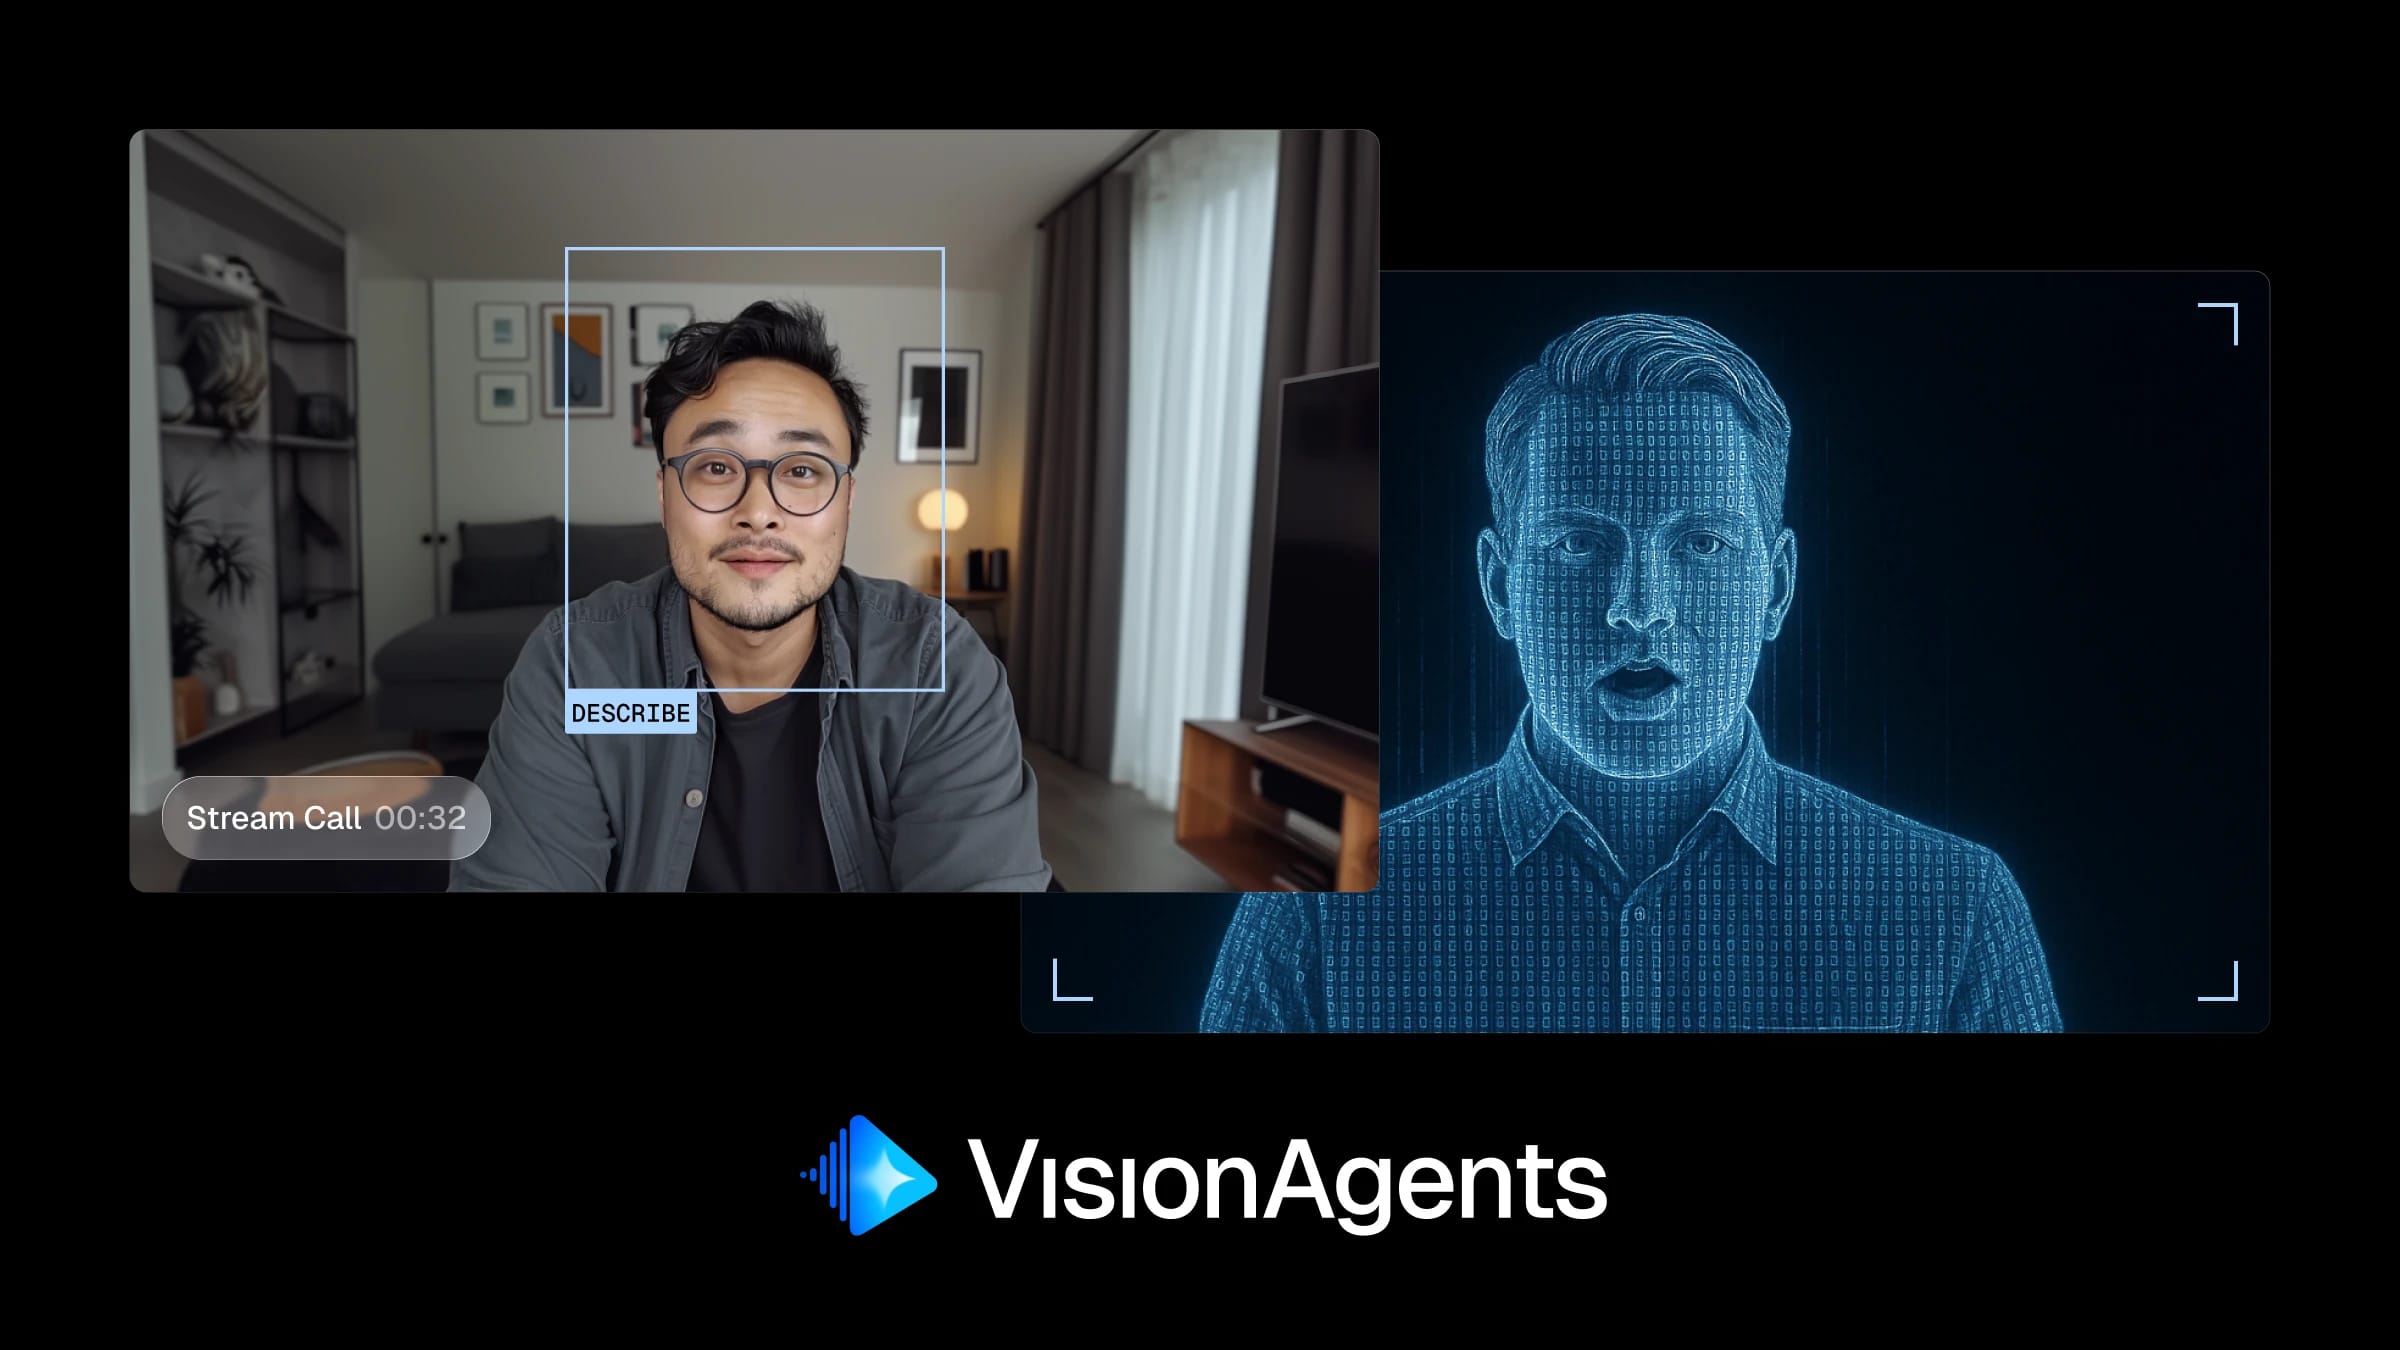
Streamは、リアルタイムのビデオ、オーディオ、会話を組み合わせた低遅延のマルチモーダルAI体験を構築できるオープンソースフレームワーク、Vision Agentsを発表しました。このフレームワークには ElevenLabsのテキスト読み上げが統合されており、表現力と応答性に優れた音声により、ユーザーとAIシステムのシームレスなやり取りを実現します。
リアルタイムのマルチモーダルエージェントを実現
Vision Agentsにより、AIはリアルタイムで見て、聞いて、応答できるようになります。StreamのビデオおよびオーディオSDKを基盤とするこのフレームワークは、マルチモーダルエージェント体験のプロトタイプ作成とデプロイに必要な、低遅延の基盤を提供します。
テキスト読み上げプロバイダーを検討する中で、Streamは業界最高水準の品質と統合のしやすさからElevenLabsを選びました。現在、ElevenLabsはStreamユーザー向けの主要な音声オプションとなっています。
「ElevenLabsのおかげで、強力なテキスト読み上げ機能をSDKへ短期間で簡単に導入できました。これにより、エージェントはユーザーからの質問や、見ているものへのフィードバックとして、表現豊かな音声でリアルタイムに応答できます」― Stream マーケティングディレクター、Neevash Ramdial
高速で信頼性が高く、デベロッパーに使いやすい統合
Streamはわずか数日でコードベース全体にElevenLabsを統合し、デベロッパーが最小限の設定でVision Agentsに自然な音声出力を追加できるようにしました。この統合により、次のメリットが得られます。
- セットアップを10倍高速化 — ElevenLabsとの事前統合により、音声のセットアップに必要なコードが400行からわずか40行に減り、所要時間を10分の1に短縮します。
- 低遅延のパフォーマンス — ElevenLabsの高速な音声生成とStreamのグローバルエッジネットワークを組み合わせることで、人との会話のように自然な応答性を実現します。
- スケーラブルな開発体験 — StreamのSDKにより、マルチモーダルエージェントの作成、テスト、デプロイがより簡単になります。
マルチモーダルAIの未来を築く
StreamのVision Agentsは、ElevenLabsのモデルがマルチモーダルAIの可能性をどのように広げているかを示しています。視覚的な理解とテキスト読み上げを組み合わせることで、見るだけでなく、人間に近い流暢さで話し、聞くエージェントを構築できます。
テキスト読み上げを活用した開発をご検討ですか?こちらからお問い合わせください。