Come risolvere i problemi di accuratezza del Text to Speech
- Scritto da
- Jack Limebear
- Pubblicato
AscoltaAscolta questo articolo
Sebbene siano addestrati su enormi dataset vocali e possano produrre costantemente audio ad alta fedeltà, la maggior parte dei modelli di sintesi vocale (TTS) può comunque pronunciare male le parole o presentare altri problemi nel parlato. Le pronunce errate si verificano quando un motore TTS incontra parole e frasi che esulano dal linguaggio presente nel suo dataset di addestramento. Questo accade più spesso con il gergo di settore, i nomi dei brand o i nomi propri.
I motori TTS possono inoltre generare un parlato frettoloso, innaturale o robotico quando i passaggi di testo sono lunghi o la punteggiatura è pensata per la lettura anziché per essere pronunciata ad alta voce.
Potresti anche riscontrare alcuni problemi tecnici comuni nel collegare le tue applicazioni ai motori TTS tramite API.
In questo articolo analizzeremo queste tre categorie di problemi e i modi più comuni per risolverli.
In sintesi
- I problemi del Text to Speech rientrano generalmente nelle categorie delle pronunce vocali errate, del ritmo o della cadenza innaturali e degli errori tecnici di esecuzione delle API.
- Puoi correggere le pronunce errate in modo più efficace con dizionari Pronunciation Lexicon Specification (PLS) conformi allo standard W3C oppure modificarle singolarmente usando tag fonetici in linea nei tuoi script.
- Puoi contribuire a controllare la naturalezza dell'output vocale formattando e punteggiando correttamente lo script. Il testo formattato per essere pronunciato è spesso diverso da quello pensato esclusivamente per la lettura.
- Puoi diagnosticare gli errori API tramite i codici di stato HTTP standard.
- Testare in anticipo e isolatamente la pronuncia di nomi di brand, nomi propri e nuove espressioni può evitarti una lunga attività di troubleshooting in seguito.
Perché il Text to Speech non funziona?
I problemi del Text to Speech rientrano generalmente in tre categorie.
Tipi di problemi TTS
Pronunce errate
Il modello TTS legge in modo errato parole o frasi nuove, ad esempio il nome del tuo brand, gergo di settore, acronimi o omografi.
Resa e cadenza innaturali
Il parlato generato è monotono, si interrompe in punti insoliti o accelera nei passaggi che richiedono una resa più lenta.
Errori di integrazione e API
La tua applicazione non genera parlato per uno o più motivi tecnici, come ID voce mancanti, limiti di carico di lavoro o chiavi API non valide.
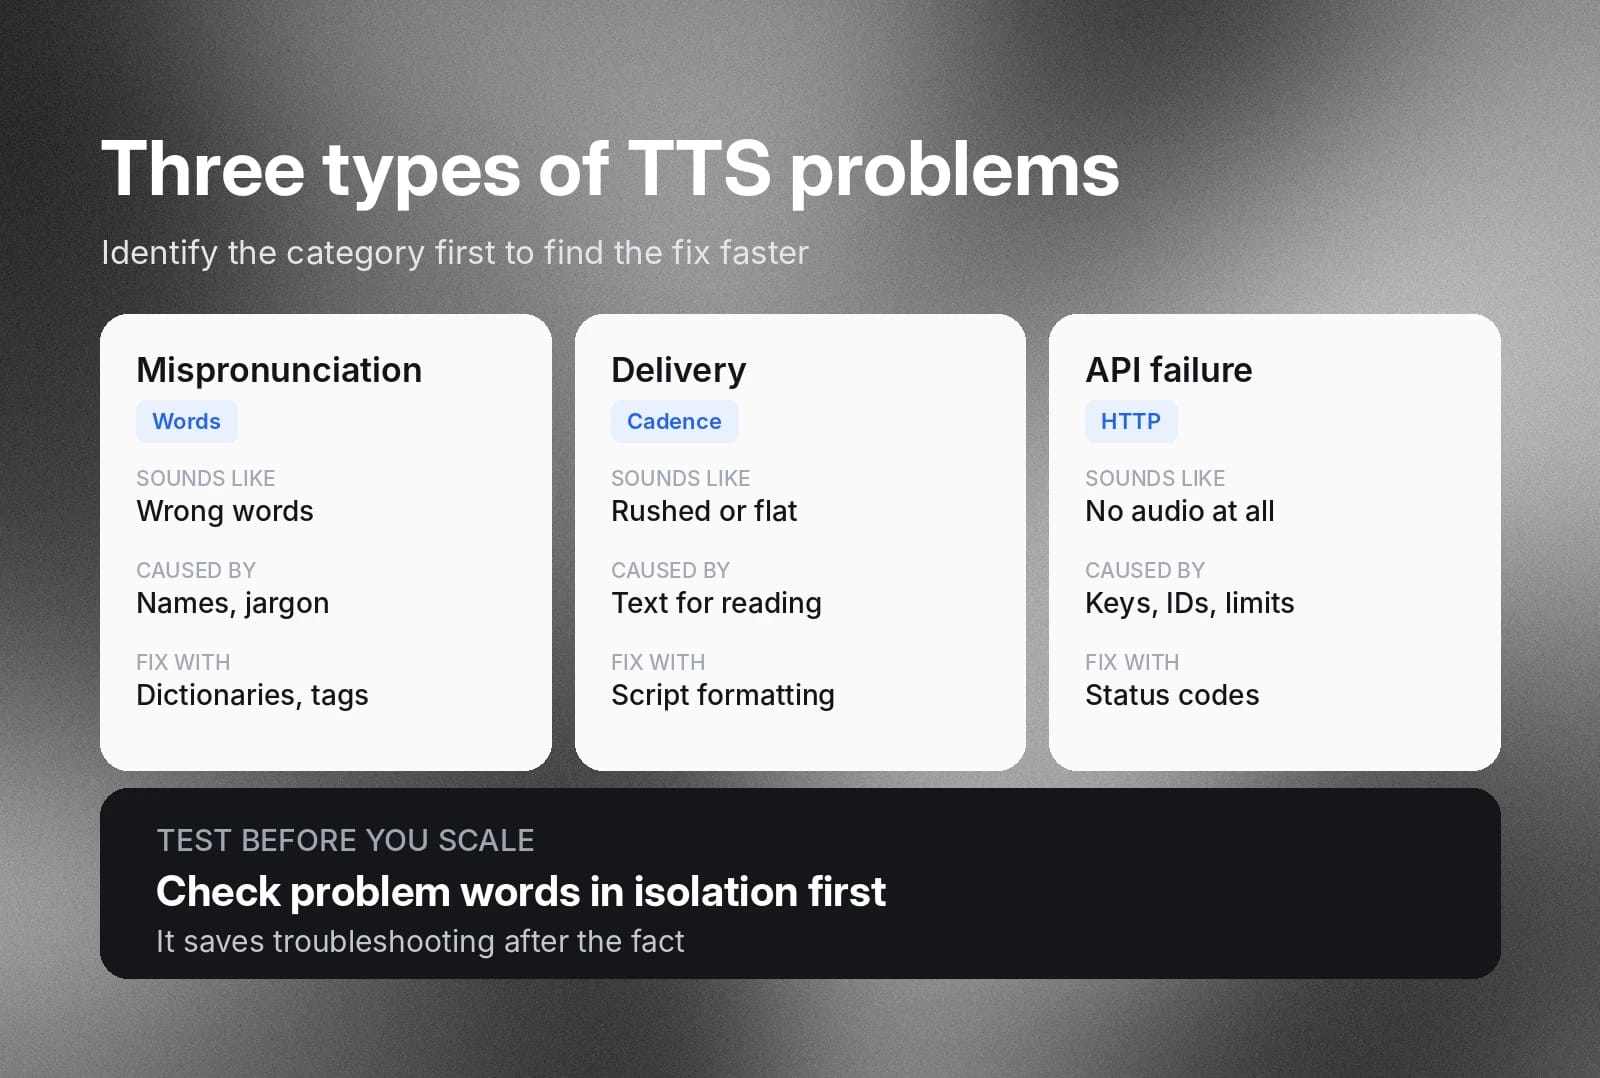
Questa guida analizza nel dettaglio ciascuno di questi tre problemi, così potrai capire esattamente quale problema di qualità dell'output o tecnico stai riscontrando. Comprenderli ti aiuterà a individuare più rapidamente la soluzione giusta.
Come risolvere i problemi di accuratezza del Text to Speech: pronunce errate e resa innaturale
Gli ingegneri addestrano i moderni modelli vocali neurali su enormi dataset di parlato. Sono in grado di generare un parlato naturale in combinazioni quasi infinite di parole. Tuttavia, nessun dataset di addestramento è universale. Esisteranno sempre pronunce in casi limite e parole o nomi propri poco comuni che il modello non pronuncerà correttamente.
Non accadrà spesso, ma chi usa regolarmente modelli TTS dovrebbe sapere come gestire questa situazione quando si verifica. Prima di tutto, è importante capire perché si verificano queste pronunce errate.
Cause principali comuni degli errori nel parlato
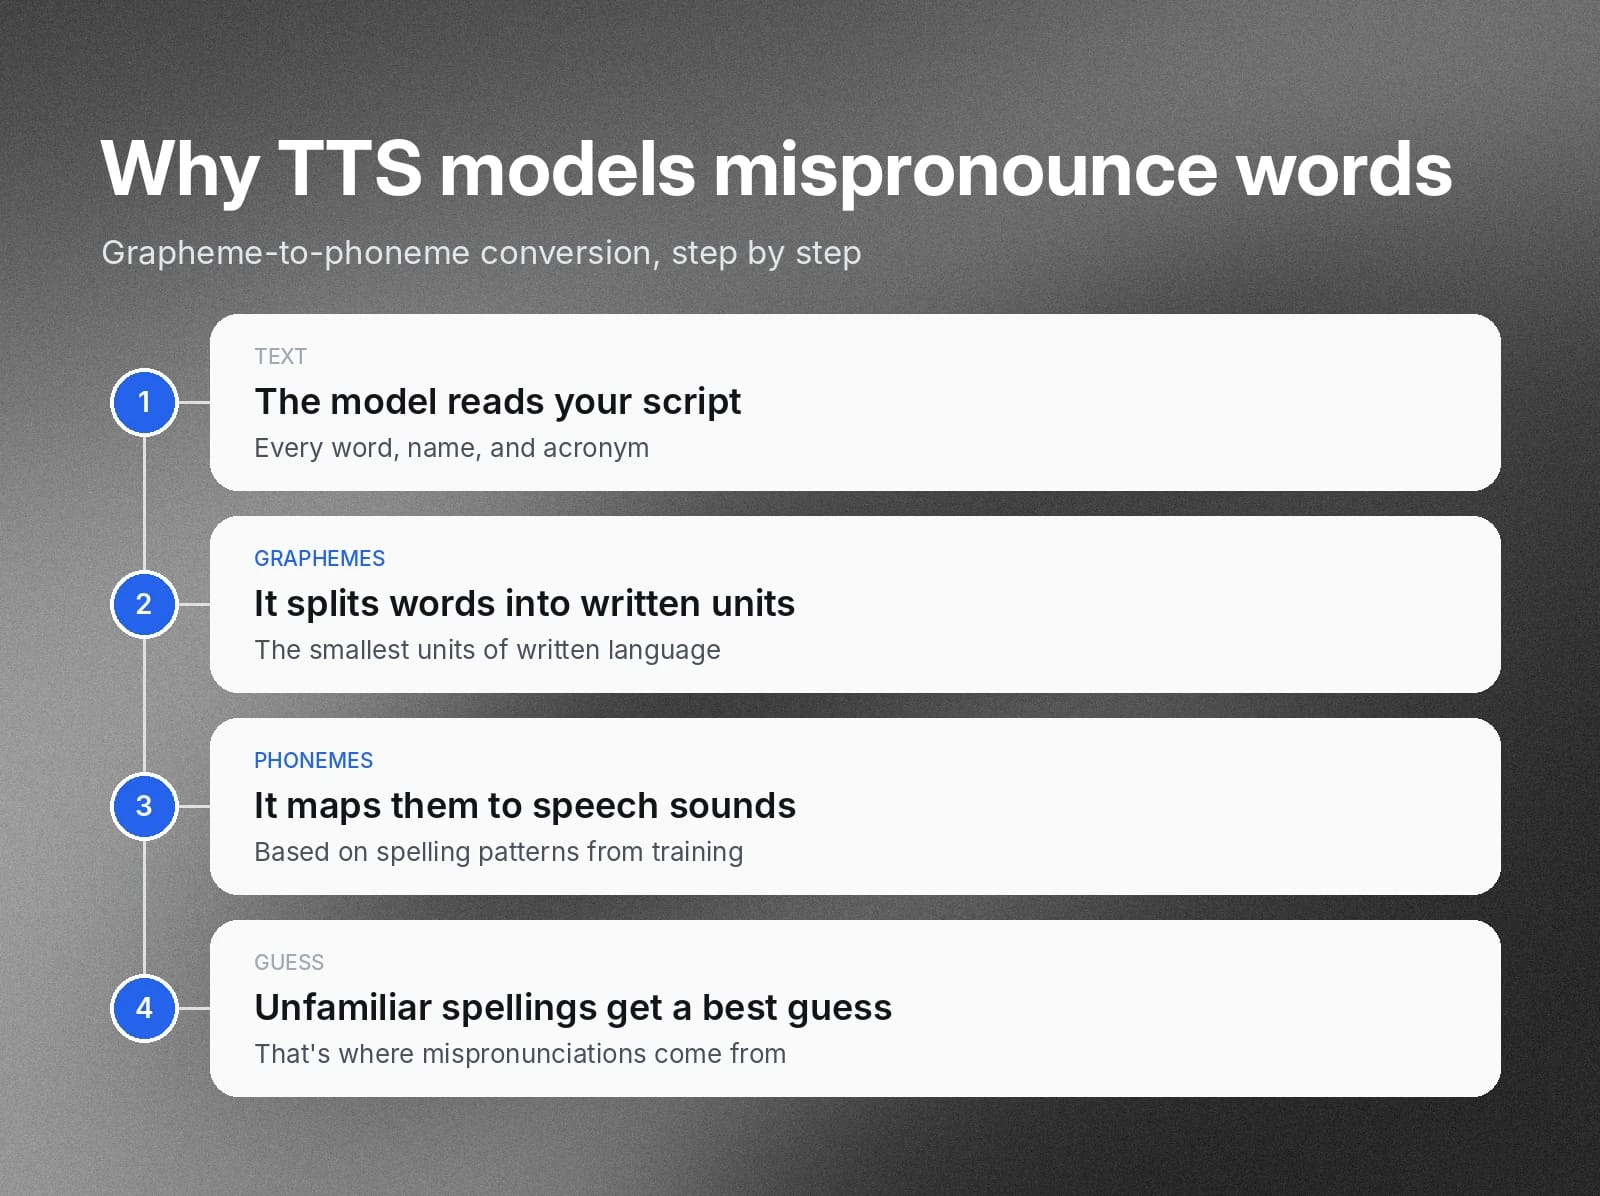
I modelli di sintesi vocale funzionano convertendo il testo in parlato tramite un processo chiamato conversione grafema-fonema (G2P). I fonemi sono le unità minime del suono parlato. I grafemi sono le unità minime del linguaggio scritto, in genere una lettera, che rappresentano un fonema.
Quando l'input di testo non corrisponde ai modelli ortografici incontrati dai modelli nei dati di addestramento, questi formulano la migliore ipotesi sulla pronuncia fonetica. Talvolta ciò porta a pronunce errate.
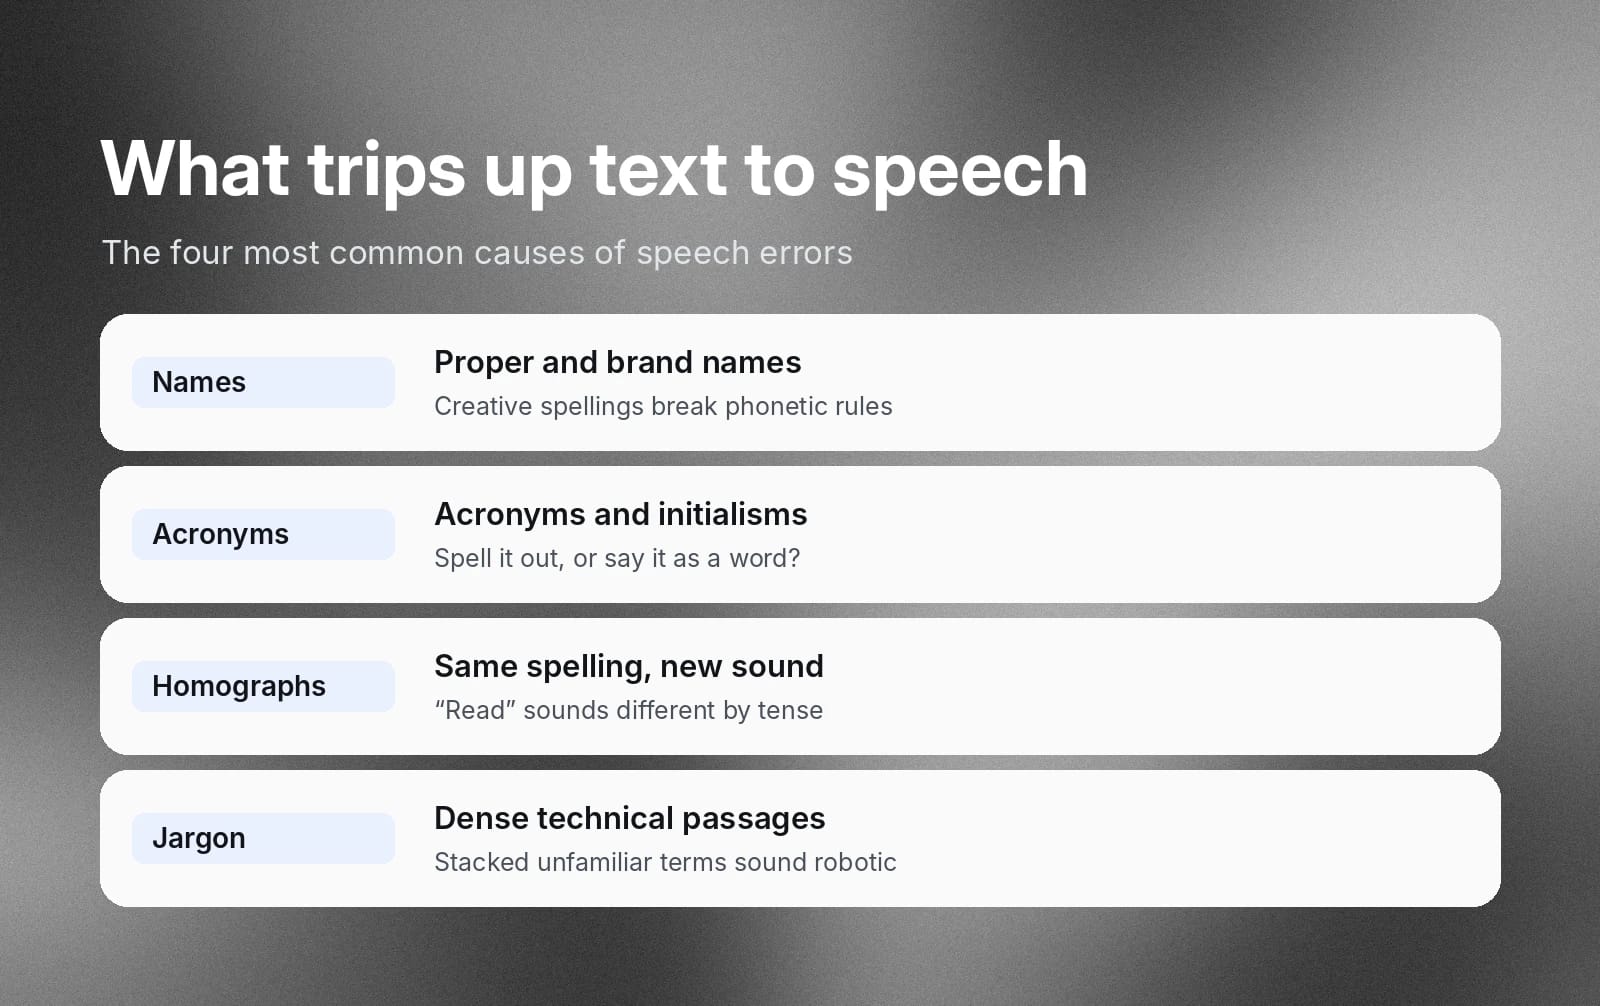
Nomi propri e nomi di brand
Le aziende usano spesso grafie creative per i nomi dei brand. Attirano l'attenzione, ma spesso confondono anche i modelli di sintesi vocale. Per lo stesso motivo, può accadere anche con nomi e cognomi creativi.
Quando un modello incontra un nome sconosciuto, cerca di applicare le regole fonetiche di base che ha appreso. Il parlato generato potrebbe essere molto diverso da quello desiderato.
Acronimi e sigle
Pensa all'acronimo NASA. Immagina di non averlo mai visto prima, proprio come potrebbe accadere a un modello vocale. Lo pronunceresti “N.A.S.A.” o “nasuh?” E un'API software? Sarebbe “A.P.I.” o “apee?” E se la tua azienda vendesse un nuovissimo strumento software con un nuovo acronimo? Puoi star certo che non è nei dati di addestramento di un modello vocale. Quindi, il modello dovrebbe indovinare come vuoi che venga pronunciato, a meno che tu non gli fornisca istruzioni personalizzate.
Omografi
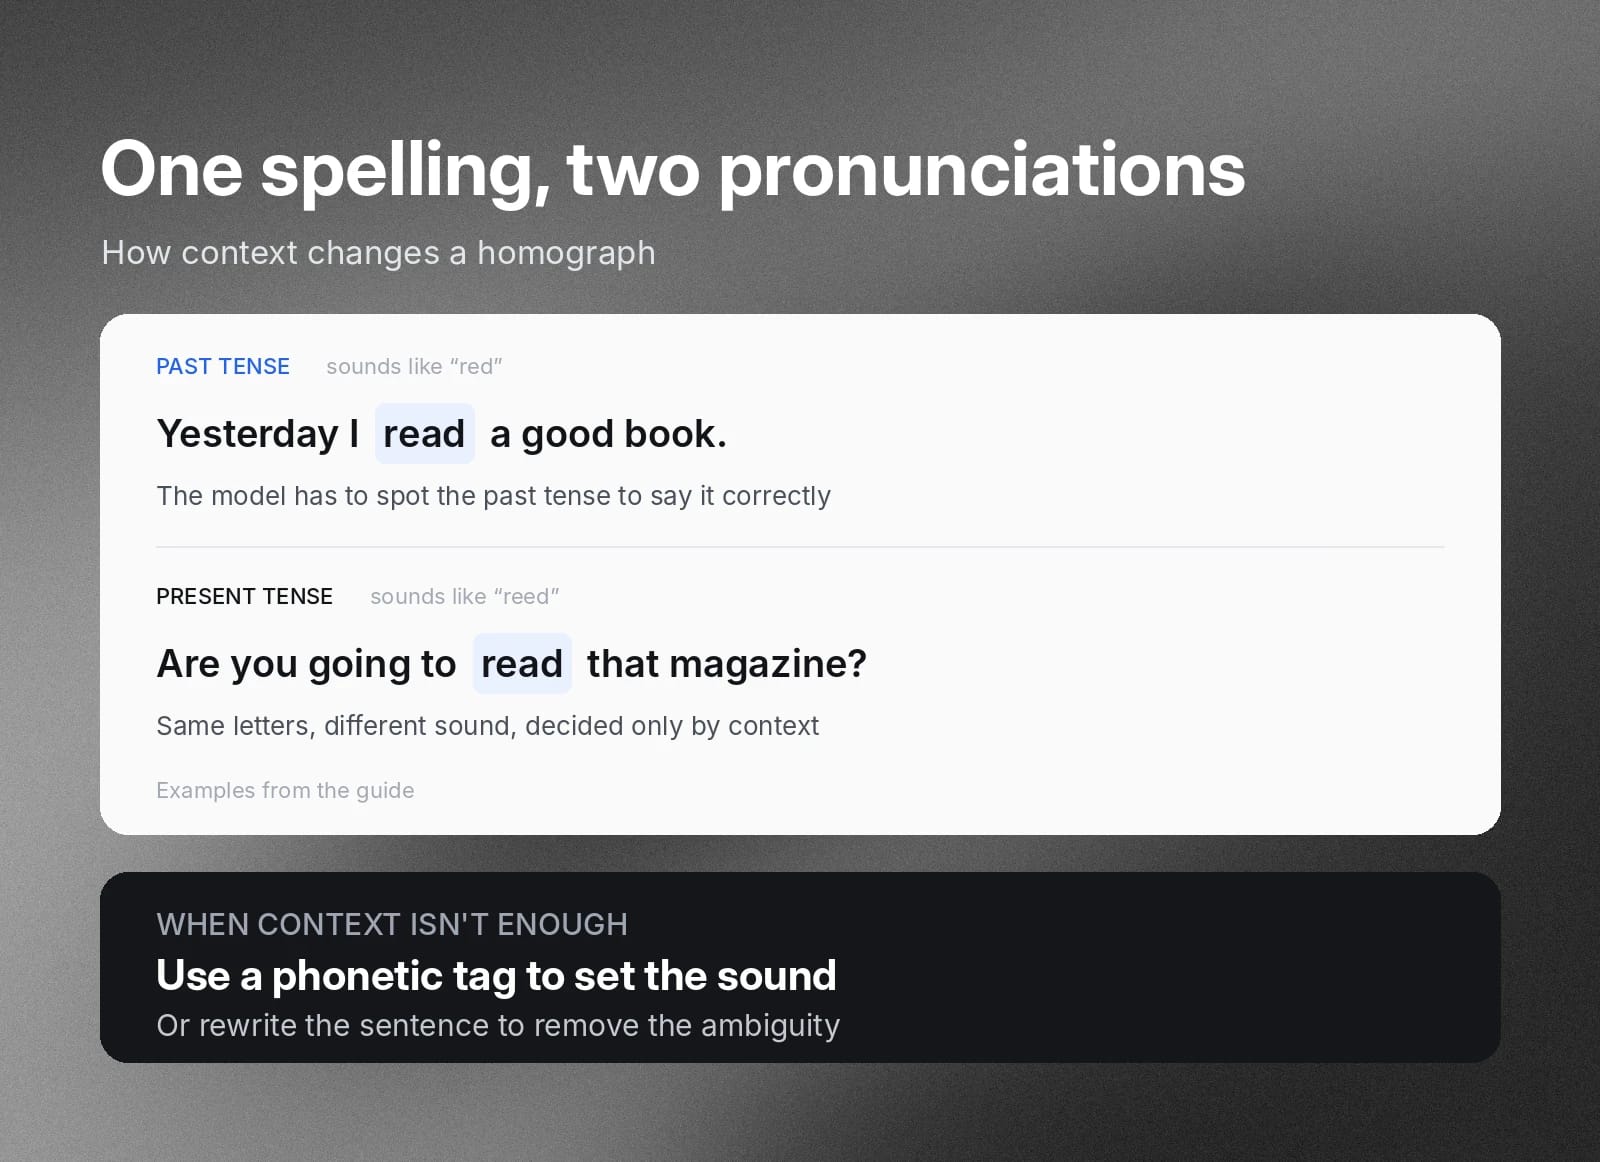
Gli omografi sono parole con la stessa grafia ma pronunce diverse a seconda del contesto. Per esempio, la parola inglese “read” si scrive nello stesso modo ma viene pronunciata diversamente al passato e al presente.
- “Ieri ho letto un buon libro.”
- “Leggerai quella rivista?”
Un modello vocale avrà bisogno di una comprensione contestuale sufficiente per stabilire come pronunciare gli omografi nel modo desiderato.
Schemi di accentazione innaturali
Lunghe frasi di gergo tecnico possono accumulare rapidamente parole poco comuni, pronunce specifiche e acronimi. Quello che da solo potrebbe essere un errore impercettibile può diventare rapidamente parte di un parlato piatto e robotico, mentre il modello cerca di interpretare molte parole e formulazioni sconosciute.
Due modi per controllare la pronuncia della voce
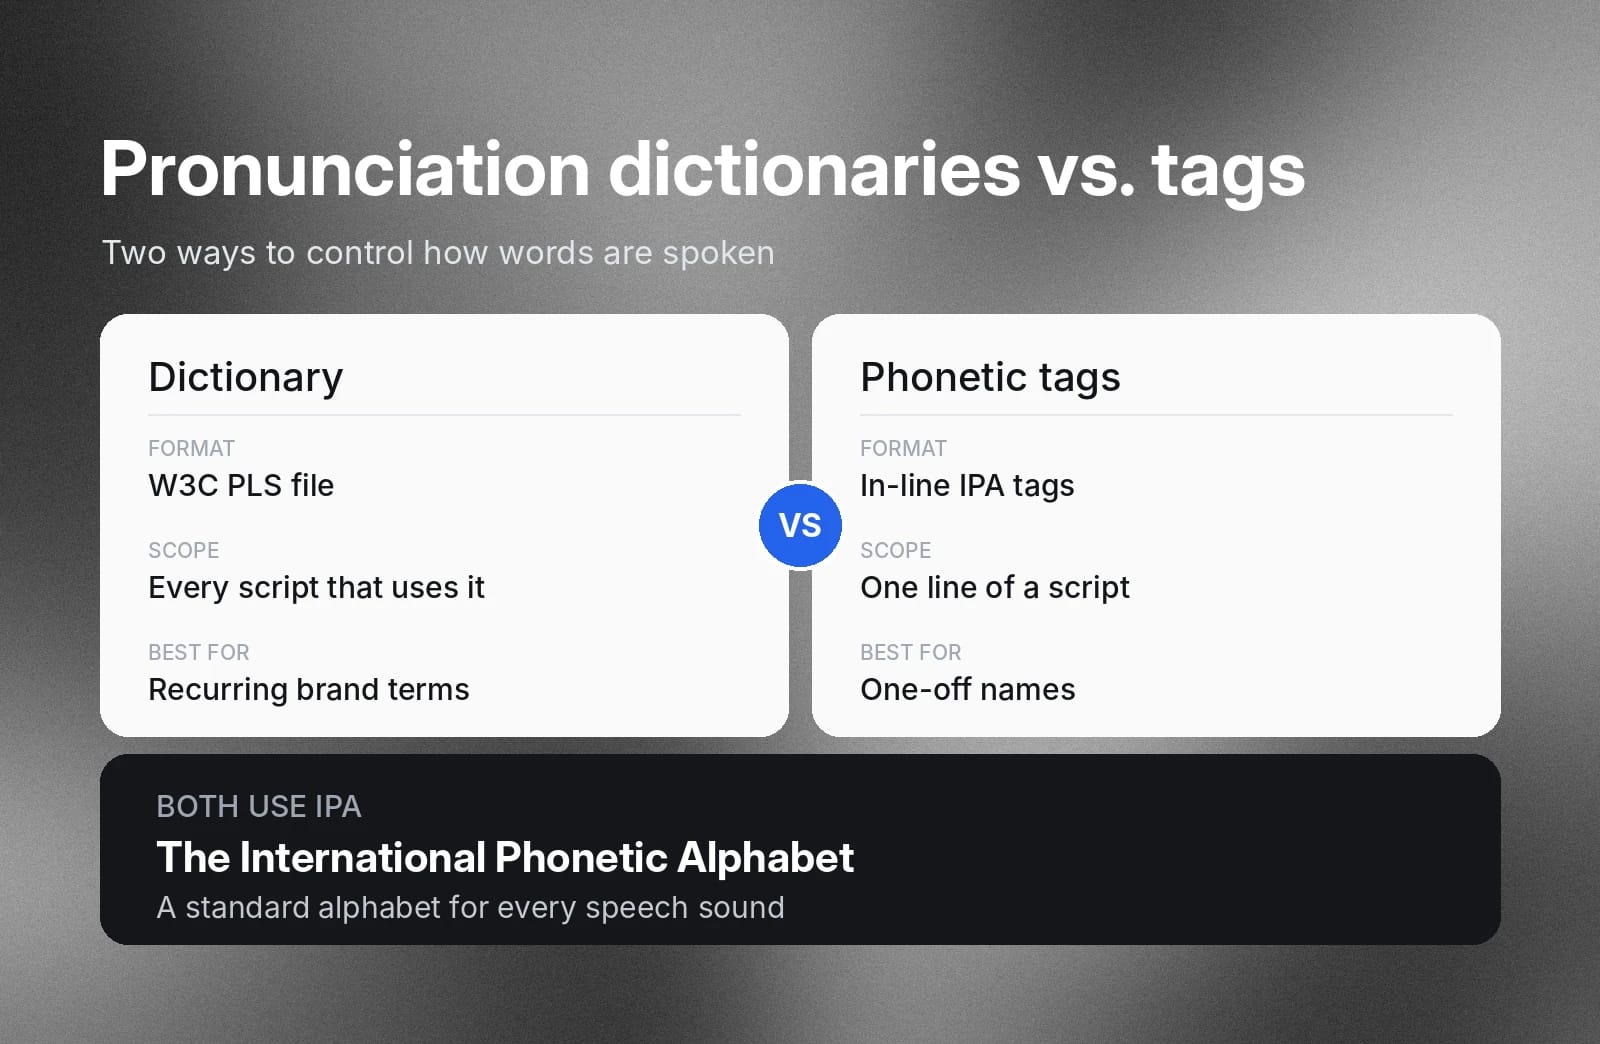
Non devi riscrivere completamente i tuoi script per evitare questi scenari. I moderni modelli vocali neurali includono due strumenti per risolverli in modo efficiente, caso per caso: dizionari di pronuncia e tag fonetici negli script.
Dizionari di pronuncia per il Text to Speech
I dizionari sono ideali quando disponi di un insieme di pronunce personalizzate che ricorrono regolarmente nei tuoi progetti TTS. Per esempio, se la tua azienda vende dispositivi medici e i tuoi script contengono regolarmente termini tecnici, procedure mediche e altri contenuti specifici del settore.
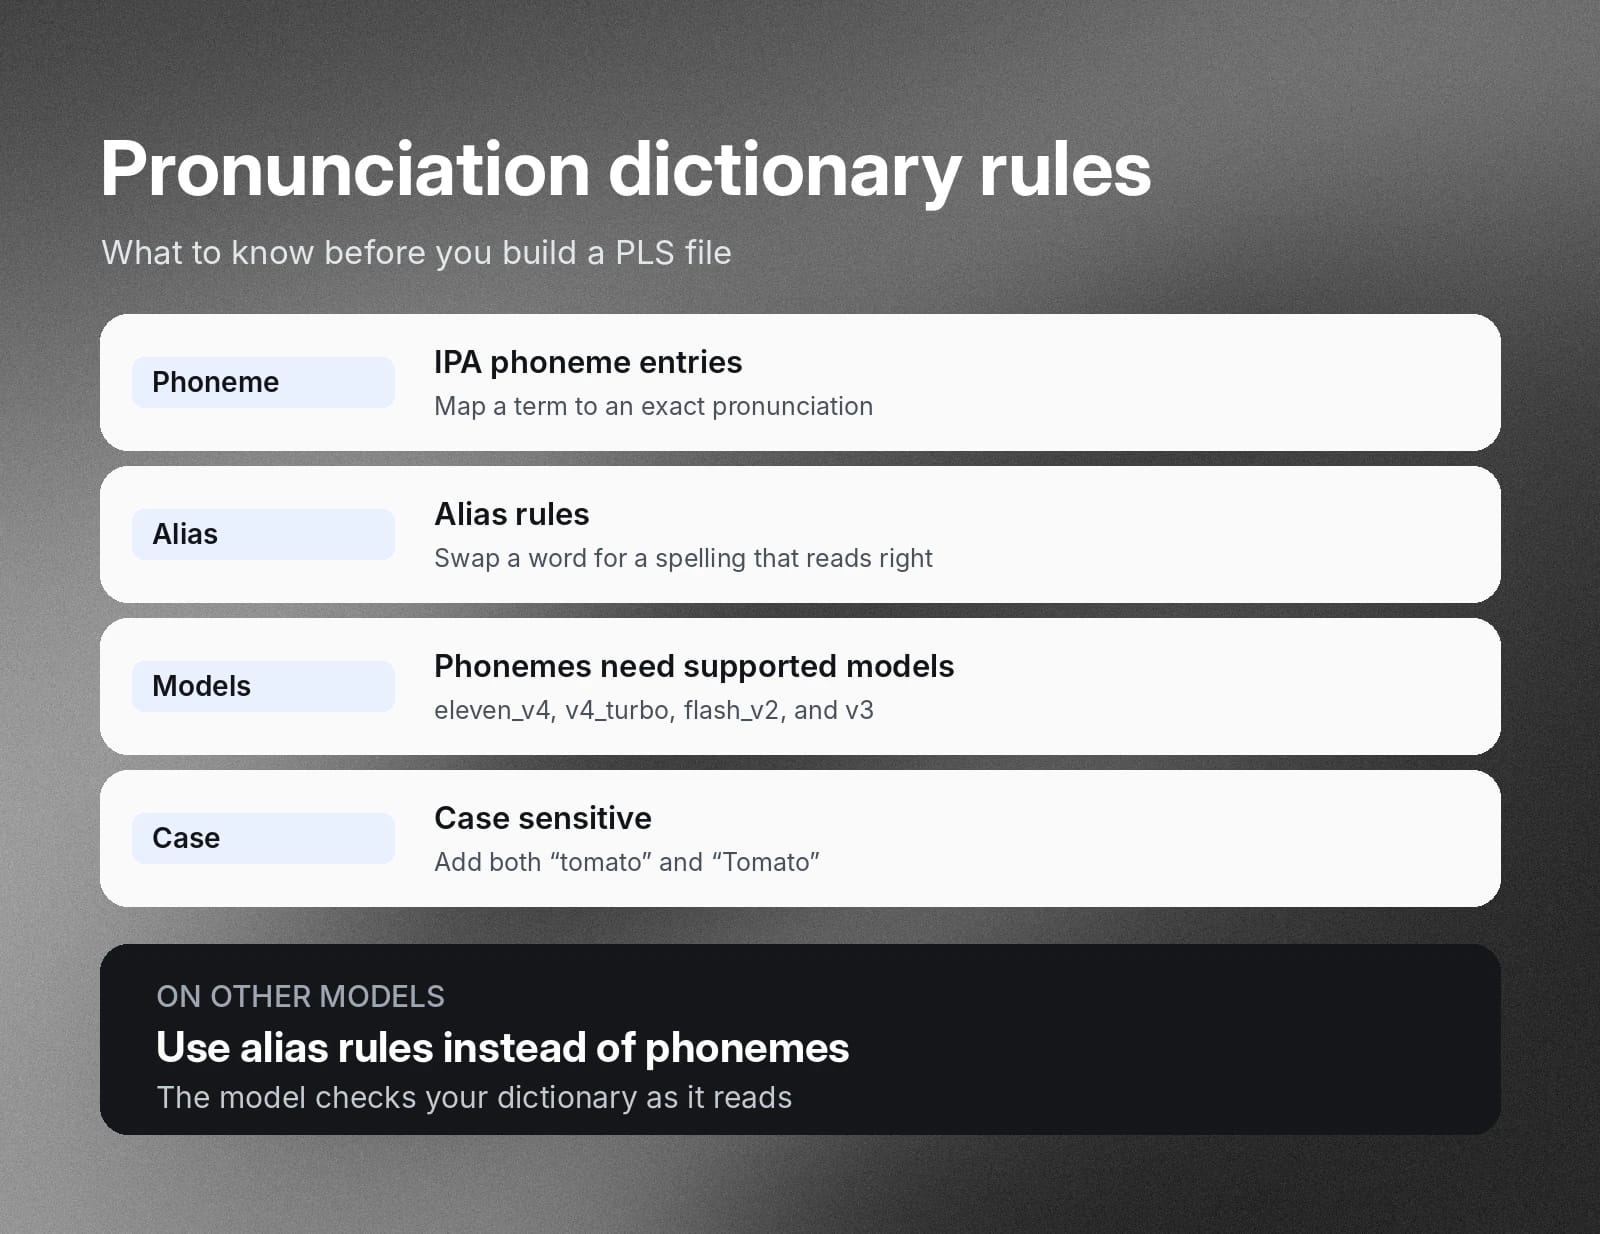
Il formato Pronunciation Lexicon Specification (PLS), standard W3C, offre una struttura per associare questi termini a specifiche pronunce fonetiche usando la notazione dell'Alfabeto Fonetico Internazionale (IPA). L'Alfabeto Fonetico Internazionale è un alfabeto standardizzato di tutti i possibili suoni del parlato. Il modello vocale consulta il tuo dizionario mentre legge lo script e fa riferimento alle pronunce elencate ogni volta che incontra parole presenti nel dizionario. Le voci di fonemi funzionano solo con i modelli eleven_v4, eleven_v4_turbo, eleven_flash_v2 ed eleven_v3. Sugli altri modelli, usa invece le regole alias. I file PLS distinguono tra maiuscole e minuscole, quindi aggiungi sia “tomato” sia “Tomato” se ti servono entrambi.
Tag fonetici negli script
I tag fonetici sono in genere la scelta migliore quando devi modificare singole righe di uno script. Anziché creare un dizionario, usi tag fonetici in linea che indicano al modello vocale di pronunciare una parola nel modo desiderato secondo l'IPA.
Per esempio, supponiamo che tu stia scrivendo lo script per un podcast e voglia citare un'esperta del settore due o tre volte. Invece di aggiungerne il nome al tuo dizionario di pronuncia aziendale, inserisci il tag con la pronuncia corretta quando lo usi nello script.
Scrivi e formatta script che suonano naturali quando vengono pronunciati ad alta voce
Dizionari e tag sono utili per gestire i problemi relativi a singole parole nell'output vocale, ma non intervengono sulla resa complessiva, sulla cadenza e sulla dinamica del parlato. Quando scrivi uno script, è importante formulare il testo sapendo che verrà pronunciato ad alta voce. La scelta delle parole, le espressioni e la punteggiatura dovrebbero spesso essere diverse da quelle di un testo pensato esclusivamente per la lettura.
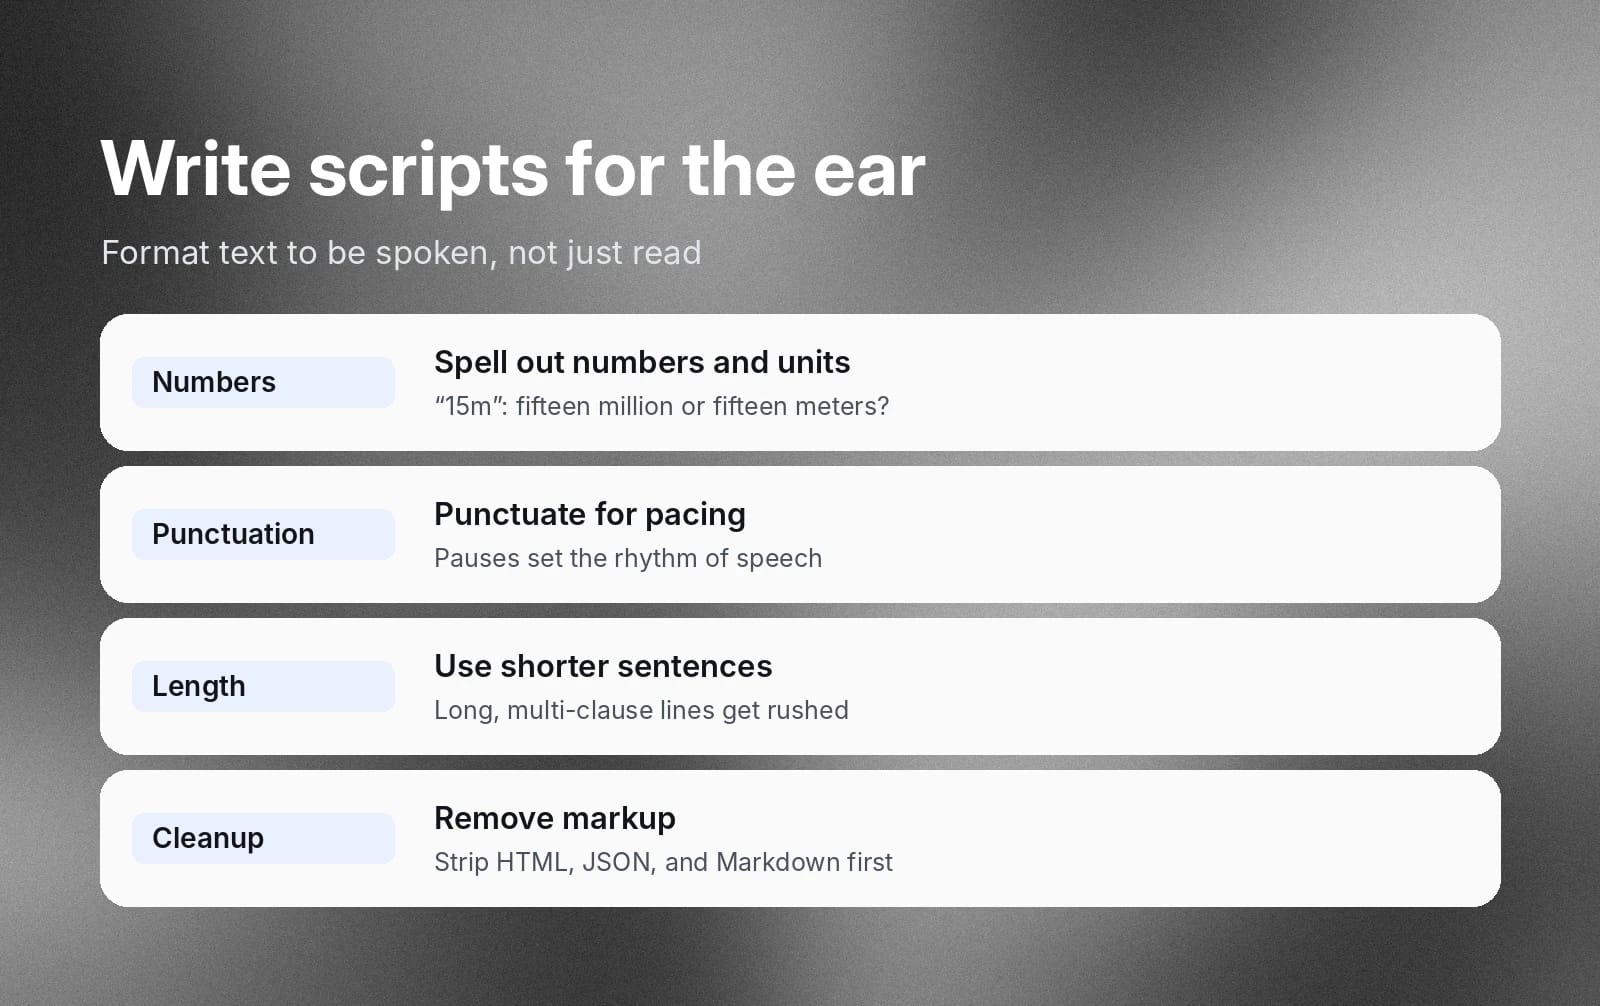
Scrivi per l'ascolto, non per la lettura
Affronta la scrittura dello script con la mentalità di chi scrive discorsi: “Come voglio che venga pronunciato ad alta voce? Dove facciamo una pausa per un effetto drammatico? Dove acceleriamo?” Queste domande valgono per uno script destinato a modelli vocali neurali avanzati tanto quanto per uno script scritto per una persona.
Scrivi per esteso numeri, valute e date
Non vuoi lasciare ambiguità nei tuoi script. I modelli vocali neurali comprendono bene il contesto, ma offrono le prestazioni migliori quando non devono indovinare. Abbreviazioni e forme sintetiche sono elementi su cui potrebbero inciampare.
Per esempio, uno script potrebbe dire: “Cerchi una cifra vicina a 15m.” L'autore vuole che il motore TTS dica “quindici milioni” o “quindici metri?” Scrivilo per esteso, così il modello non dovrà dedurlo dal contesto.
Usa la punteggiatura comune per controllare il ritmo
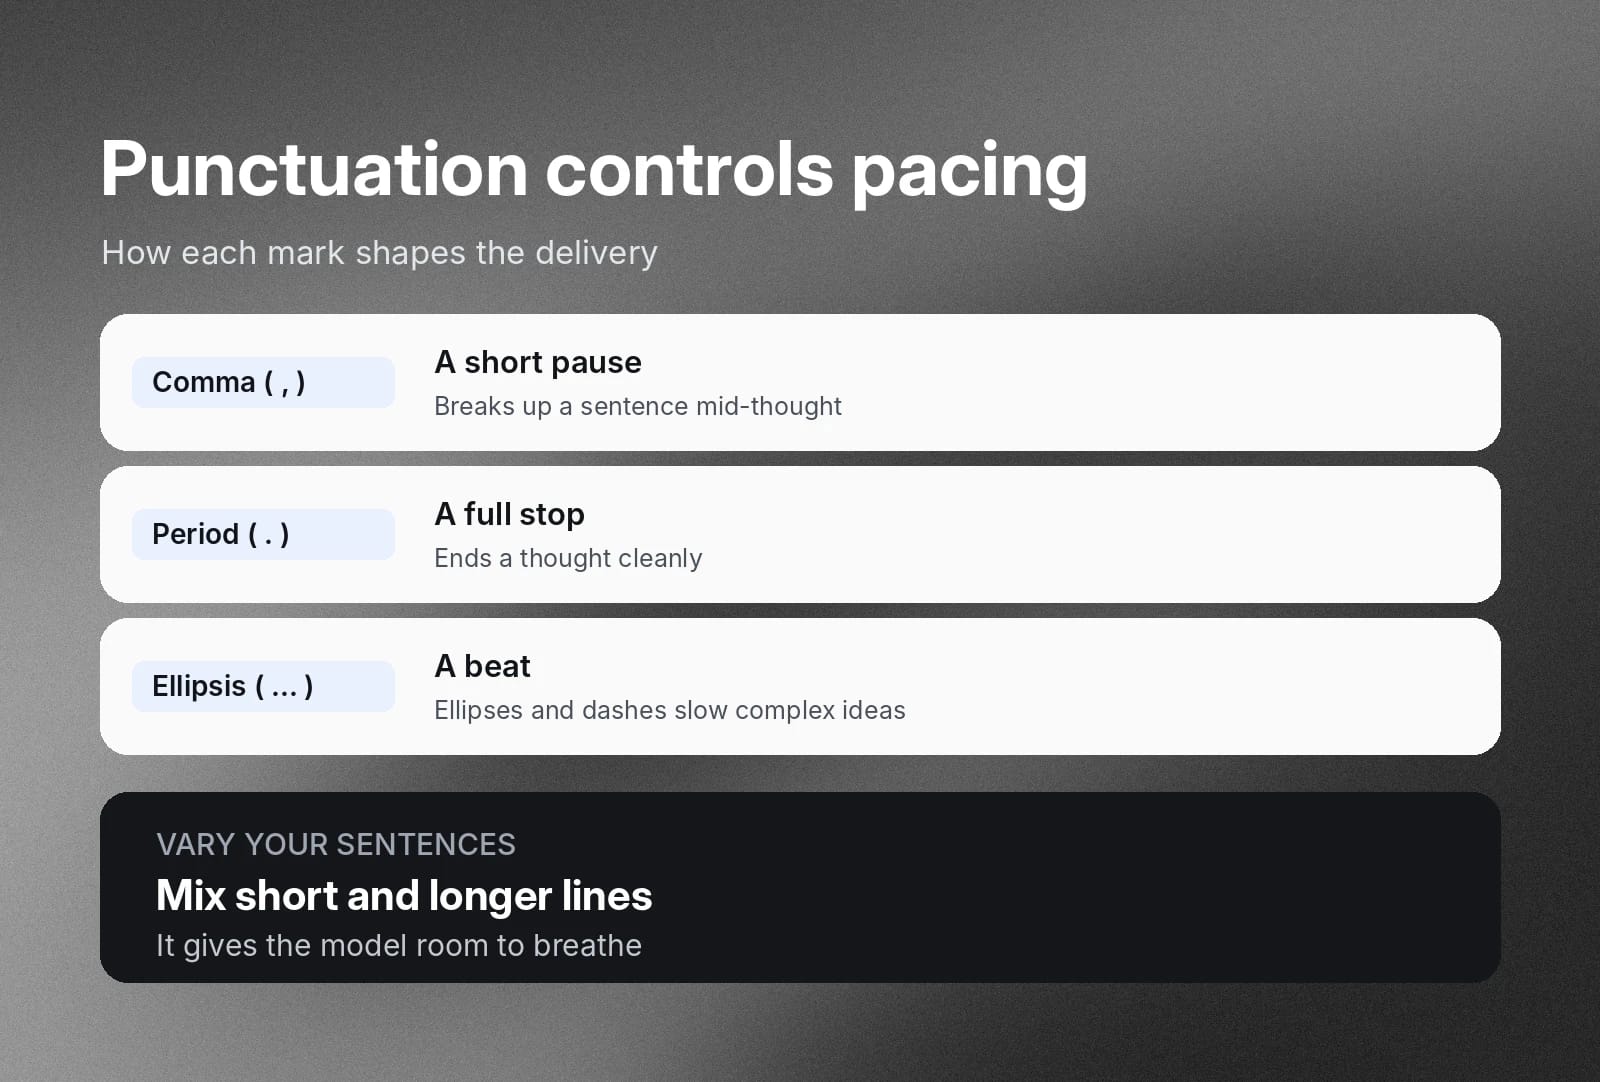
La punteggiatura svolge un ruolo importante nel testo scritto, ma conta ancora di più nella sintesi vocale. La punteggiatura controlla il ritmo. Rappresenta diversi tipi di pause che puoi usare per suddividere concetti complessi o semplicemente per mantenere una cadenza naturale, più piacevole da ascoltare.
- Usa le virgole per brevi pause a metà frase.
- Usa i punti per concludere un pensiero.
- Usa i puntini di sospensione e le lineette lunghe per inserire una pausa a metà di concetti complessi, così il modello non sembrerà frettoloso.
Le frasi brevi sono migliori
È più probabile che i modelli inciampino o accelerino con frasi lunghe, condizionali e composte da più proposizioni. Dividile in affermazioni più brevi e di lunghezza variabile. Questo dà al modello più spazio per respirare e gli impedisce di accelerare mentre cerca la cadenza per frasi lunghe e prolisse.
Rimuovi la formattazione e gli elementi Markdown
Se stai sintetizzando parlato estratto da un sistema di gestione dei contenuti o da un altro sistema aziendale, il testo potrebbe contenere HTML, JSON, Markdown o altra formattazione. Rimuovila e formatta il contenuto come testo per ottenere un parlato dal suono più naturale. I modelli vocali potrebbero avere difficoltà a capire quando ignorare quei tag, leggerli letteralmente o integrarli contestualmente nel proprio output.
Puoi approfondire le pronunce errate e altri problemi nella guida al troubleshooting di ElevenLabs.
Correggi gli errori API comuni di ElevenLabs
I team che producono audio vocale su larga scala in genere collegano le proprie applicazioni a un modello di sintesi vocale tramite API. Questo rende la produzione complessivamente più efficiente, ma aggiunge un livello tecnico da gestire oltre all'output vocale del modello.
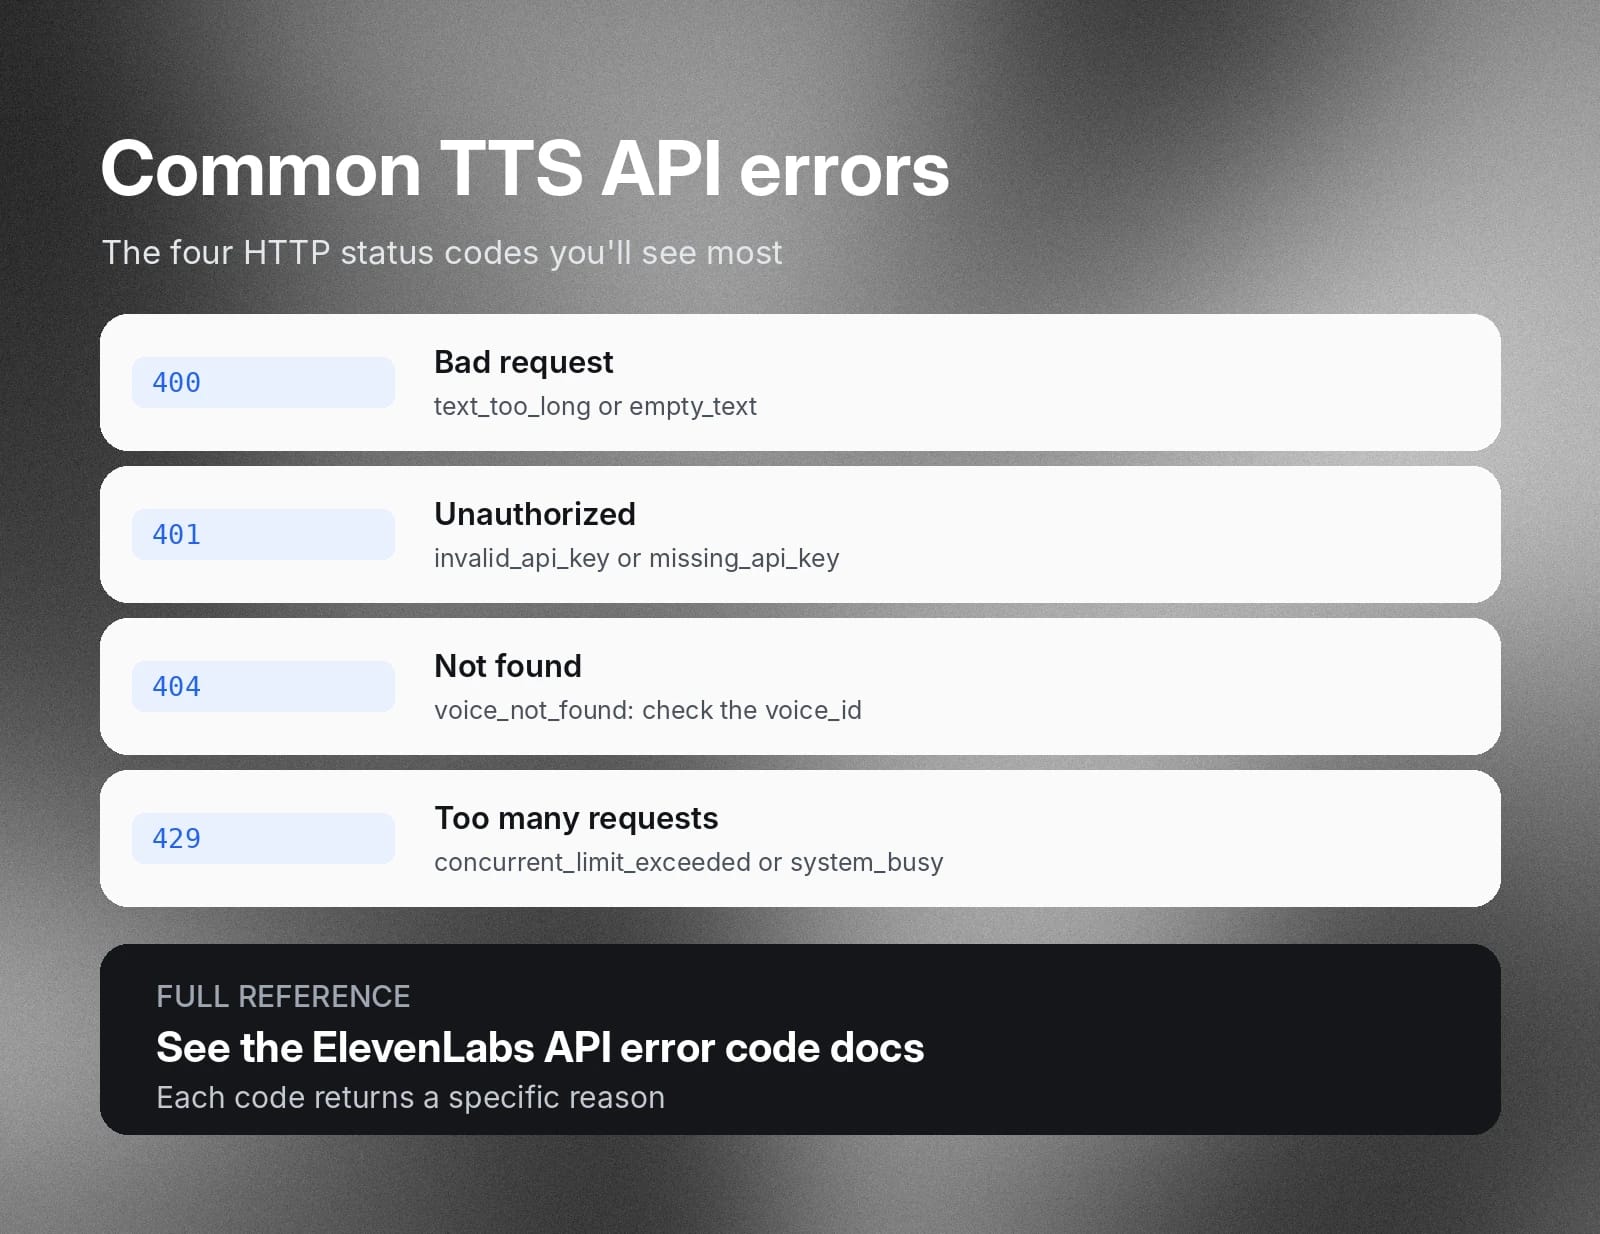
Il riferimento ai codici di errore dell'API ElevenLabs illustra nel dettaglio i codici di risposta, ma ecco i quattro codici di stato HTTP più comuni quando fai troubleshooting delle integrazioni Text to Speech e come gestirli.
400 Bad Request (errori del payload)
Una risposta con codice di stato 400 da un'API di un modello vocale significa che la tua applicazione ha inviato dati che il modello non ha potuto elaborare. Nei workflow TTS, questo deriva in genere dal superamento dei limiti di caratteri o dall'invio accidentale di input vuoti.
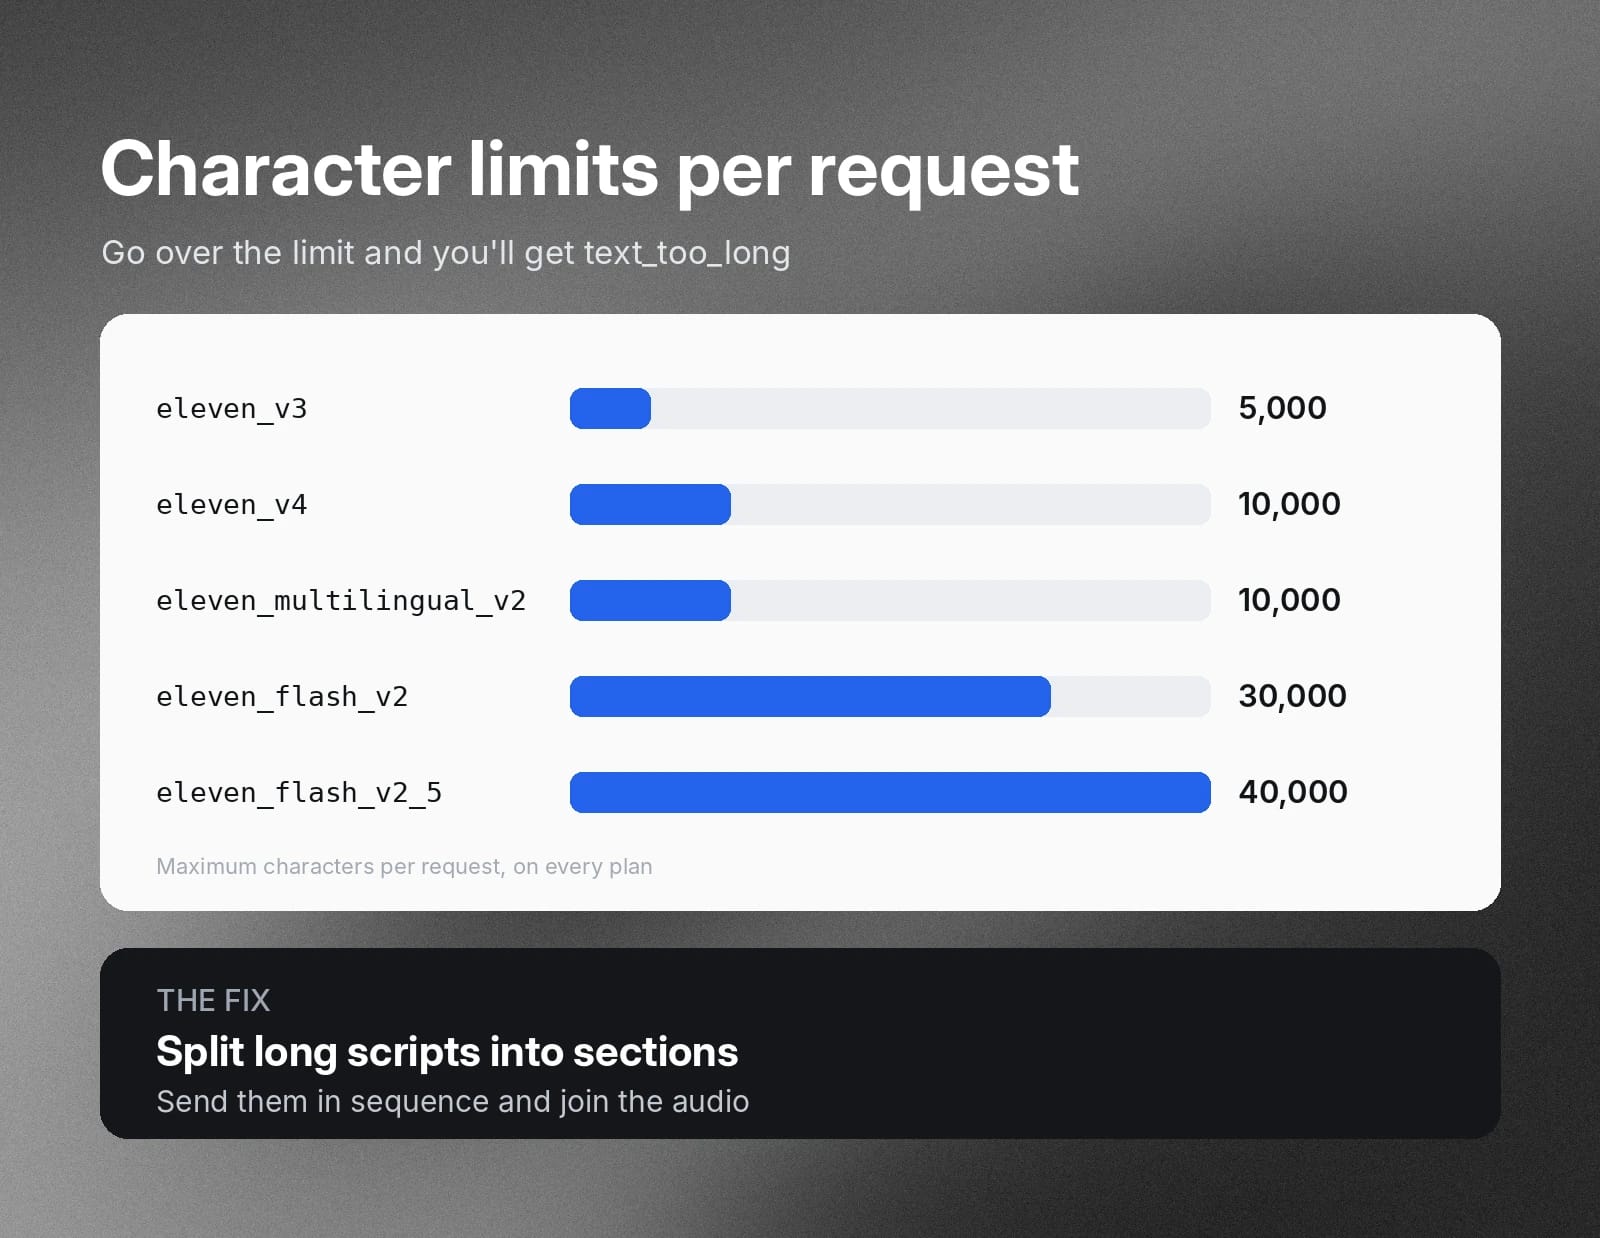
Limite di caratteri superato (text_too_long)
Ogni richiesta TTS inviata ha un limite di caratteri stabilito dal modello. Se provi a inviare più testo di quanto consentito dal limite del modello, il server TTS restituirà questo errore. I limiti per richiesta sono 10.000 caratteri per eleven_v4 ed eleven_multilingual_v2, 5.000 per eleven_v3, 30.000 per eleven_flash_v2 e 40.000 per eleven_flash_v2_5, in tutti i piani. Per risolvere il problema, dividi gli script più lunghi in più sezioni che il modello possa elaborare in sequenza.
Testo di input vuoto
Un motore TTS rifiuterà qualsiasi payload che contenga stringhe vuote (empty_text). Includi passaggi di pulizia nella pipeline di input per rimuovere le righe vuote, così il server non rifiuterà un payload altrimenti utilizzabile.
401 Unauthorized (problemi di autenticazione)
Un codice di errore 401 significa che il gateway API ha rifiutato le tue credenziali e il payload non è stato inoltrato al modello. Questo accade quando c'è un problema con la chiave API.
Chiave API non valida
La richiesta inviata al server del modello deve includere una xi-api-key valida. In caso contrario, il server restituirà un errore 401. Verifica che la chiave sia effettivamente presente nella richiesta e che non sia stata revocata, sia scaduta o sia stata troncata dagli header durante il deployment. L'API restituisce invalid_api_key quando la chiave non è corretta e missing_api_key quando non ne viene inviata alcuna.
404 Not Found (mancata corrispondenza dell'identificatore vocale)
Ricevi un errore 404 quando l'endpoint non riesce a trovare la risorsa TTS specificata nella richiesta URL. Questo può accadere se invii il parametro voice_id errato o se manca nell'URL della richiesta. Assicurati di aver ricevuto il voice_id corretto da usare. Verifica che sia effettivamente presente nei parametri del path e che non contenga errori di digitazione. L'API restituisce voice_not_found quando l'ID voce non esiste.
429 Too Many Requests
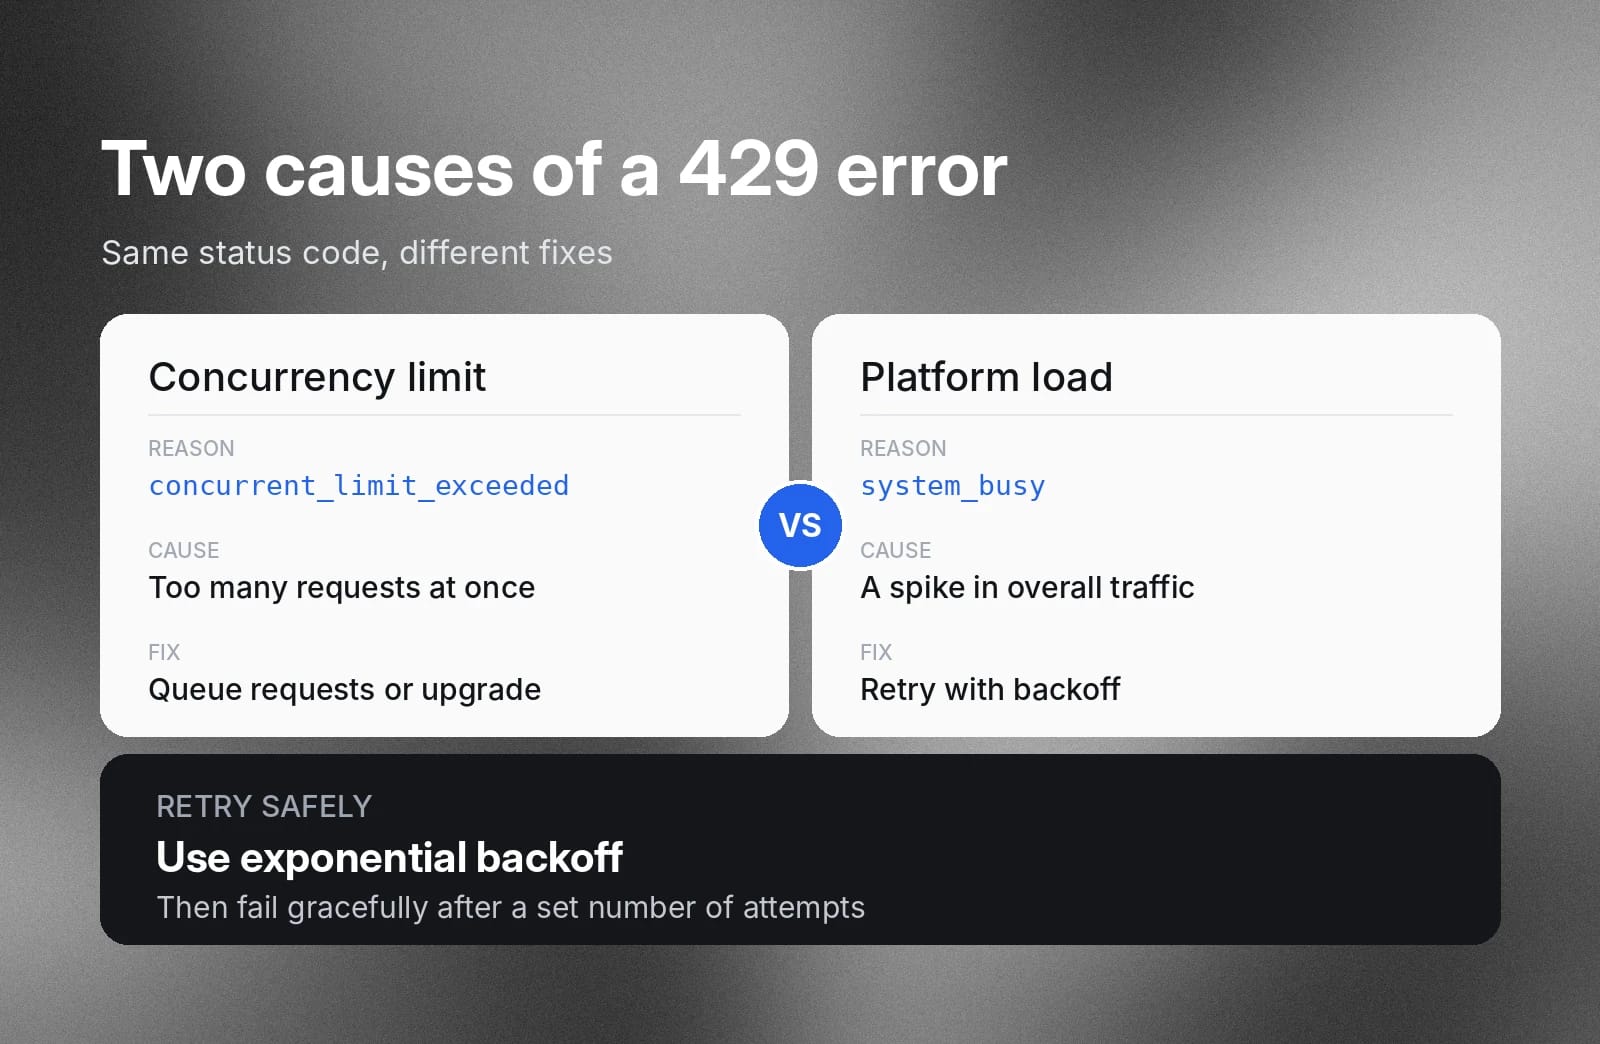
Questo errore ha due cause distinte: hai raggiunto il limite di richieste simultanee del tuo livello di servizio oppure la piattaforma TTS sta limitando le richieste per gestire un picco di traffico.
Limiti di concorrenza (concurrent_limit_exceeded)
Ogni livello di abbonamento a un motore TTS specifica un numero fisso di richieste simultanee che puoi inviare. Se le tue applicazioni superano tale limite, il server restituirà questo tipo di errore 429.
Crea un livello di accodamento asincrono usando un servizio come Redis per regolare i payload in uscita, così non supereranno i limiti del tuo livello. In alternativa, valuta se un abbonamento di livello superiore sia conveniente.
Picchi di carico della piattaforma (system_busy)
In condizioni di carico elevato, un server TTS può limitare le richieste in entrata per mantenere le prestazioni. Integra una logica di tentativi automatici nel client API della tua applicazione. Assicurati che possa ritentare con backoff esponenziale e poi terminare correttamente dopo un numero massimo di tentativi.
Testa voci, lingue e impostazioni prima della pubblicazione
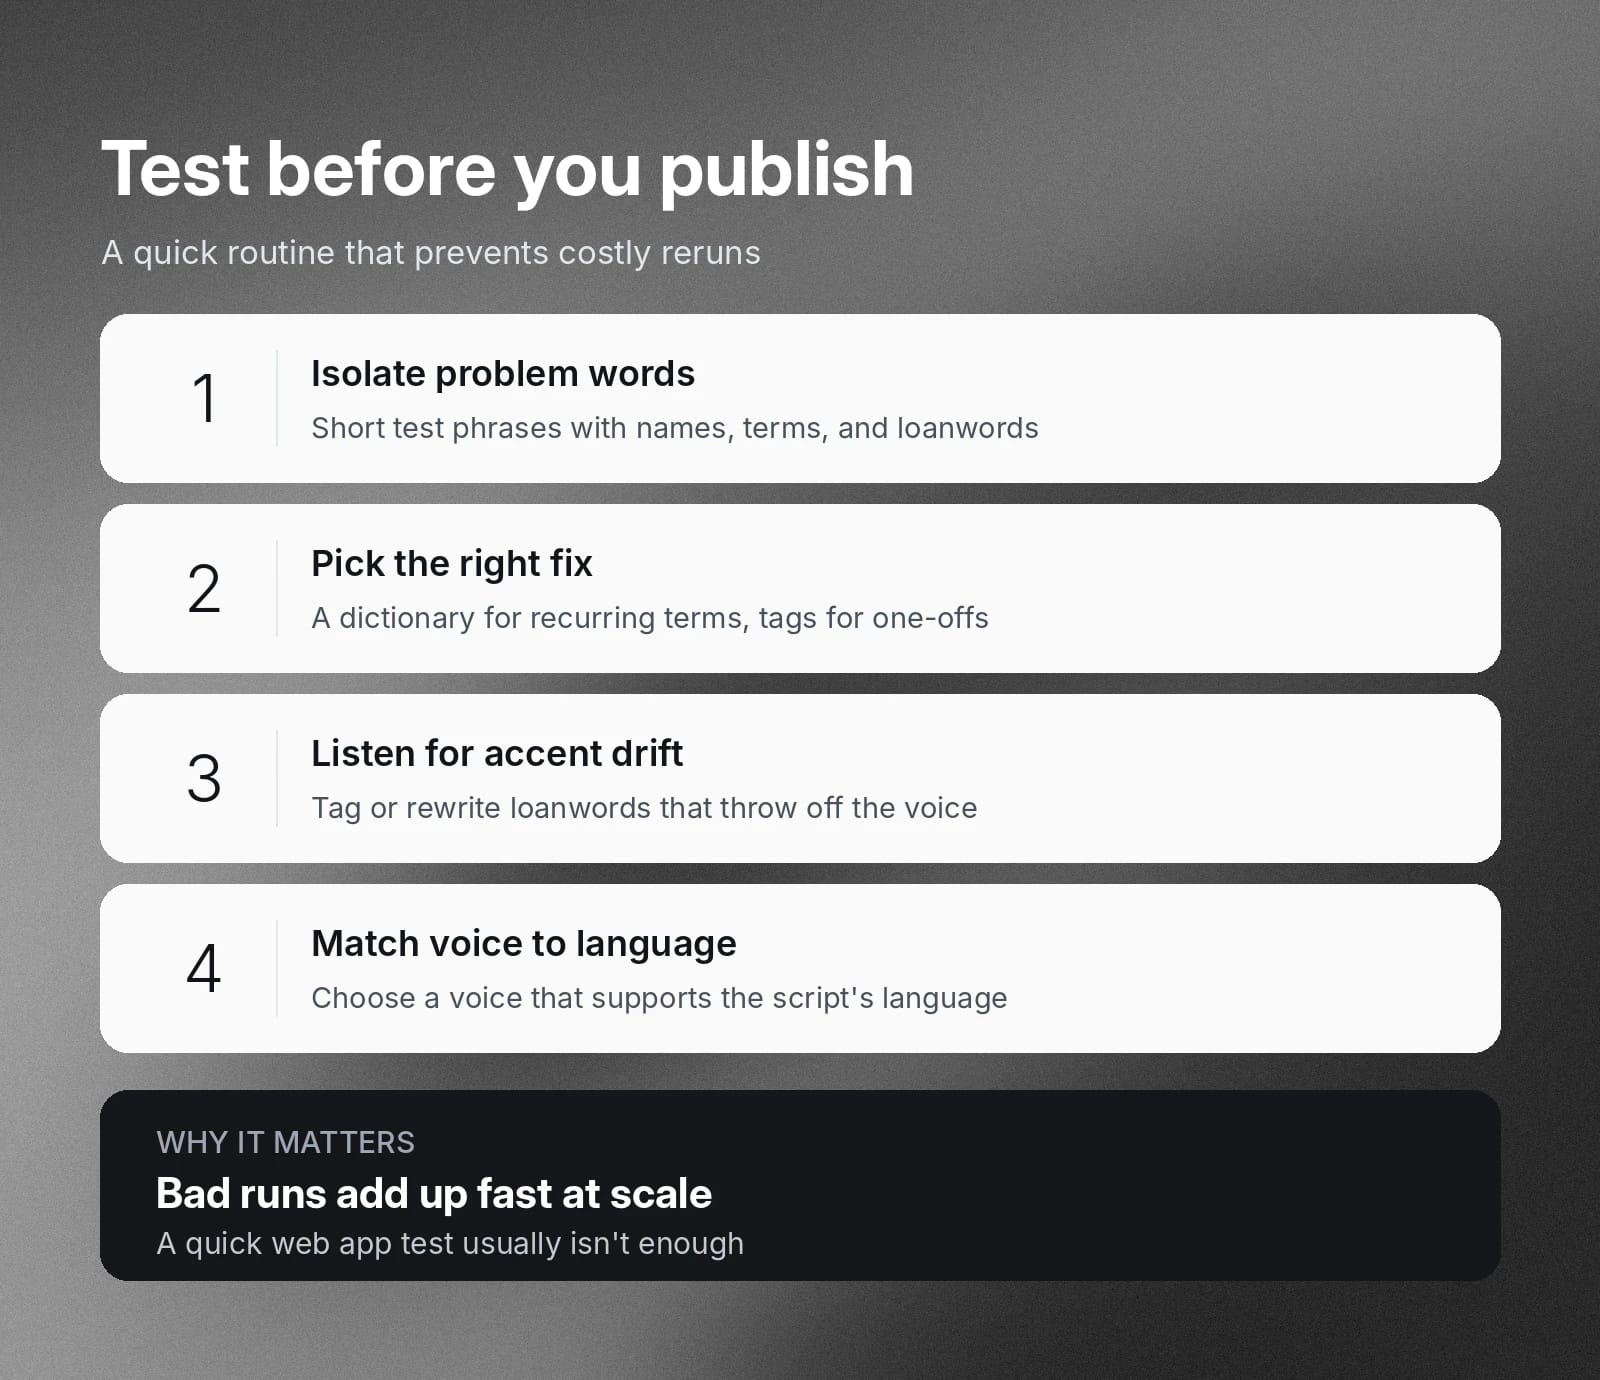
Un rapido test nell'app web di solito non offre un controllo qualità sufficiente per payload TTS su larga scala. Il costo di esecuzioni non riuscite può aumentare rapidamente. Testa lo script con una serie di iterazioni controllate prima di inviarlo. Questa preparazione iniziale ti aiuterà a produrre audio vocale della massima qualità nel modo più efficiente.
Testa isolatamente le parole problematiche
Di solito i problemi riguarderanno passaggi specifici oppure singole parole o nomi, anziché essere diffusi. Crea frasi di test da cinque a dieci parole che contengano i nomi dei tuoi brand, termini tecnici o frasi in lingua straniera. In base agli output, decidi se usare un dizionario di pronuncia oppure tag fonetici per ciascun caso.
Identifica possibili variazioni di lingua o accento
I modelli vocali possono occasionalmente adottare una cadenza insolita o lenta a metà frase. Questo accade spesso quando il modello deve indovinare come pronunciare un passaggio diverso da quelli incontrati durante l'addestramento.
- Prestiti linguistici: un testo che usa prestiti poco comuni da una lingua straniera può alterare la mappatura dei grafemi del modello, facendo sì che tutto il parlato successivo suoni con un accento insolito. Usa tag fonetici sulla parola presa in prestito oppure riscrivila.
- Parlato non inglese innaturale: un modello ottimizzato per l'inglese potrebbe balbettare o suonare robotico quando legge uno script tradotto. Seleziona un profilo vocale che supporti anche la lingua madre.
Inizia con ElevenAPI per un output vocale più affidabile
Quando sai a cosa prestare attenzione, genererai contenuti vocali di alta qualità più velocemente e con meno problemi. Impara a gestire i problemi dell'output e quelli tecnici delle API che potrebbero rallentare la produzione.
Scopri di più su come generare contenuti TTS precisi e di alta qualità con ElevenAPI oppure ottieni la tua chiave API per iniziare oggi stesso.
Domande frequenti sui problemi del Text to Speech

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.