Stream crea agentes de IA multimodales con ElevenLabs
- Escrito por
- Fergal Burnett Small
- Publicado
EscucharEscucha este artículo
Stream ha presentado Vision Agents, un framework de código abierto que permite a desarrolladores crear experiencias de IA multimodales de baja latencia que combinan vídeo, audio y conversación en tiempo real. El framework integra Texto a Voz de ElevenLabs Texto a Voz para ofrecer voces expresivas y reactivas que permiten una interacción fluida entre usuarios y sistemas de IA.
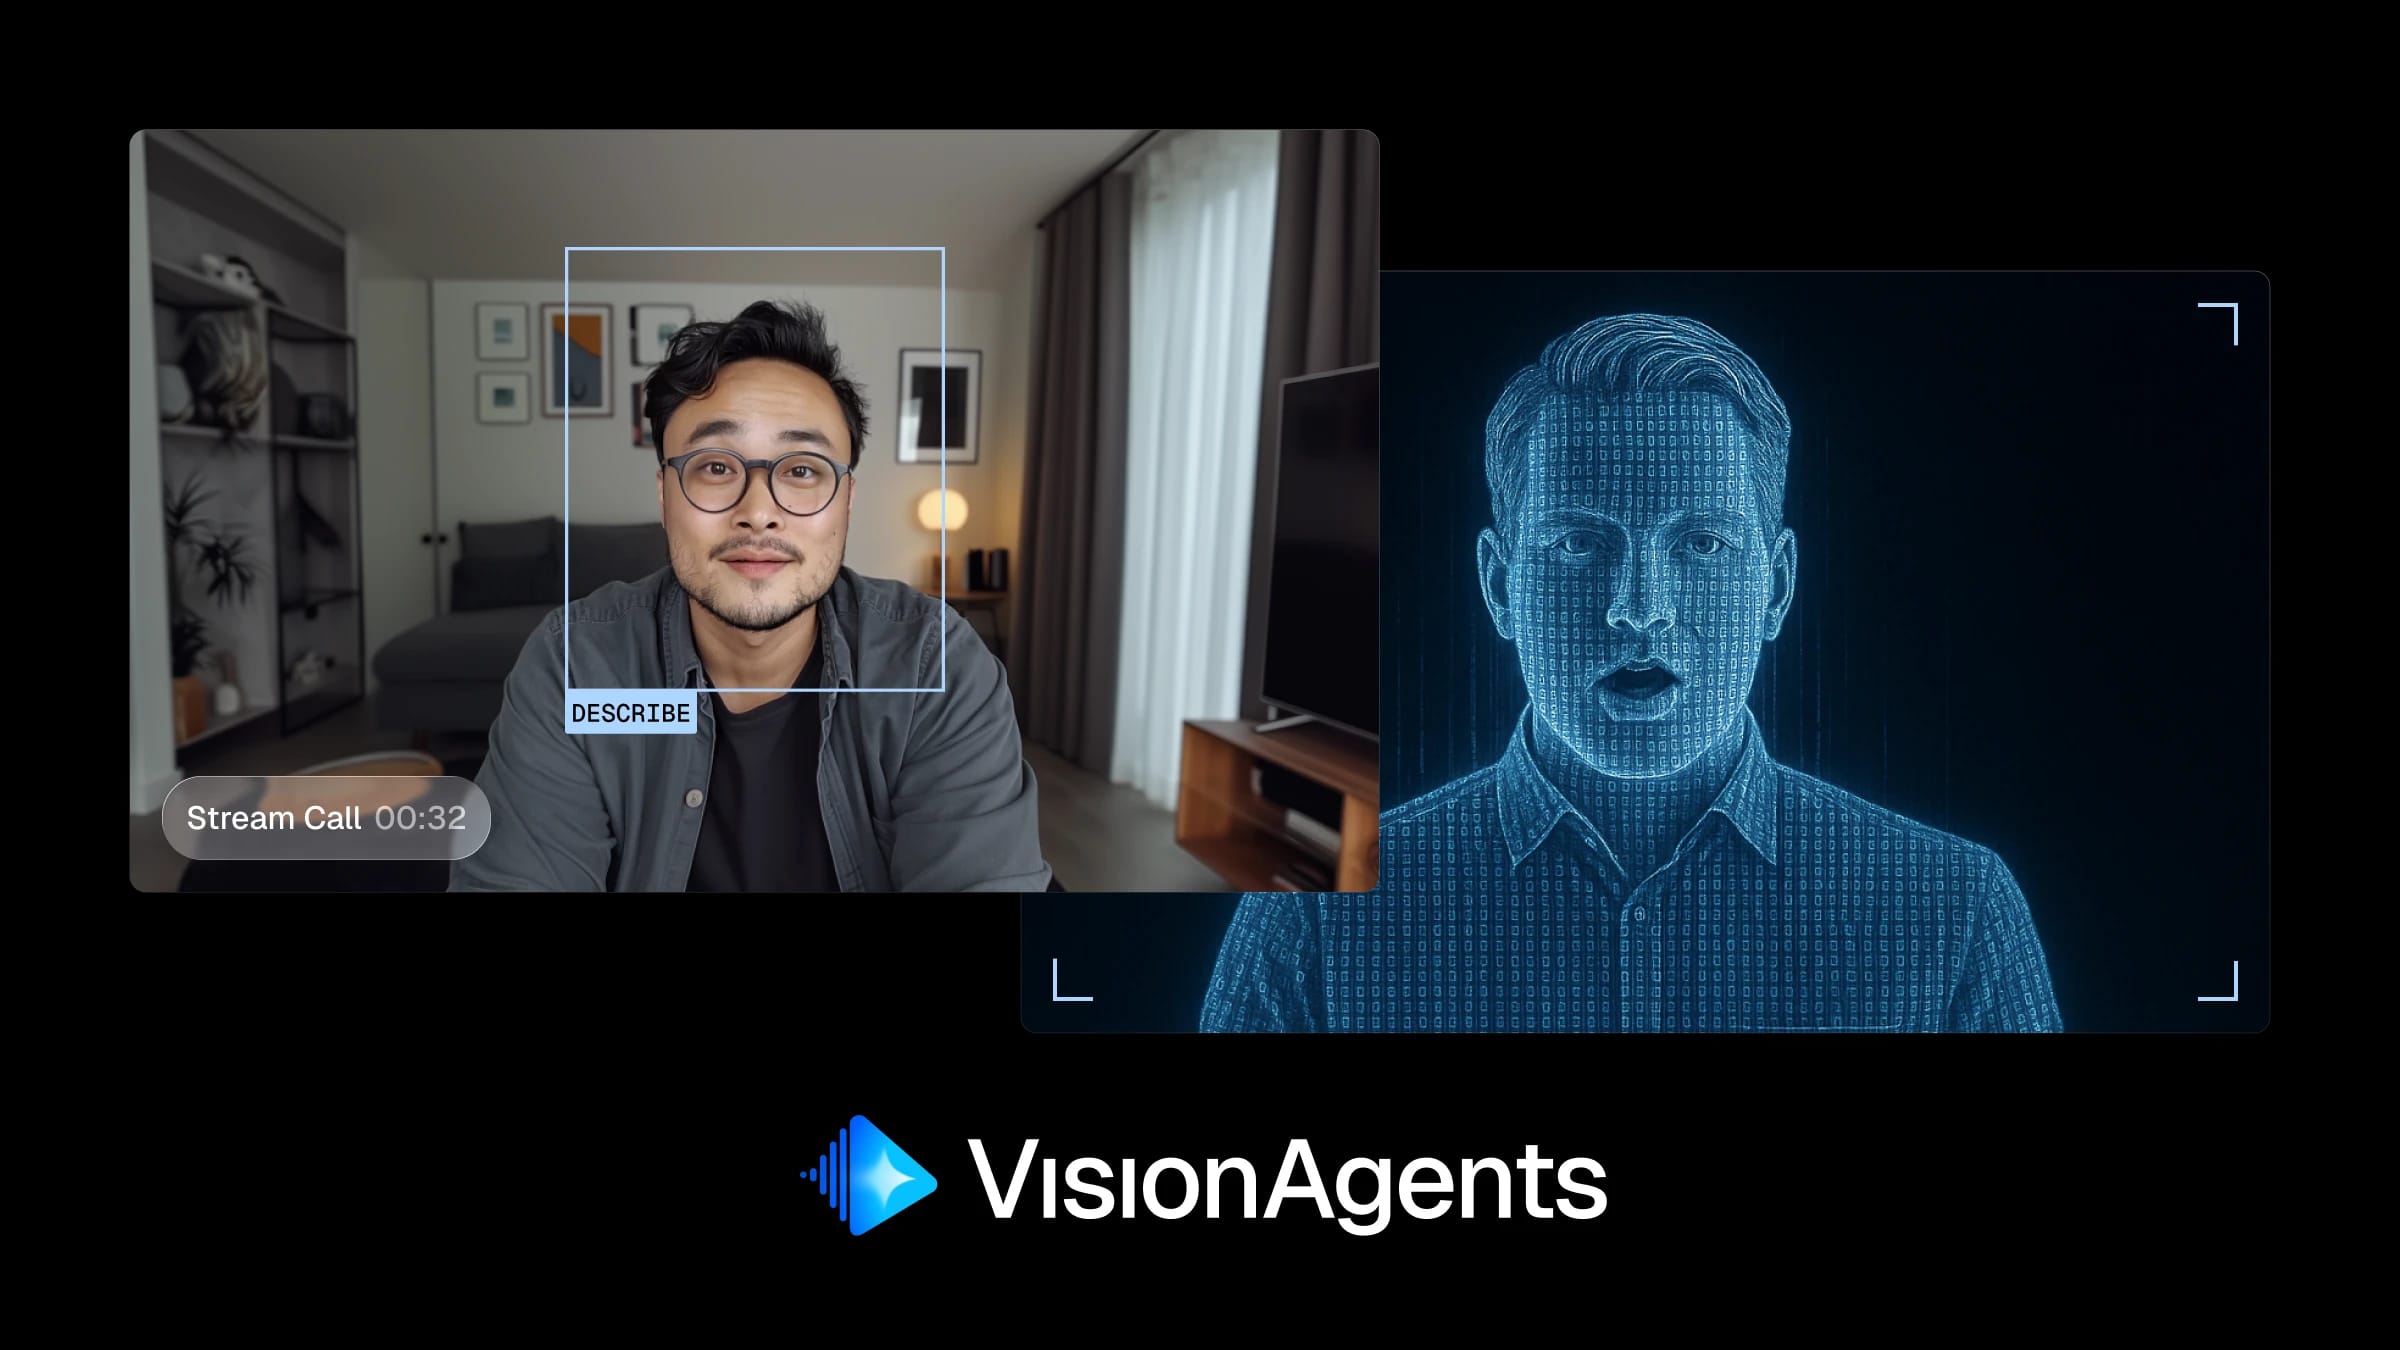
Agentes multimodales en tiempo real
Vision Agents dota a la IA de la capacidad de ver, oír y responder en tiempo real. Basado en los SDK de vídeo y audio de Stream, el framework ofrece una base de baja latencia para que desarrolladores creen prototipos y desplieguen experiencias con agentes multimodales.
Al evaluar proveedores de Texto a Voz, Stream eligió ElevenLabs por su calidad líder en el mercado y su facilidad de integración. Ahora, ElevenLabs es la principal opción de voz para usuarios de Stream.
«ElevenLabs nos facilitó incorporar rápidamente potentes capacidades de texto a voz a nuestro SDK, lo que permite a agentes responder en tiempo real con voces expresivas a las preguntas de usuarios o como respuesta a lo que están viendo». - Neevash Ramdial, director de marketing de Stream
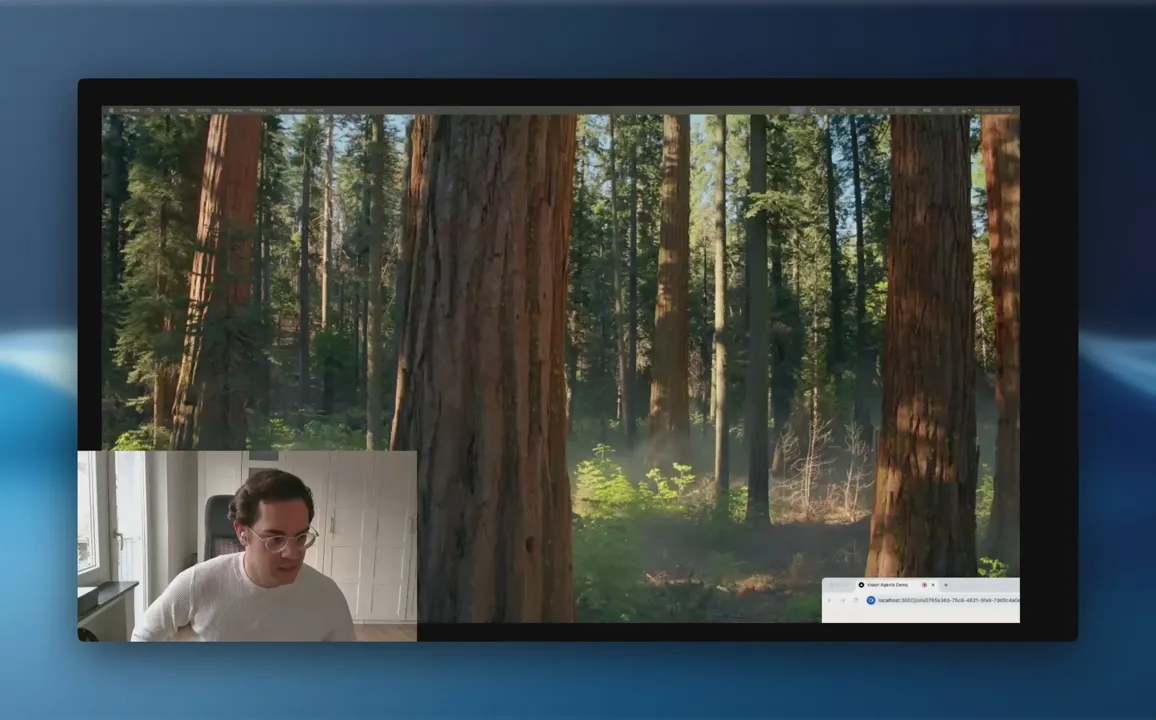
Integración rápida, fiable y pensada para desarrolladores
Stream integró ElevenLabs en toda su base de código en solo unos días, lo que permite a desarrolladores añadir una salida de voz realista a sus agentes de visión con una configuración mínima. La integración ofrece ahora:
- Configuración 10 veces más rápida: la preintegración con ElevenLabs reduce el tiempo de configuración de voz de 400 líneas de código a solo 40.
- Rendimiento de baja latencia: la rápida generación de voz de ElevenLabs, combinada con la red perimetral global de Stream, garantiza una capacidad de respuesta natural y humana.
- Experiencia escalable para desarrolladores: los SDK de Stream simplifican el proceso de crear, probar y desplegar agentes multimodales.
Construir el futuro de la IA multimodal
Vision Agents de Stream demuestra cómo los modelos de ElevenLabs están ampliando las posibilidades de la IA multimodal. Al combinar la comprensión visual con Texto a Voz, desarrolladores pueden crear agentes que no solo ven, sino que también hablan y escuchan con una fluidez casi humana.
¿Quieres crear con Texto a Voz? Ponte en contacto aquí.
Fergal forma parte del equipo de Growth y se encarga de llevar nuestra investigación y producto al mundo y a los usuarios.