Vibe Draw entwickeln: ElevenLabs mit FLUX Kontext für sprachgestützte Bilderstellung kombinieren
- Verfasst von
- Ryan Morrison
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Sprachschnittstellen verändern, wie wir mit KI kommunizieren. Was wäre, wenn ein Bild zu erstellen so einfach wäre, wie es laut zu beschreiben?
Diese Idee brachte mich dazu, Vibe Draw als Wochenendprojekt zu entwickeln. Es ist ein kreatives Tool mit Sprachfokus, das die Sprach-KI von ElevenLabs mit FLUX Kontext von Black Forest Labs kombiniert, um gesprochene Prompts in Bilder umzuwandeln.
FLUX Kontext steht für eine neue Klasse von Bildmodellen. Anders als herkömmliche Text-zu-Bild-Systeme beherrscht Kontext sowohl Generierung als auch Bearbeitung. Es kann neue Bilder aus Prompts erstellen, bestehende Bilder verändern und sogar mehrere Referenzbilder zu einer Ausgabe zusammenführen.
Während Modelle wie GPT-4o und Gemini 2 Flash multimodale Funktionen bieten, wurde FLUX Kontext speziell für hochwertige visuelle Bearbeitung entwickelt. In Tests konnte ich einzelne Buchstaben in stilisiertem Text ändern oder ein Objekt neu positionieren — allein durch die Beschreibung der Änderung.
Da dachte ich: „Warum nicht mit Sprache?“ Und welche Grundlage wäre besser als die leistungsstarke Sprachtechnologie von ElevenLabs?

Die technische Herausforderung
Für ein sprachgesteuertes Bildsystem mussten fünf zentrale Probleme gelöst werden:
- Verständnis natürlicher Sprache — Zwischen Neuerstellung und Bearbeitung unterscheiden
- Kontextbewusstsein — Kontinuität über Interaktionen hinweg bewahren
- Audiomanagement — Überlappende Antworten vermeiden und Warteschlangen verwalten
- Visuelle Generierung — Nahtlose Übergänge zwischen Generierung und Bearbeitung
- Nutzererlebnis — Erweiterte KI-Interaktionen intuitiv gestalten
Architekturübersicht
Vibe Draw läuft vollständig clientseitig und integriert folgende Komponenten:
- Web Speech API für Spracherkennung
- ElevenLabs-TTS-API für Sprachantworten
- FLUX-Kontext-API für Bildgenerierung und -bearbeitung
- Benutzerdefinierte Absichtserkennung zum Verstehen von Nutzereingaben
Dieser Ansatz hält den Prototyp schlank, doch in Produktionsumgebungen sollten Anfragen aus Sicherheitsgründen serverseitig über einen Proxy laufen.
Sprache mit ElevenLabs implementieren
Vibe Draw nutzt die Text-to-Speech API von ElevenLabs, optimiert für reaktionsschnelle Gespräche:
Für mehr Abwechslung werden Sprachantworten zufällig aus vordefinierten Vorlagen ausgewählt:
Audiowiedergabe verwalten
Überlappende Sprachantworten zerstören die Illusion eines Gesprächs. Vibe Draw löst das mit einem Audio-Warteschlangensystem:
Jede Nachricht wird vollständig abgespielt, bevor die nächste ausgelöst wird.
Absichtserkennung und Kontextverwaltung
Das System nutzt die Erkennung von Schlüsselwörtern und Kontext, um zu entscheiden, ob ein Nutzerprompt eine neue Bildanfrage oder eine Bearbeitung ist:
Dieser Ansatz stellt sicher, dass Bearbeitungen nur angewendet werden, wenn ein Bild vorhanden ist und der Kontext dies eindeutig macht.
Bildgenerierung mit FLUX Kontext
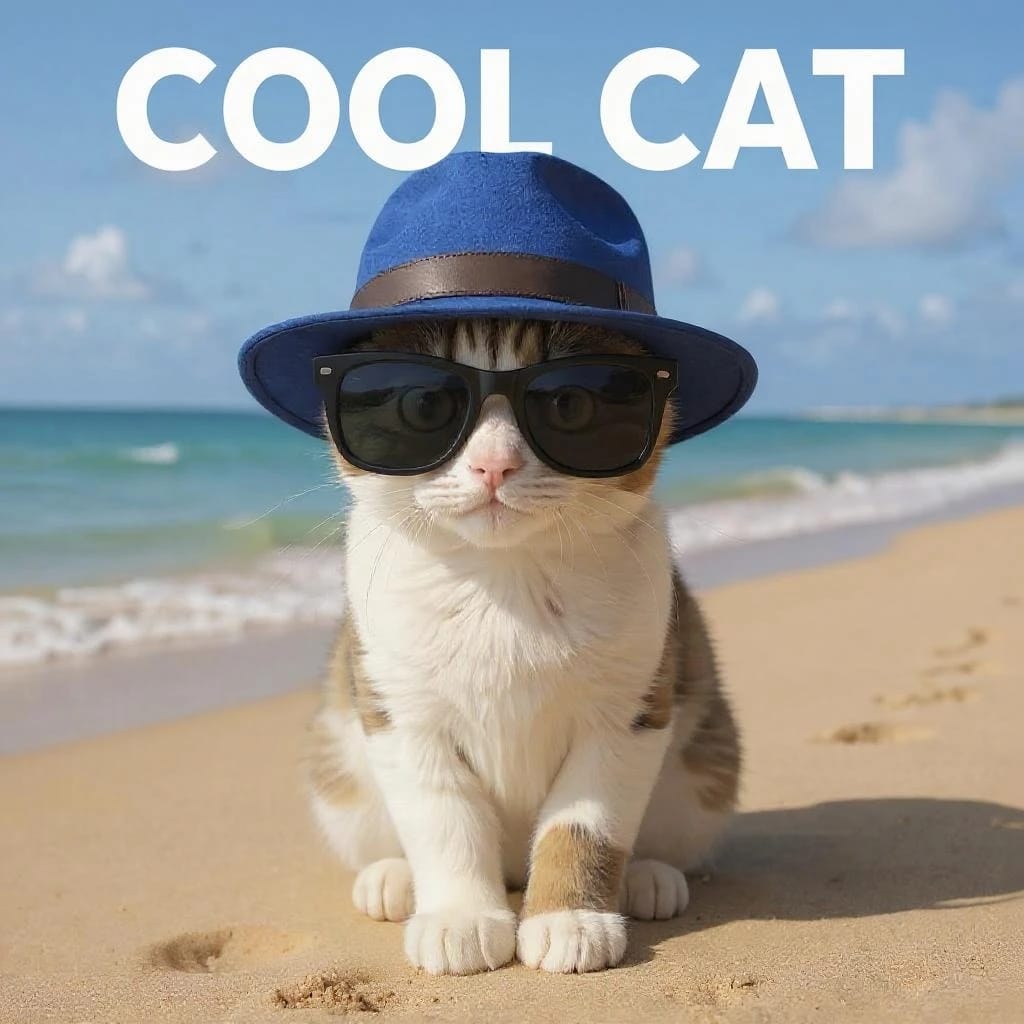
Kontext unterstützt zwei Modi: Generierung und Bearbeitung.
Generierung (Text zu Bild)
Bearbeitung (kontextbezogene Transformation)
Komplexe Transformationen verarbeiten
Manche Prompts implizieren Änderungen, die über die Grenzen der Bearbeitungs-API hinausgehen. In diesem Fall bietet das System eine Alternative:
Das Erlebnis optimieren
Progressives Feedback
UI-Feedback hilft Nutzern, den Systemstatus nachzuverfolgen:
Intelligentes Timing
Natürliche Gespräche erfordern natürliches Timing:
Sitzungsstatus
Um den Kontext zu bewahren, werden Sitzungsdaten gespeichert:
Leistungsaspekte
Für eine reaktionsschnelle Anwendung:
- Lazy Loading — APIs nur bei Bedarf initialisieren
- Debouncing — API-Anfragen pro Interaktion begrenzen
- Fehlerbehandlung — Nach Timeouts oder Fehlern reibungslos wiederherstellen
- Ressourcenbereinigung — Audioobjekte und Event-Listener korrekt entfernen
Wie es weitergeht
Dialogorientierte UIs eröffnen neue Möglichkeiten:
- Multimodale Eingabe — „Lass es mehr wie dieses Foto aussehen.“
- Kollaborative Sitzungen — Mehrere Nutzer arbeiten an einem Design mit
- Stilgedächtnis — Das System lernt mit der Zeit Ihre Ästhetik
- Echtzeit-Streaming — Bildaktualisierungen streamen, während der Nutzer spricht, und Conversational AI integrieren, um Sprache zu streamen.
Wichtigste Erkenntnisse
Die Entwicklung von Vibe Draw hat mehrere zentrale Prinzipien für Tools mit Sprachfokus gezeigt:
- Kontext ist alles — Statusverfolgung sorgt für stimmige Interaktionen
- Timing verleiht Persönlichkeit — Das richtige Tempo lässt KI reaktionsschnell wirken
- Alternativen halten den Fluss aufrecht — Schlägt die Generierung fehl, bieten Sie Alternativen an
- Abwechslung hält es frisch — Dieselbe Formulierung zu wiederholen, stört die Immersion
Fazit
Vibe Draw zeigt, was entsteht, wenn dialogorientierte Sprach-KI auf visuelle Kreativität trifft. Die natürliche Sprachsynthese von ElevenLabs und die Bild-APIs von FLUX Kontext schaffen eine neue Art zu gestalten — keine Klicks, keine Regler, nur Sprache.
Wenn Gestalten so einfach ist wie Beschreiben, beseitigen wir die Hürden zwischen Vorstellung und Umsetzung.
Probieren Sie es selbst aus
Der vollständige Quellcode ist auf GitHub verfügbar. So führen Sie Ihre eigene Version aus:
- Repository klonen
- Ihren ElevenLabs-API-Schlüssel hinzufügen
- Ihren FAL.ai-API-Schlüssel hinzufügen
- vibe-draw-v2.html in einem modernen Browser öffnen
- Klicken Sie auf das Mikrofon und beginnen Sie zu gestalten
Sie möchten Ihr eigenes Erlebnis mit Sprachfokus entwickeln? Entdecken Sie ElevenLabs Conversational AI oder kontaktieren Sie uns.
Ryan kam zu ElevenLabs nach mehr als zwei Jahrzehnten im Nachrichten- und Verlagswesen, einschließlich Rollen bei der BBC und Future Plc. Er konzentriert sich auf Content-Strategie und Storytelling und hilft ElevenLabs, seine Geschichte zu gestalten und zu teilen.