
Podsumowanie webinaru: Dodaj swojemu chatbotowi głos, który brzmi naturalnie
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Agenci czatu stali się standardową częścią firmowego stosu oprogramowania. Większość firm już ich ma lub je tworzy. Mniej firm wie, co zrobić, gdy użytkownik woli po prostu porozmawiać.
Głos zmienia interakcję w sposób, który ma znaczenie nie tylko dla wygody. Użytkownicy wyrażają frustrację, pilność i dezorientację tonem, którego tekst całkowicie nie oddaje. Klient, który pisze „moje zamówienie nie dotarło”, i klient, który mówi to z wyraźnym niepokojem, wysyłają różne sygnały — a agent, który może tylko przeczytać transkrypcję, ma zaledwie połowę informacji.
Pytanie, które zadaje dziś większość zespołów, nie brzmi, czy dodać głos, lecz jak to zrobić bez przebudowywania wszystkiego, co już działa.
Podczas Warsztat na żywo: Nadaj swojemu chatbotowi tekstowemu ludzko brzmiący głos, Paul Asjes (Developer Experience), Bhargavi Bhatt (Customer Experience) i Fergal Burnett (Product Marketing, ElevenAPI) omówili techniczne aspekty dodawania głosu do istniejącego agenta oraz to, jak w praktyce wygląda działająca integracja.
Dlaczego tworzenie rozwiązań głosowych jest trudniejsze, niż się wydaje
Jednym z głównych wyzwań jest zmiana tury w rozmowie. Ludzie wiedzą, kiedy ktoś skończył mówić, dzięki intonacji, rytmowi i kontekstowi. Jednak voice activity detection (standardowe podejście) wykrywa tylko ciszę.
Efektem często jest system, który traktuje każdą pauzę jako zaproszenie do mówienia: przerywa, ucina wypowiedzi w połowie i reaguje na naturalne zawahania tak, jakby były pełnymi zdaniami.
Technicznie działa, ale w rozmowie zawodzi.
Kontekst to druga połowa problemu. Przekazywanie LLM historii rozmowy przy każdej turze jest konieczne, ale niewystarczające. Te same słowa znaczą co innego zależnie od sposobu ich wypowiedzenia — „wszystko w porządku” powiedziane z ulgą i „wszystko w porządku” powiedziane z frustracją mają tę samą transkrypcję, ale oznaczają inną interakcję. System głosowy, który ignoruje ten wymiar, zawsze będzie brzmiał nieco nienaturalnie, niezależnie od jakości poszczególnych modeli.
Dochodzi też narzut inżynieryjny. Zespoły, które same zarządzają orkiestracją głosu, muszą stale utrzymywać logikę zmiany tury, obsługę przerwań i profilowanie opóźnień. To nie jest jednorazowa praca.
Jak dodać głos do istniejącego agenta
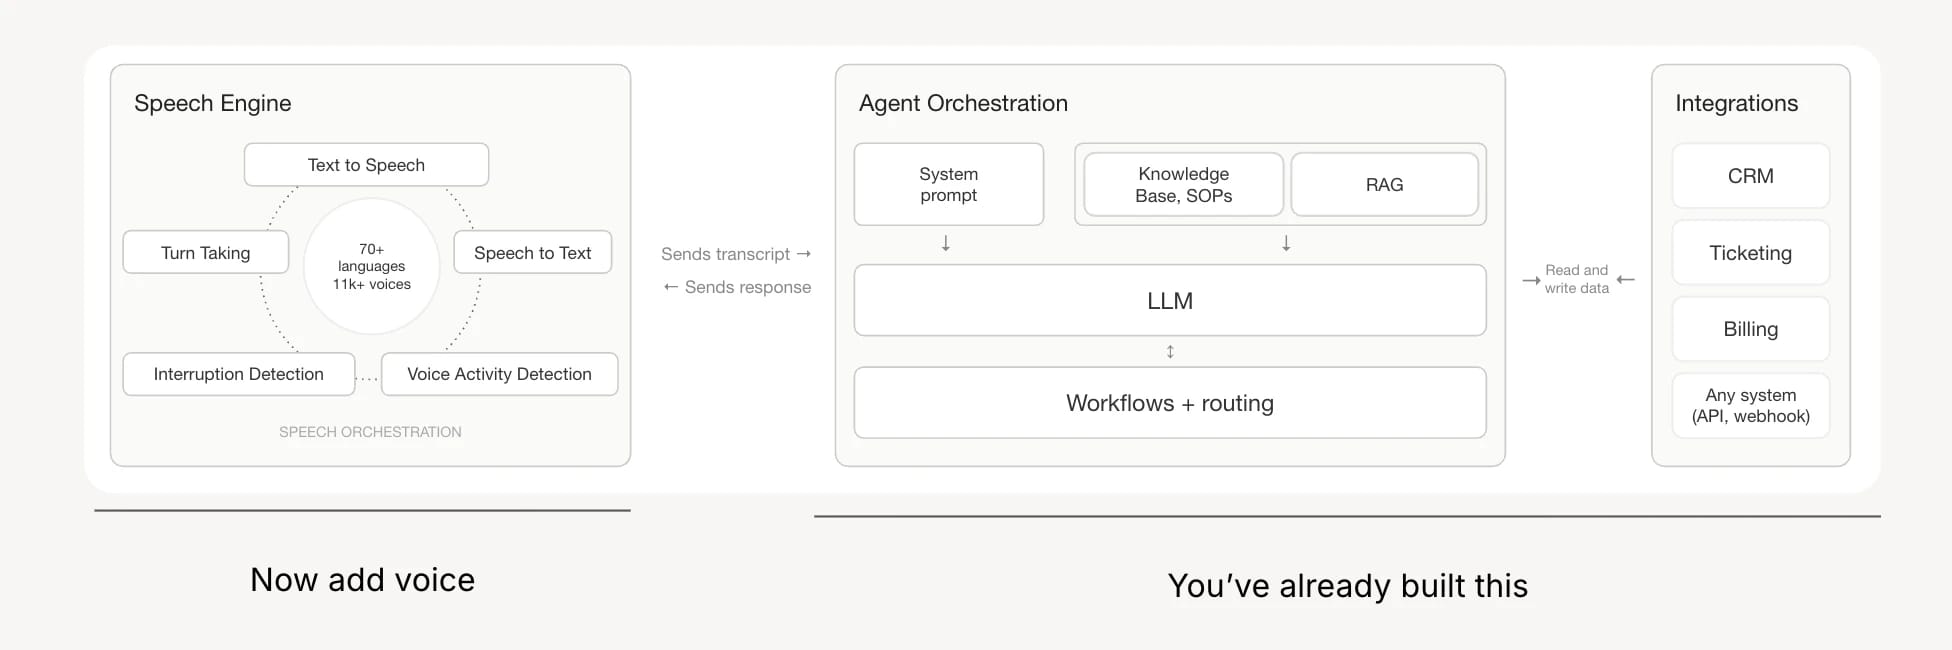
Najprostsze rozwiązanie to architektura z dwoma połączeniami WebSocket.
- Jedno połączenie działa między klientem a API ElevenLabs, a drugie między twoim serwerem a API ElevenLabs
- Użytkownik mówi do mikrofonu, dźwięk trafia do API ElevenLabs, gdzie jest transkrybowany i wysyłany na twój serwer
- Twój serwer przekazuje LLM całą historię rozmowy otrzymaną z API ElevenLabs, a odpowiedź strumieniowana wraca do syntezy mowy
- Może się to zacząć, zanim LLM zakończy generowanie — co utrzymuje niskie opóźnienie pierwszego bajtu
Kluczowym punktem integracji jest metoda onTranscript , która uruchamia się na końcu każdej tury i przekazuje LLM pełną historię rozmowy.
Metoda contextualUpdate na początku sesji przenosi wszystko, co wydarzyło się w tekstowej części rozmowy przed przejściem użytkownika na głos. Dzięki temu jeden agent może działać w obu formach bez utraty kontekstu.
Kilka rzeczy, o których warto pamiętać podczas tworzenia:
- Wybór LLM ma większe znaczenie w głosie niż na czacie. Modele do głębokiego rozumowania wprowadzają pauzy, które w audio brzmią jak nienaturalne wahanie, nawet jeśli odpowiedzi są lepszej jakości. W głosie działającym w czasie rzeczywistym szybsze modele niemal zawsze wygrywają pod względem odbieranej jakości.
- Do audio wybieraj WebRTC zamiast WebSocketów. WebRTC ma wbudowaną eliminację echa i redukcję szumów, co jest szczególnie ważne na urządzeniach mobilnych i w hałaśliwym otoczeniu. Korzystanie z WebSocketów do przesyłania audio oznacza, że musisz obsłużyć to samodzielnie.
- Nie proś użytkowników o wybór języka. To zakłóca płynność rozmowy. Lepszym rozwiązaniem jest wykrycie języka w pierwszych kilku sekundach mowy i jego ustalenie — umożliwia też płynne przełączanie bez żadnych działań ze strony użytkownika.
- Oddziel model zmiany tury od LLM. Używanie LLM do określenia, kiedy użytkownik skończył mówić, zwiększa opóźnienie i koszt każdej tury. Dedykowany model zmiany tury robi to szybciej i dokładniej, dlatego warto traktować go jako osobny element architektury.
Ile infrastruktury utrzymywać samodzielnie
Właściwa odpowiedź zależy od tego, co już masz. Jeśli masz działającego agenta czatu, dodanie warstwy głosowej na wierzch — przy zachowaniu LLM, orkiestracji i logiki biznesowej — jest zwykle najszybszą i najmniej ryzykowną drogą.
Nie przebudowujesz niczego. Dodajesz interfejs audio do czegoś, co już działa.
Jeśli potrzebujesz telefonii, zarządzania kanałami wdrożeń, wbudowanych testów i analityki, warto przekazać większą część stosu platformie agentów głosowych. Te dwa podejścia się nie wykluczają — zespoły mogą zacząć od lekkiej warstwy głosowej i dodawać możliwości platformy wraz z rozwojem zastosowania.
Demo: dodawanie głosu do istniejącego chatbota
To demo przedstawia użytkownika, który jest w trakcie rozmowy z tekstowym chatbotem do planowania podróży i prosi o rekomendacje dzielnic oraz jedzenia na wyjazd do Japonii.
Co pokazaliśmy:
- Chatbot został rozszerzony o warstwę głosową bez żadnych zmian w bazowym agencie.
- Użytkownik przeszedł z pisania na mówienie w trakcie rozmowy — agent zachował pełny kontekst w obu formach.
- Użytkownik mówił po niderlandzku; agent automatycznie wykrył zmianę języka
- Gdy agentowi przerwano i poproszono go o powrót do angielskiego w połowie zdania, zrobił to — i bez żadnej sugestii dokończył odpowiedź z lekkim niderlandzkim akcentem.
- Przez całą rozmowę wykrywanie przerwań pozwalało użytkownikowi naturalnie wchodzić agentowi w słowo, bez konieczności czekania, aż agent dokończy swoją turę.
Dlaczego to ważne:
Demo nie pokazywało stworzonego od podstaw agenta głosowego. Pokazywało działającego agenta tekstowego z dodaną warstwą głosową. Obsługa kontekstu, wykrywanie języka i zachowanie przy przerwaniach pochodziły z warstwy głosowej — bazowy agent tekstowy pozostał bez zmian.
Obejrzyj całą sesję
Obejrzyj cały webinar tutaj.
Paul pracuje w zespole Developer Growth w ElevenLabs w Walencji. Jako Developer Experience Engineer dba o wsparcie deweloperów i narzędzia na naszej platformie. Wcześniej prowadził Developer Relations w Stripe, zajmował się DX w WorkOS i przez lata tworzył aplikacje webowe oraz narzędzia dla deweloperów.




