
Praktyczny przewodnik: frameworki agentów open source i ElevenAgents
- Autor
- Akhil Chauhan
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
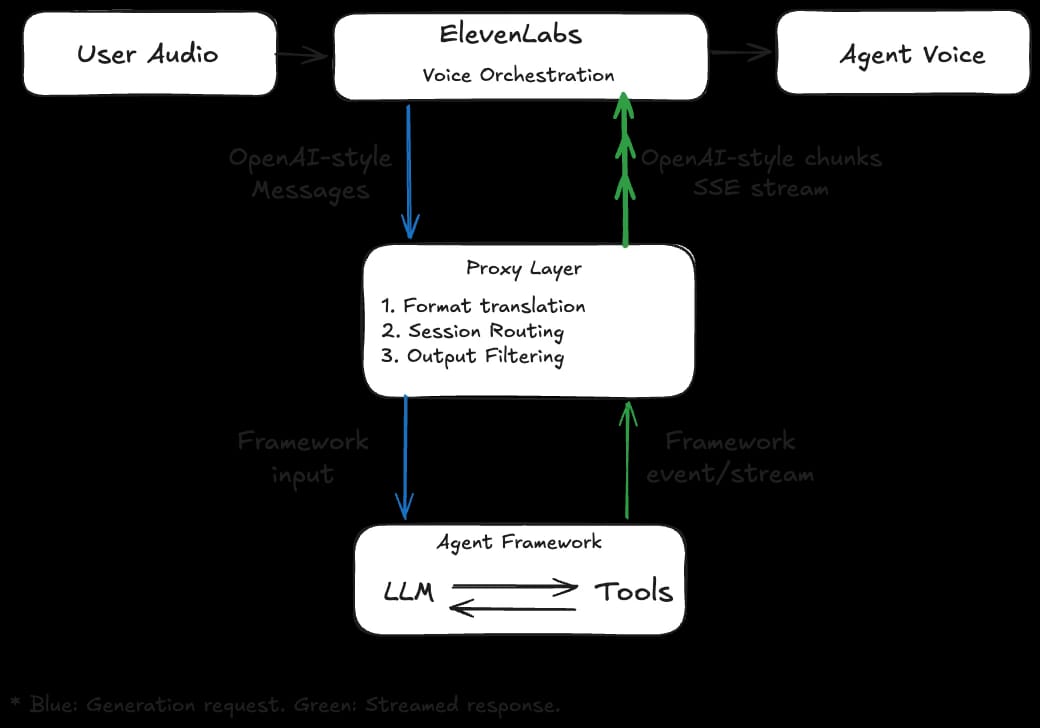
W poprzednim artykule o Integracji zewnętrznych agentów z orkiestracją głosu ElevenLabs, pokazaliśmy, jak zespoły mogą połączyć istniejącą orkiestrację agentów opartą na tekście z ElevenLabs przez Custom LLM. Ten przewodnik pokazuje, jak dostosować i wdrożyć popularne frameworki agentów open source za interfejsem Custom LLM. Powstaje elastyczna architektura, w której głos nakłada się na dojrzałe systemy agentowe bez uszczerbku dla zarządzania stanem, orkiestracji narzędzi czy kontroli specyficznej dla aplikacji. Niezależnie od frameworka stosujemy ten sam trzyetapowy schemat: utworzenie żądania generowania, wyodrębnienie końcowej odpowiedzi tekstowej i sformatowanie jej jako zgodne z OpenAI Server-Sent Events (SSE). ElevenLabs obsługuje formaty Chat Completions i Responses. Chociaż ten przewodnik obejmuje cztery popularne frameworki, opisane wzorce działają w każdym środowisku wykonawczym, które może tworzyć strumieniowe dane wyjściowe zgodne z OpenAI.
Konfiguracja podstawowa
Przykłady w tej sekcji używają Pythona i FastAPI, ale sprawdzi się każdy stos obsługujący żądania HTTP POST i strumieniowe odpowiedzi SSE. Gdy orkiestracja głosu ElevenLabs wykryje prawdopodobny koniec wypowiedzi, wysyła żądanie generowania do skonfigurowanego endpointu Custom LLM. Ta sekcja omawia główne elementy tej warstwy tłumaczącej — mostu lub proxy, dzięki któremu orkiestracja głosu i framework agentowy mówią tym samym językiem.
Klienci mogą wybierać dany framework ze względu na znajomość narzędzia lub jego przydatność do konkretnego zadania. LlamaIndex powstał na przykład po to, by uprościć konfigurację Retrieval-Augmented Generation (RAG), a CrewAI — by automatyzować określone zadania w erze agentów. Różne cele projektowe prowadzą do różnych struktur odpowiedzi, które wymagają odpowiedniej obsługi. Strumieniowanie fragmentów w trakcie generowania przez LLM, zamiast czekania na całą wypowiedź, ma kluczowe znaczenie: model Text-to-Speech (TTS) może wtedy wcześniej zacząć generować mowę, co zmniejsza odczuwalne opóźnienie. Skupiamy się na czterech popularnych frameworkach: LangGraph, Google ADK, CrewAI i LlamaIndex.
Uwaga o wspólnym kodzie
Każdy framework musi przesyłać odpowiedzi jako fragmenty SSE zgodne z OpenAI. Wprowadzamy małą funkcję pomocniczą, używaną we wszystkich przykładach do tworzenia tych fragmentów.
Mając tę podstawę, zacznijmy od LangGraph.
LangGraph
LangGraph modeluje agentów jako grafy, w których węzły reprezentują pojedyncze kroki, a krawędzie określają przepływ sterowania między nimi. Minimalna konfiguracja jest prosta: zainicjuj model czatu, zdefiniuj narzędzia agenta i utwórz środowisko wykonawcze grafu agenta.
Przy każdym żądaniu generowania agent LangGraph otrzymuje pełną historię rozmowy, dzięki czemu może wewnętrznie utrzymywać wymagany stan. LangGraph obsługuje trwałość po stronie serwera przez Checkpoints, ale nie omawiamy ich tutaj, aby zachować minimalną implementację.
Po obsłużeniu zarządzania stanem kolejną decyzją specyficzną dla LangGraph jest tryb strumieniowania. LangGraph oferuje dwie opcje, każda do innego zastosowania:
- stream_mode="values" udostępnia migawki stanu grafu. Jest prostszy we wdrożeniu, ale w każdej odpowiedzi zawiera pełniejszy stan wiadomości, co zwiększa opóźnienie w rozmowach w czasie rzeczywistym.
- stream_mode="messages" przesyła przyrostowe fragmenty wiadomości z modelu. Zwykle jest preferowany przy interakcjach głosowych w czasie rzeczywistym, ponieważ skraca czas do pierwszego audio w warstwie orkiestracji ElevenLabs.
Dokładniej mówiąc, implementacja pętli agenta z messages obejmuje kroki pośrednie, takie jak aktualizacje wywoływania narzędzi, których nie należy odczytywać na głos. Proxy je filtruje i przekazuje do warstwy TTS tylko tekst odpowiedzi widoczny dla użytkownika. Poniżej przykład wypowiedzi z użyciem narzędzia.
[1] Model decyduje się wywołać narzędzie (tool_calls=["get_price"])[2] Narzędzie wykonuje się i zwraca dane (result="$24.99") [3] Model tworzy odpowiedź na podstawie wyniku (content="Kosztuje $24.99")
Oczywiście w strumieniu SSE należy przekazać tylko fragmenty z kroku 3. W praktyce filtrowanie w pętli strumieniowania obsługują dwa warunki: jeden zachowuje tylko zdarzenia langgraph_node == "model", a drugi pomija pustą treść. Razem zapewniają, że do ElevenLabs jako SSE trafia tylko tekst asystenta widoczny dla użytkownika. Łącząc te założenia, otrzymujemy lekką implementację proxy żądań.
Dzięki temu do ElevenLabs trafiają wyłącznie fragmenty modelu widoczne dla użytkownika. Ponieważ LangGraph pokazuje wewnętrzne wykonanie narzędzi w strumieniu stanu, filtrowanie jest jawne i kontrolowane przez proxy.
Teraz przyjrzymy się niuansom pracy z Google Agent Development Kit (ADK)
Google ADK
Google ADK ukrywa pętlę środowiska wykonawczego za kilkoma podstawowymi elementami: Agent, Runner i SessionService. Runner w ADK znajduje się między warstwą HTTP a definicją agenta. Obsługuje kierowanie wiadomości, orkiestrację narzędzi, cykl życia sesji i strumieniowanie zdarzeń.
Po zainicjowaniu agenta, backendu sesji i runnera proxy wyszukuje lub tworzy sesję ADK dla każdego przychodzącego żądania. W ADK session_id kontroluje trwałość pamięci: użycie tego samego session_id w kolejnych wypowiedziach automatycznie przenosi historię, wywołania narzędzi i wcześniejsze odpowiedzi. Tożsamość rozmowy istnieje po stronie ElevenLabs, więc proxy jawnie obsługuje to mapowanie. Po przekazaniu właściwego identyfikatora dla żądania generowania SDK może wewnętrznie obsłużyć wcześniejszy kontekst. Dowolny identyfikator przekazujemy podczas rozpoczęcia rozmowy przez dodatkowe parametry przekazane w treści żądania.
Po przygotowaniu wiadomości i sesji można wywołać runner. Wywołania narzędzi i ich wyniki nadal pojawiają się podczas wykonania jako wewnętrzne zdarzenia ADK, ale są traktowane jako pośrednie kroki orkiestracji, a nie dane wyjściowe dla użytkownika. Eliminuje to potrzebę ręcznego filtrowania, wymaganego w frameworkach, w których wywołania narzędzi pojawiają się jako tekst widoczny dla użytkownika.
Poniższy handler to uproszczona implementacja z obsługą sesji oraz logiką pobierania lub tworzenia sesji w kodzie.
Następnie przyjrzymy się CrewAI, które z założenia bardziej skupia się na zadaniach.
CrewAI
CrewAI zaprojektowano do orkiestracji workflowów wieloagentowych wokół ustrukturyzowanych zadań (badanie, pisanie, podsumowanie), a nie otwartych pętli dialogowych. Agenci są definiowani przez rolę, cel i historię. Wykonanie koncentruje się na obiektach Task, z których każdy ma jasny opis i oczekiwany wynik.
W przeciwieństwie do modelu pętli agenta używanego w LangGraph i ADK, CrewAI zwykle tworzy Task i Crew dla każdego żądania, aby zdefiniować jednostkę pracy dla danej wypowiedzi w rozmowie. Przenosimy kontekst rozmowy, wstawiając wcześniejsze wypowiedzi do kolejnego zadania przez placeholder. Zmienna {crew_chat_messages} jest przy każdym żądaniu wypełniana bieżącą historią rozmowy, a następnie interpolowana w opisie zadania podczas wykonania. Chcemy też uzyskać czysty tekst gotowy do odczytu, więc jawnie odfiltrowujemy pośrednie wzorce śledzenia (Thought, Action, Action Input, Observation) i generujemy wyłącznie tekst końcowej odpowiedzi.
Poniższy handler łączy tworzenie zadań dla każdego żądania, interpolację historii, strumieniowanie na poziomie Crew, filtrowanie śladów i formatowanie danych wyjściowych.
Teraz przyjrzymy się LlamaIndex, które podąża inną ścieżką i skupia się na natywnym, sterowanym zdarzeniami modelu strumieniowania.
LlamaIndex
W przeciwieństwie do innych frameworków omówionych w tym artykule LlamaIndex zaprojektowano do łączenia LLM-ów z zewnętrznymi źródłami danych (repozytoriami dokumentów, indeksami, potokami wyszukiwania). Warstwa agenta, FunctionAgent, bazuje na tym fundamencie, aby wyszukiwać i analizować ustrukturyzowany kontekst, zamiast prowadzić otwarty dialog lub wykonywać zadania.
Aby zachować ciągłość rozmowy, proxy przekształca przychodzące wiadomości w wiadomości czatu LlamaIndex, a następnie dzieli je na najnowszą wypowiedź użytkownika (user_msg) i wcześniejsze wypowiedzi (chat_history). Pole event.delta każdego zdarzenia AgentStream zawiera kolejny fragment tekstu, który bezpośrednio odpowiada fragmentowi delta.content w stylu OpenAI. Niepuste delty można przekazywać bez zmian, co czyni ten most strumieniowania najprostszym w przewodniku. Strumień zawiera zarówno zdarzenia orkiestracji (wywołania narzędzi, wyniki), jak i zdarzenia mowy (delty tekstu asystenta). Aby dane głosowe były czyste, proxy zachowuje tylko zdarzenia AgentStream i pomija puste delty.
[1] AgentStream (delta='') ← pominięto[2] ToolCall ← pominięto[3] ToolCallResult ← pominięto[4] AgentStream (delta='To') ← przekazano ✓[5] AgentStream (delta=' kosztuje') ← przekazano ✓[6] AgentStream (delta=' $49.99')← przekazano ✓
Ten podział nie dopuszcza pośredniej mechaniki narzędzi do odczytywanego tekstu, a jednocześnie zachowuje przyrostową mowę o niskim opóźnieniu. Poniższy gotowy do użycia handler łączy te kroki.
LlamaIndex jest mniej nakazowy w kwestii wzorców działania konwersacyjnego runtime end-to-end niż frameworki z bardziej rozbudowanymi wbudowanymi warstwami orkiestracji. W środowisku produkcyjnym zwykle wymaga to od klientów wdrożenia obsługi sesji, zabezpieczeń odpowiedzi, orkiestracji narzędzi i śledzenia.
Podsumowanie
Każdy framework z tego przewodnika łączy się z ElevenLabs przez tę samą umowę: przyjmuje żądanie Completions lub Responses w stylu OpenAI i przesyła z powrotem fragmenty SSE. Dzięki temu zespoły mogą z niewielkimi zmianami dodać orkiestrację głosu do istniejącej implementacji agenta, zachowując to, co już zbudowały, i odblokowując działające w czasie rzeczywistym Conversational AI. Ta modułowość jest jedną z głównych zasad platformy ElevenAgents. Niezależnie od tego, czy organizacje rozwijają istniejącego agenta, czy od początku budują rozwiązanie głosowe, orkiestracja głosu ElevenAgents jest stworzona tak, by działać z tym, co już mają.
Jeśli już korzystasz z agenta opartego na frameworku open source i chcesz dodać głos, wypróbuj to podejście i daj nam znać, co o nim myślisz.



