Wat is conversational AI-latentie en wat beïnvloedt deze?
- Geschreven door
- Jack Limebear
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Voor conversationele AI is latency wat goede applicaties van geweldige onderscheidt.
Conversationele AI is van nature ambitieus. Het probeert hetzelfde gevoel op te roepen als een gesprek met een mens, met hetzelfde emotionele bereik, dezelfde toonhoogte en hetzelfde ritme. Tel daarbij de ‘natuurlijke’ vertraging op tussen het moment waarop je stopt met spreken en een AI-agent begint te reageren, en je krijgt een latentiedoel dat is gebaseerd op hoe mensen daadwerkelijk communiceren.
Bedrijven die conversationele AI-agenten op schaal willen inzetten, moeten die latency zo veel mogelijk beperken om die natuurlijke illusie te bereiken. Dit artikel behandelt wat latency bij conversationele AI is, wat vertragingen in de hele pipeline veroorzaakt en hoe je deze op hoofdlijnen kunt verminderen.
Samenvatting
- Latency bij conversationele AI is de totale end-to-endvertraging vanaf het moment dat een gebruiker stopt met spreken tot deze het eerste woord van de agent hoort.
- Agenten met meer dan 700 ms kunnen onnatuurlijk aanvoelen; bij meer dan 1.200 ms zijn de afhaakpercentages hoog.
- Latency stapelt zich op in elke fase van de pipeline voor conversationele AI.
- ElevenAgents verwerkt de volledige pipeline in één uniforme architectuur, waardoor conversationele AI met lage latency toegankelijk wordt voor je bedrijf.
Wat is latency bij conversationele AI?
Latency bij conversationele AI verwijst naar de totale tijd die een systeem nodig heeft om te reageren nadat je hebt gesproken. Bij moderne AI-modellen wordt latency gemeten in ms. Achter de schermen bestaat de totale latency uit verschillende afzonderlijke processen, die elk een deel van de end-to-endpipeline vormen.
Een typische pipeline voor conversationele AI ziet er als volgt uit:
- Een gebruiker spreekt
- De audio wordt getranscribeerd door een speech to text-model
- Het transcript wordt doorgegeven aan een LLM-model, dat een reactie produceert
- De tekst van de LLM wordt vervolgens met een Text to Speech-model omgezet in audio
- De audio wordt vervolgens voor de gebruiker afgespeeld
Elk van deze fasen voegt latency toe aan een conversationeel AI-systeem. Daarom zijn er bij het bespreken van latency enkele verschillende afkortingen die we moeten verduidelijken.
Modelinference-latency
Modelinference-latency is de tijd die een model besteedt aan het genereren van output, intern gemeten en zonder externe factoren. Het is de modelspecifieke maatstaf voor hoe snel je engine presteert bij typische inputs. Flash v2.5 heeft bijvoorbeeld een modelinference-latency van ongeveer 75 ms. Daarmee kun je de snelheid van modellen van verschillende aanbieders vergelijken.
Houd er wel rekening mee dat dit niet de latency is die een gebruiker daadwerkelijk ervaart. Deze heeft uitsluitend betrekking op de totale tijd die een model besteedt aan het genereren van output.
LLM-tijd-tot-eerste-token
De time-to-first-token (TTFT) van een large language model (LLM) is de totale tijd die een large language model nodig heeft om een prompt te verwerken en het eerste bruikbare outputtoken te genereren.
TTS-generatie begint zodra het eerste token van je LLM arriveert. Dit meet dus hoe lang de LLM nodig heeft voordat je TTS-model kan beginnen. Voor de meeste end-to-endconversationele AI-systemen vormt LLM TTFT een aanzienlijk deel van de totale latency.
TTS time-to-first-audio (TTFA)
TTS time-to-first-audio (TTFA) meet de tijd vanaf de eerste TTS-request tot het moment waarop het eerste audiochunk het model daadwerkelijk verlaat. Het beschrijft modelinference-latency, maar dan specifiek voor TTS-engines.
End-to-end tijd tot eerste audio (TTFA)
De end-to-end-TTFA is de totale latency van conversationele AI. Het is de som van elk onderdeel van de pipeline, van spraakherkenning, LLM TTFT, TTS, TTFA en alle netwerkoverdrachten tussen de stappen. Als we latency bij conversationele AI als geheel bespreken, is dit de metriek die de gebruiker ervaart.
Wanneer iemand spreekt, wacht diegene op de end-to-end-TTFA voordat er iets van je agent terug te horen is. Het is een holistische maatstaf, wat betekent dat verbetering van elk onderdeel van de pipeline deze waarde verbetert.
Waarom latency bij conversationele AI belangrijk is
Wanneer een gebruiker met je AI-agent praat, wordt latency een belangrijke factor in hoe diegene de ervaring beoordeelt. Lage latency verkort de wachttijd op een reactie, waardoor het gesprek natuurlijk aanvoelt en je agent capabel lijkt.
Agenten met hoge latency voelen kunstmatig en minder competent aan, zelfs als de kwaliteit van hun reacties hetzelfde is. Voor bedrijven kan zelfs een verschil van enkele honderden ms als een eeuwigheid voelen, waardoor je klantenserviceagent log en ineffectief aanvoelt.
Hier zijn enkele scenario’s die laten zien waarom latency bij conversationele AI in de praktijk belangrijk is:
- Onder 500 ms: Een conversationele agent voelt responsief en gestroomlijnd aan. Gebruikers merken mogelijk niet eens de vertraging tussen het stoppen met spreken en hun eerste reactie, waardoor het gesprek soepel verloopt.
- 500 ms tot 1000 ms: De vertraging tussen het moment waarop een gebruiker stopt met spreken en een reactie krijgt, kan merkbaar worden. Deze duurt net iets te lang, waardoor gebruikers zich mogelijk vooraf proberen aan te passen door zichzelf te herhalen of te pauzeren om te zien of de agent hen echt heeft begrepen.
- Boven 1000 ms: Vertragingen beginnen traag aan te voelen, met pauzes waardoor sommige gebruikers het idee krijgen dat de AI-agent het gesprek niet volledig kan bijhouden. Transcripten kunnen af en toe onderbrekingen of verzoeken om met een menselijke agent te spreken tonen. In sommige gevallen beëindigen gebruikers het gesprek.
Elk van deze drempelwaarden vertaalt zich naar concrete bedrijfsresultaten.
Aan de onderkant van het latencyspectrum heb je een klantenserviceagent die inkomende vragen op natuurlijke wijze kan afhandelen en gebruikers zonder extra hulp kan helpen hun vragen op te lossen. Dit verlicht de druk op je menselijke agenten en houdt de klanttevredenheid hoog. Aan de bovenkant van het latencyspectrum frustreer je klanten met een agent die veel te lang lijkt te aarzelen.
In een ander artikel hebben we de benchmarks voor het latencybudget van voice agents gedefinieerd om te laten zien hoe goede latency eruitziet voor zowel P50- als P95-waarden.
Wat veroorzaakt latency bij conversationele AI?
Latency bij conversationele AI is een term die verschillende processen samenvat, waarbij elk segment bijdraagt aan het geheel. Het knelpunt voor lage latency is daarom eerder een probleem op systeemniveau dan iets wat je oplost door simpelweg een beter model te kiezen. Er werken immers meerdere modellen samen in de pipeline.
Voor ontwikkelaars hebben we een uitgebreide technische handleiding geschreven over latencyoptimalisatie voor voice agents die je kunt gebruiken om elke fase van de end-to-end time to first audio (TTFA) te verbeteren.
Naast de kernpipeline voegen ook andere factoren, zoals telefonie en function calling, latency toe, ook al maken ze geen deel uit van de modelinfrastructuur.
Hier volgt een overzicht van alle factoren die bijdragen aan latency bij conversationele AI.
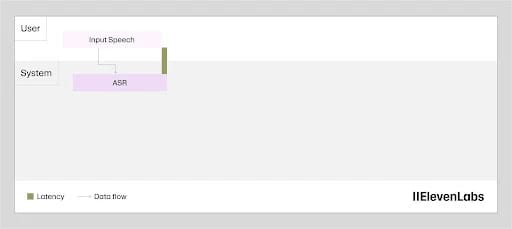
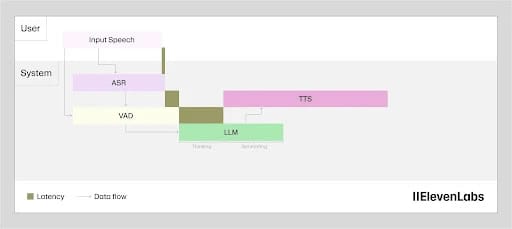
Automatische spraakherkenning
De latency van spraakherkenning is niet de tijd die nodig is om een transcript te genereren. Het transcriptieproces draait op de achtergrond terwijl de gebruiker spreekt, dus wanneer de spraak eindigt, is de tekst grotendeels al klaar.
De latency is hier eigenlijk de tijd tussen het einde van de spraak en het moment waarop het transcript is afgerond en doorgegeven aan de volgende fase. Scribe v2 Realtime verkleint dit verschil tot ongeveer 150 ms en streamt continu, zodat de output klaar is zodra de beurt eindigt.
Beurtwisseling en endpointing
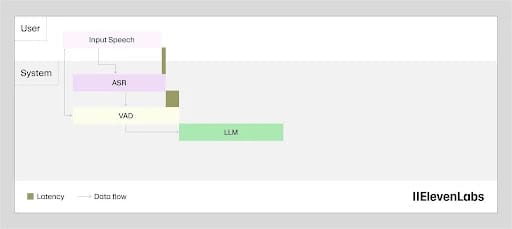
Een Voice Activity Detector (VAD) bevindt zich tussen spraakherkenning en het taalmodel. Deze bepaalt wanneer de gebruiker daadwerkelijk is uitgesproken.
Om fouten te voorkomen, wacht de VAD op een bepaalde periode van aanhoudende stilte voordat deze de beurt als beëindigd markeert. Die wachttijd voegt latency toe voordat het taalmodel een woord verwerkt. Deze kleine extra latency kost tijd, maar voorkomt ook dat het systeem begint te reageren terwijl de gebruiker nog spreekt.
Technisch gezien zou de latency die aan beurtwisseling wordt toegeschreven positief zijn als alle andere onderdelen van conversationele AI geen latency hadden. Mensen nemen ook even de tijd voordat ze op spraak reageren. Een machine die een vergelijkbare pauze neemt, maakt de interactie realistischer. Omdat andere onderdelen van conversationele AI echter al latency veroorzaken, is minimale latency ideaal.
Verwerking door het taalmodel
Zodra het transcript van de Speech to Text-engine (STT) klaar is, genereert het taalmodel een antwoord. Latency is hier de tijd die nodig is om tokens te beginnen genereren, niet om de volledige reactie te genereren. Die tokens worden direct naar de TTS-fase gestreamd zodra ze aankomen, dus TTFT is het belangrijkst.
Naast de modelkeuze hebben zowel de promptlengte als de omvang van de kennisbank invloed op deze fase. Hoe meer context de LLM moet overwegen, hoe langer het duurt. Bij het ontwerpen van deze systemen op schaal wil je de juiste balans vinden tussen een nuttige kennisbank en een beknopte prompt om alles snel te houden.
Spraaksynthese
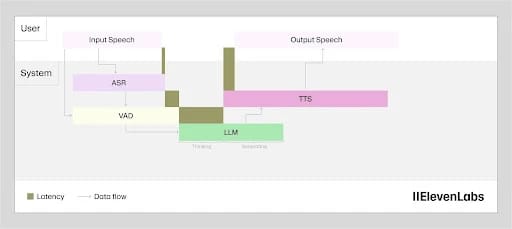
TTS-latency is de tijd tussen het ontvangen van de eerste tokens van het taalmodel en het begin van de audio. Omdat tokens sneller arriveren dan menselijke spraak wordt afgespeeld, wacht het synthesemodel nooit op de volledige reactie. TTS-latency is strikt genomen de tijd tot het eerste audiochunk.
Deze fase was vroeger de grootste afzonderlijke factor in latency bij conversationele AI: oudere modellen hadden 2-3 seconden nodig om spraak te genereren. Flash v2.5 van ElevenLabs pakt dit rechtstreeks aan met spraaksynthese met een latency van ~75 ms, waardoor dit knelpunt van seconden wordt teruggebracht naar een fractie van een seconde.
Netwerklatency
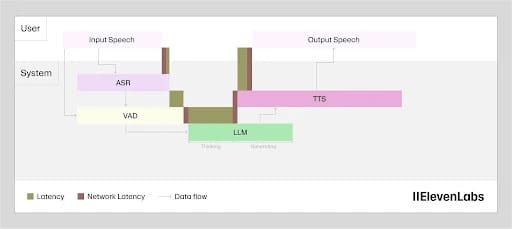
Het versturen van data van de ene locatie naar de andere voegt altijd latency toe, waarbij geografische afstand de round-tripnetwerklatency alleen maar vergroot.
Doordat meerdere componenten samenwerken voor een end-to-endreactie, kan aanzienlijke latency zich opstapelen over meerdere netwerksprongen.
Functieaanroepen
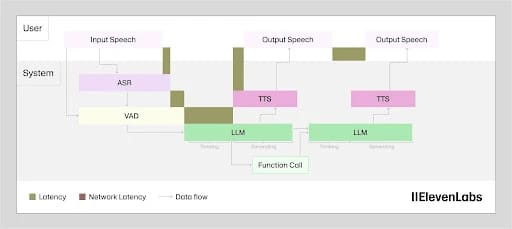
Function calls voegen API-round-trips toe in de LLM-fase. Een snelle interne lookup voegt tientallen milliseconden toe, terwijl een betalingsverwerker of voorraadsysteem seconden kan toevoegen. De hoeveelheid latency hangt volledig af van de aangeroepen service, waardoor dit de lastigste fase is om rechtstreeks te optimaliseren.
Het effectiefste patroon is de LLM de opdracht geven te reageren voordat de tool call is voltooid. Een zin als "Laat me dat voor je controleren" houdt de gebruiker betrokken terwijl de externe call wordt afgehandeld, in plaats van stilte te laten vallen. De gesproken reactie begint terwijl de tool parallel draait.
Latency bij conversationele AI verminderen
Om latency bij conversationele AI te verminderen, moet je elke pipelinefase aanpakken in volgorde van impact. Afzonderlijke verbeteringen die je aanbrengt hebben wel invloed op latency, maar je moet de hele pipeline holistisch aanpakken om de grootste verandering te zien.
Hier zijn enkele principes die je op hoofdlijnen kunnen helpen de latency van conversationele AI te verminderen:
- TTS-modelselectie: Voor snelheid geoptimaliseerde TTS-modellen zoals Flash v2.5 gebruiken andere architecturen dan voor kwaliteit geoptimaliseerde modellen zoals Eleven v3 en Eleven v4. Voor realtime spraakagenten is de juiste keuze het model met de hoogste kwaliteit dat aan je latentiedoel voldoet, en dat is vrijwel altijd een model dat voor snelheid is geoptimaliseerd.
- LLM-modelselectie: Kleinere, snellere LLM's leveren doorgaans een lagere time-to-first-token dan grotere modellen. Het kiezen van de snelste LLM die nog steeds aan je kwaliteitsnorm voor de taak voldoet, is net zo belangrijk als de keuze van een TTS-model.
- Streaming: Streaming TTS levert audio in chunks terwijl de synthese doorgaat, zodat de gebruiker het eerste woord hoort terwijl het model de rest nog genereert. Dit concept geldt ook voor de LLM-output: door de TTS-synthese bij de eerste zin te starten terwijl het taalmodel volgende zinnen genereert, kun je latency uit de pipeline terugwinnen.
- Systeemprompt-ontwerp: Gebruikers kunnen system prompts stroomlijnen door instructies naar procedures of workflows te verplaatsen, in plaats van ze onderdeel te maken van elke beslissingsstap. Zo verminder je de hoeveelheid context waarover het model bij elke beurt moet redeneren.
- Guardrails: Door guardrails in het streamingmodel uit te voeren, kan de output worden afgespeeld voordat de guardrailcontrole is voltooid, in plaats van het afspelen te blokkeren totdat de controle klaar is.
- Collocatie van modellen: Door waar mogelijk gecolloceerde modellen te gebruiken, zoals de ElevenLabs Agents-stack, blijven componenten dicht bij elkaar zodat latency niet toeneemt door sprongen tussen afzonderlijk gehoste modellen.
- Geografie: Als je servers en gebruikers dicht bij elkaar zijn, kan dat latency aanzienlijk verminderen, omdat dit de netwerkbijdrage aan end-to-end-TTFA rechtstreeks verlaagt.
Naast deze factoren kun je deze technische handleiding voor latencyoptimalisatie gebruiken voor meer details.
Ga aan de slag met conversationele AI met lage latency op ElevenAgents
Latency bij conversationele AI is een belangrijke overweging bij het bouwen en implementeren van agenten. Met ElevenAgents is latencyoptimalisatie ingebouwd in het proces. Van overlaptechnieken om tijd terug te winnen tot lage modelinference-latency voor afzonderlijke componenten: ElevenAgents bouwt conversationele AI-stacks met lage latency voor je bedrijf.
Uiteindelijk is het doel om realisme te creëren. Een gebruiker moet het gemak van een gesprek met een mens ervaren, met de voordelen van een computerprogramma. Door de subprocessen te optimaliseren, is dat nu mogelijk.
Ontdek meer informatie over ElevenAgents of neem contact op met sales om vandaag nog aan de slag te gaan.
Veelgestelde vragen over latency bij conversationele AI

Jack Limebear maakt deel uit van het Growth-team en werkt als contentschrijver en strateeg voor de blog- en inzichtpagina's. Voordat hij bij ElevenLabs kwam, gaf hij meer dan tien jaar leiding aan contentstrategieën voor organisaties, van snelgroeiende SaaS-startups tot Fortune 500-bedrijven. Hij heeft een master in Engelse literatuur van de University of Cambridge.