
실무 가이드: 오픈 소스 에이전트 프레임워크와 ElevenAgents
- 게시일
- 최종 업데이트
듣기이 글 오디오로 듣기
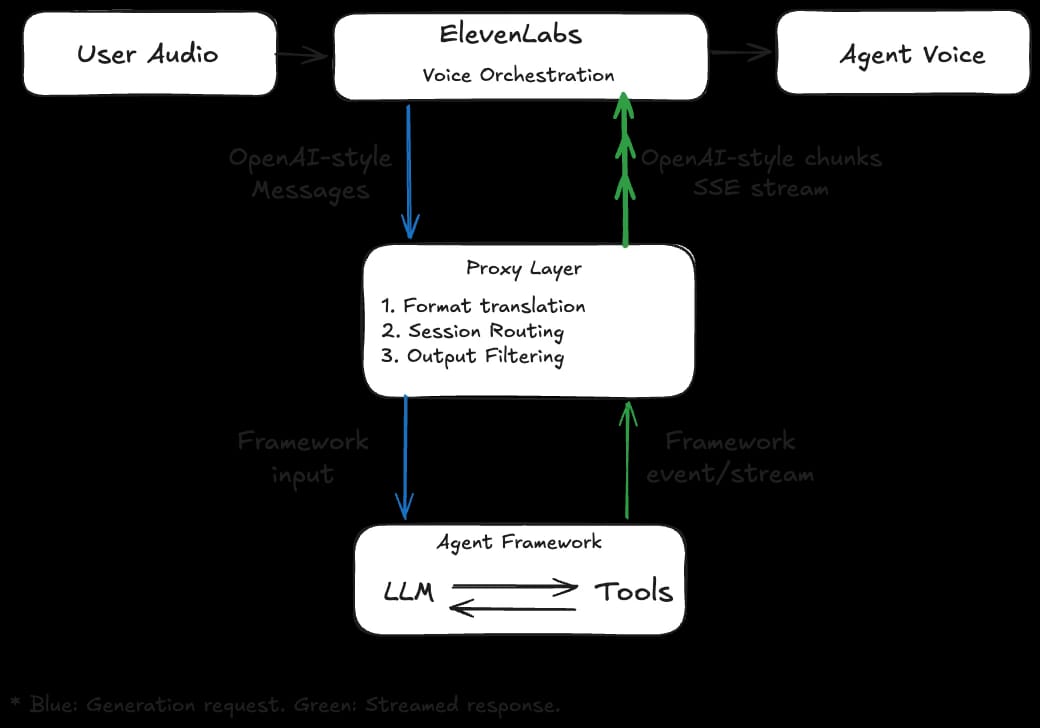
이전 글인 ElevenLabs 음성 오케스트레이션에 외부 에이전트 통합하기에서는 팀이 기존 텍스트 기반 에이전트 오케스트레이션을 ElevenLabs에 연결하는 방법을 Custom LLM을 통해 살펴봤습니다. 이 기반 위에서, 이 가이드는 주요 오픈 소스 에이전트 프레임워크를 Custom LLM 인터페이스 뒤에 맞춰 적용하고 배포하는 방법을 설명합니다. 그 결과 상태 관리, 도구 오케스트레이션 또는 애플리케이션별 제어 기능을 손상하지 않으면서, 성숙한 에이전트 시스템에 음성을 더할 수 있는 유연한 아키텍처가 완성됩니다. 프레임워크와 관계없이 동일한 3단계 패턴을 따릅니다. 생성 요청을 만들고, 최종 텍스트 응답을 추출한 뒤, OpenAI 호환 Server-Sent Events(SSE) 형식으로 다시 포맷합니다. ElevenLabs는 Chat Completions 및 Responses 형식을 모두 지원합니다. 이 가이드에서는 널리 쓰이는 4가지 프레임워크를 다루지만, 이러한 패턴은 OpenAI 호환 스트리밍 출력을 생성할 수 있는 모든 런타임에 적용할 수 있습니다.
일반 설정
이 섹션의 예제는 Python과 FastAPI를 사용하지만, HTTP POST 요청과 스트리밍 SSE 응답을 처리할 수 있다면 어떤 스택이든 사용할 수 있습니다. ElevenLabs의 음성 오케스트레이션이 발화 종료 가능성을 감지하면, 구성된 Custom LLM 엔드포인트로 생성 요청을 보냅니다. 이 섹션에서는 음성 오케스트레이션과 에이전트 프레임워크가 같은 언어로 통신하도록 하는 브리지 또는 프록시, 즉 변환 계층의 핵심 구성 요소를 살펴봅니다.
각 프레임워크는 일반적인 친숙도나 특정 목적을 수행할 수 있는 능력에 따라 선택될 수 있습니다. 예를 들어 LlamaIndex는 검색 증강 생성(RAG) 설정을 간편하게 하기 위해 처음 개발된 반면, CrewAI는 에이전트 시대에 정의된 작업을 자동화하도록 구축되었습니다. 설계 목표가 다르면 응답 구조도 달라지며, 각기 다른 처리가 필요합니다. 전체 발화가 완료되기를 기다리지 않고 LLM이 생성하는 대로 청크를 스트리밍하는 것은 매우 중요합니다. 텍스트 음성 변환(TTS) 모델이 더 일찍 음성을 생성하기 시작해 체감 지연 시간을 줄일 수 있기 때문입니다. 여기서는 주로 LangGraph, Google ADK, CrewAI, LlamaIndex라는 4가지 인기 프레임워크에 집중합니다.
공통 코드 참고 사항
각 프레임워크는 OpenAI 호환 SSE 청크로 응답을 스트리밍해야 합니다. 이 청크를 구성하기 위해 예제 전반에서 사용하는 작은 헬퍼 함수를 소개합니다.
이 기반을 갖췄으니 LangGraph부터 시작하겠습니다.
LangGraph
LangGraph는 에이전트를 그래프로 모델링합니다. 노드는 개별 단계를 나타내고, 엣지는 노드 간 제어 흐름을 정의합니다. 최소 구성은 간단합니다. 채팅 모델을 초기화하고, 에이전트 도구를 정의한 다음, 에이전트 그래프 런타임을 생성하면 됩니다.
각 생성 요청에서 LangGraph Agent는 전체 대화 기록을 수신하므로 필요한 상태를 내부적으로 유지할 수 있습니다. LangGraph는 Checkpoints를 통한 서버 측 영속성을 지원하지만, 구현을 간결하게 유지하기 위해 여기서는 다루지 않습니다.
상태 관리가 처리되면, 다음 LangGraph 전용 결정 사항은 스트리밍 모드입니다. LangGraph는 각기 다른 사용 사례에 적합한 두 가지 옵션을 제공합니다.
- stream_mode="values"는 그래프 상태 스냅샷을 제공합니다. 구현은 더 간단하지만, 매 응답에 더 많은 메시지 상태가 포함되어 실시간 대화 흐름의 지연 시간이 늘어납니다.
- stream_mode="messages"는 모델의 증분 메시지 청크를 스트리밍합니다. ElevenLabs 오케스트레이션 계층에서 첫 오디오 생성까지의 시간을 줄이므로, 일반적으로 실시간 음성 상호작용에 더 적합합니다.
좀 더 구체적으로 말하면, 에이전트 루프의 messages 구현에는 도구 호출 업데이트처럼 소리 내어 말하면 안 되는 중간 단계가 포함됩니다. 프록시는 이를 필터링하여 사용자에게 보여 줄 응답 텍스트만 TTS 계층으로 전달합니다. 도구가 사용되는 발화의 예를 살펴보겠습니다.
[1] 모델이 도구 호출을 결정함 (tool_calls=["get_price"])[2] 도구가 실행되어 데이터를 반환함 (result="$24.99") [3] 모델이 결과를 사용해 응답을 생성함 (content="가격은 $24.99입니다")
당연히 3단계의 청크만 SSE 스트림으로 전달해야 합니다. 실제로는 스트리밍 루프의 두 가지 가드 검사로 이를 필터링합니다. 하나는 langgraph_node == "model" 이벤트만 유지하고, 다른 하나는 빈 콘텐츠를 건너뜁니다. 이 검사들을 함께 사용하면 사용자에게 보이는 어시스턴트 텍스트만 SSE로 ElevenLabs에 전달됩니다. 이 개념을 종합해, 가벼운 요청 프록시 구현을 제공합니다.
이렇게 하면 사용자에게 보이는 모델 청크만 ElevenLabs에 전달됩니다. LangGraph는 내부 도구 실행을 상태 스트림을 통해 노출하므로, 필터링은 명시적이며 프록시가 제어합니다.
다음으로 Google의 Agent Development Kit(ADK)를 사용할 때의 세부 사항을 살펴보겠습니다.
Google ADK
Google ADK는 몇 가지 핵심 프리미티브인 Agent, Runner, SessionService 뒤로 런타임 루프를 추상화합니다. ADK의 Runner는 HTTP 계층과 에이전트 정의 사이에 위치합니다. 메시지 라우팅, 도구 오케스트레이션, 세션 수명 주기, 이벤트 스트리밍을 처리합니다.
에이전트, 세션 백엔드, Runner를 초기화한 뒤 프록시는 들어오는 각 요청에 맞는 ADK 세션을 확인하거나 생성합니다. ADK에서 session_id는 메모리 영속성을 제어합니다. 여러 발화에 걸쳐 동일한 session_id를 재사용하면 기록, 도구 호출, 이전 응답이 자동으로 이어집니다. 대화 ID는 ElevenLabs 업스트림에 있으므로 프록시가 이 매핑을 명시적으로 처리합니다. 생성 요청에 올바른 식별자를 전달하면 SDK가 이전 컨텍스트를 내부적으로 처리할 수 있습니다. 대화 시작 시 추가 파라미터를 요청 본문에 전달하여 임의의 식별자를 보냅니다.
메시지와 세션을 준비하면 Runner를 호출할 수 있습니다. 실행 중에도 도구 호출과 도구 결과는 내부 ADK 이벤트로 나타나지만, 사용자에게 보이는 출력이 아니라 중간 오케스트레이션 단계로 처리됩니다. 따라서 도구 호출이 사용자에게 보이는 텍스트로 나타나는 프레임워크와 달리 수동 필터가 필요하지 않습니다.
아래 핸들러는 세션 확인 및 조회 또는 생성 로직을 인라인으로 포함한 간소화된 구현입니다.
다음으로, 설계상 작업 중심적인 CrewAI를 살펴보겠습니다.
CrewAI
CrewAI는 멀티 에이전트 워크플로를 개방형 대화 루프가 아닌 구조화된 작업(조사, 작성, 요약)을 중심으로 오케스트레이션하도록 설계되었습니다. 에이전트는 역할, 목표, 배경 이야기로 정의됩니다. 실행은 각각 명확한 설명과 예상 출력을 갖춘 Task 객체를 중심으로 이루어집니다.
LangGraph와 ADK에서 사용하는 에이전트 루프 모델과 달리, CrewAI는 일반적으로 요청마다 Task와 Crew를 구성하여 해당 대화 발화의 작업 단위를 정의합니다. 플레이스홀더를 통해 이전 발화를 다음 작업에 주입하여 대화 컨텍스트를 유지합니다. {crew_chat_messages} 변수는 각 요청에서 누적 대화 기록으로 채워지고, 실행 시 작업 설명에 삽입됩니다. 또한 중간 추적 패턴(Thought, Action, Action Input, Observation)을 명시적으로 필터링하고 최종 답변 텍스트만 내보내, 깔끔하게 음성으로 사용할 수 있는 텍스트를 생성합니다.
아래 핸들러는 요청별 작업 구성, 기록 삽입, Crew 수준 스트리밍, 추적 필터링, 출력 포맷팅을 결합합니다.
다음으로 네이티브 이벤트 기반 스트리밍 모델에 집중하는 다른 접근 방식의 LlamaIndex를 살펴보겠습니다.
LlamaIndex
이 글에서 다룬 다른 프레임워크와 달리, LlamaIndex는 LLM을 외부 데이터 소스(문서 저장소, 인덱스, 검색 파이프라인)에 연결하도록 설계되었습니다. 에이전트 계층인 FunctionAgent는 개방형 대화나 작업 실행 대신, 이 기반 위에서 구조화된 컨텍스트를 검색하고 추론합니다.
대화의 연속성을 유지하기 위해 프록시는 들어오는 메시지를 LlamaIndex 채팅 메시지로 변환한 후, 이를 최신 사용자 발화(user_msg)와 이전 발화(chat_history)로 나눕니다. 각 AgentStream 이벤트의 event.delta 필드에는 다음 텍스트 조각이 포함되며, 이는 OpenAI 스타일의 delta.content 청크에 직접 매핑됩니다. 비어 있지 않은 delta는 그대로 전달할 수 있어, 이 가이드에서 가장 간단한 스트리밍 브리지입니다. 스트림에는 오케스트레이션 이벤트(도구 호출, 결과)와 음성 이벤트(어시스턴트 텍스트 delta)가 모두 포함됩니다. 음성 출력을 깔끔하게 유지하기 위해 프록시는 AgentStream 이벤트만 유지하고 빈 delta는 건너뜁니다.
[1] AgentStream (delta='') ← 무시됨[2] ToolCall ← 무시됨[3] ToolCallResult ← 무시됨[4] AgentStream (delta='It') ← 전달됨 ✓[5] AgentStream (delta=' costs') ← 전달됨 ✓[6] AgentStream (delta=' $49.99')← 전달됨 ✓
이 분리를 통해 중간 도구 메커니즘은 음성 출력에서 제외하면서도, 지연 시간이 짧은 증분 음성을 유지할 수 있습니다. 아래의 바로 적용할 수 있는 핸들러는 이 단계를 함께 구현합니다.
LlamaIndex는 더 무거운 내장 오케스트레이션 계층을 갖춘 프레임워크보다 엔드 투 엔드 대화 런타임 패턴을 덜 규정합니다. 프로덕션 배포에서는 일반적으로 고객이 세션 처리, 응답 가드레일, 도구 오케스트레이션, 추적을 구현해야 합니다.
결론
이 가이드의 각 프레임워크는 동일한 계약을 통해 ElevenLabs에 연결됩니다. OpenAI 스타일의 Completions 또는 Responses 요청을 수락하고 SSE 청크를 스트리밍으로 반환합니다. 이를 통해 팀은 기존에 구축한 것을 유지하면서 최소한의 변경으로 기존 에이전트 구현 위에 음성 오케스트레이션을 추가하고, 실시간 대화형 AI를 구현할 수 있습니다. 이 모듈성은 ElevenAgents 플랫폼의 핵심 원칙입니다. 조직이 기존 에이전트를 확장하든 처음부터 음성 네이티브로 구축하든, ElevenAgents의 음성 오케스트레이션은 현재 위치에서 바로 시작할 수 있도록 설계되었습니다.
이미 오픈 소스 프레임워크로 에이전트를 운영하고 있고 음성을 활성화하고 싶다면, 이 방식을 사용해 보시고 의견을 들려주세요.
Akhil은 ElevenLabs의 Forward Deployed Engineering 팀에서 고객이 에이전트를 구축하고 배포할 수 있도록 지원하고 있습니다. 이전에는 GTM 팀을 위한 AI 기반 제품을 개발했으며, Orgvue에서 솔루션 엔지니어 리드를 맡았습니다.

