
Testare gli agenti conversazionali IA
- Scritto da
- Anna Neely
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Quando gli agenti vocali conversazionali vengono messi in produzione, come li monitori su larga scala? Come individui quando non si comportano come previsto? E, dopo aver apportato modifiche, come li testi?
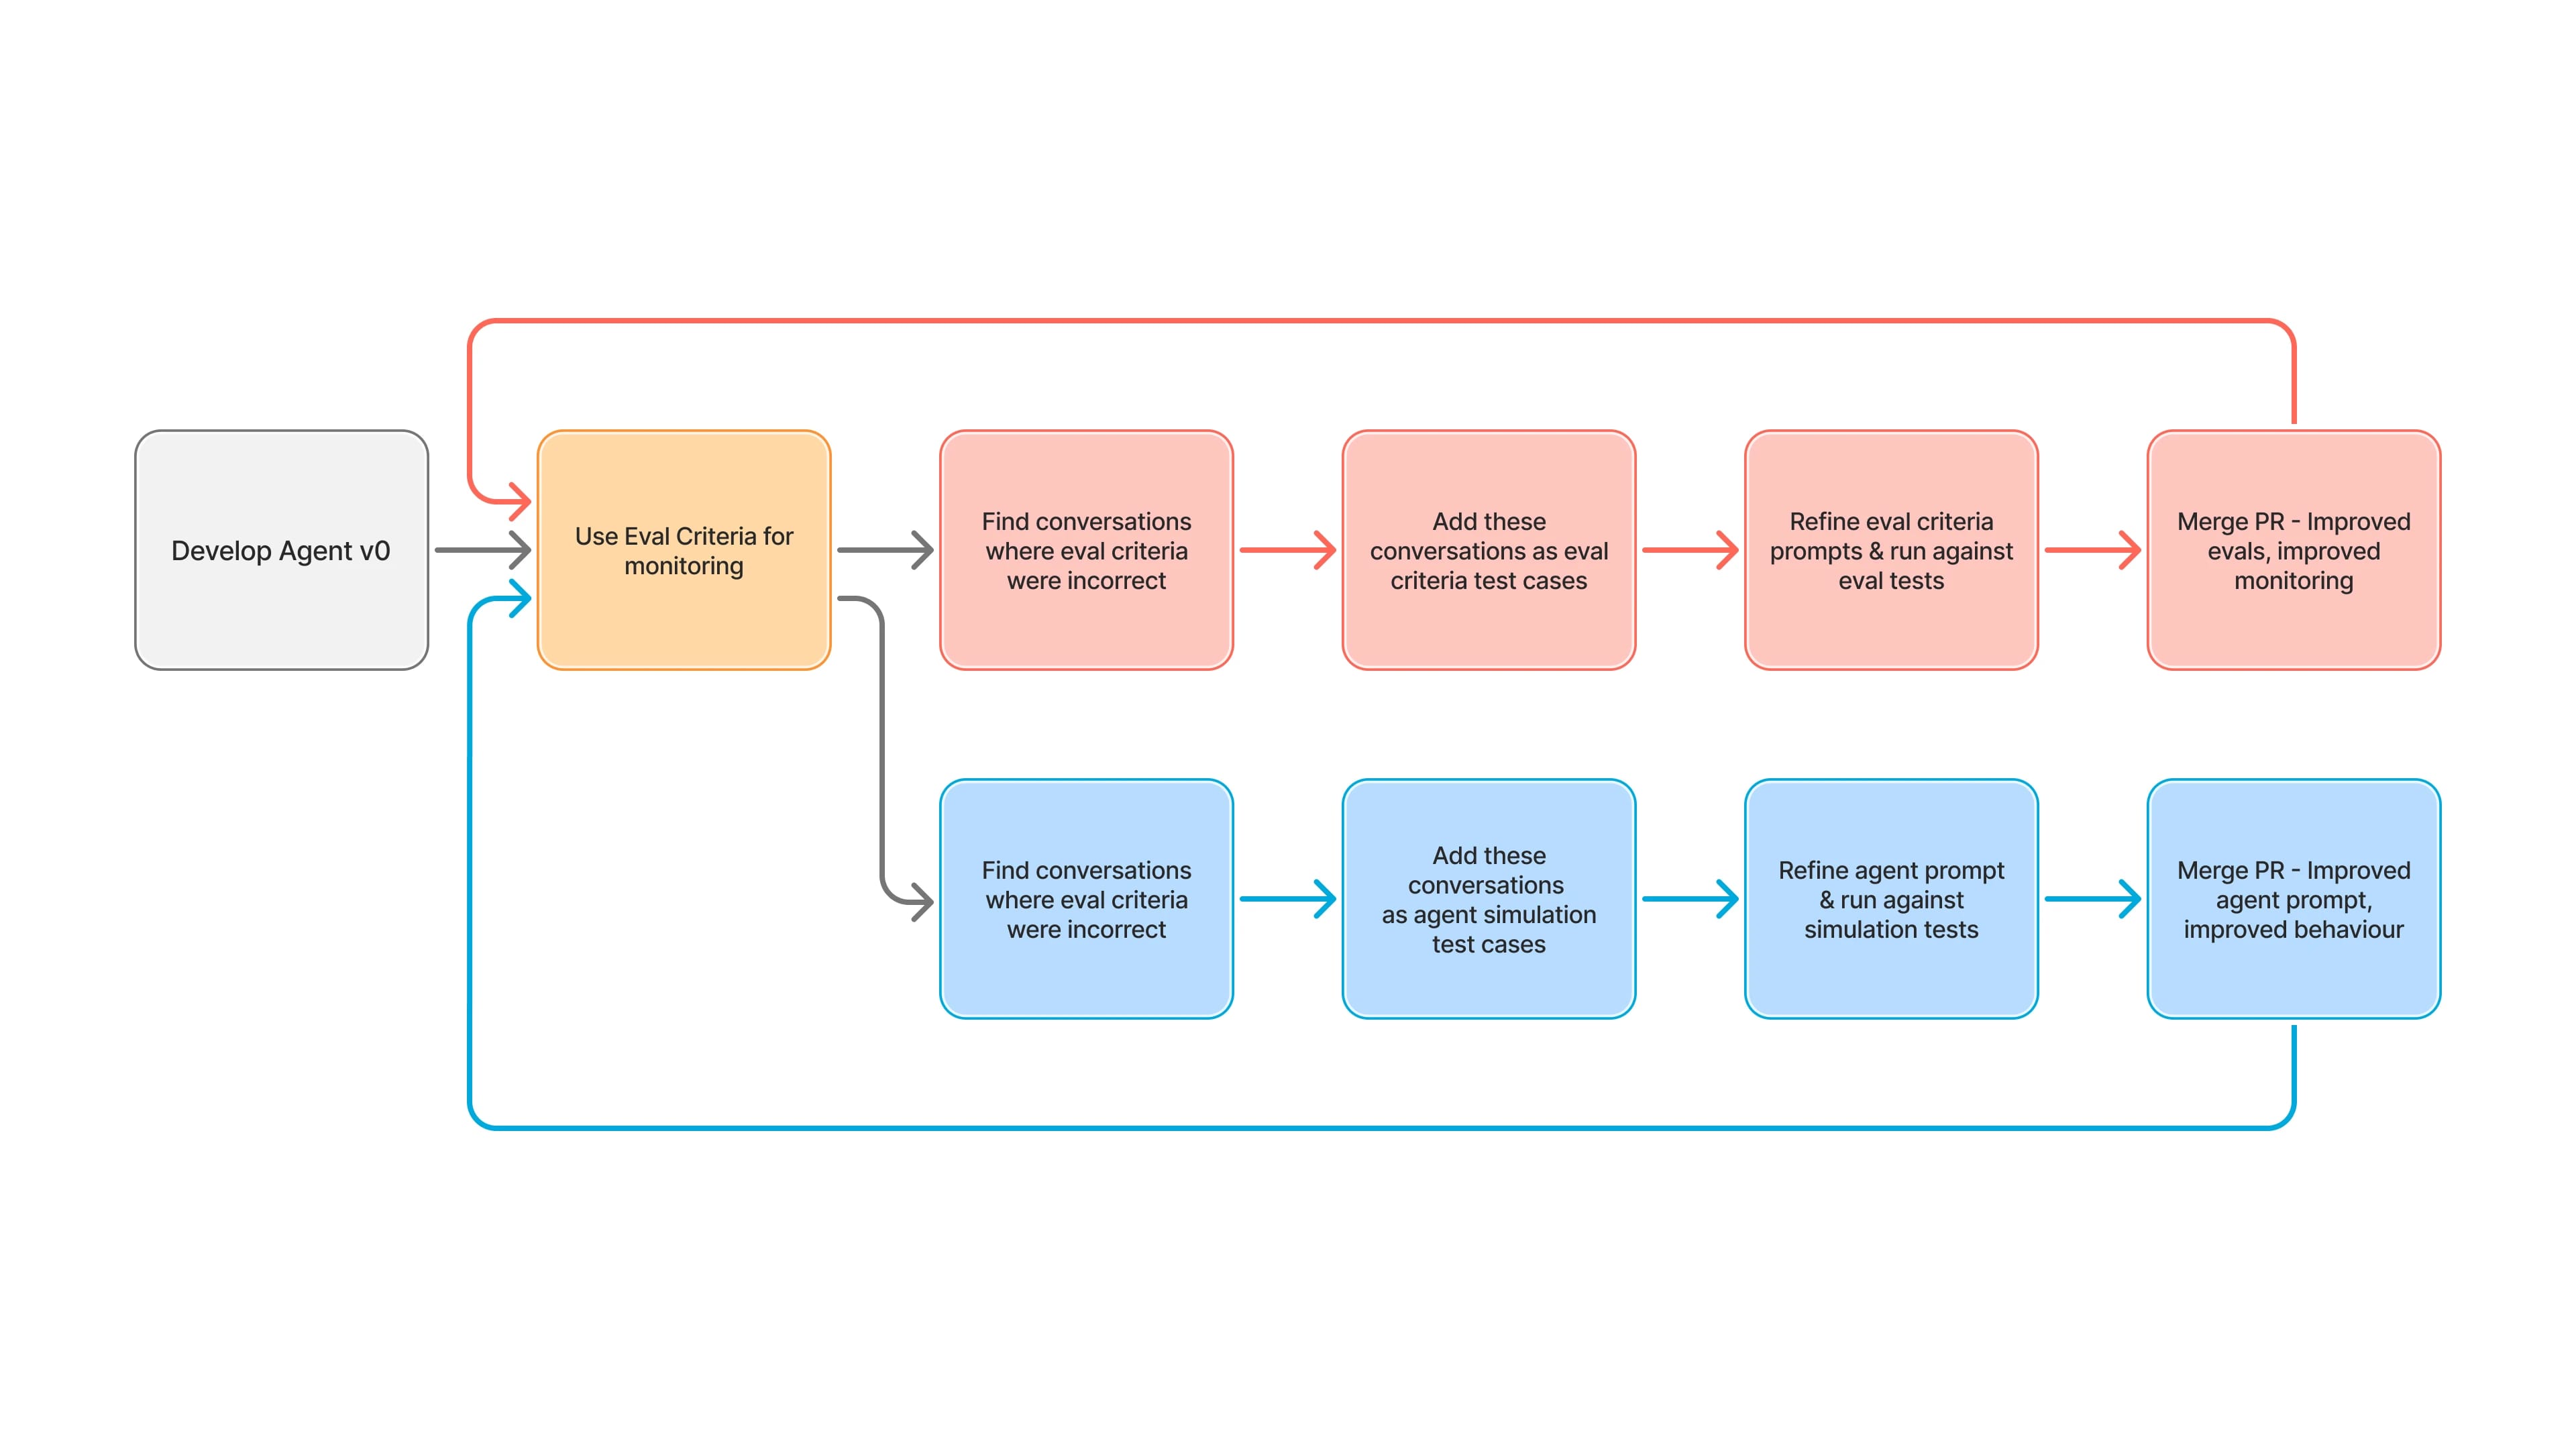
Queste domande hanno guidato il nostro lavoro su El, il nostro assistente per la documentazione basato su IA conversazionale. Con l'evoluzione di El, abbiamo creato un sistema per monitorare, valutare e testare gli agenti, basato su criteri di valutazione e simulazioni di conversazioni.
Creare le basi: criteri di valutazione affidabili
Per migliorare un agente bisogna prima capire come si comporta nell'uso reale. Per questo abbiamo perfezionato i nostri criteri di valutazione e ci siamo assicurati che fossero sufficientemente accurati e affidabili per monitorarne le prestazioni. Definiamo come fallita una conversazione in cui l'agente fornisce informazioni errate o non aiuta l'utente a raggiungere il proprio obiettivo.
Abbiamo sviluppato i seguenti criteri di valutazione:
- Interazione: la conversazione è valida, l'utente ha posto domande pertinenti, la conversazione ha senso?
- Interazione positiva: l'utente è rimasto soddisfatto o era confuso o frustrato?
- Comprensione della causa principale: l'agente ha identificato correttamente il problema alla base della richiesta dell'utente?
- Risoluzione della richiesta dell'utente: l'agente ha risolto il problema dell'utente o fornito un metodo di assistenza alternativo?
- Allucinazione: l'agente ha inventato informazioni che non sono presenti nella knowledge base?
Se Interazione fallisce, la conversazione stessa non è valida. Se fallisce uno qualsiasi degli altri criteri, approfondiamo l'analisi. L'analisi ci indica come migliorare l'agente. A volte si tratta di perfezionare l'uso degli strumenti o le tempistiche. Altre volte, di aggiungere guardrail per impedire azioni non supportate.
Iterare con sicurezza: API di simulazione delle conversazioni
Dopo aver identificato cosa migliorare, il passo successivo è il testing. È qui che entra in gioco la nostra API di simulazione delle conversazioni . Simula scenari utente realistici, sia end-to-end sia in segmenti mirati, e valuta automaticamente i risultati usando gli stessi criteri che applichiamo in produzione. Supporta il mocking degli strumenti e valutazioni personalizzate, offrendo la flessibilità necessaria per testare comportamenti specifici.
Utilizziamo due approcci:
- Simulazioni complete: Testa intere conversazioni dall'inizio alla fine.
- Simulazioni parziali: inizia a metà conversazione per convalidare punti decisionali o sotto-flussi. È il nostro metodo preferito per gli unit test, perché consente iterazioni rapide e debugging mirato.
Scenari chiari e mirati ci permettono di controllare cosa viene testato dall'LLM, garantendo la copertura di edge case, utilizzo degli strumenti e logica di fallback.
Automazione su larga scala: integrare i test in CI/CD
L'ultimo tassello è l'automazione. Abbiamo usato le API aperte di ElevenLabs per collegarci al nostro flusso DevOps su GitHub, integrando valutazione e simulazione nella nostra pipeline CI/CD. Ogni aggiornamento viene testato automaticamente prima del deployment. Questo previene le regressioni e ci offre rapidamente feedback sulle prestazioni nel mondo reale.
Risultati: un El più solido e intelligente
Questo processo ha trasformato il modo in cui sviluppiamo e gestiamo El. Abbiamo creato un ciclo di feedback che collega l'utilizzo reale a valutazioni strutturate, test mirati e convalida automatizzata, consentendoci di rilasciare miglioramenti più velocemente e con maggiore sicurezza.
Ed è un framework che ora possiamo applicare a qualsiasi agente sviluppiamo.
Anna Neely focuses on product strategy and partners with enterprise customers on solution design and implementation



