Stream crea agenti IA multimodali con ElevenLabs
- Scritto da
- Fergal Burnett Small
- Pubblicato
AscoltaAscolta questo articolo
Stream ha presentato Vision Agents, un framework open source che consente agli sviluppatori di creare esperienze IA multimodali a bassa latenza, combinando video, audio e conversazioni in tempo reale. Il framework integra ElevenLabs Text to Speech per offrire voci espressive e reattive, che permettono un'interazione fluida tra gli utenti e i sistemi IA.
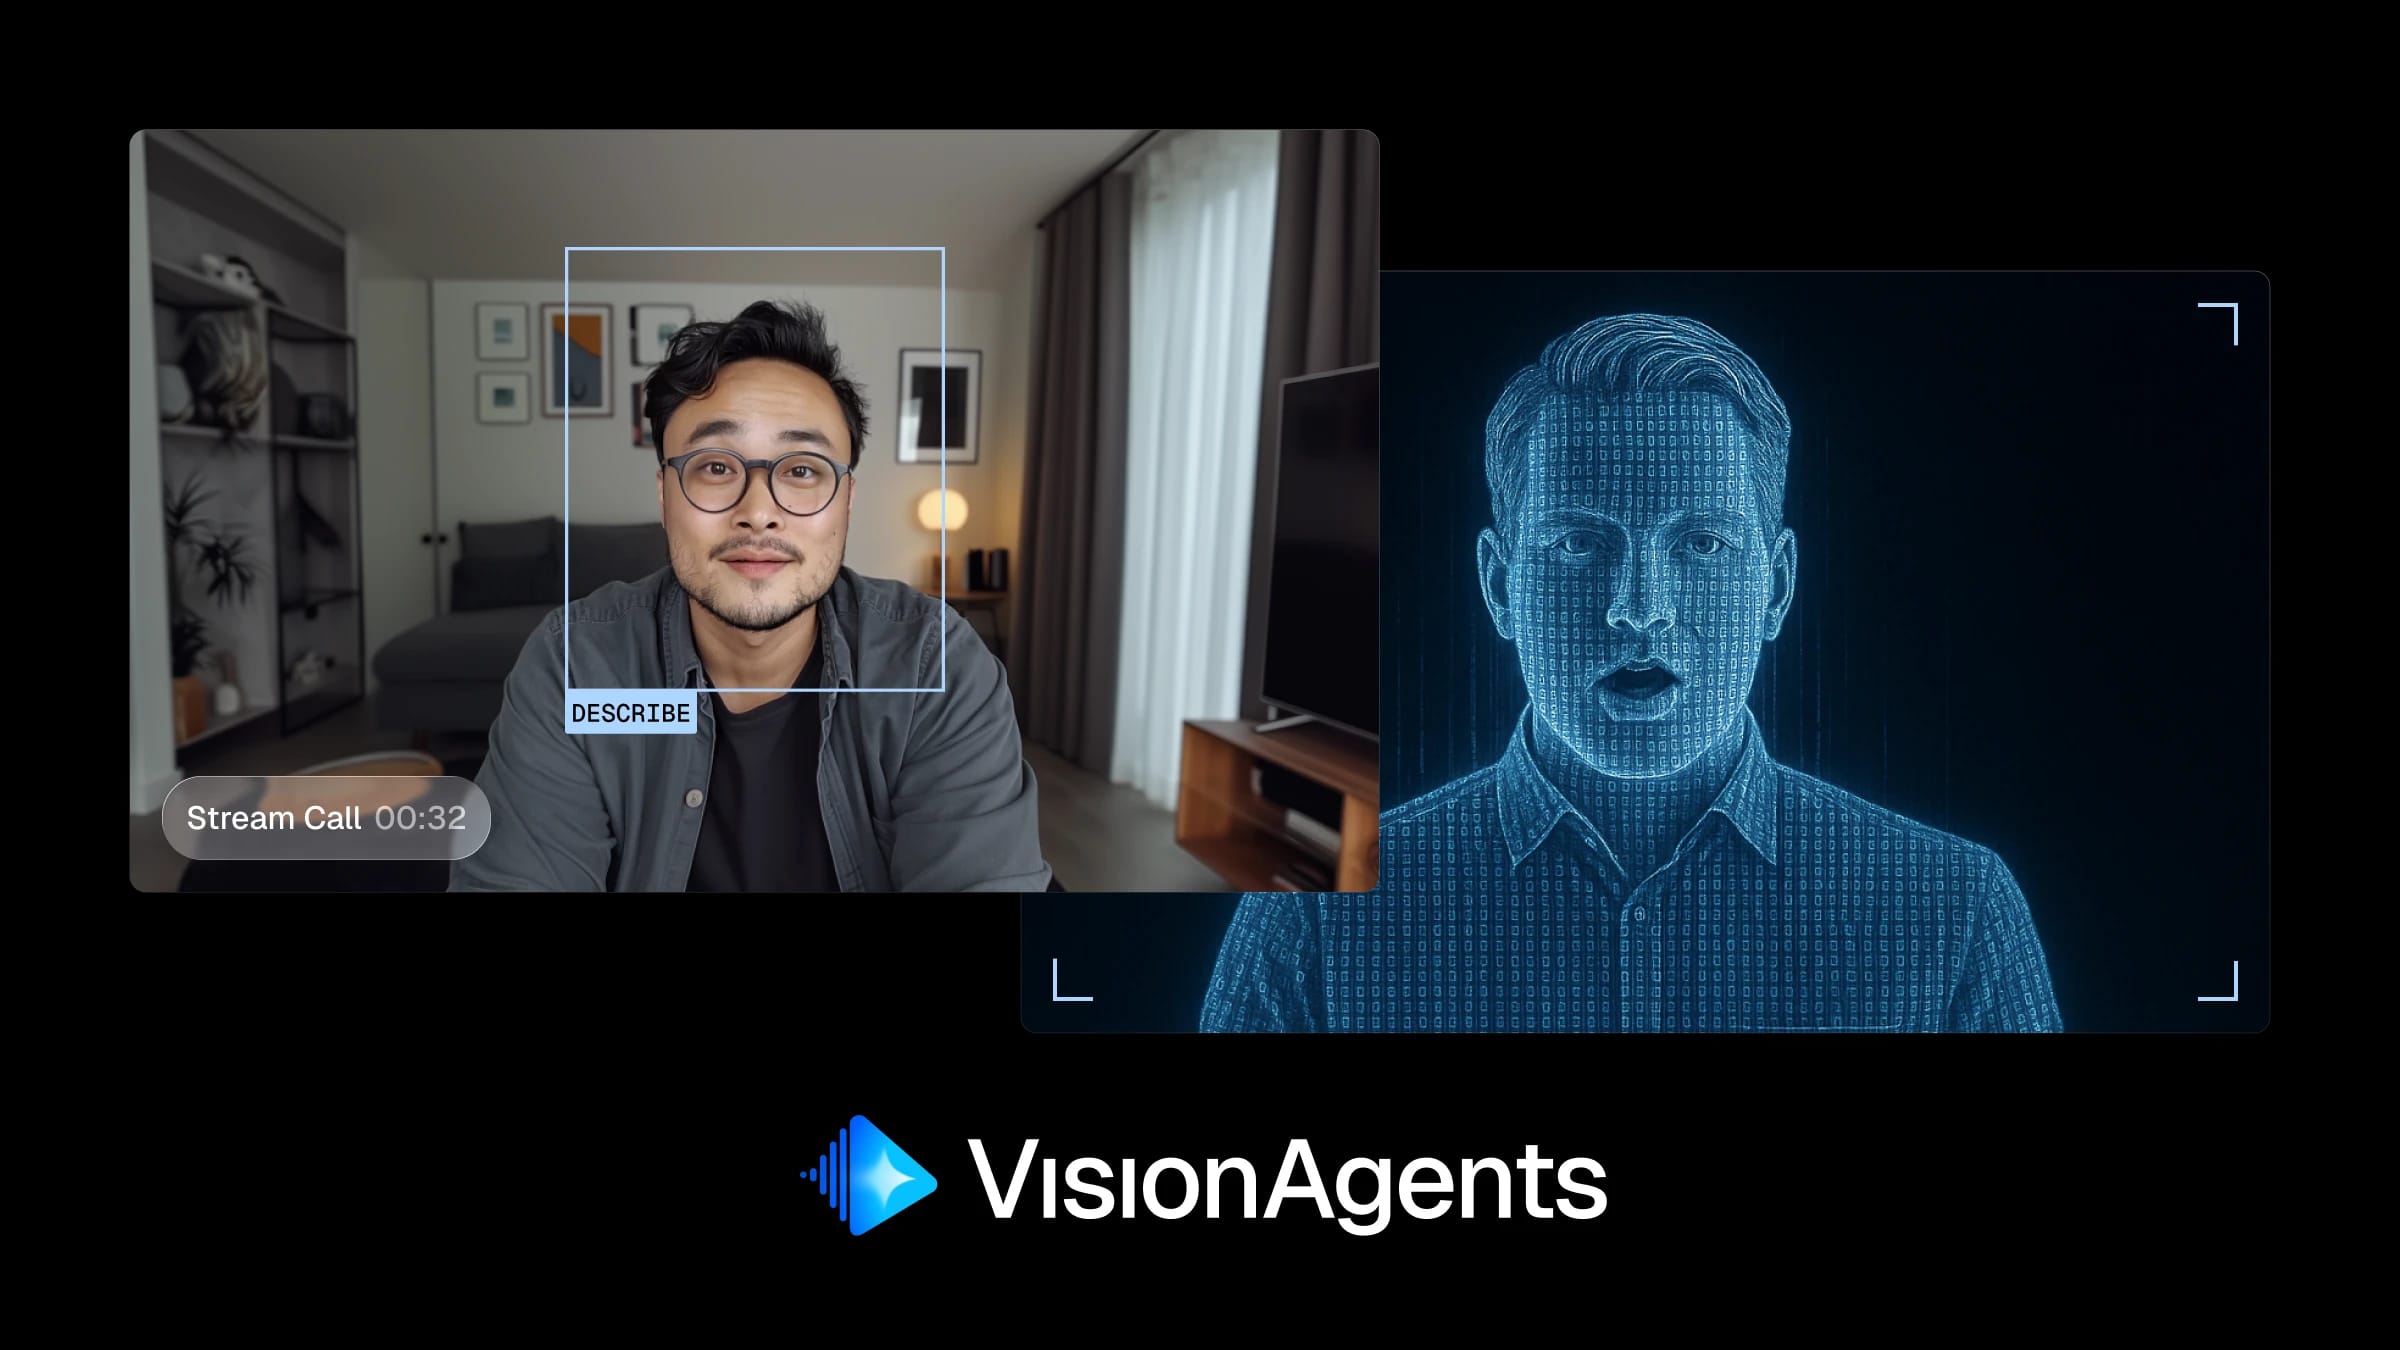
Agenti multimodali in tempo reale
Vision Agents offre all'IA la capacità di vedere, ascoltare e rispondere in tempo reale. Basato sugli SDK video e audio di Stream, il framework fornisce agli sviluppatori una base a bassa latenza per creare prototipi e distribuire esperienze con agenti multimodali.
Nella valutazione dei fornitori di Text to Speech, Stream ha scelto ElevenLabs per la sua qualità leader di mercato e la facilità di integrazione. Ora ElevenLabs è l'opzione vocale principale per gli utenti di Stream.
“ElevenLabs ci ha permesso di integrare rapidamente potenti funzionalità di sintesi vocale nel nostro SDK, consentendo agli Agents di rispondere in tempo reale alle domande degli utenti o a ciò che vedono, con voci espressive.” - Neevash Ramdial, Direttore marketing, Stream
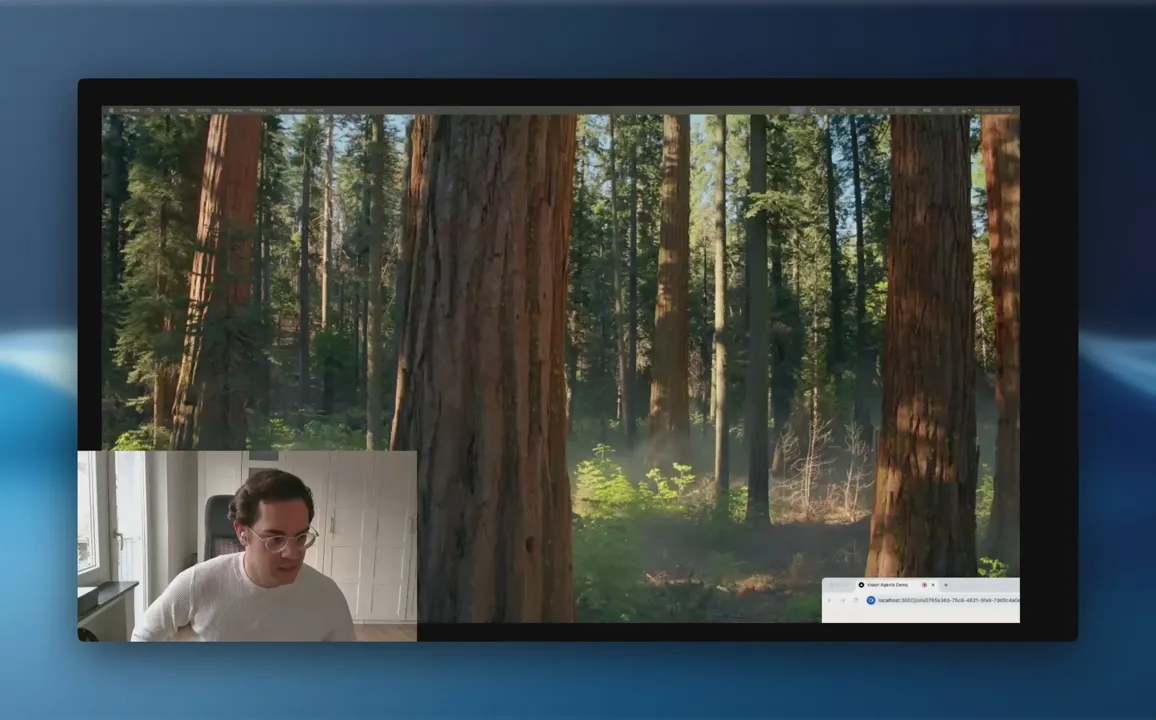
Integrazione rapida, affidabile e pensata per gli sviluppatori
Stream ha integrato ElevenLabs nell'intero codebase in pochi giorni, consentendo agli sviluppatori di aggiungere un output vocale realistico ai propri vision agent con una configurazione minima. L'integrazione offre ora:
- Configurazione 10 volte più rapida - La preintegrazione con ElevenLabs riduce il tempo di configurazione della voce da 400 righe di codice a sole 40.
- Prestazioni a bassa latenza - La rapida generazione vocale di ElevenLabs, combinata con la rete edge globale di Stream, garantisce una reattività naturale e umana.
- Esperienza scalabile per gli sviluppatori - Gli SDK di Stream semplificano la creazione, il test e la distribuzione di agenti multimodali.
Costruire il futuro dell'IA multimodale
I Vision Agents di Stream dimostrano come i modelli di ElevenLabs stiano ampliando le possibilità dell'IA multimodale. Combinando la comprensione visiva con Text to Speech, gli sviluppatori possono creare agenti che non solo vedono, ma parlano e ascoltano con una fluidità quasi umana.
Vuoi creare soluzioni con Text to Speech? Contattaci qui.
Fergal is on the Growth team at ElevenLabs, helping bring the company's research and products to more users. Previously, he worked on product and data at Entrepreneurs First, and spent two years at CloudKitchens building a new retail business vertical from the ground up. He studied at Yale University.