
Guida pratica: framework di agenti open source ed ElevenAgents
- Scritto da
- Akhil Chauhan
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
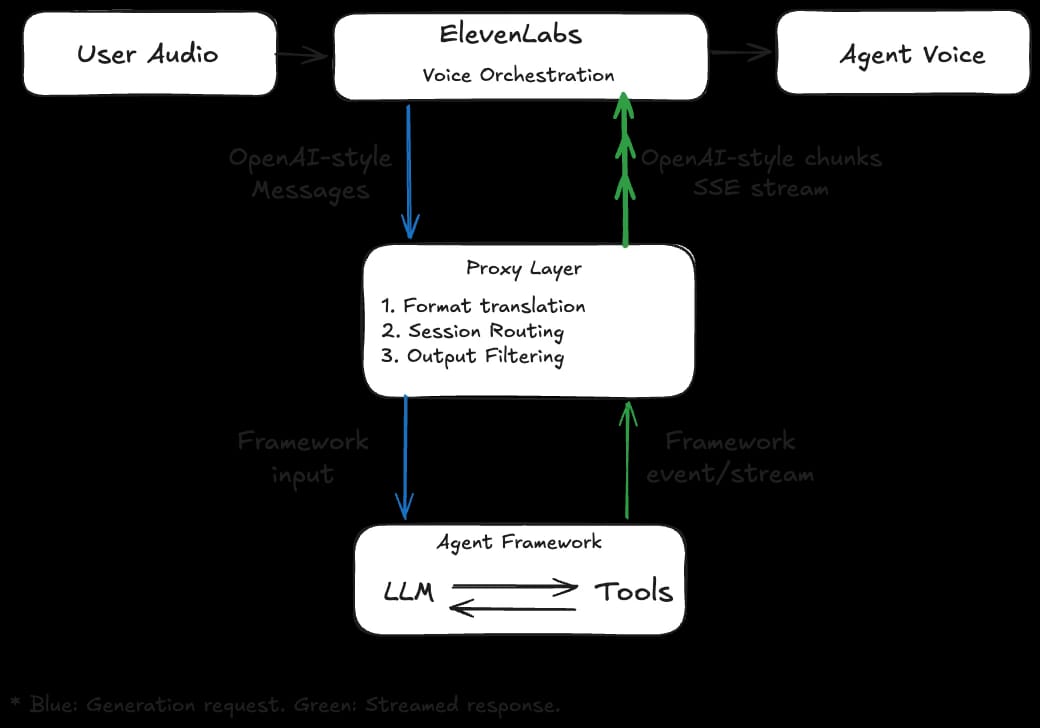
Nel nostro precedente articolo su Integrazione di agenti esterni con l'orchestrazione vocale di ElevenLabs, abbiamo spiegato come i team possano collegare l'orchestrazione dei propri agenti basati sul testo a ElevenLabs tramite Custom LLM. Partendo da queste basi, questa guida mostra come adattare e distribuire dietro l'interfaccia Custom LLM i principali framework di agenti open source. Il risultato è un'architettura flessibile che aggiunge la voce a sistemi di agenti maturi senza compromettere la gestione dello stato, l'orchestrazione degli strumenti o il controllo specifico dell'applicazione. In tutti i framework seguiamo lo stesso schema in tre passaggi: creare una richiesta di generazione, estrarre la risposta testuale finale e riformattarla nel formato Server-Sent Events (SSE) compatibile con OpenAI. ElevenLabs supporta entrambi i formati Chat Completions e Responses. Sebbene questa guida tratti quattro framework molto diffusi, questi schemi si applicano a qualsiasi runtime in grado di produrre output in streaming compatibile con OpenAI.
Configurazione generale
Gli esempi di questa sezione usano Python e FastAPI, ma va bene qualsiasi stack in grado di gestire richieste HTTP POST e risposte SSE in streaming. Quando l'orchestrazione vocale di ElevenLabs rileva una probabile fine del turno, invia una richiesta di generazione all'endpoint Custom LLM configurato. Questa sezione illustra i componenti principali di questo livello di traduzione: il bridge o proxy che permette all'orchestrazione vocale e al framework di agenti di parlare la stessa lingua.
Comprensibilmente, i clienti possono scegliere ciascun framework per familiarità generale o per la sua capacità di soddisfare uno scopo specifico. LlamaIndex, per esempio, è stato sviluppato inizialmente per semplificare la configurazione della Retrieval-Augmented Generation (RAG), mentre CrewAI è stato creato per automatizzare attività definite nell'era degli agenti. Obiettivi di progettazione diversi producono strutture di risposta diverse, che richiedono una gestione specifica. Inviare i chunk in streaming mentre l'LLM li genera, anziché aspettare un turno completo, è fondamentale perché consente al modello Text-to-Speech (TTS) di iniziare prima a generare il parlato, riducendo così la latenza percepita. Ci concentriamo su quattro framework popolari: LangGraph, Google ADK, CrewAI e LlamaIndex.
Nota sul codice condiviso
Ogni framework deve inviare le risposte in streaming come chunk SSE compatibili con OpenAI. Introduciamo una piccola funzione di supporto, usata negli esempi, per costruire questi chunk.
Una volta poste queste basi, iniziamo con LangGraph.
LangGraph
LangGraph rappresenta gli agenti come grafi, in cui i nodi rappresentano singoli passaggi e gli archi definiscono il flusso di controllo tra di essi. La configurazione minima è semplice: inizializza un modello di chat, definisci gli strumenti dell'agente e crea il runtime del grafo dell'agente.
Per ogni richiesta di generazione, l'agente LangGraph riceve l'intera cronologia della conversazione, che gli consente di mantenere internamente lo stato necessario. LangGraph supporta la persistenza lato server tramite i checkpoint, ma non li trattiamo qui per mantenere l'implementazione essenziale.
Una volta gestito lo stato, il successivo punto decisionale specifico di LangGraph è la modalità di streaming, per cui LangGraph offre due opzioni, ciascuna adatta a un caso d'uso diverso:
- stream_mode="values" fornisce snapshot dello stato del grafo. È più semplice da implementare, ma include uno stato dei messaggi più completo in ogni risposta, aumentando la latenza nei flussi conversazionali in tempo reale.
- stream_mode="messages" invia in streaming chunk incrementali dei messaggi dal modello. In genere è preferibile per le interazioni vocali in tempo reale, perché riduce il tempo al primo audio nel livello di orchestrazione di ElevenLabs.
Più nello specifico, l'implementazione messages del loop dell'agente include passaggi intermedi come gli aggiornamenti di tool calling, che non devono essere pronunciati. Il proxy li filtra, inviando al livello TTS soltanto il testo della risposta destinato all'utente. Ecco un esempio di turno con strumenti abilitati.
[1] Il modello decide di chiamare uno strumento (tool_calls=["get_price"])[2] Lo strumento viene eseguito e restituisce dati (result="$24.99") [3] Il modello produce una risposta usando il risultato (content="Costa $24.99")
Naturalmente, nello stream SSE devono essere inoltrati soltanto i chunk del passaggio 3. In pratica, due controlli gestiscono questo filtro nel loop di streaming: uno conserva soltanto gli eventi langgraph_node == "model" e l'altro ignora i contenuti vuoti. Insieme, questi controlli garantiscono che a ElevenLabs venga inoltrato come SSE soltanto il testo dell'assistente destinato all'utente. Riunendo questi concetti, proponiamo un'implementazione leggera del proxy delle richieste.
Questo garantisce che a ElevenLabs vengano inoltrati soltanto i chunk del modello destinati all'utente. Poiché LangGraph rende visibile l'esecuzione interna degli strumenti attraverso lo stream di stato, il filtro è esplicito e controllato dal proxy.
Vediamo ora le particolarità dell'utilizzo dell'Agent Development Kit (ADK) di Google
Google ADK
L'ADK di Google astrae il loop di runtime dietro alcune primitive fondamentali: Agent, Runner e SessionService. Il Runner di ADK si trova tra il livello HTTP e la definizione dell'agente. Gestisce l'instradamento dei messaggi, l'orchestrazione degli strumenti, il ciclo di vita della sessione e lo streaming degli eventi.
Dopo aver inizializzato l'agente, il backend delle sessioni e il runner, il proxy risolve o crea una sessione ADK per ogni richiesta in entrata. In ADK, session_id controlla la persistenza della memoria: riutilizzare lo stesso session_id nei vari turni mantiene automaticamente cronologia, chiamate agli strumenti e risposte precedenti. Poiché l'identità della conversazione risiede a monte in ElevenLabs, il proxy gestisce esplicitamente questa mappatura. Passando l'identificatore corretto per la richiesta di generazione, l'SDK può gestire internamente il contesto precedente. Passiamo l'identificatore arbitrario durante l'avvio della conversazione tramite gli extra parameters passati nel body della richiesta.
Dopo aver preparato il messaggio e la sessione, puoi invocare il runner. Le chiamate agli strumenti e i relativi risultati compaiono comunque come eventi ADK interni durante l'esecuzione, ma vengono trattati come passaggi intermedi di orchestrazione anziché come output destinato all'utente. Questo elimina la necessità di un filtro manuale rispetto ai framework in cui le chiamate agli strumenti compaiono come testo visibile all'utente.
L'handler seguente è un'implementazione semplificata che include inline la risoluzione della sessione e la logica get-or-create.
Vediamo ora CrewAI, che per progettazione è più incentrato sulle attività.
CrewAI
CrewAI è stato progettato per orchestrare workflow multi-agente attorno a compiti strutturati (ricerca, scrittura, sintesi), anziché loop di dialogo aperti. Gli agenti vengono definiti con un ruolo, un obiettivo e un background. L'esecuzione ruota attorno a oggetti Task, ciascuno con una descrizione chiara e un output previsto.
A differenza del modello a loop di agenti usato in LangGraph e ADK, CrewAI in genere costruisce Task e Crew per ogni richiesta per definire l'unità di lavoro di quel turno della conversazione. Manteniamo il contesto conversazionale inserendo i turni precedenti nell'attività successiva tramite un segnaposto. La variabile {crew_chat_messages} viene popolata a ogni richiesta con la cronologia della conversazione in corso, quindi interpolata nella descrizione dell'attività al momento dell'esecuzione. Inoltre, puntiamo a produrre testo pulito e pronto per il parlato, filtrando esplicitamente i pattern di tracciamento intermedi (Thought, Action, Action Input, Observation) ed emettendo soltanto il testo della risposta finale.
L'handler seguente riunisce la costruzione delle attività per richiesta, l'interpolazione della cronologia, lo streaming a livello di Crew, il filtro delle tracce e la formattazione dell'output.
Vediamo ora LlamaIndex, che segue un approccio diverso incentrato su un modello di streaming nativo guidato dagli eventi.
LlamaIndex
A differenza degli altri framework trattati in questo articolo, LlamaIndex è stato progettato per collegare gli LLM a fonti di dati esterne (archivi di documenti, indici, pipeline di retrieval). Il suo livello di agenti, FunctionAgent, si basa su queste fondamenta per recuperare informazioni e ragionare su contesto strutturato, anziché su dialoghi aperti o esecuzione di attività.
Per preservare la continuità conversazionale, il proxy trasforma i messaggi in entrata in messaggi di chat LlamaIndex, quindi li divide nell'ultimo turno dell'utente (user_msg) e nei turni precedenti (chat_history). Il campo event.delta di ogni evento AgentStream contiene il frammento di testo successivo, che viene mappato direttamente in un chunk delta.content in stile OpenAI. Puoi inoltrare i delta non vuoti così come sono, rendendolo il bridge di streaming più semplice della guida. Lo stream contiene sia eventi di orchestrazione (chiamate agli strumenti, risultati) sia eventi vocali (delta di testo dell'assistente). Per mantenere pulito l'output vocale, il proxy conserva soltanto gli eventi AgentStream e ignora i delta vuoti.
[1] AgentStream (delta='') ← ignorato[2] ToolCall ← ignorato[3] ToolCallResult ← ignorato[4] AgentStream (delta='It') ← inoltrato ✓[5] AgentStream (delta=' costs') ← inoltrato ✓[6] AgentStream (delta=' $49.99')← inoltrato ✓
Questa separazione mantiene i meccanismi intermedi degli strumenti fuori dall'output pronunciato, preservando al contempo un parlato incrementale a bassa latenza. L'handler pronto all'uso qui sotto riunisce questi passaggi.
LlamaIndex è meno prescrittivo riguardo ai pattern di runtime conversazionale end-to-end rispetto ai framework con livelli di orchestrazione integrati più completi. Per le distribuzioni in produzione, in genere questo richiede ai clienti di implementare la gestione delle sessioni, le barriere di sicurezza delle risposte, l'orchestrazione degli strumenti e il tracciamento.
Conclusione
Ogni framework di questa guida si collega a ElevenLabs attraverso lo stesso contratto: accettare una richiesta Completions o Responses in stile OpenAI e restituire in streaming chunk SSE. Questo consente ai team di aggiungere l'orchestrazione vocale a un'implementazione di agenti esistente con modifiche minime, preservando ciò che hanno già creato e abilitando al tempo stesso l'IA conversazionale in tempo reale. Questa modularità è un principio fondamentale della piattaforma ElevenAgents. Che un'organizzazione stia estendendo un agente esistente o realizzando una soluzione nativa per la voce fin dall'inizio, l'orchestrazione vocale di ElevenAgents è progettata per adattarsi al suo punto di partenza.
Se usi già un agente con un framework open source e vuoi abilitare la voce, prova questo approccio e facci sapere cosa ne pensi.
Akhil fa parte del team Forward Deployed Engineering di ElevenLabs, dove aiuta i clienti a creare e distribuire agenti. In precedenza ha sviluppato prodotti basati su IA per team GTM ed è stato lead Solutions Engineer in Orgvue.


