
व्यावहारिक गाइड: ओपन-सोर्स एजेंट फ्रेमवर्क्स और ElevenAgents
- लेखक
- Akhil Chauhan
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
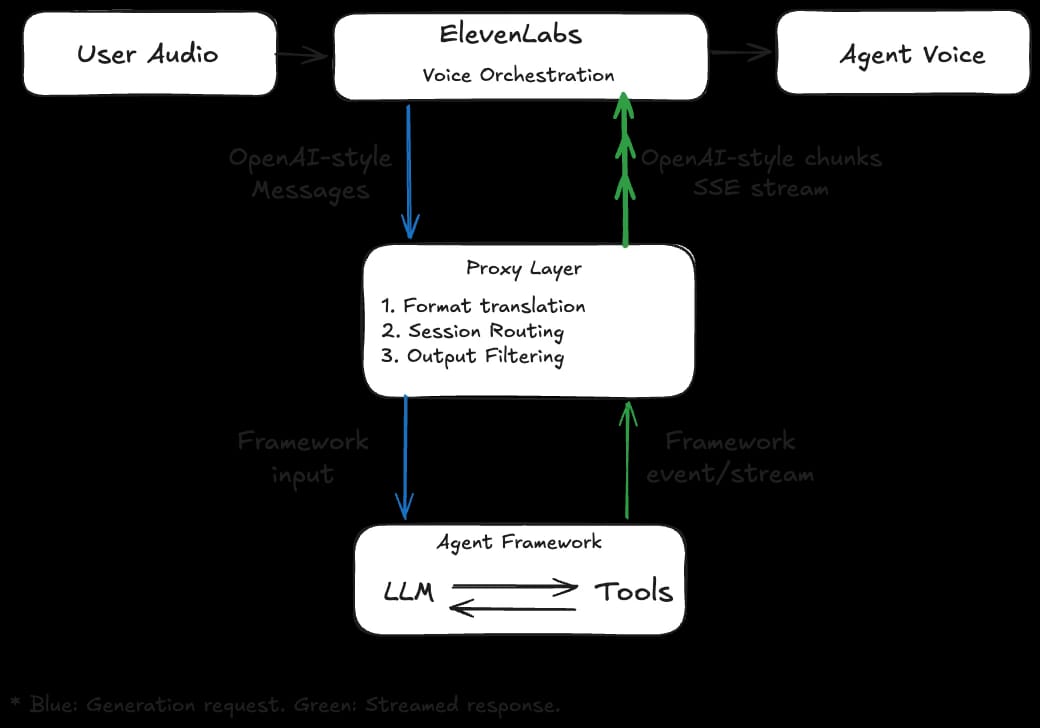
हमारी पिछली पोस्ट ElevenLabs वॉइस ऑर्केस्ट्रेशन के साथ बाहरी एजेंट्स को इंटीग्रेट करना में, हमने बताया था कि टीमें अपने मौजूदा टेक्स्ट-आधारित एजेंट ऑर्केस्ट्रेशन को ElevenLabs से Custom LLM के ज़रिए कैसे जोड़ सकती हैं। उसी आधार पर आगे बढ़ते हुए, यह गाइड बताती है कि प्रमुख ओपन-सोर्स एजेंट फ्रेमवर्क्स को Custom LLM इंटरफ़ेस के पीछे कैसे अनुकूलित और डिप्लॉय किया जा सकता है। नतीजा एक लचीला आर्किटेक्चर है, जिसमें स्टेट मैनेजमेंट, टूल ऑर्केस्ट्रेशन या ऐप्लिकेशन-विशिष्ट नियंत्रण से समझौता किए बिना परिपक्व एजेंट सिस्टम्स पर वॉइस की परत जोड़ी जा सकती है। फ्रेमवर्क चाहे कोई भी हो, हम एक ही तीन-स्टेप पैटर्न अपनाते हैं: जनरेशन रिक्वेस्ट बनाना, अंतिम टेक्स्ट रिस्पॉन्स निकालना और उसे OpenAI-संगत Server-Sent Events (SSE) फ़ॉर्मैट में दोबारा फ़ॉर्मैट करना। ElevenLabs Chat Completions और Responses दोनों फ़ॉर्मैट सपोर्ट करता है। यह गाइड चार व्यापक रूप से अपनाए गए फ्रेमवर्क्स को कवर करती है, लेकिन ये पैटर्न ऐसे किसी भी रनटाइम पर लागू होते हैं जो OpenAI-संगत स्ट्रीमिंग आउटपुट दे सकता है।
सामान्य सेटअप
इस सेक्शन के उदाहरण Python और FastAPI का इस्तेमाल करते हैं, हालांकि HTTP POST रिक्वेस्ट और स्ट्रीमिंग SSE रिस्पॉन्स संभालने वाला कोई भी स्टैक काम करेगा। जब ElevenLabs का वॉइस ऑर्केस्ट्रेशन संभावित टर्न एंड पहचानता है, तो यह कॉन्फ़िगर किए गए Custom LLM एंडपॉइंट पर जनरेशन रिक्वेस्ट भेजता है। इस सेक्शन में उस ट्रांसलेशन लेयर के मुख्य हिस्सों की जानकारी दी गई है—वह ब्रिज या प्रॉक्सी जो वॉइस ऑर्केस्ट्रेशन और एजेंट फ्रेमवर्क को एक ही भाषा में संवाद करने देता है।
स्वाभाविक रूप से, ग्राहक किसी फ्रेमवर्क को उससे परिचित होने या किसी खास काम को पूरा करने की क्षमता के कारण चुन सकते हैं। उदाहरण के लिए, LlamaIndex को मूल रूप से Retrieval-Augmented Generation (RAG) सेट अप करना आसान बनाने के लिए विकसित किया गया था, जबकि CrewAI को एजेंट्स के दौर में तय कार्यों को ऑटोमेट करने के लिए बनाया गया था। अलग-अलग डिज़ाइन लक्ष्यों से अलग रिस्पॉन्स स्ट्रक्चर बनते हैं और हर एक को विशेष तरीके से हैंडल करना पड़ता है। पूरे टर्न का इंतज़ार करने के बजाय LLM के जनरेट करते ही chunks को स्ट्रीम करना बेहद ज़रूरी है, क्योंकि इससे टेक्स्ट टू स्पीच (TTS) मॉडल जल्दी स्पीच जनरेट करना शुरू कर सकता है और महसूस होने वाली लेटेंसी कम होती है। हम चार लोकप्रिय फ्रेमवर्क्स—मुख्य रूप से LangGraph, Google ADK, CrewAI और LlamaIndex—पर ध्यान देते हैं।
शेयर किए गए कोड पर एक नोट
हर फ्रेमवर्क को OpenAI-संगत SSE chunks के रूप में रिस्पॉन्स स्ट्रीम करना चाहिए। इन chunks को बनाने के लिए हम उदाहरणों में इस्तेमाल होने वाला एक छोटा हेल्पर फ़ंक्शन पेश करते हैं।
आधार तैयार है, तो आइए LangGraph से शुरू करते हैं।
LangGraph
LangGraph एजेंट्स को ग्राफ़ के रूप में मॉडल करता है, जहाँ नोड्स अलग-अलग स्टेप्स का प्रतिनिधित्व करते हैं और एजेस उनके बीच कंट्रोल फ़्लो तय करते हैं। न्यूनतम सेटअप आसान है: एक चैट मॉडल इनिशियलाइज़ करें, एजेंट टूल्स परिभाषित करें और एजेंट ग्राफ़ रनटाइम बनाएं।
हर जनरेशन रिक्वेस्ट के लिए, LangGraph Agent को पूरी बातचीत की हिस्ट्री मिलती है, जिससे वह ज़रूरी स्टेट को अंदर ही बनाए रख सकता है। LangGraph Checkpoints के ज़रिए सर्वर-साइड पर्सिस्टेंस सपोर्ट करता है, हालांकि इंप्लीमेंटेशन को न्यूनतम रखने के लिए हम उन्हें यहाँ कवर नहीं कर रहे हैं।
स्टेट मैनेजमेंट के बाद, LangGraph से जुड़ा अगला निर्णय स्ट्रीमिंग मोड का है। LangGraph दो विकल्प देता है, जिनमें से हर एक अलग उपयोग के लिए उपयुक्त है:
- stream_mode="values" ग्राफ़ स्टेट स्नैपशॉट देता है। इसे लागू करना आसान है, लेकिन हर रिस्पॉन्स में ज़्यादा विस्तृत मैसेज स्टेट शामिल होती है, जिससे रीयल-टाइम बातचीत में लेटेंसी बढ़ती है।
- stream_mode="messages" मॉडल से क्रमिक मैसेज chunks स्ट्रीम करता है। रीयल-टाइम वॉइस इंटरैक्शन के लिए इसे आम तौर पर प्राथमिकता दी जाती है, क्योंकि यह ElevenLabs ऑर्केस्ट्रेशन लेयर में पहले ऑडियो तक का समय कम करता है।
और खास तौर पर, एजेंट लूप के messages इंप्लीमेंटेशन में टूल कॉलिंग अपडेट्स जैसे मध्यवर्ती स्टेप्स शामिल होते हैं, जिन्हें ज़ोर से नहीं बोला जाना चाहिए। प्रॉक्सी इन्हें फ़िल्टर करता है और TTS लेयर को केवल यूज़र के लिए बना रिस्पॉन्स टेक्स्ट भेजता है। नीचे टूल-सक्षम टर्न का एक उदाहरण है।
[1] मॉडल टूल कॉल करने का निर्णय लेता है (tool_calls=["get_price"])[2] टूल चलता है और डेटा लौटाता है (result="$24.99") [3] मॉडल नतीजे का इस्तेमाल करके रिस्पॉन्स बनाता है (content="इसकी कीमत $24.99 है")
स्वाभाविक रूप से, SSE स्ट्रीम में सिर्फ़ स्टेप 3 के chunks ही फ़ॉरवर्ड होने चाहिए। व्यवहार में, स्ट्रीमिंग लूप में दो गार्ड चेक यह फ़िल्टरिंग करते हैं: एक सिर्फ़ langgraph_node == "model" इवेंट्स रखने के लिए और दूसरा खाली कंटेंट छोड़ने के लिए। मिलकर, ये चेक सुनिश्चित करते हैं कि केवल यूज़र के लिए बना असिस्टेंट टेक्स्ट ही SSE के रूप में ElevenLabs को फ़ॉरवर्ड हो। इन अवधारणाओं को मिलाकर, हम रिक्वेस्ट प्रॉक्सी का एक हल्का इंप्लीमेंटेशन देते हैं।
यह सुनिश्चित करता है कि केवल यूज़र के लिए बने मॉडल chunks ही ElevenLabs को फ़ॉरवर्ड हों। LangGraph अपने इंटरनल टूल एक्ज़ीक्यूशन को स्टेट स्ट्रीम के ज़रिए दिखाता है, इसलिए फ़िल्टरिंग स्पष्ट रहती है और प्रॉक्सी द्वारा नियंत्रित होती है।
अब, Google के Agent Development Kit (ADK) के साथ काम करने की बारीकियों पर नज़र डालते हैं
Google ADK
Google का ADK रनटाइम लूप को कुछ मुख्य प्रिमिटिव्स—Agent, Runner और SessionService—के पीछे एब्स्ट्रैक्ट करता है। ADK का Runner HTTP लेयर और एजेंट डेफ़िनिशन के बीच होता है। यह मैसेज रूटिंग, टूल ऑर्केस्ट्रेशन, सेशन लाइफ़साइकल और इवेंट स्ट्रीमिंग संभालता है।
एजेंट, सेशन बैकएंड और रनर इनिशियलाइज़ होने के बाद, प्रॉक्सी हर इनकमिंग रिक्वेस्ट के लिए ADK सेशन ढूँढता या बनाता है। ADK में session_id मेमोरी पर्सिस्टेंस नियंत्रित करता है: अलग-अलग टर्न्स में उसी session_id का दोबारा इस्तेमाल करने से हिस्ट्री, टूल कॉल्स और पिछले रिस्पॉन्स अपने-आप आगे बने रहते हैं। बातचीत की पहचान ElevenLabs में अपस्ट्रीम रहती है, इसलिए प्रॉक्सी इस मैपिंग को स्पष्ट रूप से हैंडल करता है। जनरेशन रिक्वेस्ट के लिए सही आइडेंटिफ़ायर पास करके SDK पिछले कॉन्टेक्स्ट को अंदरूनी तौर पर हैंडल कर सकता है। बातचीत शुरू करते समय हम मनमाना आइडेंटिफ़ायर अतिरिक्त पैरामीटर्स के ज़रिए रिक्वेस्ट की बॉडी में पास करते हैं।
मैसेज और सेशन तैयार होने पर रनर को चलाया जा सकता है। एक्ज़ीक्यूशन के दौरान टूल कॉल्स और टूल रिज़ल्ट्स फिर भी इंटरनल ADK इवेंट्स के रूप में दिखते हैं, लेकिन इन्हें यूज़र के लिए आउटपुट के बजाय मध्यवर्ती ऑर्केस्ट्रेशन स्टेप्स माना जाता है। इससे उन फ्रेमवर्क्स की तुलना में मैन्युअल फ़िल्टर की ज़रूरत नहीं रहती, जहाँ टूल कॉल्स यूज़र को दिखने वाले टेक्स्ट के रूप में आते हैं।
नीचे दिया हैंडलर एक सरल इंप्लीमेंटेशन है, जिसमें सेशन रिज़ॉल्यूशन और get-or-create लॉजिक इनलाइन शामिल है।
अब हम CrewAI को देखेंगे, जो डिज़ाइन के हिसाब से ज़्यादा टास्क-केंद्रित है।
CrewAI
CrewAI को मल्टी-एजेंट वर्कफ़्लोज़ को संरचित कार्यों (रिसर्च, लिखना, सारांश बनाना) के इर्द-गिर्द ऑर्केस्ट्रेट करने के लिए डिज़ाइन किया गया था, न कि खुले संवाद लूप्स के लिए। एजेंट्स को एक भूमिका, लक्ष्य और बैकस्टोरी के साथ परिभाषित किया जाता है। एक्ज़ीक्यूशन Task ऑब्जेक्ट्स पर केंद्रित होता है, जिनमें से हर एक का स्पष्ट विवरण और अपेक्षित आउटपुट होता है।
LangGraph और ADK में इस्तेमाल होने वाले एजेंट-लूप मॉडल के उलट, CrewAI आम तौर पर बातचीत के उस टर्न के कार्य-इकाई को परिभाषित करने के लिए हर रिक्वेस्ट पर Task और Crew बनाता है। हम प्लेसहोल्डर के ज़रिए पिछले टर्न्स को अगले टास्क में शामिल करके बातचीत का कॉन्टेक्स्ट आगे ले जाते हैं। {crew_chat_messages} वेरिएबल को हर रिक्वेस्ट पर चल रही बातचीत की हिस्ट्री से भरा जाता है, फिर एक्ज़ीक्यूशन के समय टास्क डिस्क्रिप्शन में इंटरपोलेट किया जाता है। हम मध्यवर्ती ट्रेसिंग पैटर्न्स (Thought, Action, Action Input, Observation) को स्पष्ट रूप से फ़िल्टर करके और केवल अंतिम उत्तर का टेक्स्ट भेजकर साफ़, स्पीच-रेडी टेक्स्ट बनाने का लक्ष्य रखते हैं।
नीचे दिया हैंडलर हर-रिक्वेस्ट टास्क निर्माण, हिस्ट्री इंटरपोलेशन, Crew-लेवल स्ट्रीमिंग, ट्रेस फ़िल्टरिंग और आउटपुट फ़ॉर्मैटिंग को एक साथ लाता है।
अब हम LlamaIndex को देखेंगे, जो नेटिव इवेंट-ड्रिवन स्ट्रीमिंग मॉडल पर केंद्रित एक अलग रास्ता अपनाता है।
LlamaIndex
इस पोस्ट में शामिल अन्य फ्रेमवर्क्स के विपरीत, LlamaIndex को LLMs को बाहरी डेटा सोर्सेज़ (डॉक्यूमेंट स्टोर्स, इंडेक्स, रिट्रीवल पाइपलाइन्स) से जोड़ने के लिए डिज़ाइन किया गया था। इसकी एजेंट लेयर, FunctionAgent, खुले संवाद या टास्क एक्ज़ीक्यूशन के बजाय संरचित कॉन्टेक्स्ट को रिट्रीव करने और उस पर तर्क करने के लिए इस आधार पर काम करती है।
बातचीत की निरंतरता बनाए रखने के लिए, प्रॉक्सी इनकमिंग मैसेजेस को LlamaIndex चैट मैसेजेस में बदलता है, फिर उन्हें सबसे नए यूज़र टर्न (user_msg) और पिछले टर्न्स (chat_history) में बाँटता है। हर AgentStream इवेंट के event.delta फ़ील्ड में अगला टेक्स्ट फ़्रैगमेंट होता है, जो सीधे OpenAI-स्टाइल delta.content chunk में मैप होता है। गैर-खाली deltas को ज्यों का त्यों फ़ॉरवर्ड किया जा सकता है, जिससे यह गाइड का सबसे सीधा स्ट्रीमिंग ब्रिज बनता है। स्ट्रीम में ऑर्केस्ट्रेशन इवेंट्स (टूल कॉल्स, रिज़ल्ट्स) और स्पीच इवेंट्स (असिस्टेंट टेक्स्ट deltas) दोनों शामिल होते हैं। वॉइस आउटपुट को साफ़ रखने के लिए, प्रॉक्सी केवल AgentStream इवेंट्स रखता है और खाली deltas छोड़ देता है।
[1] AgentStream (delta='') ← अनदेखा किया गया[2] ToolCall ← अनदेखा किया गया[3] ToolCallResult ← अनदेखा किया गया[4] AgentStream (delta='यह') ← फ़ॉरवर्ड किया गया ✓[5] AgentStream (delta='कीमत है') ← फ़ॉरवर्ड किया गया ✓[6] AgentStream (delta=' $49.99')← फ़ॉरवर्ड किया गया ✓
यह अलगाव कम लेटेंसी वाली क्रमिक स्पीच को बनाए रखते हुए मध्यवर्ती टूल मैकेनिक्स को बोले जाने वाले आउटपुट से दूर रखता है। नीचे दिया ड्रॉप-इन हैंडलर इन स्टेप्स को एक साथ लाता है।
भारी बिल्ट-इन ऑर्केस्ट्रेशन लेयर्स वाले फ्रेमवर्क्स की तुलना में LlamaIndex एंड-टू-एंड कन्वर्सेशनल रनटाइम पैटर्न्स के बारे में कम निर्देशात्मक है। प्रोडक्शन डिप्लॉयमेंट्स के लिए, आम तौर पर ग्राहकों को सेशन हैंडलिंग, रिस्पॉन्स गार्डरेल्स, टूल ऑर्केस्ट्रेशन और ट्रेसिंग लागू करनी होती है।
निष्कर्ष
इस गाइड का हर फ्रेमवर्क एक ही कॉन्ट्रैक्ट के ज़रिए ElevenLabs से जुड़ता है: OpenAI-स्टाइल Completions या Responses रिक्वेस्ट स्वीकार करें और SSE chunks वापस स्ट्रीम करें। इससे टीमें बहुत कम बदलावों के साथ किसी मौजूदा एजेंट इंप्लीमेंटेशन पर वॉइस ऑर्केस्ट्रेशन की परत जोड़ सकती हैं। इस तरह वे पहले से बनाए गए सिस्टम को बनाए रखते हुए रीयल-टाइम कन्वर्सेशनल AI को अनलॉक कर सकती हैं। यह मॉड्यूलैरिटी ElevenAgents प्लैटफ़ॉर्म का एक मूल सिद्धांत है। चाहे संगठन किसी मौजूदा एजेंट को बढ़ा रहे हों या शुरुआत से वॉइस-नेटिव बना रहे हों, ElevenAgents का वॉइस ऑर्केस्ट्रेशन उन्हें वहीं से आगे बढ़ने देता है जहाँ वे हैं।
अगर आप पहले से किसी ओपन-सोर्स फ्रेमवर्क के साथ एजेंट चला रहे हैं और वॉइस सक्षम करना चाहते हैं, तो इस तरीके को आज़माएं और हमें बताएं कि आपको कैसा लगा।

