टेक्स्ट टू स्पीच की सटीकता संबंधी समस्याएं कैसे ठीक करें
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
हालांकि इन्हें विशाल वॉइस डेटासेट पर प्रशिक्षित किया जाता है और ये लगातार उच्च-गुणवत्ता वाला ऑडियो बना सकते हैं, फिर भी ज़्यादातर टेक्स्ट टू स्पीच (TTS) मॉडल शब्दों का गलत उच्चारण कर सकते हैं या स्पीच संबंधी दूसरी समस्याओं का सामना कर सकते हैं। गलत उच्चारण तब होता है, जब TTS इंजन को ऐसे शब्द और वाक्यांश मिलते हैं जो उसके ट्रेनिंग डेटासेट में मौजूद स्पीच के दायरे से बाहर हों। ऐसा अक्सर इंडस्ट्री जार्गन, ब्रांड नामों या व्यक्तिवाचक नामों के साथ होता है।
टेक्स्ट लंबे होने पर या उसे ज़ोर से बोलने के बजाय पढ़ने के लिए विराम चिह्नों के साथ लिखा गया हो, तो TTS इंजन जल्दबाज़ी भरी, अटकी हुई या रोबोटिक स्पीच भी बना सकते हैं।
API के ज़रिए अपने ऐप्लिकेशन को TTS इंजन से कनेक्ट करते समय आपको कुछ आम तकनीकी समस्याएं भी मिल सकती हैं।
इस लेख में हम इन तीन तरह की समस्याओं और हर एक को हल करने के आम तरीकों पर चर्चा करेंगे।
सारांश
- टेक्स्ट टू स्पीच विफलताएं आम तौर पर गलत उच्चारण, अस्वाभाविक गति/लय और तकनीकी API एक्ज़ीक्यूशन त्रुटियों की श्रेणियों में आती हैं।
- गलत उच्चारण को सबसे प्रभावी तरीके से W3C-मानक Pronunciation Lexicon Specification (PLS) डिक्शनरी से ठीक किया जा सकता है, या अपनी स्क्रिप्ट में इन-लाइन फोनेटिक टैग से अलग-अलग समायोजित किया जा सकता है।
- आप अपनी स्क्रिप्ट को सही ढंग से फ़ॉर्मैट और विराम चिह्नों के साथ लिखकर स्पीच आउटपुट की स्वाभाविकता नियंत्रित करने में मदद कर सकते हैं। बोलने के लिए फ़ॉर्मैट किया गया टेक्स्ट अक्सर केवल पढ़ने के लिए लिखे टेक्स्ट से अलग होता है।
- आप मानक HTTP स्टेटस कोड के ज़रिए API विफलताओं का पता लगा सकते हैं।
- ब्रांड नामों, व्यक्तिवाचक नामों और नए वाक्यांशों के उच्चारण को अलग से पहले ही टेस्ट करने से बाद में होने वाली लंबी ट्रबलशूटिंग से बचा जा सकता है।
टेक्स्ट टू स्पीच काम क्यों नहीं कर रहा है?
टेक्स्ट टू स्पीच की समस्याएं मोटे तौर पर तीन श्रेणियों में आती हैं।
TTS समस्या के प्रकार
गलत उच्चारण
TTS मॉडल नए शब्दों या वाक्यांशों को गलत पढ़ता है। उदाहरण के लिए, आपका ब्रांड नाम, इंडस्ट्री जार्गन, संक्षिप्त शब्द या होमोग्राफ।
अस्वाभाविक डिलीवरी और लय
आउटपुट स्पीच एकरस होती है, अजीब जगहों पर रुकती है या उन अंशों को जल्दी बोलती है जिन्हें धीमी डिलीवरी की ज़रूरत होती है।
इंटीग्रेशन और API विफलताएं
आपका ऐप्लिकेशन एक या अधिक तकनीकी कारणों से स्पीच जनरेट नहीं करता, जैसे voice ID छूट जाना, वर्कलोड सीमाएं या खराब API key।
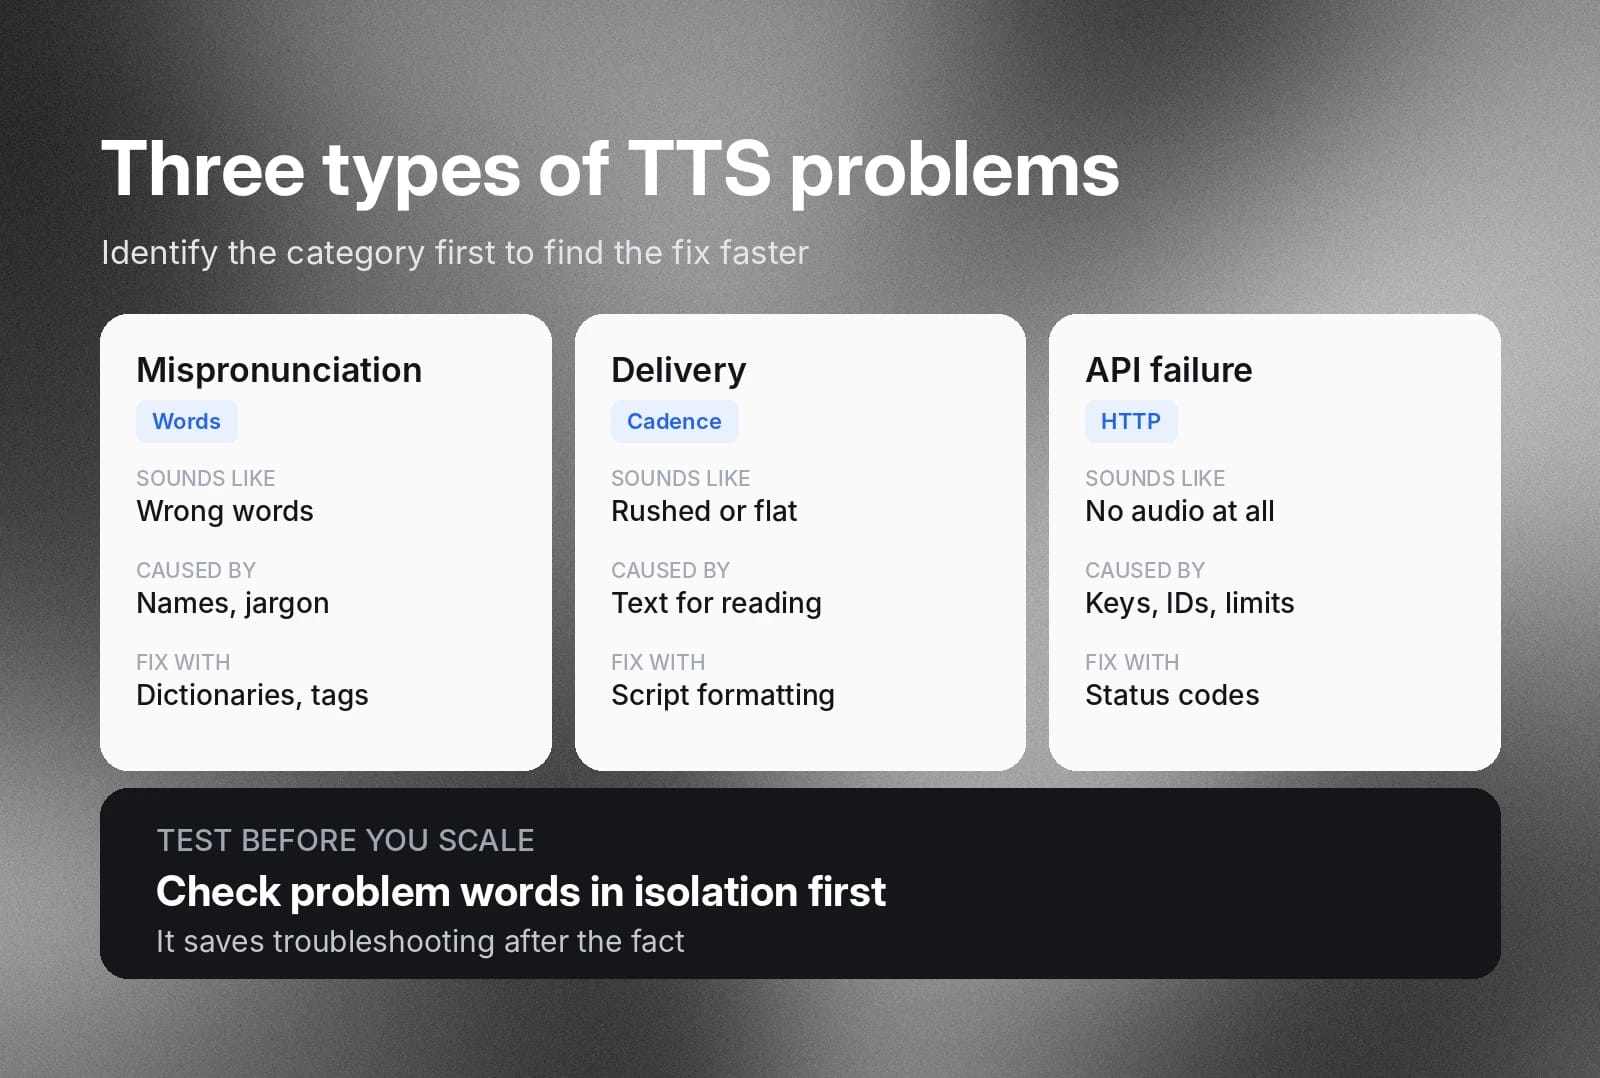
यह गाइड इन तीनों समस्याओं को विस्तार से समझाती है, ताकि आप ठीक-ठीक जान सकें कि आपको किस तरह की आउटपुट क्वालिटी या तकनीकी समस्या आ रही है। इन्हें समझने से आपको सही समाधान तेज़ी से पहचानने में मदद मिलेगी।
टेक्स्ट टू स्पीच की सटीकता संबंधी समस्याएं कैसे ठीक करें: गलत उच्चारण और अस्वाभाविक डिलीवरी
इंजीनियर आधुनिक न्यूरल वॉइस मॉडल को विशाल स्पीच डेटासेट पर प्रशिक्षित करते हैं। ये शब्दों के लगभग अनगिनत संयोजनों में स्वाभाविक लगने वाली स्पीच बना सकते हैं। लेकिन कोई भी ट्रेनिंग डेटासेट सार्वभौमिक नहीं होता। कुछ असाधारण उच्चारण और अपरिचित शब्द या व्यक्तिवाचक नाम हमेशा होंगे जिन्हें मॉडल सही ढंग से नहीं बोल पाएगा।
ऐसा अक्सर नहीं होगा, लेकिन जो कोई भी नियमित रूप से TTS मॉडल इस्तेमाल करता है, उसे ऐसा होने पर इसे संभालने के लिए तैयार रहना चाहिए। पहले यह समझना ज़रूरी है कि ये गलत उच्चारण क्यों होते हैं।
स्पीच त्रुटियों के आम मूल कारण
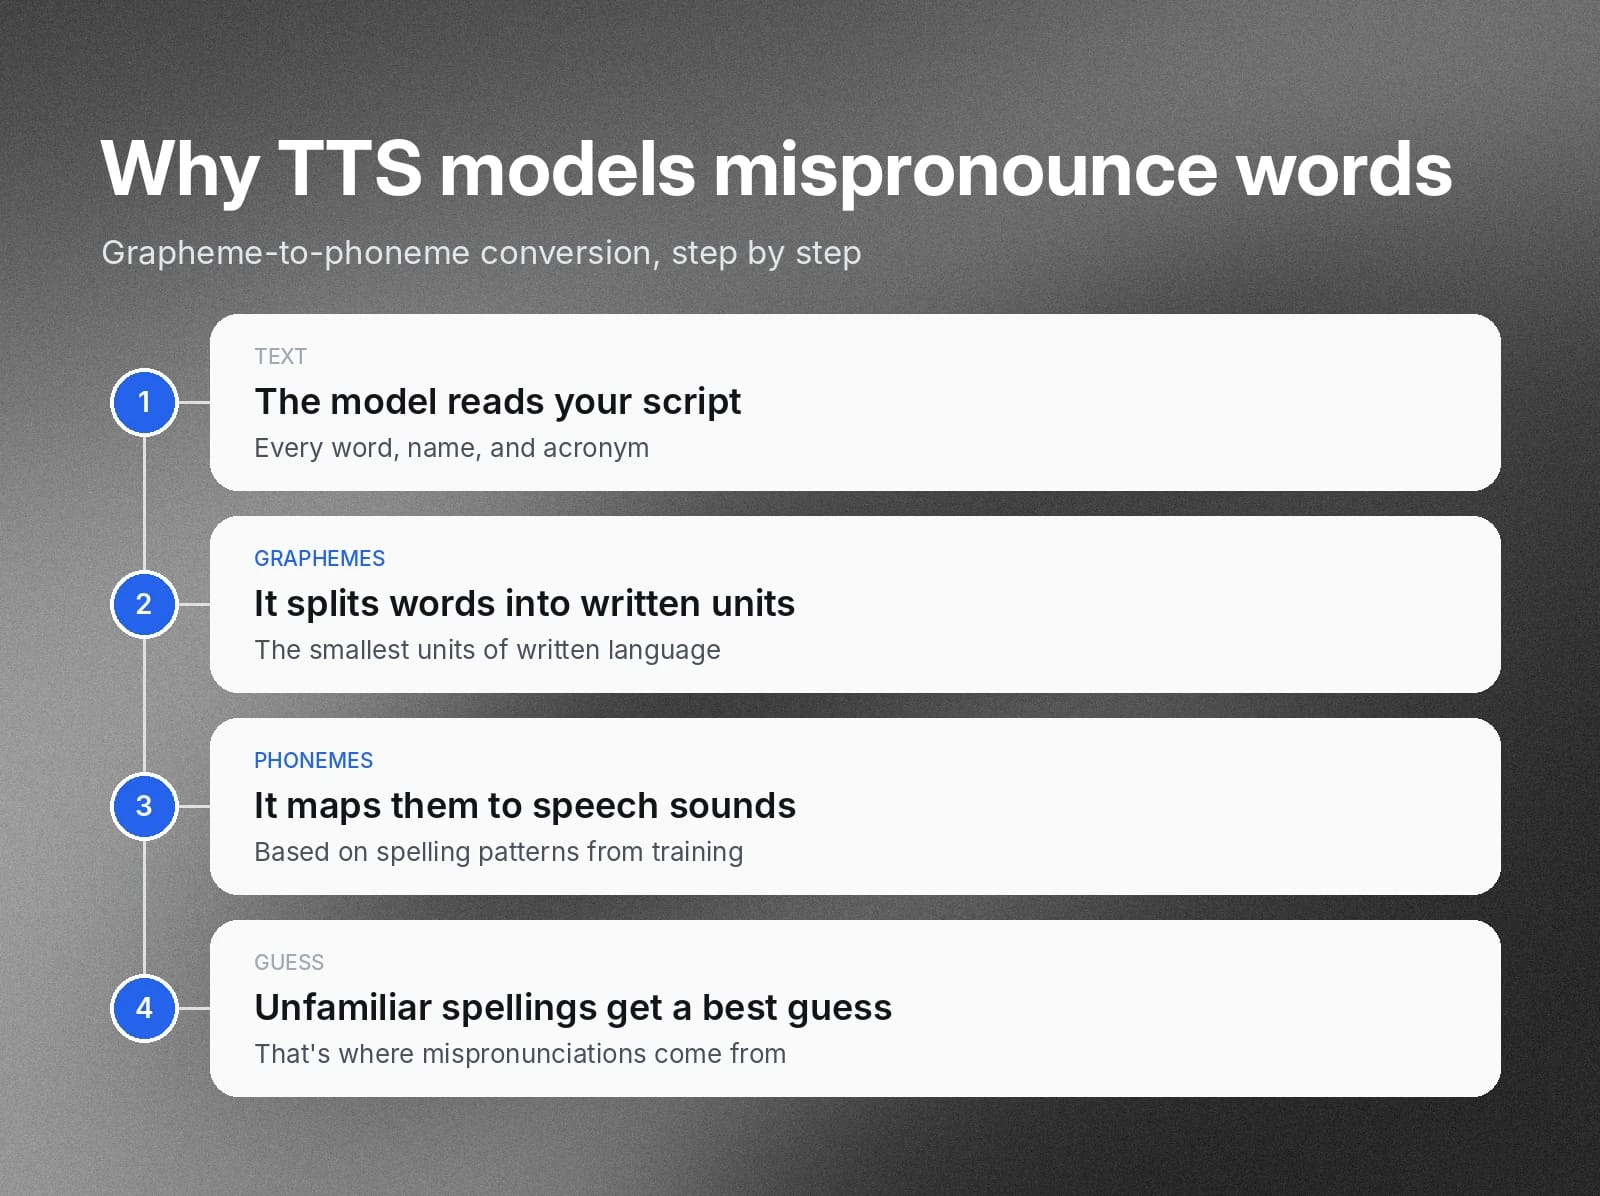
स्पीच सिंथेसिस मॉडल ग्राफ़ीम-टू-फोनिम (G2P) कन्वर्ज़न नामक प्रक्रिया से टेक्स्ट को स्पीच में बदलते हैं। फोनिम बोले जाने वाले ध्वनि के सबसे छोटे भाग होते हैं। ग्राफ़ीम लिखित भाषा की सबसे छोटी इकाइयां होती हैं, आम तौर पर एक अक्षर, जो किसी फोनिम का प्रतिनिधित्व करता है।
जब टेक्स्ट इनपुट उन वर्तनी पैटर्न से मेल नहीं खाता जो मॉडल ने ट्रेनिंग डेटा में देखे थे, तो वे ध्वन्यात्मक उच्चारण का सबसे अच्छा अनुमान लगाते हैं। कभी-कभी इससे गलत उच्चारण होता है।
व्यक्तिवाचक नाम और ब्रांड नाम
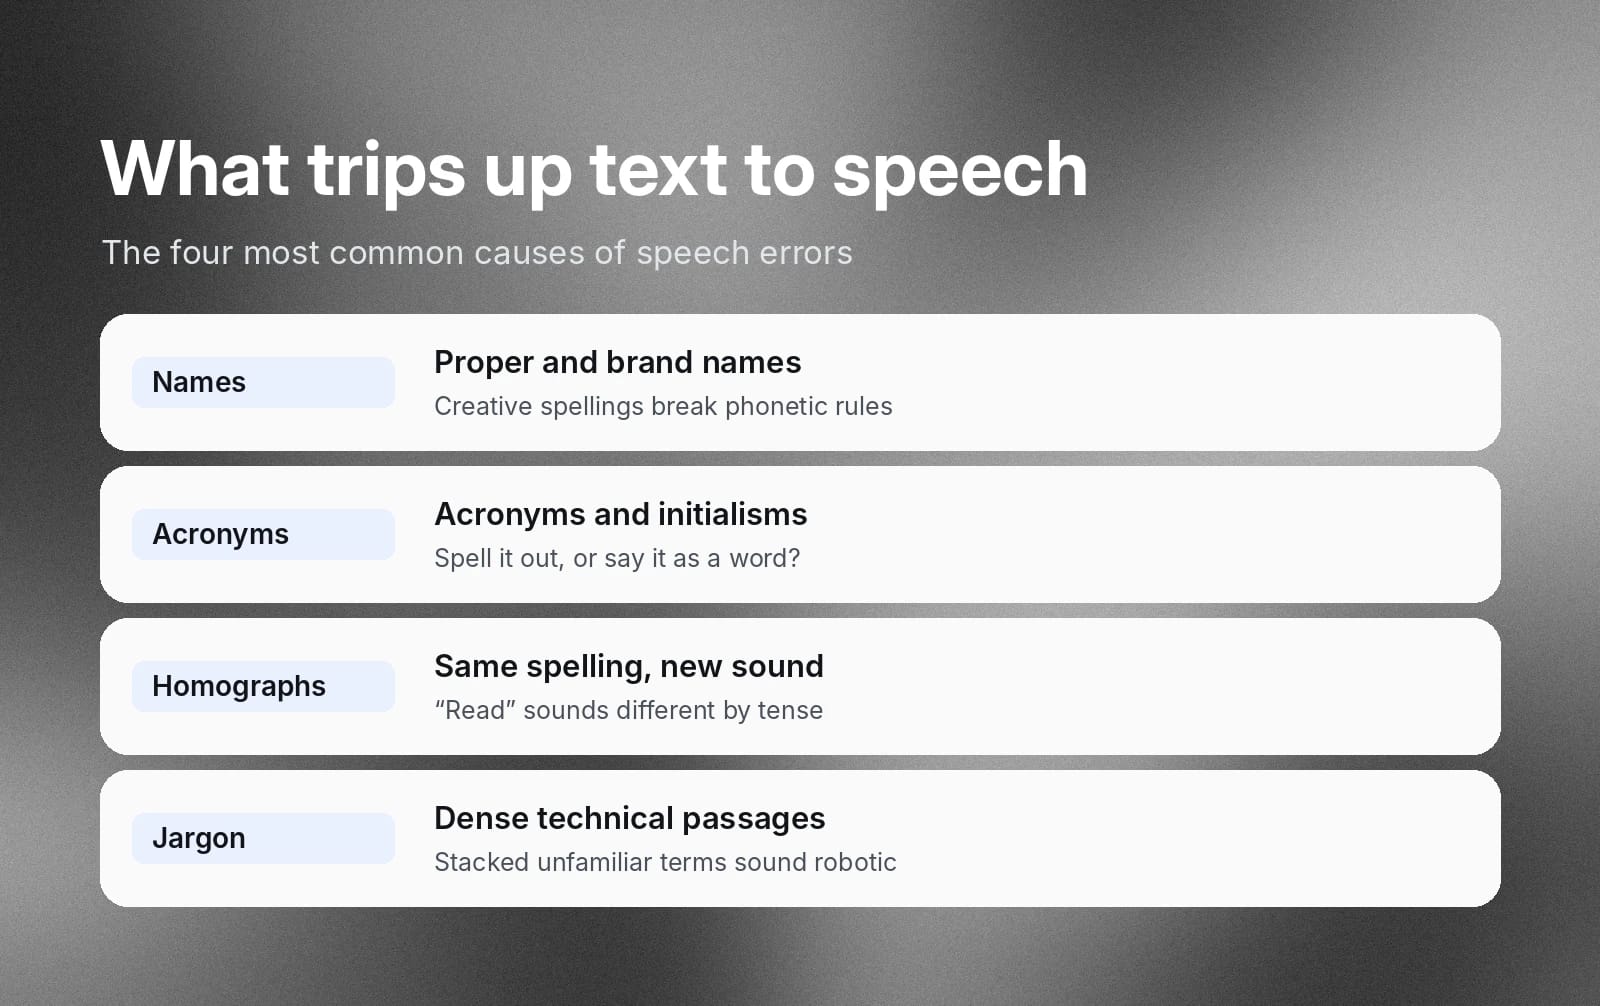
व्यवसाय अक्सर ब्रांड नामों के लिए रचनात्मक वर्तनी का इस्तेमाल करते हैं। वे ध्यान खींचते हैं, लेकिन अक्सर स्पीच सिंथेसिस मॉडल को भ्रमित भी करते हैं। इसी कारण रचनात्मक पहले नाम और उपनामों के साथ भी ऐसा हो सकता है।
जब किसी मॉडल को कोई अपरिचित नाम मिलता है, तो वह अपने सीखे हुए बुनियादी ध्वन्यात्मक नियम लागू करने की कोशिश करता है। हो सकता है कि आउटपुट स्पीच आपकी अपेक्षा से काफी अलग हो।
संक्षिप्त शब्द और इनिशियलिज़्म
NASA संक्षिप्त शब्द के बारे में सोचें। कल्पना करें कि आपने इसे पहले कभी नहीं देखा, ठीक वैसे ही जैसे किसी स्पीच मॉडल ने नहीं देखा हो। क्या आप इसे “N.A.S.A.” बोलेंगे या “nasuh?” किसी सॉफ़्टवेयर API का क्या? क्या वह “A.P.I.” है या “apee?” अगर आपकी कंपनी नए संक्षिप्त नाम वाला बिल्कुल नया सॉफ़्टवेयर टूल बेच रही हो तो? आप पक्के तौर पर कह सकते हैं कि वह स्पीच मॉडल के ट्रेनिंग डेटा में नहीं होगा। इसलिए, जब तक आप उसे कस्टम निर्देश न दें, मॉडल को आपके इच्छित उच्चारण का अनुमान लगाना पड़ेगा।
होमोग्राफ
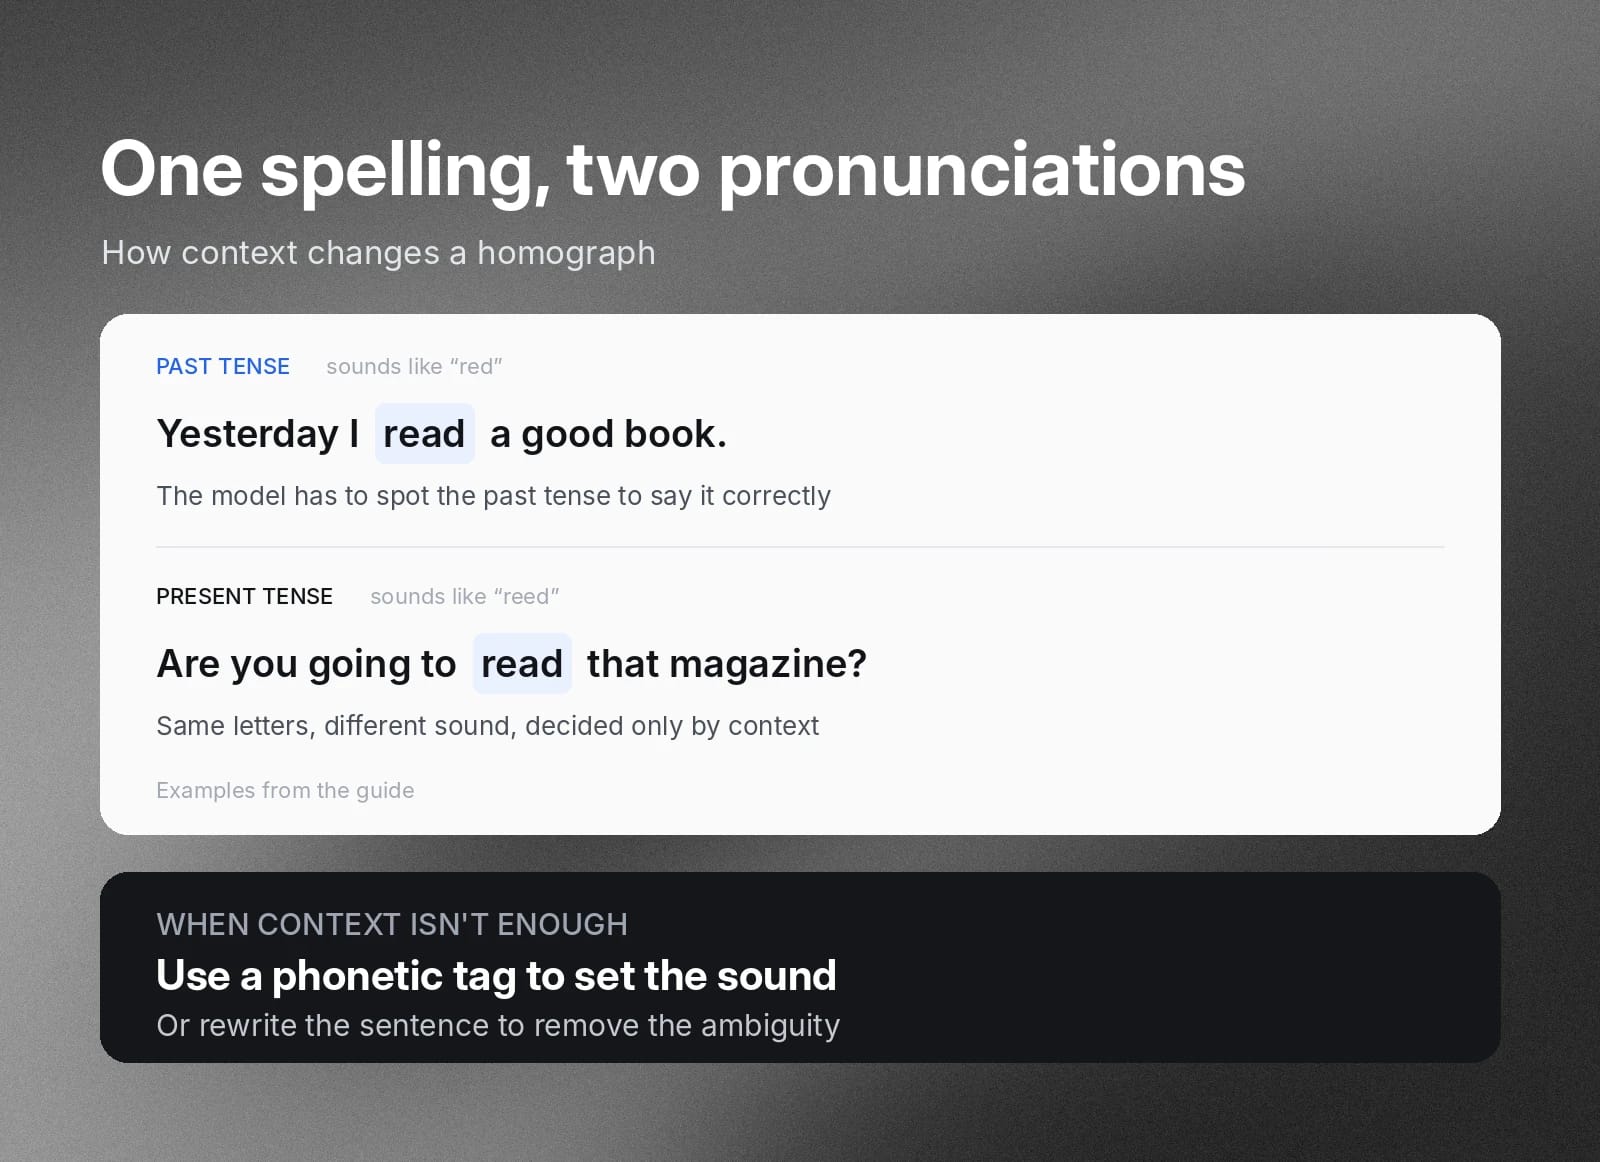
होमोग्राफ ऐसे शब्द हैं जिनकी वर्तनी एक जैसी होती है, लेकिन संदर्भ के आधार पर उनके उच्चारण अलग होते हैं। उदाहरण के लिए, “read” शब्द की वर्तनी एक ही है, लेकिन भूतकाल और वर्तमानकाल में उसका उच्चारण अलग होता है।
- “कल मैंने एक अच्छी किताब पढ़ी।”
- “क्या आप वह पत्रिका पढ़ने वाले हैं?”
होमोग्राफ का आपकी इच्छा के अनुसार उच्चारण तय करने के लिए स्पीच मॉडल को पर्याप्त संदर्भ समझ की ज़रूरत होगी।
अस्वाभाविक बलाघात पैटर्न
तकनीकी जार्गन वाले लंबे वाक्यों में विशिष्ट उच्चारण और संक्षिप्त शब्दों के साथ कई अपरिचित शब्द जल्दी-जल्दी आ सकते हैं। जो त्रुटि अकेले में ध्यान न देने लायक हो, वह कई अपरिचित शब्दों और वाक्यांशों को पार्स करने की कोशिश में मॉडल की सपाट, रोबोटिक स्पीच का हिस्सा जल्दी बन सकती है।
वॉइस के उच्चारण को नियंत्रित करने के दो तरीके
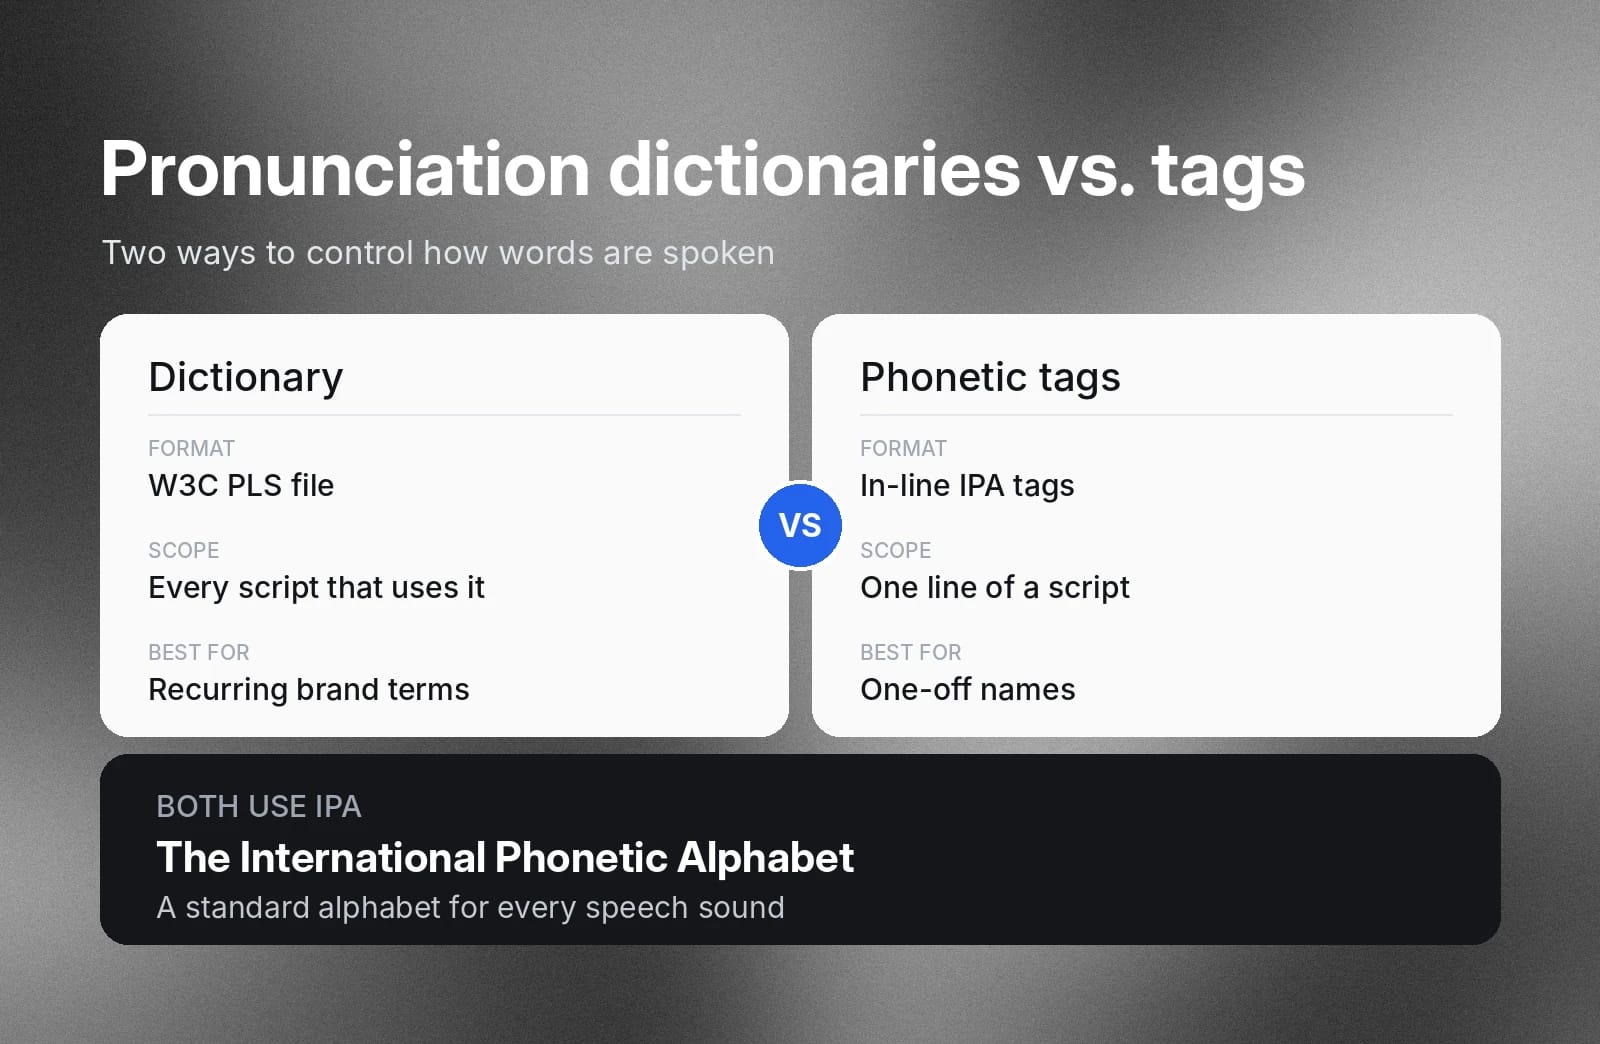
इन स्थितियों से बचने के लिए आपको अपनी स्क्रिप्ट पूरी तरह से फिर से लिखने की ज़रूरत नहीं है। आधुनिक न्यूरल स्पीच मॉडल में इन्हें हर मामले के अनुसार कुशलता से ठीक करने के दो टूल होते हैं: उच्चारण डिक्शनरी और फोनेटिक स्क्रिप्ट टैग।
टेक्स्ट टू स्पीच उच्चारण डिक्शनरी
डिक्शनरी तब सबसे बेहतर होती हैं, जब आपके पास कस्टम उच्चारणों का ऐसा संग्रह हो जो आपके TTS प्रोजेक्ट्स में नियमित रूप से दोहराया जाता हो। उदाहरण के लिए, यदि आपकी कंपनी मेडिकल डिवाइस बेचती है और आपकी स्क्रिप्ट में नियमित रूप से तकनीकी शब्द, चिकित्सकीय प्रक्रियाएं और अन्य डोमेन-विशिष्ट सामग्री होती है।
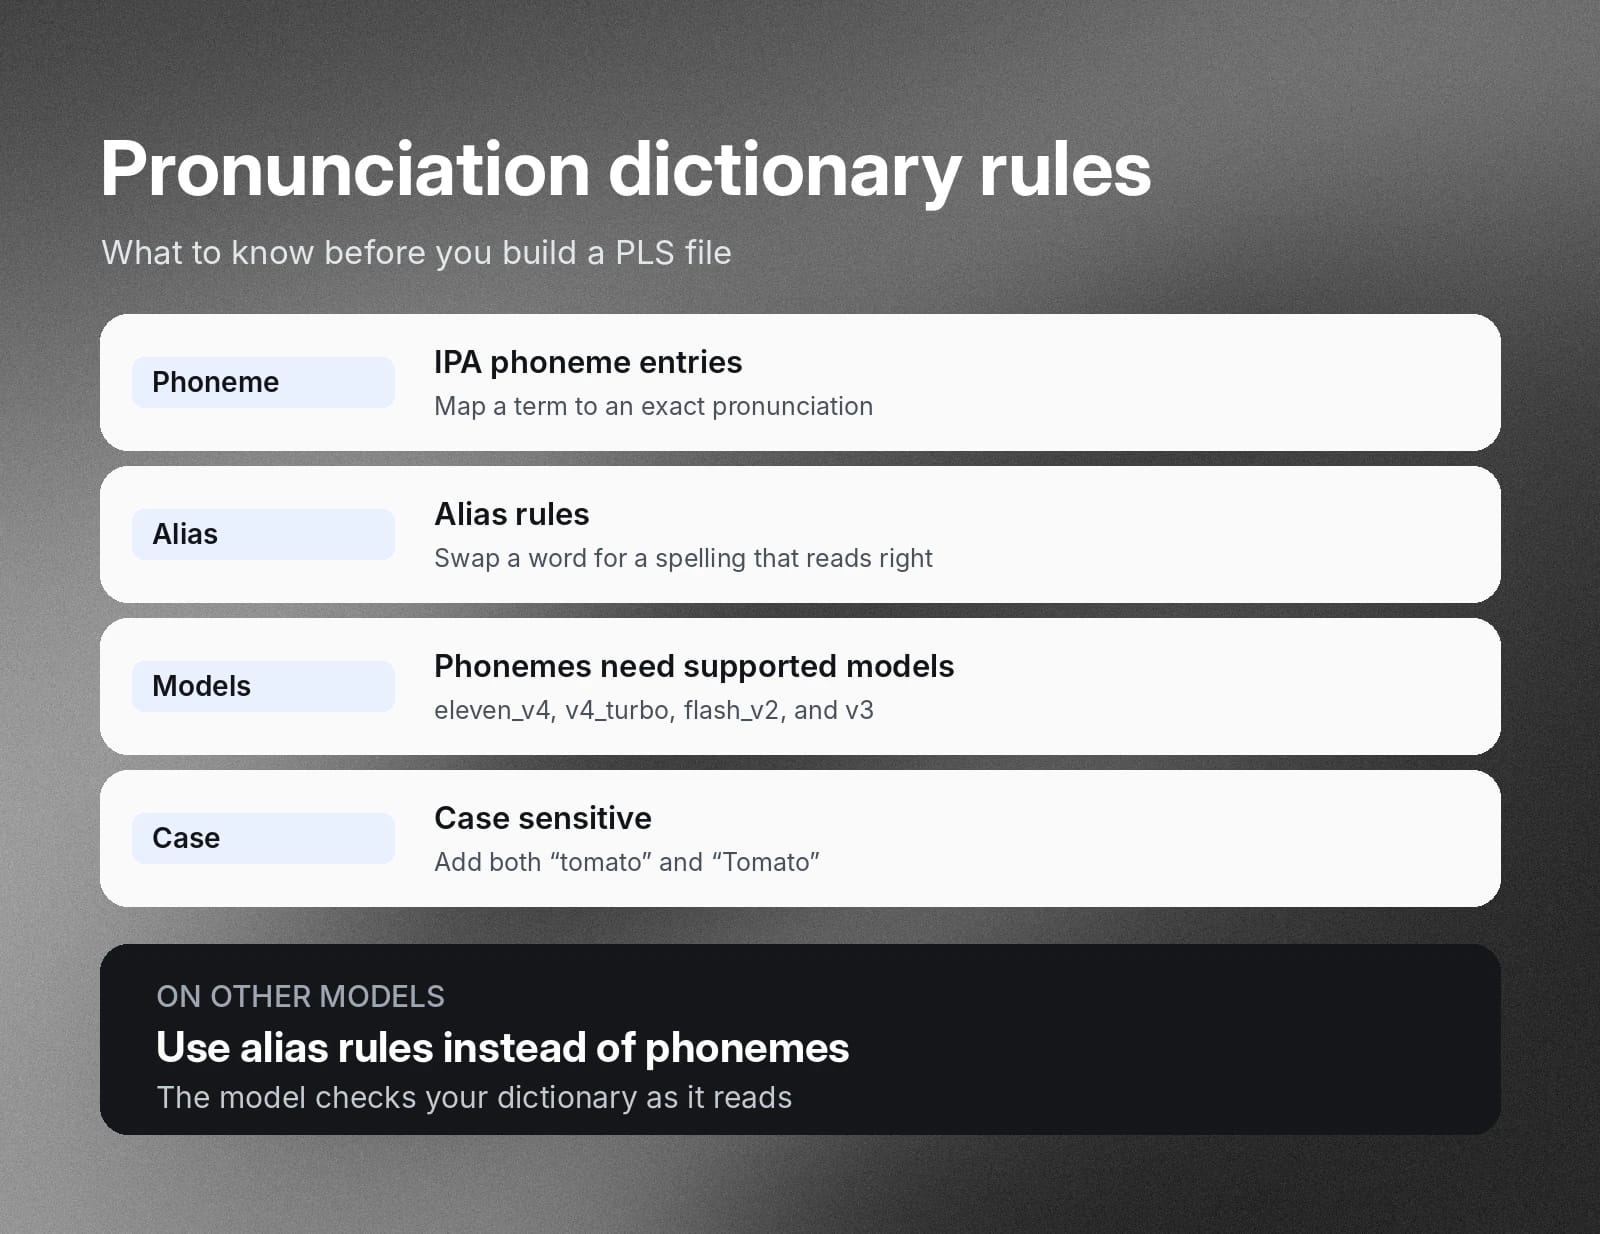
W3C-मानक Pronunciation Lexicon Specification (PLS) फ़ॉर्मैट, International Phonetic Alphabet (IPA) नोटेशन का उपयोग करके उन शब्दों को विशिष्ट ध्वन्यात्मक उच्चारणों से मैप करने का ढांचा देता है। International Phonetic Alphabet सभी संभव स्पीच ध्वनियों की मानकीकृत वर्णमाला है। स्पीच मॉडल स्क्रिप्ट पढ़ते समय आपकी डिक्शनरी जांचता है और डिक्शनरी में मौजूद शब्द मिलने पर आपके दिए उच्चारणों का इस्तेमाल करता है। फोनिम एंट्री केवल eleven_v4, eleven_v4_turbo, eleven_flash_v2 और eleven_v3 मॉडल के साथ काम करती हैं। दूसरे मॉडल पर इसके बजाय एलियस नियमों का इस्तेमाल करें। PLS फ़ाइलें केस-सेंसिटिव होती हैं, इसलिए अगर दोनों चाहिए तो “tomato” और “Tomato” दोनों जोड़ें।
फोनेटिक स्क्रिप्ट टैग
जब आपको स्क्रिप्ट की अलग-अलग पंक्तियों में बदलाव करना हो, तो फोनेटिक टैग आम तौर पर बेहतर विकल्प होते हैं। डिक्शनरी बनाने के बजाय, आप इन-लाइन फोनेटिक टैग इस्तेमाल करते हैं जो स्पीच मॉडल को IPA के अनुसार किसी शब्द को आपके इच्छित तरीके से बोलने का निर्देश देते हैं।
उदाहरण के लिए, मान लें कि आप पॉडकास्ट स्क्रिप्ट लिख रहे हैं और किसी इंडस्ट्री एक्सपर्ट का दो या तीन बार उल्लेख करना चाहते हैं। उसे अपनी कॉर्पोरेट उच्चारण डिक्शनरी में जोड़ने के बजाय, स्क्रिप्ट में उसका इस्तेमाल करते समय आप उसके नाम को सही उच्चारण के साथ टैग कर दें।
ऐसी स्क्रिप्ट लिखें और फ़ॉर्मैट करें जो ज़ोर से बोलने पर स्वाभाविक लगे
डिक्शनरी और टैग स्पीच आउटपुट में अलग-अलग शब्दों की समस्याओं को संभालने में उपयोगी हैं, लेकिन वे समग्र डिलीवरी, लय और स्पीच की गतिशीलता को ठीक नहीं करते। स्क्रिप्ट लिखते समय यह समझकर टेक्स्ट तैयार करना ज़रूरी है कि उसे ज़ोर से बोला जाएगा। आपके शब्दों का चयन, वाक्यांश और विराम चिह्न अक्सर केवल पढ़ने के लिए लिखे टेक्स्ट से अलग होने चाहिए।
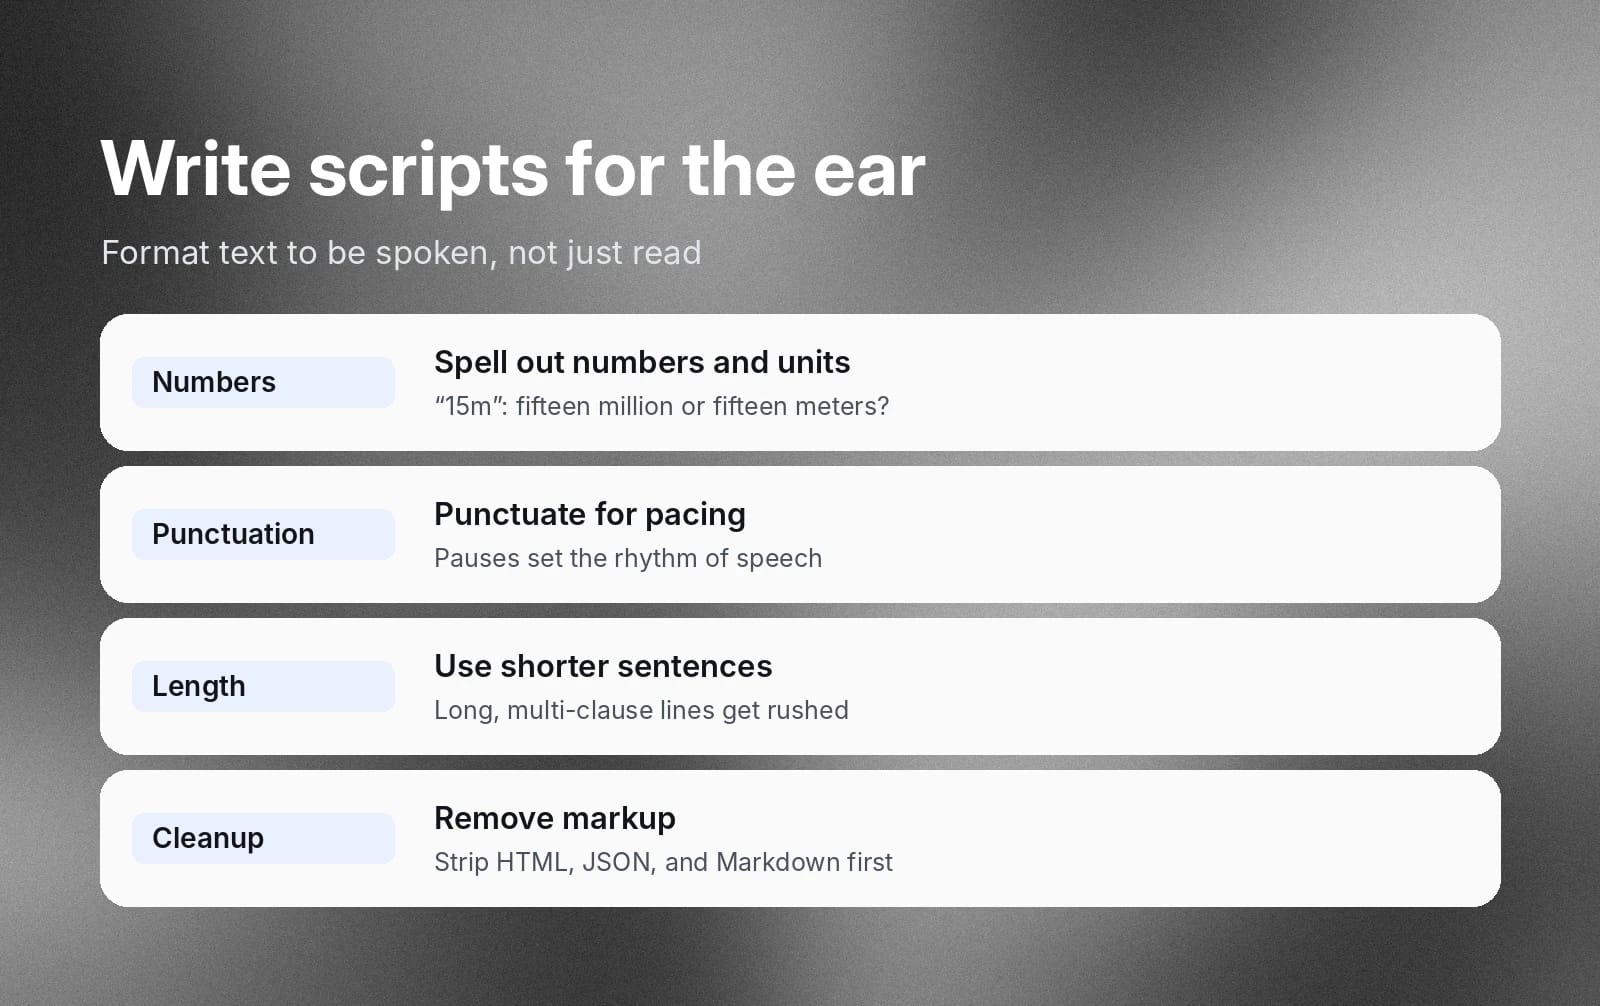
आंखों के लिए नहीं, कानों के लिए लिखें
अपनी स्क्रिप्ट को स्पीच राइटर की सोच के साथ लिखें: “मैं इसे ज़ोर से कैसे बुलवाना चाहता हूं? नाटकीय प्रभाव के लिए हम कहां रुकें? हम कहां तेज़ बोलें?” ये सवाल उन्नत न्यूरल स्पीच मॉडल की स्क्रिप्ट पर उतने ही लागू होते हैं, जितने किसी व्यक्ति के लिए लिखी स्क्रिप्ट पर।
संख्याएं, मुद्राएं और तारीखें पूरे शब्दों में लिखें
आप अपनी स्क्रिप्ट में कोई अस्पष्टता नहीं छोड़ना चाहते। न्यूरल स्पीच मॉडल संदर्भ अच्छी तरह समझते हैं, लेकिन जब उन्हें अनुमान नहीं लगाना पड़ता, तो वे सबसे अच्छा काम करते हैं। संक्षिप्त रूप और शॉर्टहैंड ऐसी आम चीजें हैं जिन पर वे अटक सकते हैं।
उदाहरण के लिए, स्क्रिप्ट में लिखा हो सकता है, “आप 15m के करीब की संख्या ढूंढ रहे हैं।” क्या लेखक चाहता है कि TTS इंजन “पंद्रह मिलियन” बोले या “पंद्रह मीटर?” इसे पूरा लिखें, ताकि मॉडल को संदर्भ से अनुमान न लगाना पड़े।
गति नियंत्रित करने के लिए सामान्य विराम चिह्नों का इस्तेमाल करें
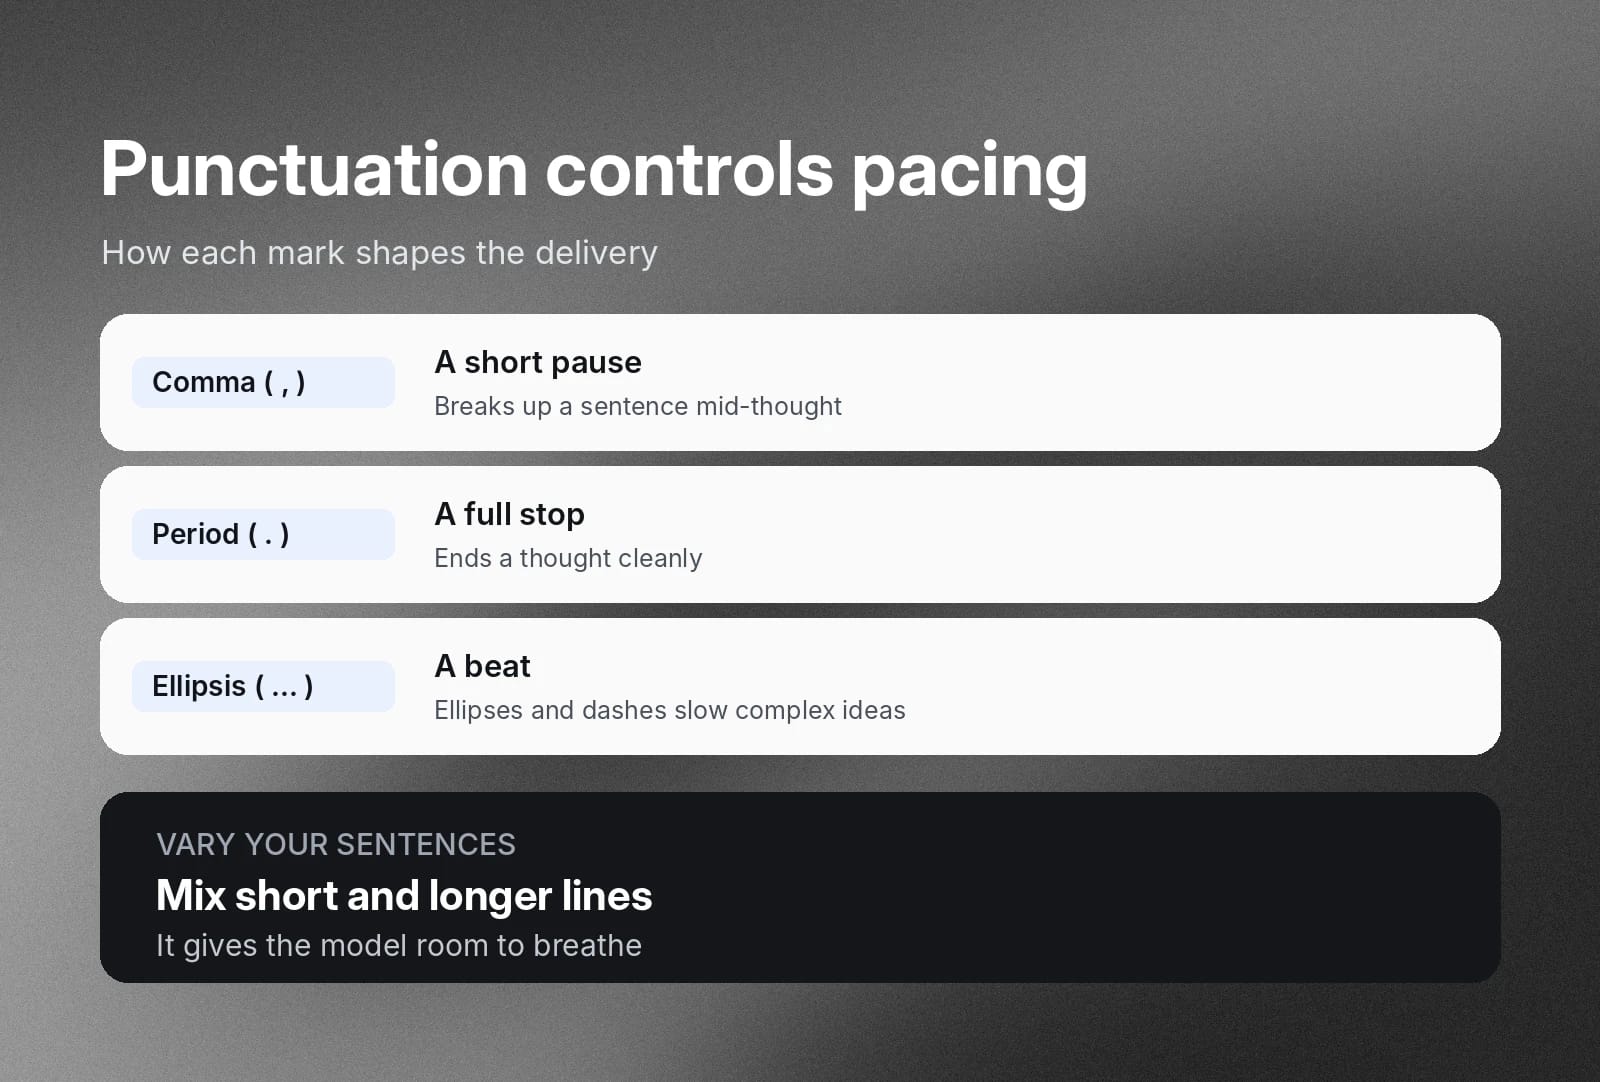
लिखित टेक्स्ट में विराम चिह्न महत्वपूर्ण भूमिका निभाते हैं, लेकिन टेक्स्ट टू स्पीच सिंथेसिस में वे और भी ज़्यादा मायने रखते हैं। विराम चिह्न लय नियंत्रित करते हैं। वे अलग-अलग तरह के विराम दर्शाते हैं, जिनसे आप जटिल विचारों को बांट सकते हैं या बस ऐसी स्वाभाविक लय बनाए रख सकते हैं जिसे सुनना अधिक सहज हो।
- वाक्य के बीच में छोटे विराम के लिए कॉमा का इस्तेमाल करें।
- किसी विचार को समाप्त करने के लिए पूर्ण विराम लगाएं।
- जटिल विचारों के बीच एक ठहराव जोड़ने के लिए इलिप्सिस और एम डैश का उपयोग करें, ताकि आपका मॉडल जल्दबाज़ी में न लगे।
छोटे वाक्य बेहतर वाक्य होते हैं
मॉडल लंबे, शर्तों वाले और कई क्लॉज़ वाले वाक्यों पर सबसे अधिक अटक सकते हैं या उन्हें जल्दी बोल सकते हैं। इन्हें अलग-अलग लंबाई वाले छोटे कथनों में बांट दें। इससे मॉडल को अधिक जगह मिलती है और लंबे, लगातार चलते वाक्यों की लय खोजते समय वह जल्दबाज़ी नहीं करता।
फ़ॉर्मैटिंग और Markdown आर्टिफैक्ट हटाएं
अगर आप किसी कंटेंट मैनेजमेंट सिस्टम या दूसरे बिज़नेस सिस्टम से लिए गए टेक्स्ट की स्पीच सिंथेसाइज़ कर रहे हैं, तो उसमें HTML, JSON, Markdown या अन्य फ़ॉर्मैटिंग हो सकती है। सबसे स्वाभाविक लगने वाली स्पीच पाने के लिए इन्हें हटाकर टेक्स्ट के रूप में फ़ॉर्मैट करें। स्पीच मॉडल को यह समझने में मुश्किल हो सकती है कि इन टैग को कब अनदेखा करना है, उन्हें शब्दशः पढ़ना है या अपने आउटपुट में संदर्भ के अनुसार शामिल करना है।
आप ElevenLabs ट्रबलशूटिंग गाइड में गलत उच्चारण और अन्य समस्याओं को और विस्तार से देख सकते हैं।
ElevenLabs API की आम त्रुटियां ठीक करें
बड़े पैमाने पर वॉइस ऑडियो बनाने वाली टीमें आम तौर पर API के ज़रिए अपने ऐप्लिकेशन को स्पीच सिंथेसिस मॉडल से जोड़ती हैं। इससे कुल मिलाकर प्रोडक्शन अधिक कुशल होता है, लेकिन मॉडल के स्पीच आउटपुट के अलावा एक तकनीकी स्तर भी जुड़ जाता है जिसे आपको मैनेज करना होता है।
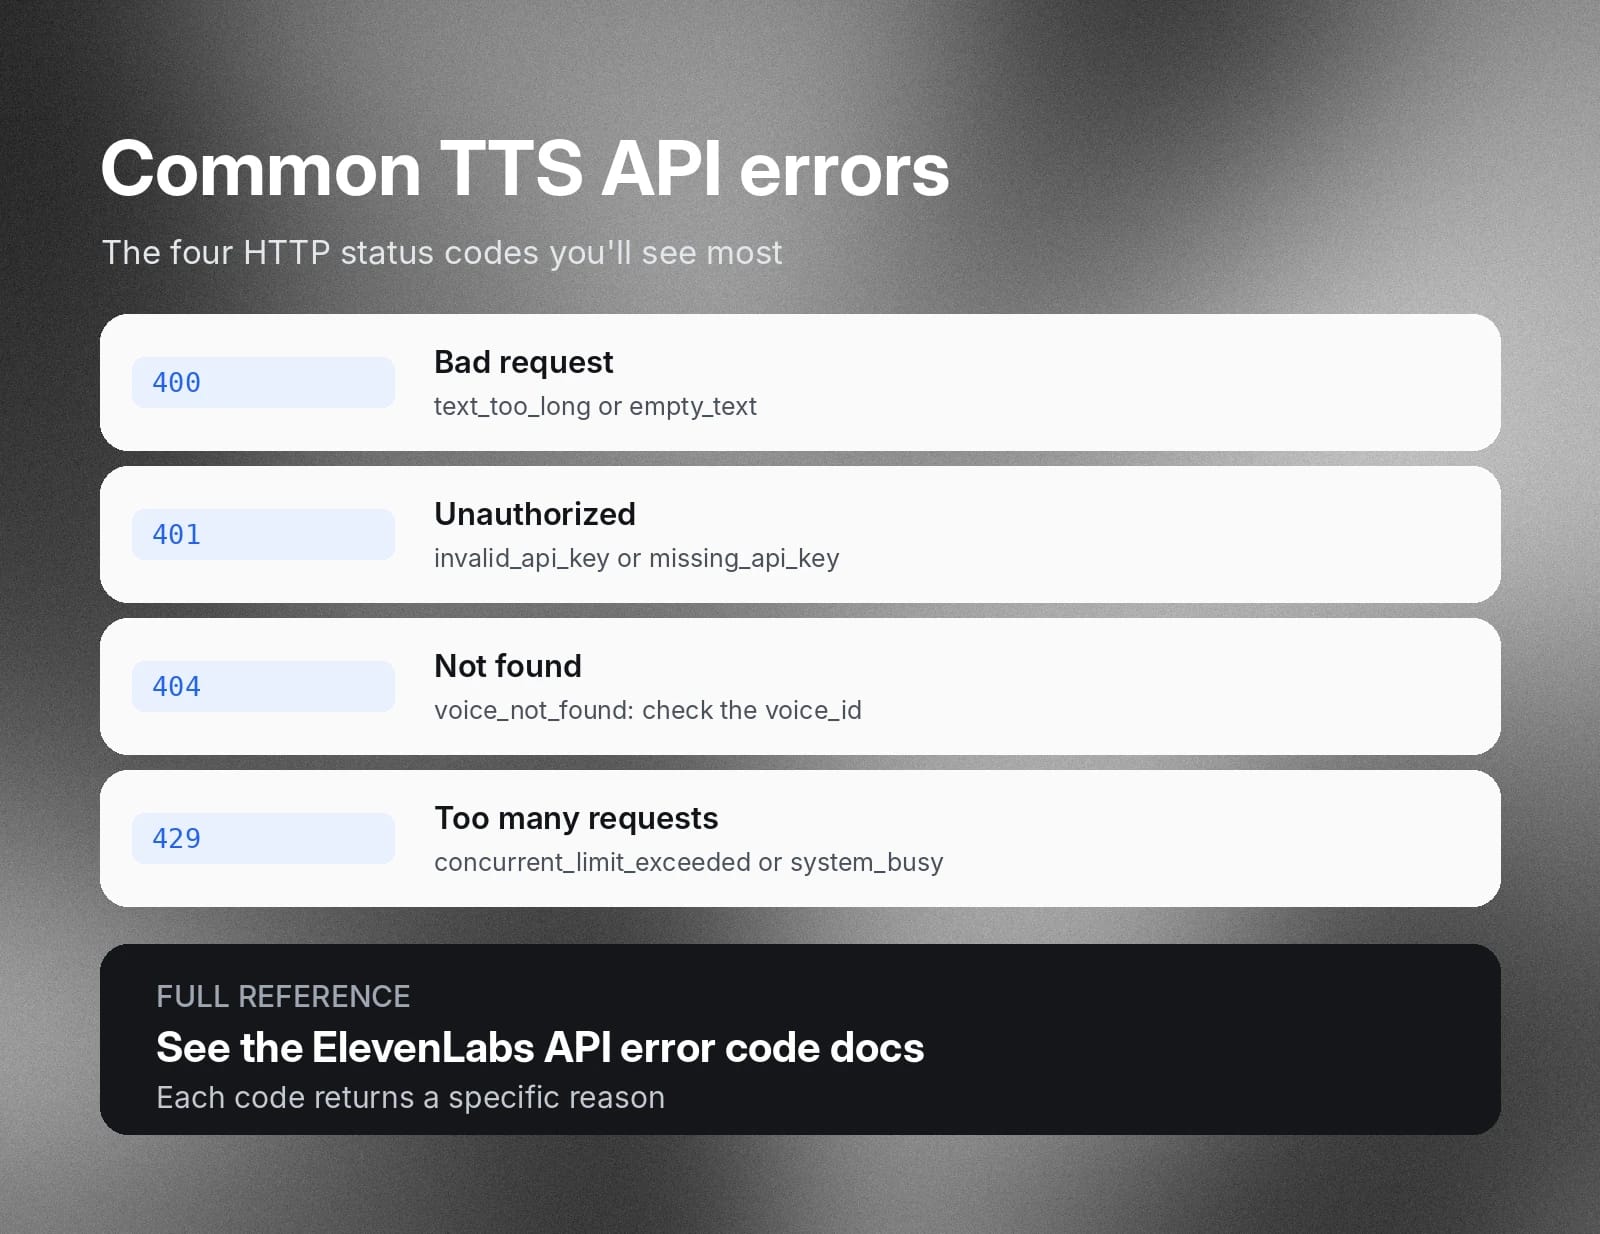
ElevenLabs API त्रुटि कोड रेफरेंस में रिस्पॉन्स कोड का विस्तार से वर्णन है, लेकिन टेक्स्ट टू स्पीच इंटीग्रेशन की ट्रबलशूटिंग के दौरान मिलने वाले चार सबसे आम HTTP स्टेटस कोड और उन्हें ठीक करने के तरीके यहां दिए गए हैं।
400 Bad Request (Payload त्रुटियां)
स्पीच मॉडल API से 400 स्टेटस कोड रिस्पॉन्स का मतलब है कि आपके ऐप्लिकेशन ने ऐसा डेटा भेजा जिसे मॉडल प्रोसेस नहीं कर सका। TTS वर्कफ़्लो में आमतौर पर ऐसा कैरेक्टर सीमा पार करने या गलती से खाली इनपुट भेजने के कारण होता है।
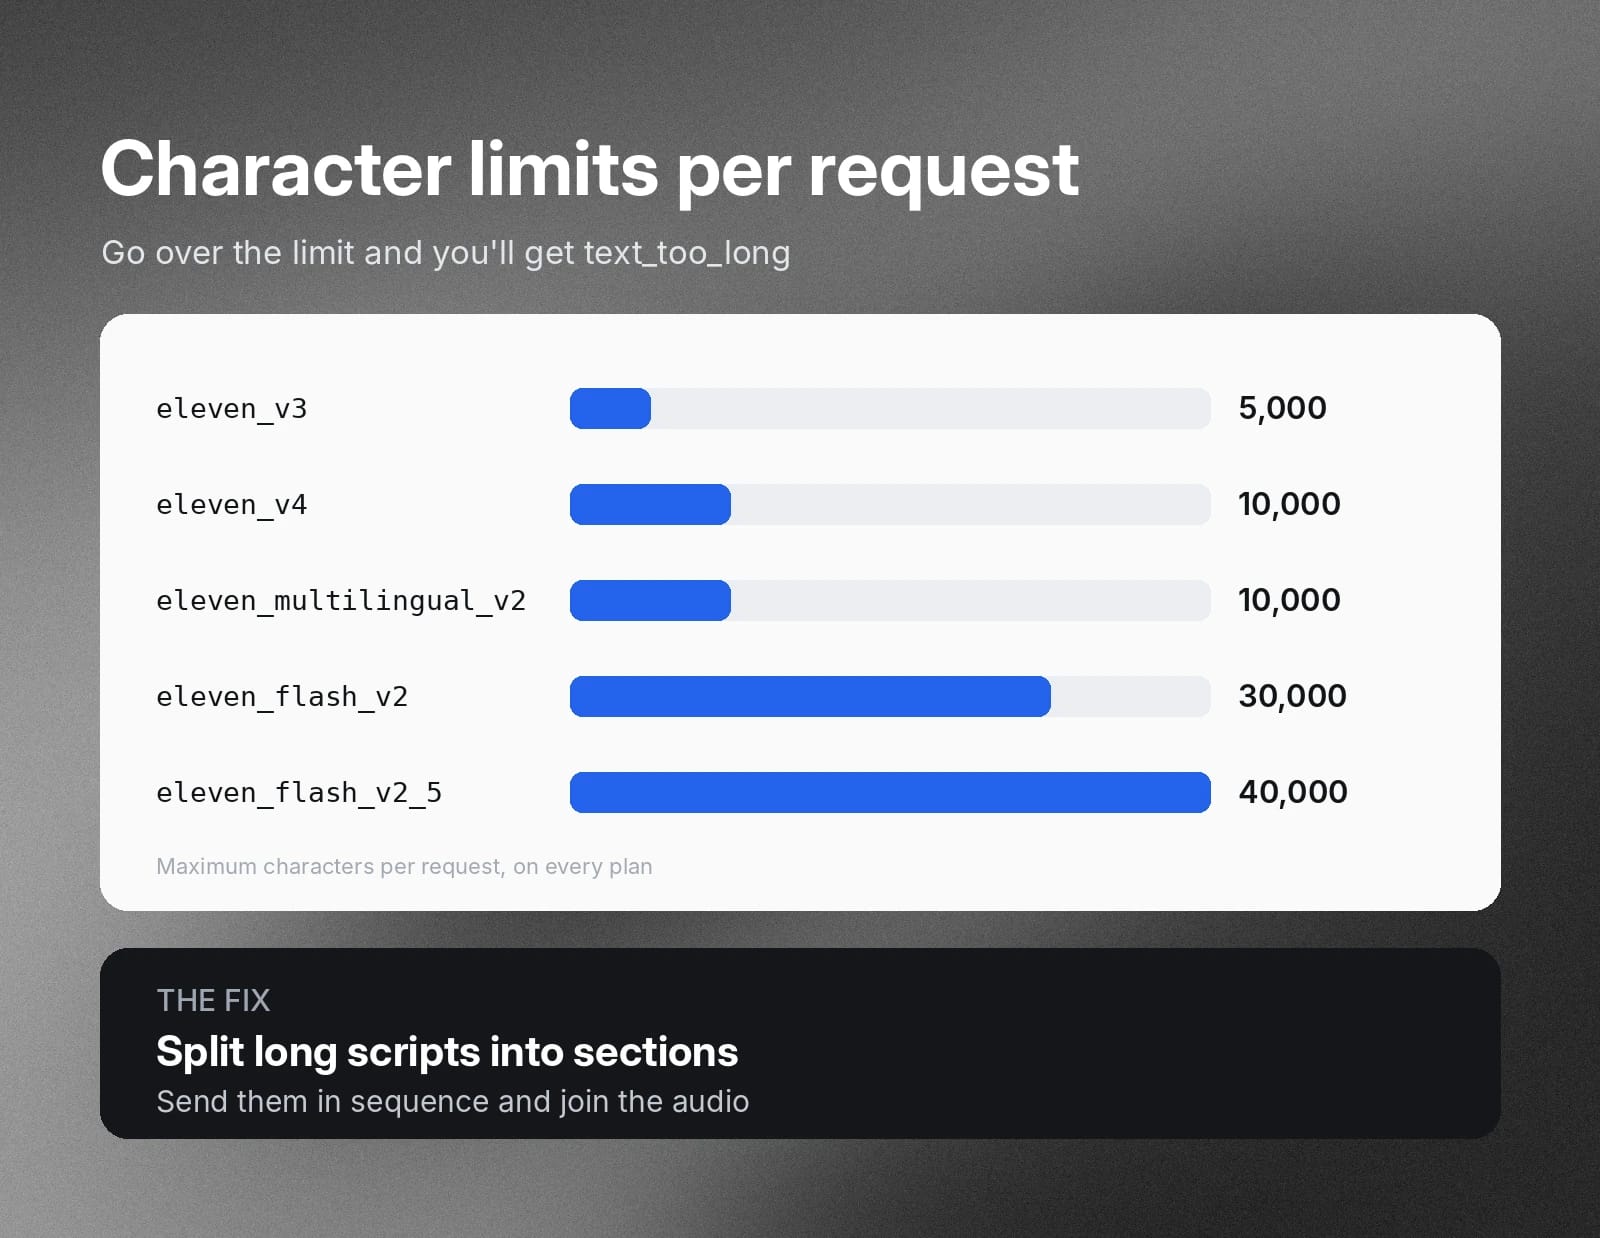
कैरेक्टर सीमा पार हो गई (text_too_long)
आपके भेजे हर TTS अनुरोध की मॉडल द्वारा तय की गई कैरेक्टर सीमा होती है। यदि आप मॉडल की अनुमति से अधिक टेक्स्ट भेजने की कोशिश करते हैं, तो TTS सर्वर यह त्रुटि लौटाएगा। हर प्लान में प्रति अनुरोध सीमा eleven_v4 और eleven_multilingual_v2 के लिए 10,000 कैरेक्टर, eleven_v3 के लिए 5,000, eleven_flash_v2 के लिए 30,000 और eleven_flash_v2_5 के लिए 40,000 है। इसे हल करने के लिए लंबी स्क्रिप्ट को कई सेक्शन में बांटें, जिन्हें मॉडल क्रम से प्रोसेस कर सके।
खाली इनपुट टेक्स्ट
TTS इंजन खाली स्ट्रिंग (empty_text) वाले किसी भी पेलोड को अस्वीकार कर देगा। अपनी इनपुट पाइपलाइन में खाली पंक्तियां हटाने के लिए क्लीनिंग चरण शामिल करें, ताकि सर्वर किसी अन्यथा काम करने योग्य पेलोड को अस्वीकार न करे।
401 Unauthorized (ऑथेंटिकेशन समस्याएं)
401 त्रुटि कोड का मतलब है कि API गेटवे ने आपके क्रेडेंशियल अस्वीकार कर दिए और आपका पेलोड मॉडल तक नहीं पहुंचा। ऐसा API key में समस्या होने पर होता है।
अमान्य API key
मॉडल सर्वर को भेजे आपके अनुरोध में एक मान्य xi-api-key शामिल होनी चाहिए। अगर नहीं है, तो सर्वर 401 त्रुटि लौटाएगा। जांचें कि आपकी key वास्तव में अनुरोध में मौजूद है और डिप्लॉयमेंट के दौरान उसे रद्द, एक्सपायर या हेडर से छोटा नहीं किया गया है। key गलत होने पर API invalid_api_key और कोई key न भेजने पर missing_api_key लौटाता है।
404 Not Found (वॉइस आइडेंटिफ़ायर मेल न खाना)
जब एंडपॉइंट URL अनुरोध में बताए गए TTS रिसोर्स को नहीं ढूंढ पाता, तो आपको 404 त्रुटि मिलती है। ऐसा तब हो सकता है जब आप गलत voice_id पैरामीटर भेजते हैं या वह अनुरोध URL में मौजूद ही नहीं होता। इस्तेमाल के लिए सही voice_id प्राप्त करना सुनिश्चित करें। जांचें कि यह पाथ पैरामीटर में वास्तव में मौजूद है और उसमें टाइपो नहीं है। वॉइस ID मौजूद न होने पर API voice_not_found लौटाता है।
429 Too Many Requests
इस त्रुटि के दो अलग कारण हैं: आपने अपनी सर्विस टियर की कॉन्करेंट अनुरोध सीमा पार कर ली है, या TTS प्लेटफ़ॉर्म ट्रैफ़िक बढ़ने को संभालने के लिए अनुरोधों की गति सीमित कर रहा है।
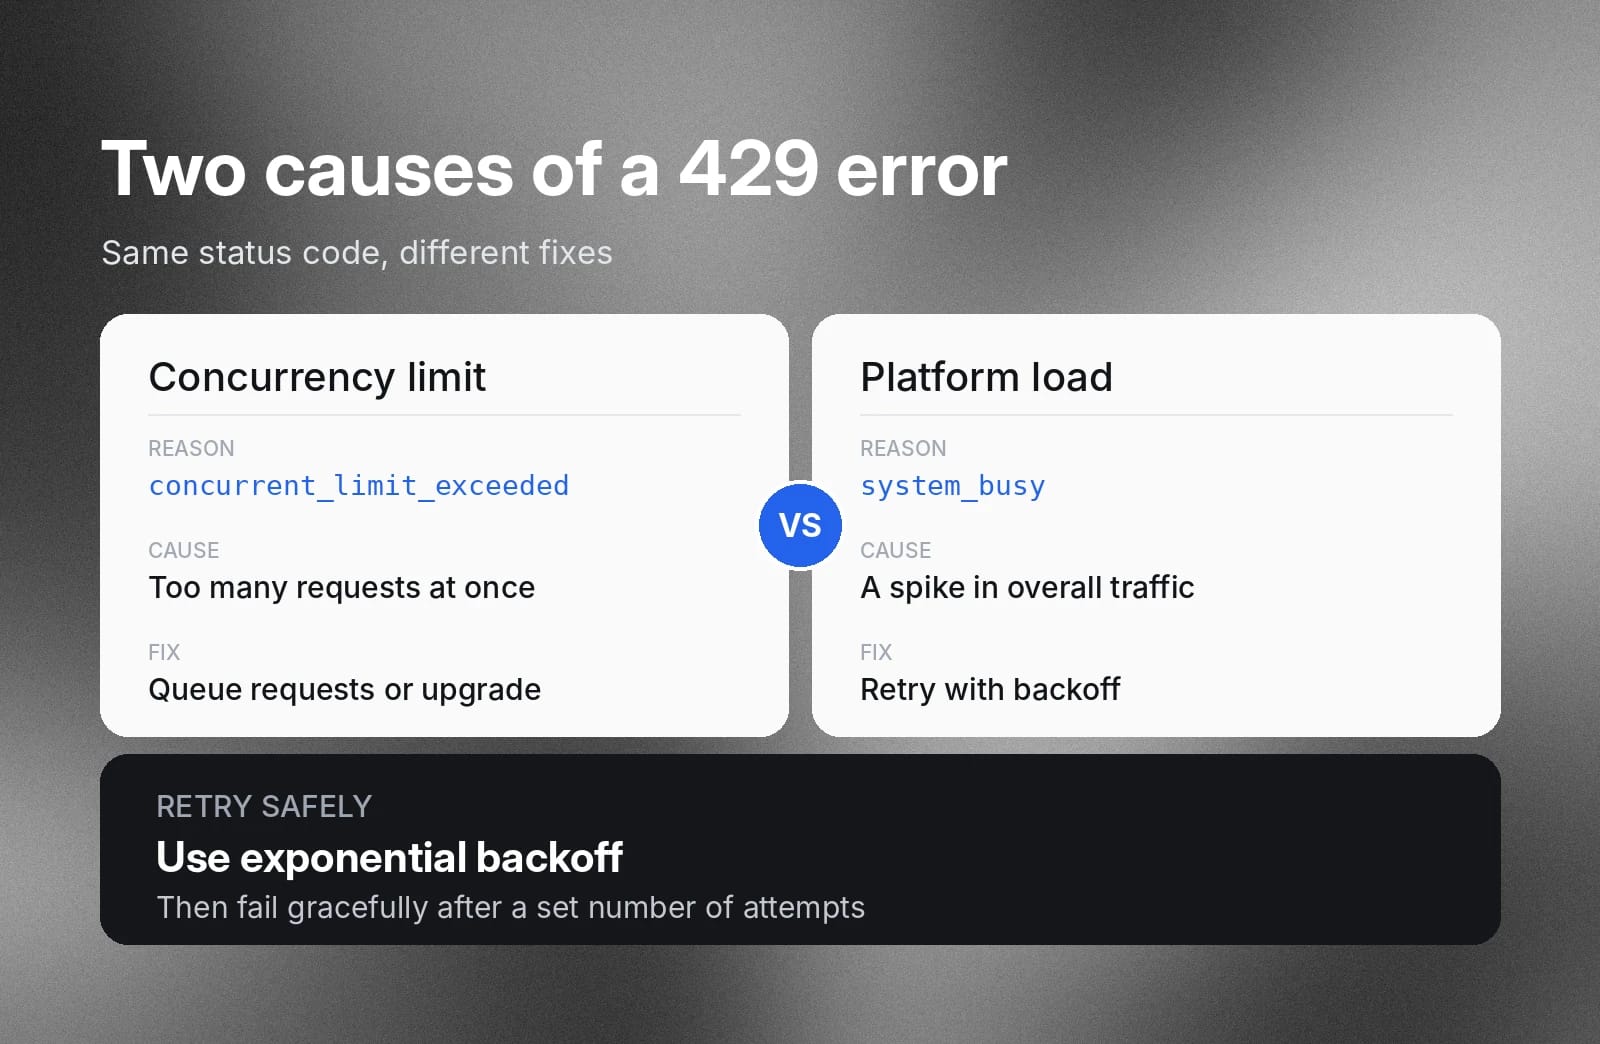
कॉन्करेंसी सीमाएं (concurrent_limit_exceeded)
TTS इंजन की हर सब्सक्रिप्शन टियर में आपके भेज सकने वाले कॉन्करेंट अनुरोधों की एक निश्चित संख्या होती है। अगर आपके ऐप्लिकेशन उस सीमा से अधिक हो जाते हैं, तो सर्वर इस प्रकार की 429 त्रुटि लौटाएगा।
Redis जैसी सेवा का उपयोग करके एक असिंक्रोनस क्यूइंग लेयर बनाएं, जो आपके आउटगोइंग पेलोड को मापे ताकि वे आपकी टियर सीमाओं से अधिक न हों। या आकलन करें कि क्या उच्च टियर की सब्सक्रिप्शन किफायती है।
प्लेटफ़ॉर्म लोड स्पाइक (system_busy)
भारी लोड में, TTS सर्वर परफ़ॉर्मेंस बनाए रखने के लिए आने वाले अनुरोधों की गति सीमित कर सकता है। अपने ऐप्लिकेशन के API क्लाइंट में स्वचालित रिट्राई लॉजिक बनाएं। सुनिश्चित करें कि वह एक्सपोनेंशियल बैकऑफ़ के साथ रिट्राई कर सके और अधिकतम कोशिशों के बाद सुरक्षित रूप से विफल हो जाए।
पब्लिश करने से पहले वॉइस, भाषाओं और सेटिंग्स को टेस्ट करें
बड़े पैमाने के TTS पेलोड के लिए त्वरित वेब ऐप टेस्ट आम तौर पर पर्याप्त क्वालिटी कंट्रोल नहीं होता। खराब रन की लागत तेज़ी से बढ़ सकती है। सबमिट करने से पहले अपनी स्क्रिप्ट को नियंत्रित इटरेशन की एक श्रृंखला में टेस्ट करें। यह शुरुआती तैयारी आपको सबसे उच्च गुणवत्ता वाला वॉइस ऑडियो सबसे कुशल तरीके से बनाने में मदद करेगी।
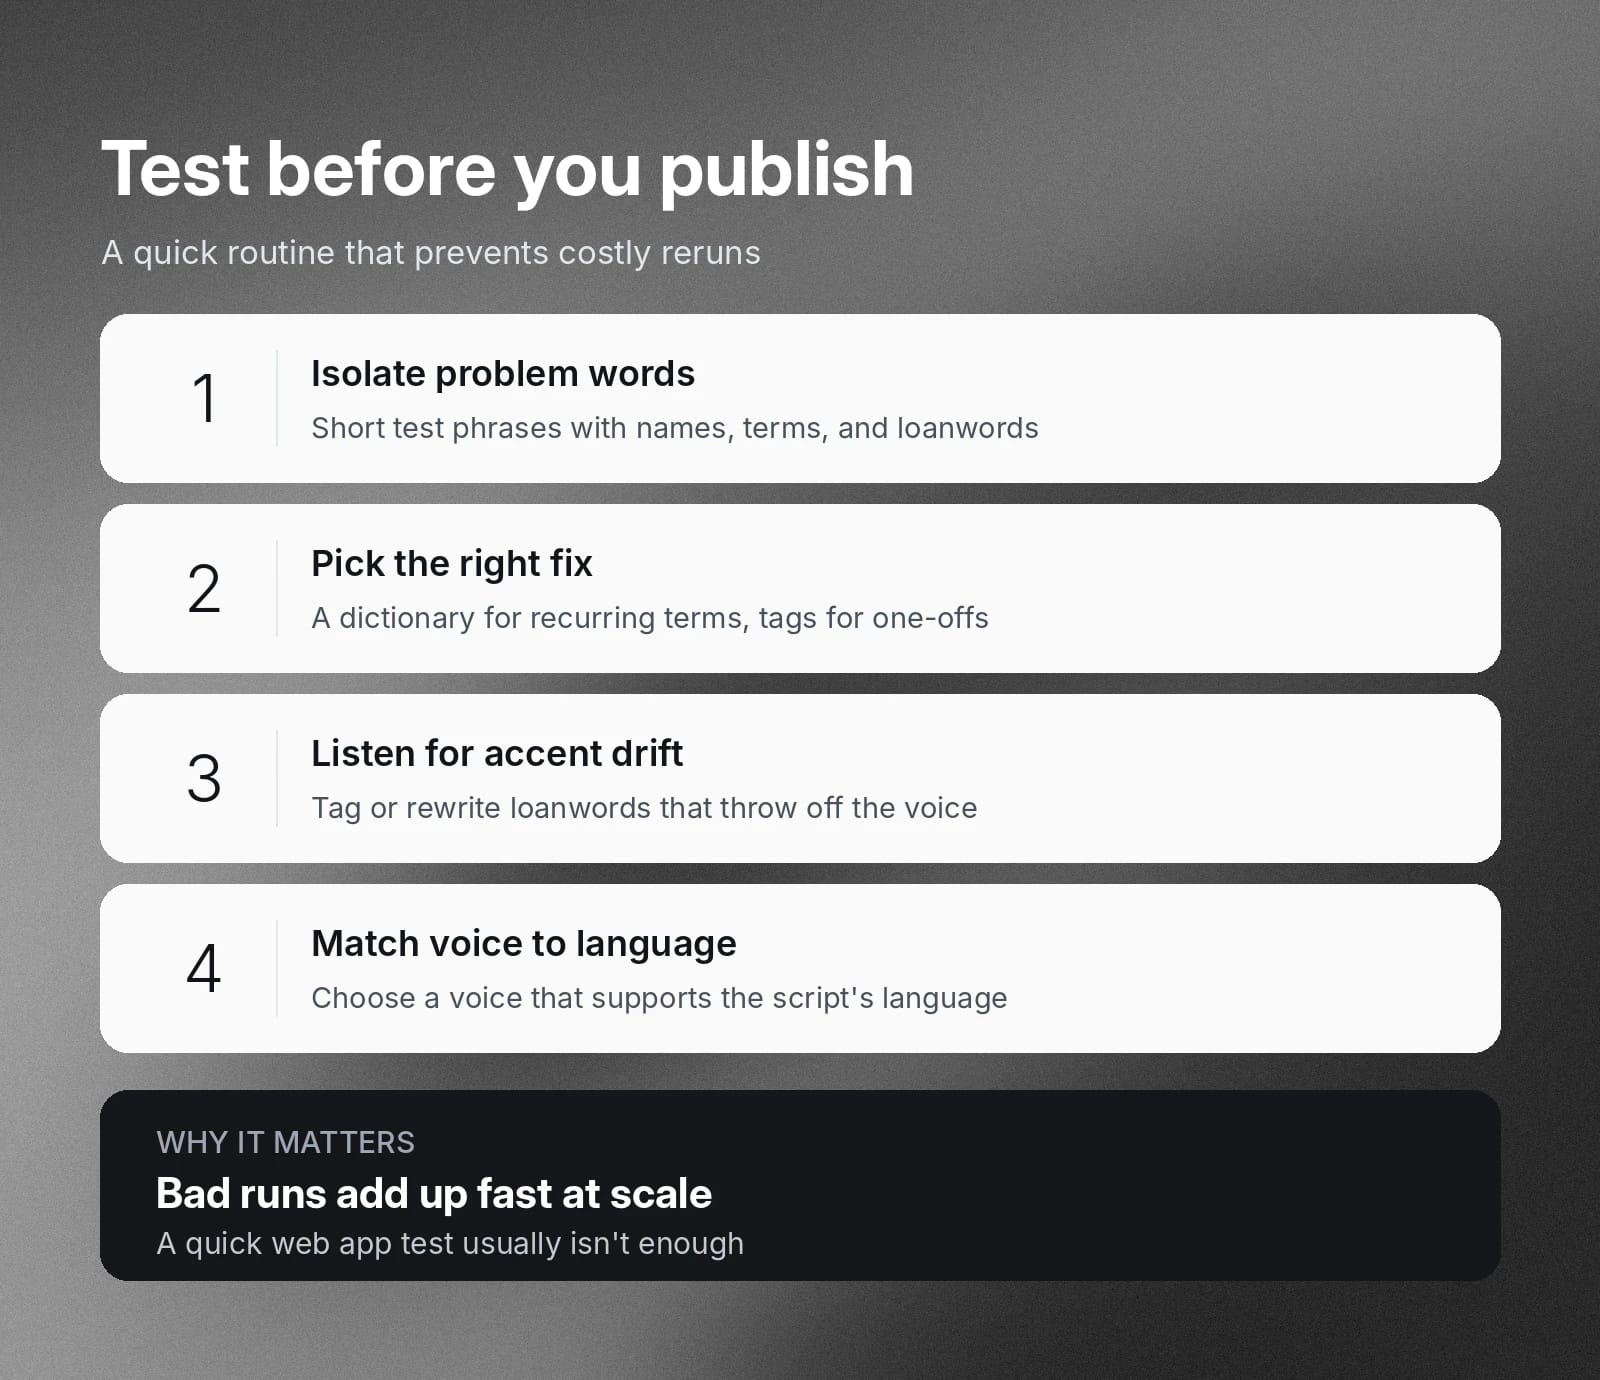
समस्याग्रस्त शब्दों को अलग से टेस्ट करें
आमतौर पर आपकी समस्याएं व्यापक होने के बजाय विशिष्ट अंशों या केवल खास शब्दों या नामों में होंगी। पांच से दस शब्दों के टेस्ट वाक्यांश बनाएं जिनमें आपके ब्रांड नाम, तकनीकी शब्द या विदेशी भाषा के वाक्यांश हों। आउटपुट के आधार पर तय करें कि हर मामले में उच्चारण डिक्शनरी इस्तेमाल करनी है या केवल फोनेटिक टैग।
संभावित भाषा या एक्सेंट ड्रिफ्ट पहचानें
स्पीच मॉडल कभी-कभी वाक्य के बीच में अजीब या धीमी लय अपना सकते हैं। ऐसा अक्सर तब होता है, जब मॉडल को ऐसे अंश के उच्चारण का अनुमान लगाना पड़ता है जो ट्रेनिंग में देखी गई चीज़ से अलग हो।
- उधार लिए गए शब्द: किसी विदेशी भाषा के अपरिचित उधार लिए गए शब्दों वाले टेक्स्ट से मॉडल की ग्राफ़ीम मैपिंग गड़बड़ा सकती है, जिससे उसके बाद की सारी स्पीच अजीब एक्सेंट वाली लग सकती है। उस शब्द पर फोनेटिक टैग इस्तेमाल करें या उसे फिर से लिखें।
- अटकी हुई गैर-अंग्रेज़ी स्पीच: अंग्रेज़ी के लिए ऑप्टिमाइज़ किया गया मॉडल अनुवादित स्क्रिप्ट पढ़ते समय हकलाने या रोबोटिक लगने लग सकता है। ऐसा वॉइस प्रोफ़ाइल चुनें जो मूल भाषा को भी सपोर्ट करता हो।
अधिक भरोसेमंद स्पीच आउटपुट के लिए ElevenAPI के साथ शुरू करें
जब आपको पता होता है कि किन बातों पर ध्यान देना है, तो आप कम परेशानी के साथ तेज़ी से उच्च-गुणवत्ता वाला वॉइस कंटेंट बना पाएंगे। आउटपुट संबंधी और उन तकनीकी API समस्याओं को संभालना सीखें जो प्रोडक्शन को रोक सकती हैं।
उच्च-गुणवत्ता वाला, सटीक TTS कंटेंट बनाने के बारे में ElevenAPI के साथ और जानें या शुरू करने के लिए आज ही अपनी API key पाएं।
टेक्स्ट टू स्पीच समस्याओं के बारे में अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।