ऑडियो डीपफेक डिटेक्शन: यह कैसे काम करता है और ElevenLabs ऑडियो की पुष्टि कैसे करें
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
ऑडियो डीपफेक डिटेक्शन, वॉइस ऑडियो का विश्लेषण करके यह तय करने की प्रक्रिया है कि स्पीच असली है या नहीं। डीपफेक बनाने वाले AI वॉइस सिंथेसाइज़र लगातार अधिक सुलभ हो रहे हैं। सार्वजनिक जीवन और व्यवसाय, दोनों में यह जल्दी पहचानना महत्वपूर्ण हो गया है कि जो स्पीच आप सुन रहे हैं वह असली है या किसी दुर्भावनापूर्ण व्यक्ति ने उसमें हेरफेर किया है।
इस लेख में हम जानेंगे कि ऑडियो डीपफेक डिटेक्शन कैसे काम करता है, इसके अलग-अलग प्रकार, उनकी खूबियां और कमियां, और आप डीपफेक डिटेक्शन को बड़े पैमाने के फ़्रॉड-डिटेक्शन स्टैक में कैसे शामिल कर सकते हैं।
सारांश
- सिर्फ सुनकर डीपफेक से सिंथेसाइज़ की गई स्पीच पहचानना मुश्किल होता जा रहा है। यह सार्वजनिक जीवन और व्यवसाय, दोनों के लिए बड़ा जोखिम है।
- डीपफेक डिटेक्शन सॉफ़्टवेयर कई प्रकार के होते हैं। पारंपरिक टूल किसी ऑडियो सैंपल के AI-जनरेटेड होने की संभावना का आकलन करने के लिए सांख्यिकीय विश्लेषण इस्तेमाल करते हैं।
- नई वॉटरमार्किंग टेक्नोलॉजी आपको निश्चित रूप से हां या नहीं में जवाब देती है कि किसी वॉइस सैंपल को सिंथेसाइज़ किया गया था या नहीं।
- वॉटरमार्किंग बहुत सटीक है, लेकिन डिटेक्टर सिर्फ किसी प्रदाता के अपने ऑडियो पर काम करते हैं। उदाहरण के लिए, ElevenLabs का ऑडियो डिटेक्टर अपने प्रोडक्ट्स से बने वॉटरमार्क को बहुत सटीकता से पहचान सकता है, लेकिन अन्य कंपनियों के वॉटरमार्क को नहीं।
- जिन संगठनों को बड़े पैमाने पर डीपफेक डिटेक्शन चाहिए, उनके लिए वॉटरमार्किंग एक महत्वपूर्ण संसाधन है, लेकिन यह उनके डीपफेक-डिटेक्शन स्टैक के कई टूल्स में से सिर्फ एक होना चाहिए।
ऑडियो डीपफेक डिटेक्शन क्या है?
ऑडियो डीपफेक डिटेक्शन यह निर्धारित करने की प्रक्रिया है कि वॉइस ऑडियो को आर्टिफ़िशियल इंटेलिजेंस ने जनरेट या मैनिपुलेट किया है या नहीं।
डीपफेक, जनरेटिव AI एप्लिकेशन द्वारा बनाया गया किसी भी प्रकार का मीडिया है—आमतौर पर इमेज, वीडियो या ऑडियो—जिसका उद्देश्य किसी व्यक्ति के कहने या करने के बारे में गलत जानकारी देना होता है। ऑडियो डीपफेक के कई दुर्भावनापूर्ण उपयोग हो सकते हैं। इनका इस्तेमाल फ़्रॉड, निजी अकाउंट्स तक पहुंचने की कोशिश, राजनीतिक प्रोपेगैंडा या घरेलू विवादों में जीवनसाथी या परिवार के सदस्य की चुपके से नकल करने के लिए हो सकता है।
मौजूदा रुझानों के आधार पर, ऑडियो डीपफेक स्कैम के शिकार सबसे अधिक ये लोग हो सकते हैं:
- राजनेता और अन्य सार्वजनिक हस्तियां: जिन लोगों के वॉइस सैंपल ट्रेनिंग के लिए ऑनलाइन बड़ी मात्रा में उपलब्ध हैं, उनकी आवाज़ का विरोधियों या तीसरे पक्ष द्वारा डीपफेक बनाया जा सकता है ताकि जनता को गुमराह किया जा सके।
- परिवार के सदस्य: कोई दुर्भावनापूर्ण व्यक्ति मिली हुई वॉइस रिकॉर्डिंग का इस्तेमाल करके पैसों के डीपफेक अनुरोधों से बुजुर्ग परिवार के सदस्यों को ठगने की कोशिश कर सकता है।
- कॉर्पोरेट अधिकारी: नकली इंटरव्यू, प्रेज़ेंटेशन और अर्निंग्स कॉल का इस्तेमाल किसी कंपनी के ब्रांड को नुकसान पहुंचाने के लिए हो सकता है।
- कस्टमर सर्विस टीमें: स्कैमर इकट्ठा किए गए वॉइस सैंपल का इस्तेमाल करके कस्टमर सर्विस टीमों को निजी अकाउंट की पहुंच देने के लिए ठग सकते हैं।
दुर्भाग्य से, इंसान डीपफेक के भरोसेमंद डिटेक्टर नहीं हैं। नियंत्रित शोध स्थितियों में, उन्हें पहचानने की लोगों की क्षमता संयोग से बेहतर नहीं है, और यह शोध 2024 का है। तब से जनरेटिव मीडिया काफी अधिक परिष्कृत हो गया है।
शिक्षा और कानून समाज को डीपफेक के प्रभाव से बचाने में बहुत मदद करेंगे, लेकिन भरोसेमंद डिटेक्शन तरीके अभी भी जरूरी हैं।
ऑडियो डीपफेक डिटेक्शन कैसे काम करता है?
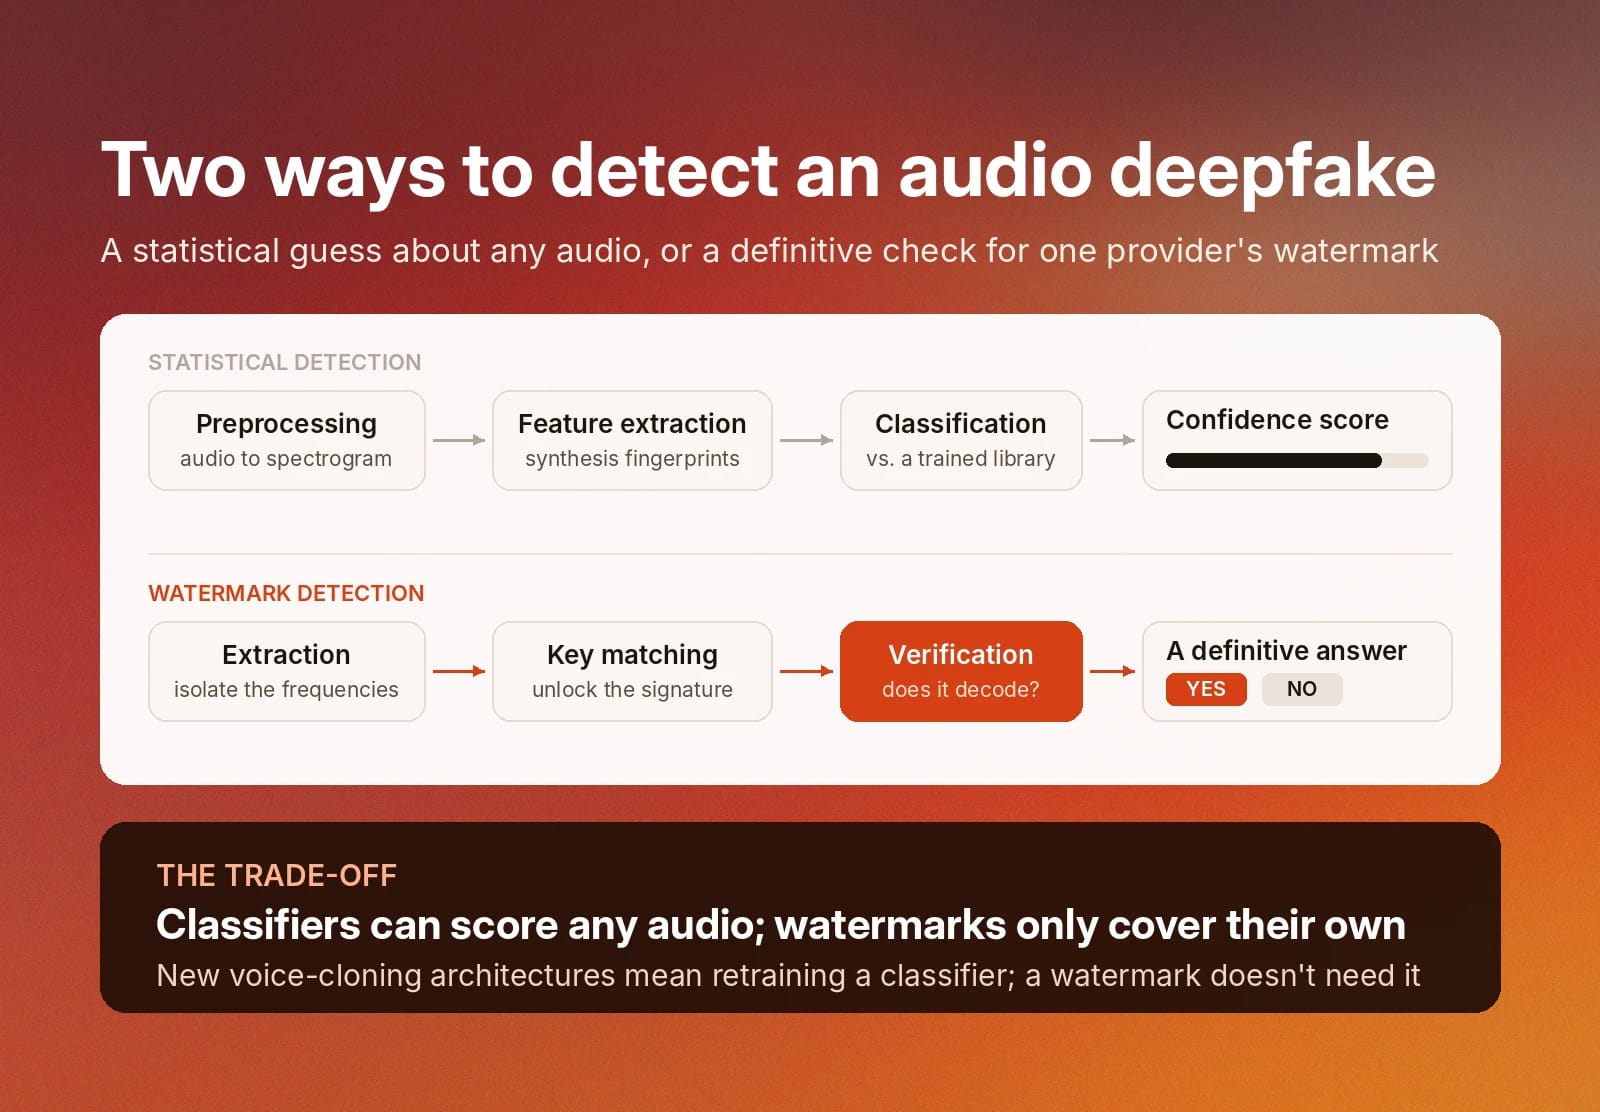
पारंपरिक डीपफेक डिटेक्शन, किसी मीडिया के AI से जनरेट होने की संभावना मापने के लिए सांख्यिकीय विश्लेषण इस्तेमाल करता है। डिटेक्शन टूल अलग-अलग प्रकार की सिंथेसाइज़्ड स्पीच में मौजूद मूल पैटर्न पहचानने के लिए मशीन लर्निंग तकनीकों का इस्तेमाल करता है।
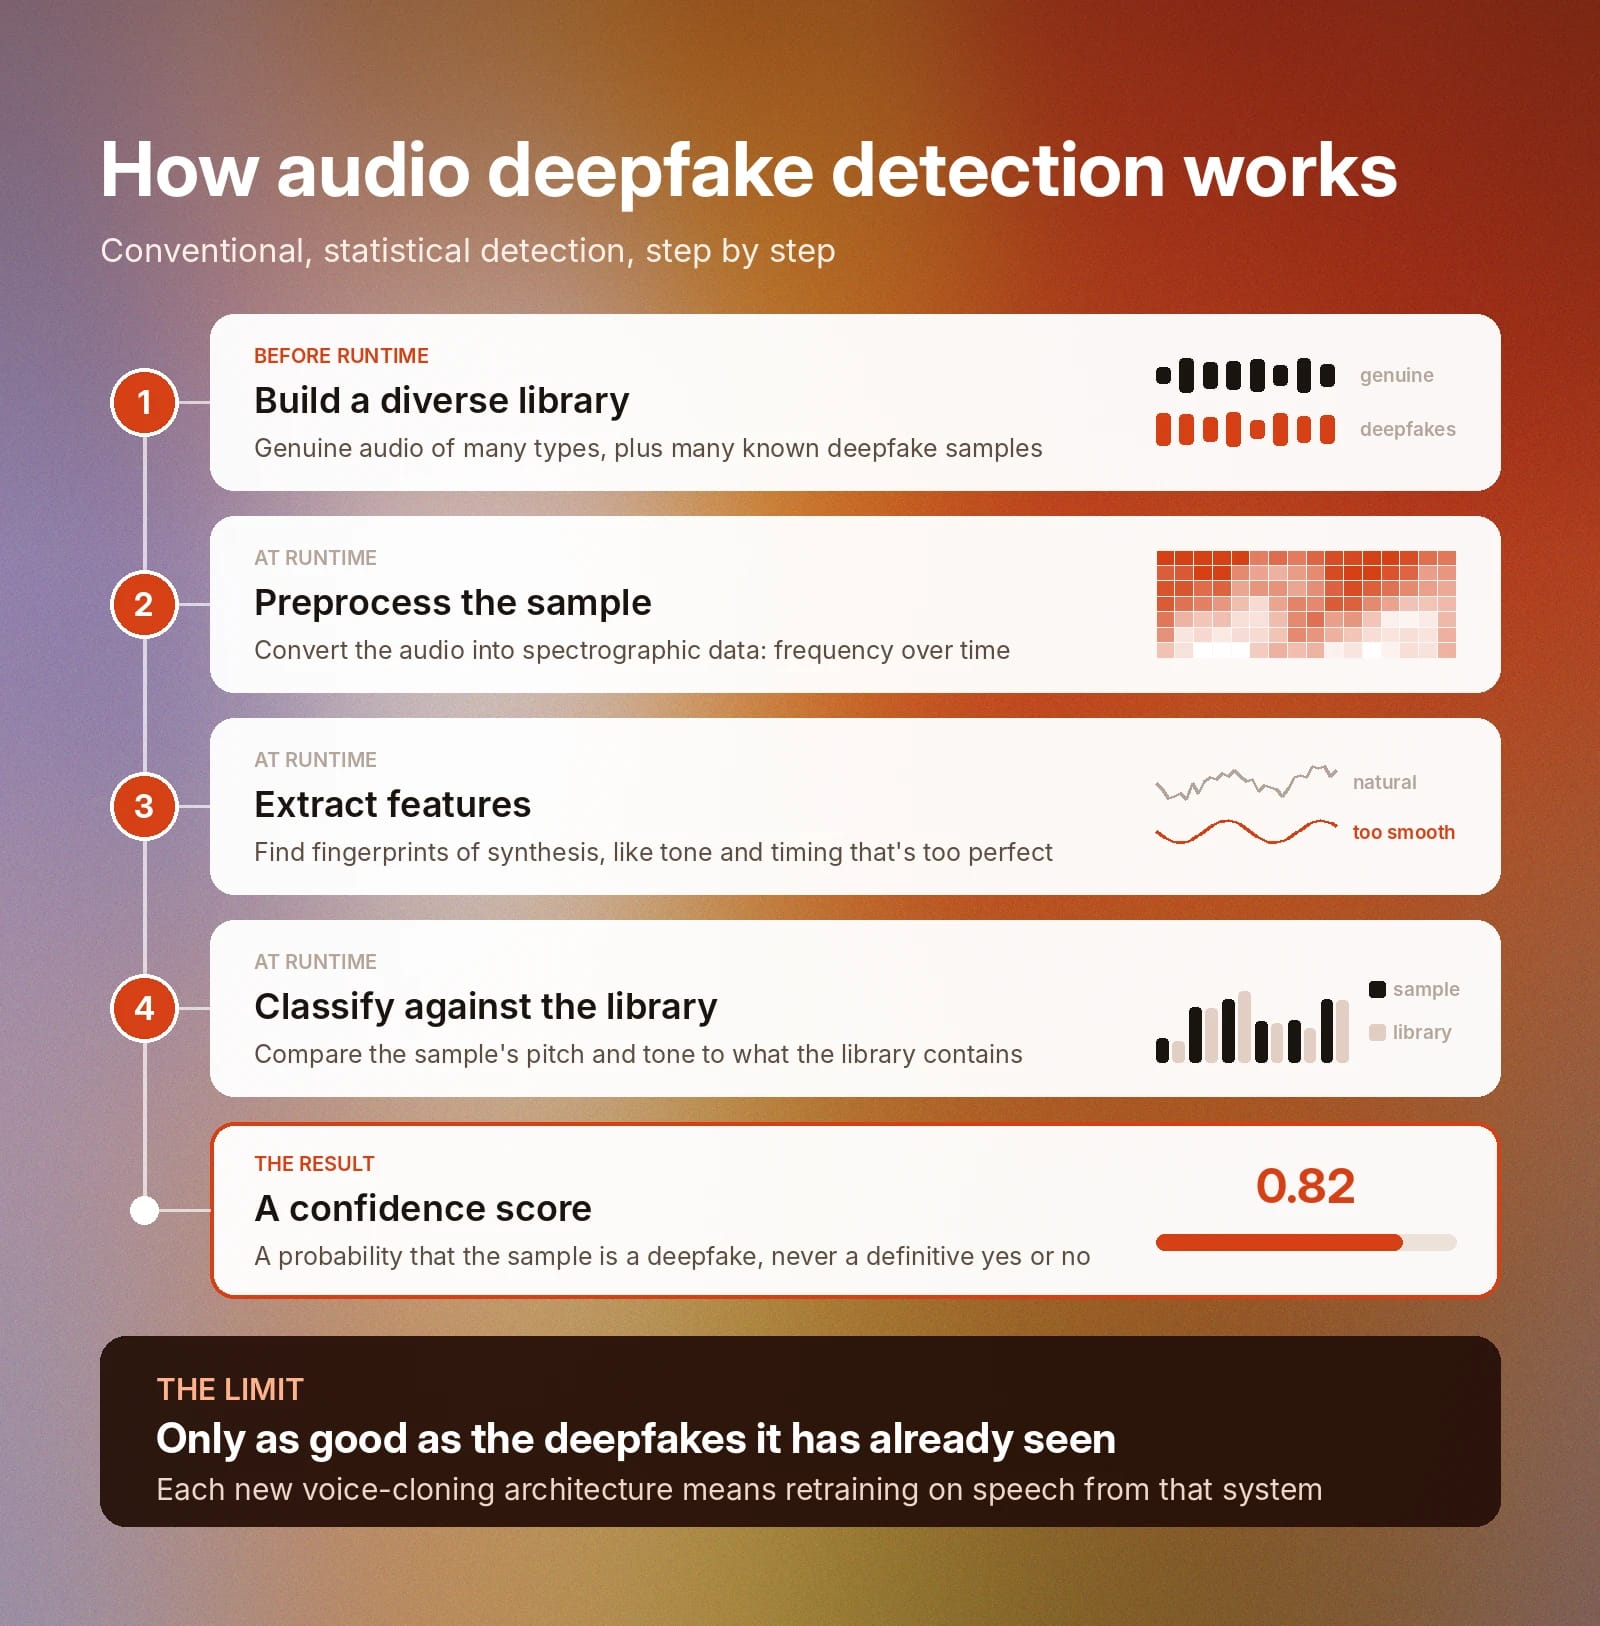
इसका पहला चरण संदिग्ध डीपफेक से तुलना करने के लिए ऑडियो कंटेंट की एक लाइब्रेरी बनाना है। यह विविध डेटा सेट होना चाहिए, जिसमें कई प्रकार के असली ऑडियो सैंपल और पॉज़िटिव डिटेक्शन में मदद के लिए कई ज्ञात डीपफेक सैंपल शामिल हों।
रनटाइम पर, यह तीन चरणों की प्रक्रिया अपनाता है: प्रीप्रोसेसिंग, फीचर एक्सट्रैक्शन और क्लासिफ़िकेशन।
ऑडियो प्रीप्रोसेसिंग
जब आप किसी प्रशिक्षित डिटेक्शन टूल को ऑडियो सैंपल देते हैं, तो वह उसे स्पेक्ट्रोग्राफ़िक डेटा, यानी समय के साथ फ़्रीक्वेंसी में बदलाव के गणितीय रूप में बदल देता है।
फीचर एक्सट्रैक्शन
इसके बाद, डिटेक्शन टूल सैंपल डेटा से ऐसे फीचर निकालता है जो सिंथेसाइज़्ड स्पीच के फिंगरप्रिंट जैसे होते हैं। उदाहरण के लिए, AI स्पीच कभी-कभी जरूरत से ज्यादा परफेक्ट होती है और उसमें प्राकृतिक स्पीच की टोन और टाइमिंग में मिलने वाली अनियमितताएं नहीं होतीं। स्पीकर’ की पिच और टोन की अपनी लाइब्रेरी से तुलना करने पर टूल को अन्य चेतावनी संकेत पहचानने में भी मदद मिलती है।
क्लासिफ़िकेशन
चूंकि पारंपरिक डीपफेक डिटेक्शन सांख्यिकीय विश्लेषण से होता है, इसलिए यह आपको इस सवाल का निश्चित “हां” या “नहीं” जवाब नहीं दे सकता कि कोई सैंपल डीपफेक है या नहीं। इसके बजाय, यह कॉन्फिडेंस स्कोर या संभावना देता है कि सैंपल डीपफेक है।
चूंकि यह किसी सैंपल और मौजूदा ऑडियो लाइब्रेरी के बीच समानताएं मापता है, पारंपरिक टूल उनके पास उपलब्ध ज्ञात डीपफेक सैंपल तक सीमित होते हैं। जब भी कोई नई वॉइस-क्लोनिंग आर्किटेक्चर जारी होती है, उसे सटीकता से पहचानने के लिए आपको अपने डिटेक्शन टूल को उस नए सिस्टम में सिंथेसाइज़ की गई स्पीच पर फिर से ट्रेन करना होगा।
वॉटरमार्किंग और सांख्यिकीय डिटेक्शन में क्या अंतर है?
वॉटरमार्किंग स्पीच क्लासिफ़िकेशन का बिल्कुल अलग तरीका है। मशीन लर्निंग क्लासिफ़ायर अपने ट्रेनिंग डेटा से प्राकृतिक स्पीच के बारे में जो जानता है, उसके आधार पर किसी सैंपल के असली होने का संभावित अनुमान लगाता है। जैसे, स्पेक्ट्रोग्राफ़िक डेटा में असली भावनात्मक भार और ज़ोर कैसा दिखता है, और टोन व टाइमिंग में किस प्रकार के बदलाव प्राकृतिक होते हैं।
वॉटरमार्किंग निर्धारक होती है। वॉटरमार्क एक गणितीय हस्ताक्षर है, जिसे सिंथेसाइज़र ऑडियो डेटा में ऐसे स्तरों पर एम्बेड करता है जिन्हें इंसान सुन नहीं सकता। वॉटरमार्क डिटेक्टर यह सत्यापित करता है कि उसे वह छिपा हुआ हस्ताक्षर मिला है या नहीं।
एक डिटेक्टर तीन सरल चरणों में काम करता है:
- एक्सट्रैक्शन: टूल स्पेक्ट्रोग्राफ़िक डेटा निकालता है और उन फ़्रीक्वेंसी को अलग करता है जहां उसे वॉटरमार्क मिलने की उम्मीद होती है।
- की मैचिंग: यह एक की से हस्ताक्षर को अनलॉक करने की कोशिश करता है।
- वेरिफ़िकेशन: अगर सिग्नल सही तरीके से डिकोड हो जाता है, तो टूल पुष्टि करता है कि संबंधित AI वॉइस जनरेटर ने ऑडियो जनरेट किया है।
ElevenLabs की वॉटरमार्क डिटेक्शन प्रक्रिया
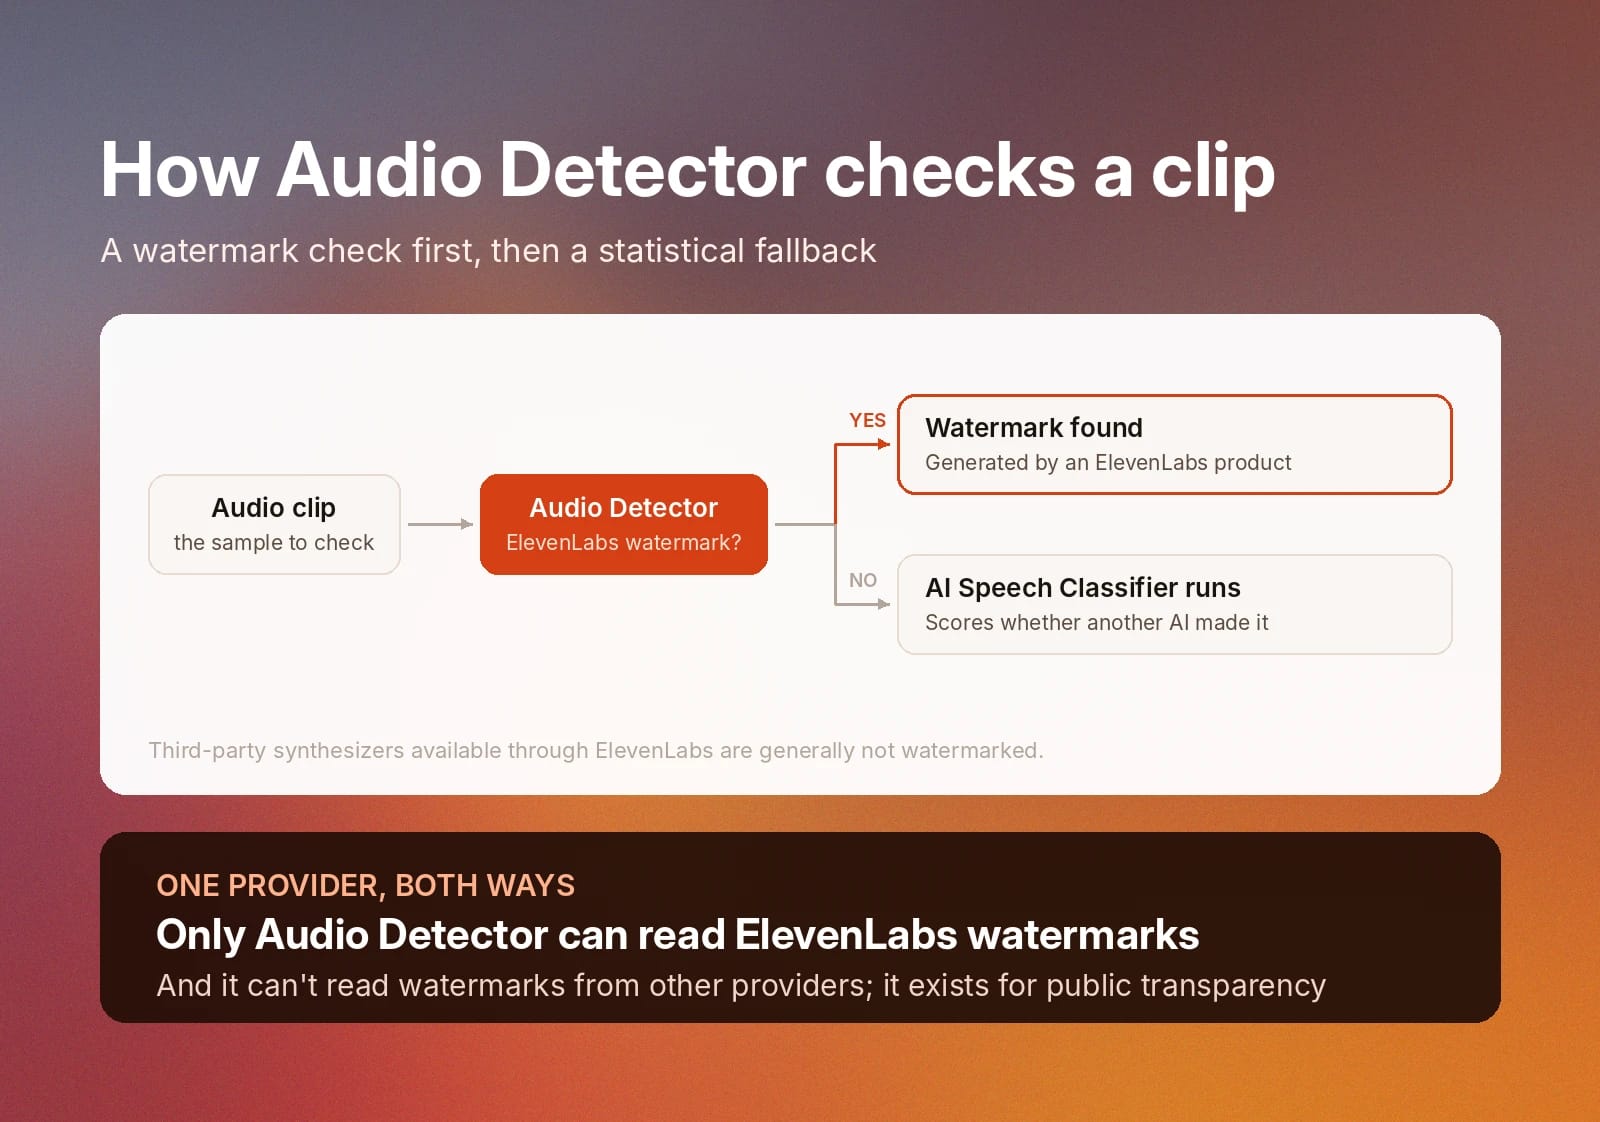
ElevenLabs का वॉटरमार्किंग टूल ऑडियो डिटेक्टर है। यह ऑडियो सैंपल स्कैन करता है और सत्यापित करता है कि कंटेंट ElevenLabs के किसी प्रोडक्ट से जनरेट हुआ है या नहीं। अगर इसे वॉटरमार्क नहीं मिलता, तो यह सांख्यिकीय AI Speech Classifier चलाता है, ताकि आकलन कर सके कि ऑडियो किसी अन्य स्रोत से AI-जनरेटेड है या नहीं।
वॉटरमार्किंग के काम करने के तरीके के कारण, ElevenLabs ऑडियो डिटेक्टर केवल ElevenLabs से जनरेट किया गया ऑडियो पहचानता है। यह फिलहाल अन्य AI वॉइस प्रदाताओं के वॉटरमार्क पहचान नहीं सकता।
इसके विपरीत, केवल ElevenLabs का ऑडियो डिटेक्टर ही ElevenLabs के वॉटरमार्क पहचान सकता है।
यह भी ध्यान रखें कि ElevenLabs के ज़रिए उपलब्ध किसी भी थर्ड-पार्टी सिंथेसाइज़र से जनरेट किया गया कंटेंट आमतौर पर वॉटरमार्क नहीं होता।
ElevenLabs से जनरेट किए गए ऑडियो को पहचानने के अन्य विकल्प
ElevenCreative AI Speech Classifier मुफ़्त में और बिना साइन-इन के उपलब्ध है। यह ऑडियो सैंपल के पहले मिनट का विश्लेषण करेगा और कॉन्फिडेंस स्कोर देगा कि ऑडियो के ElevenLabs मॉडल से जनरेट होने की कितनी संभावना है।
ध्यान दें कि यह Eleven v3 ऑडियो को भरोसेमंद तरीके से क्लासिफ़ाई नहीं कर सकता। यह पुराने ElevenLabs TTS मॉडल से जनरेट किए गए ऑडियो को क्लासिफ़ाई करने में सबसे प्रभावी है। बहुत अधिक कंप्रेस या एडिट किए गए स्पीच कंटेंट का विश्लेषण करने पर इसकी सटीकता भी कम हो जाती है।
आप बड़े पैमाने पर सिंथेटिक वॉइस कैसे पहचान सकते हैं?
कुछ बिज़नेस टीमों को लगभग रियल-टाइम में बड़े पैमाने पर डीपफेक पहचानने की क्षमता चाहिए। एक राष्ट्रीय बैंक’ की कस्टमर सर्विस टीम का उदाहरण लें। उसके प्रतिनिधि हर दिन हजारों ग्राहकों से बातचीत करते हैं। टीम के सदस्यों को नियमित रूप से निजी अकाउंट डेटा साझा और अपडेट करना पड़ता है।
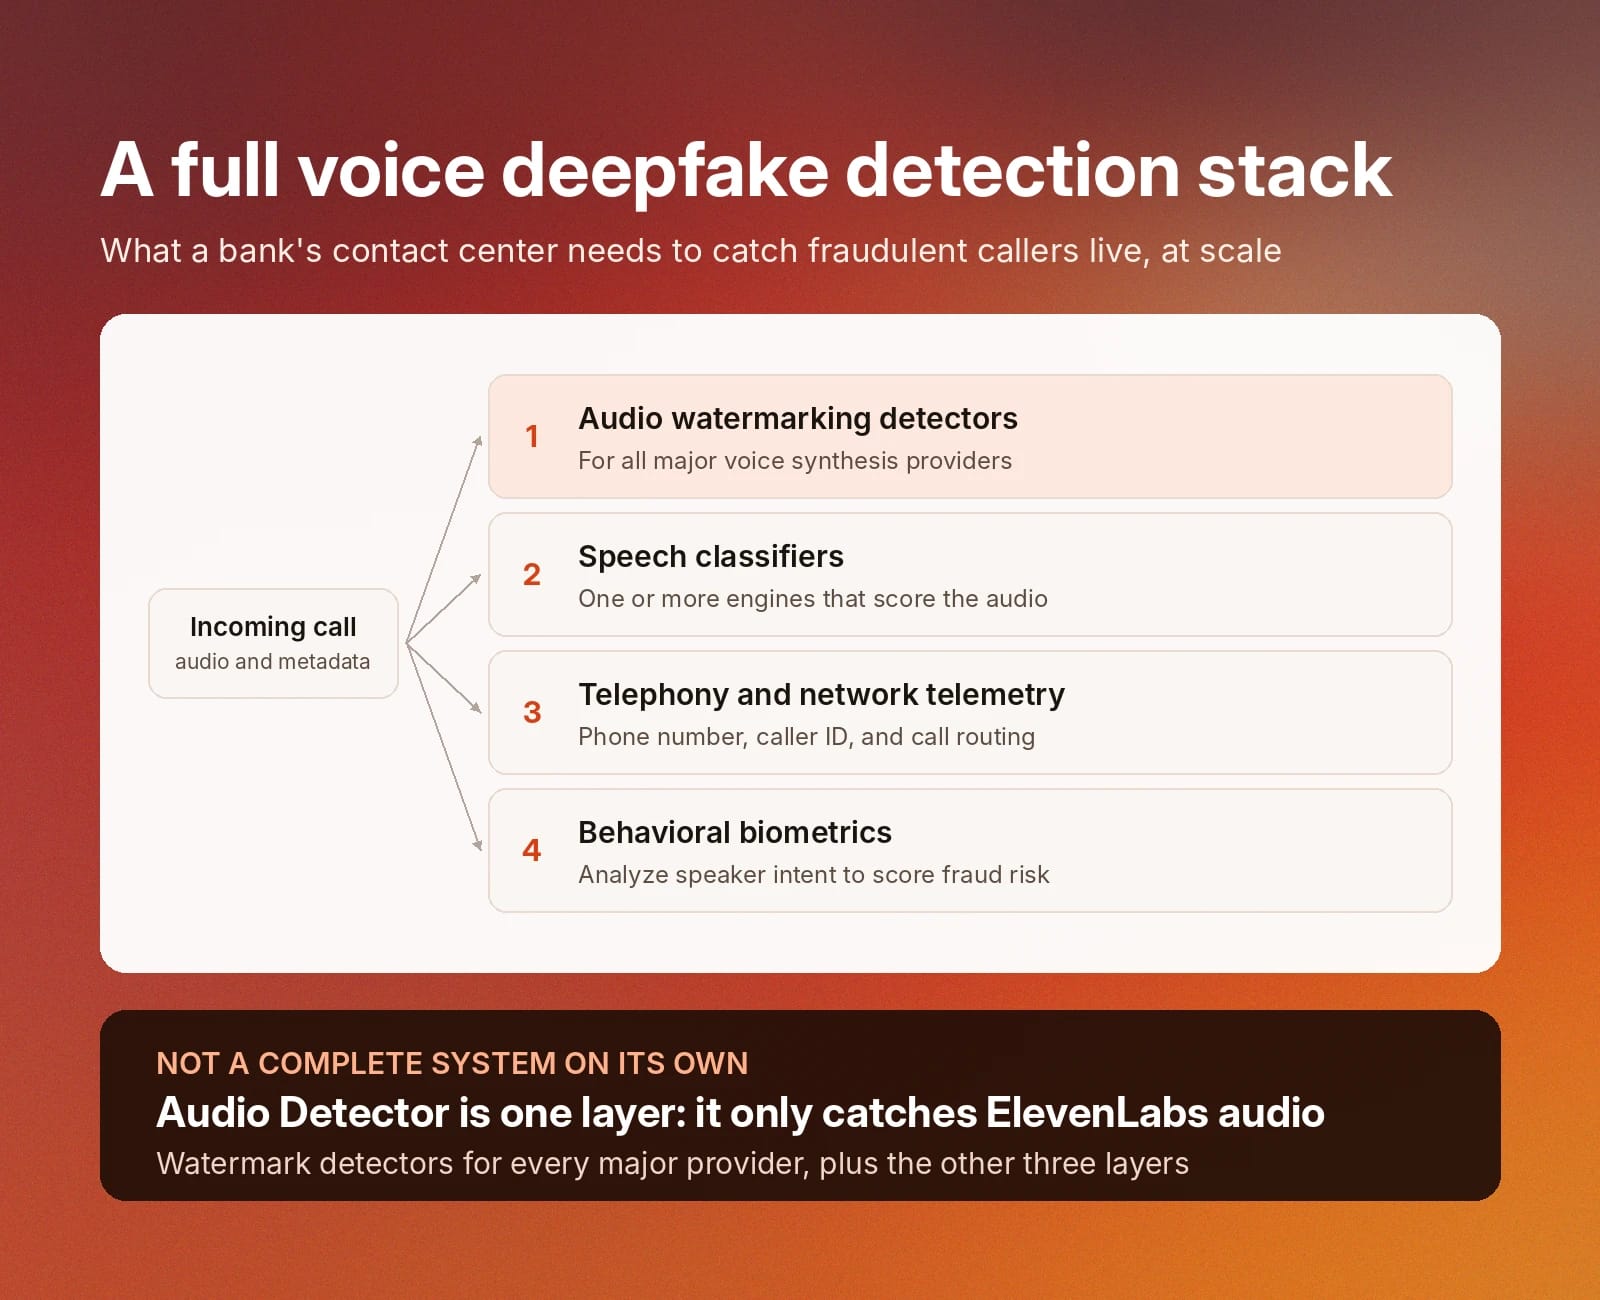
उस टीम के लीडर्स के लिए यह बहुत महत्वपूर्ण है कि वे किसी फ़्रॉड करने वाले कॉलर को कितनी जल्दी पहचान सकते हैं और असली ग्राहकों को कितनी जल्दी जवाब दे सकते हैं। उन्हें ऐसा वॉइस-डिटेक्शन स्टैक चाहिए जो ग्राहक कॉल के दौरान लाइव सभी प्रमुख वॉइस-जनरेशन इंजन के ऑडियो की पहचान कर सके।
पूरा वॉइस-डिटेक्शन स्टैक बनाना
यहां ElevenLabs का ऑडियो डिटेक्टर अहम भूमिका निभाता है, लेकिन फिर से ध्यान देना जरूरी है कि यह सिर्फ ElevenLabs-वॉटरमार्क वाले ऑडियो को पहचानता है। यह अपने आप में पूरा वॉइस-डिटेक्शन सिस्टम नहीं है। जिन संगठनों को पूरी वॉइस-डिटेक्शन क्षमता चाहिए, उन्हें कई अलग-अलग प्रकार के टूल्स तैयार करने होंगे:
- ऑडियो वॉटरमार्किंग डिटेक्टर: सभी प्रमुख वॉइस सिंथेसिस प्रदाताओं के लिए।
- स्पीच क्लासिफ़ायर: एक या अधिक क्लासिफ़िकेशन इंजन, जो ऑडियो डेटा को स्कोर कर सकें।
- टेलीफोनी और नेटवर्क टेलीमेट्री: कॉल मेटाडेटा, जैसे फ़ोन नंबर, कॉलर ID और कॉल रूटिंग के लिए एनालिटिक्स।
- व्यवहार संबंधी बायोमेट्रिक्स: फ़्रॉड के जोखिम का स्कोर करने के लिए स्पीकर के इरादे का विश्लेषण करने वाला सॉफ़्टवेयर।
ElevenLabs डीपफेक डिटेक्शन के साथ शुरुआत करें
ElevenLabs सार्थक वॉइस जनरेशन सेवाओं के जरिए और लोगों को डीपफेक व AI-जनरेटेड ऑडियो के अन्य दुर्भावनापूर्ण उपयोग पहचानने के लिए जरूरी टूल्स देकर, सार्वजनिक जीवन में सकारात्मक योगदान देने के लिए प्रतिबद्ध है।
क्या आपके पास कोई ऑडियो क्लिप है जिसे आप डीपफेक के लिए टेस्ट करना चाहते हैं? ElevenLabs ऑडियो डिटेक्टर आज़माने के लिए साइन अप करें या AI Speech Classifier के साथ आज ही शुरुआत करें।
अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।