
Webinar-sammanfattning: Ge din textchattbot en röst som låter mänsklig
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Chatt-agenter har blivit en självklar del av företags mjukvarustack. De flesta företag har en eller håller på att bygga en. Färre har kommit fram till vad som händer när en användare hellre bara vill prata.
Röst förändrar interaktionen på sätt som spelar roll utöver bekvämlighet. Användare uttrycker frustration, brådska och förvirring genom tonfall på sätt som text helt tar bort. En kund som skriver ”min beställning har inte kommit” och en kund som säger det med hörbar oro skickar olika signaler – och agenten som bara kan läsa transkriberingen arbetar bara med halva informationen.
Frågan som de flesta team nu ställer är inte om de ska lägga till röst, utan hur de gör det utan att bygga om allt som redan fungerar.
I Live Workshop: Give Your Text Chatbot a Voice That Sounds Human, gick Paul Asjes (Developer Experience), Bhargavi Bhatt (Customer Experience) och Fergal Burnett (Product Marketing, ElevenAPI) igenom de tekniska realiteterna i att lägga till röst i en befintlig agent och hur en fungerande integration faktiskt ser ut.
Varför det är svårare än det verkar att bygga med röst
En av de stora utmaningarna är turtagning. Människor vet när någon har pratat klart tack vare intonation, rytm och sammanhang. Däremot upptäcker röstaktivitetsdetektering (standardmetoden) bara tystnad.
Resultatet blir ofta ett system som tolkar varje paus som en inbjudan att prata: ett som avbryter, klipper av mitt i en tanke och reagerar på naturliga tveksamheter som om de vore avslutade meningar.
Det fungerar tekniskt, men samtalet fungerar inte.
Kontext är den andra halvan av problemet. Att skicka konversationshistoriken till en LLM vid varje tur är nödvändigt, men inte tillräckligt. Samma ord får olika betydelse beroende på hur de sägs – ”jag mår bra” sagt med lättnad och ”jag mår bra” sagt med frustration ger samma transkribering, men en annan interaktion. Ett röstsystem som ignorerar den dimensionen kommer alltid att låta lite fel, oavsett hur starka de enskilda modellerna är.
Det finns också tekniskt underhåll. Team som ansvarar för sin egen röstorkestrering behöver löpande underhålla logik för turtagning, hantering av avbrott och analys av latens. Det är inte något man bygger en gång.
Så lägger du till röst i en befintlig agent
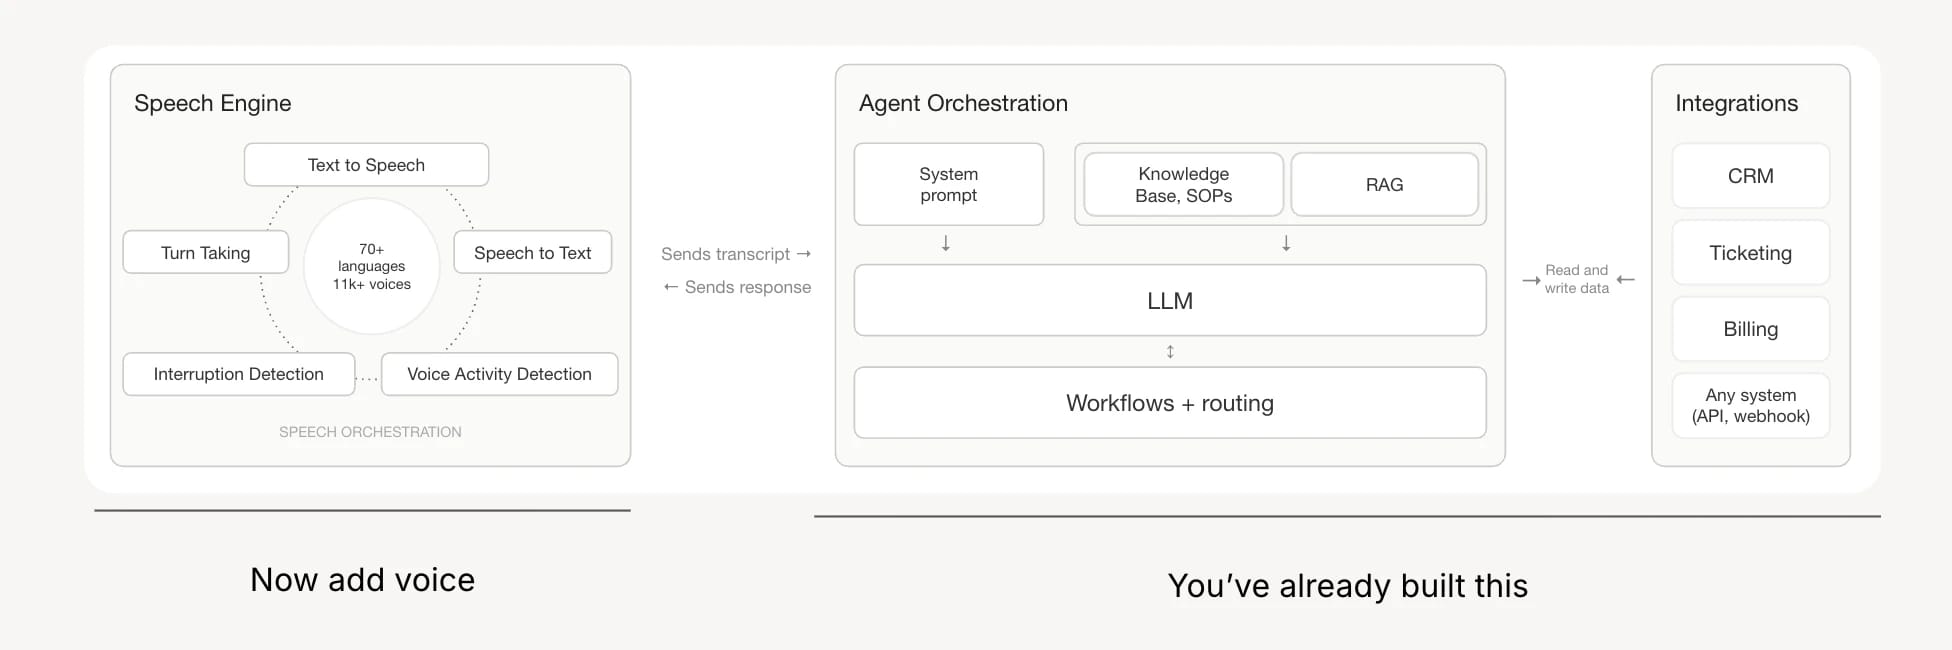
Det smidigaste sättet är en dubbel WebSocket-arkitektur.
- En anslutning går mellan klienten och ElevenLabs API, och en annan mellan din server och ElevenLabs API
- Användaren pratar i mikrofonen, ljudet skickas till ElevenLabs API där det transkriberas och skickas till din server
- Din server skickar hela konversationshistoriken som den får från ElevenLabs API till LLM:en, och det strömmade svaret skickas tillbaka för ljudsyntes
- Detta kan börja innan LLM:en har genererat klart – vilket håller latensen till första byten låg
Den viktigaste integrationspunkten är metoden onTranscript , som körs i slutet av varje tur och skickar hela konversationshistoriken till LLM:en.
En contextualUpdate när sessionen startar tar med allt som hände i konversationens textdel innan användaren bytte till röst – vilket gör att en och samma agent kan fungera i båda modaliteterna utan att förlora kontext.
Några saker att tänka på när du bygger:
- Valet av LLM spelar större roll för röst än för chatt. Modeller för djupgående resonemang skapar pauser som låter som onaturlig tvekan i ljudet, även om svarskvaliteten är högre. För röst i realtid vinner snabbare modeller nästan alltid när det gäller upplevd kvalitet.
- Välj WebRTC framför WebSockets för ljud. WebRTC har inbyggd eko- och brusreducering, vilket är särskilt viktigt på mobilen eller i bullriga miljöer. Om du använder WebSockets för ljudöverföring behöver du hantera det själv.
- Be inte användare att välja språk. Det bryter samtalsflödet. Ett bättre mönster är att identifiera språket utifrån de första sekunderna av tal och låsa det – samtidigt som användaren kan byta språk smidigt utan att behöva göra något.
- Håll modellen för turtagning separat från LLM:en. Att låta LLM:en avgöra när en användare har pratat klart ökar latensen och kostnaden vid varje tur. En särskild modell för turtagning hanterar detta snabbare och mer träffsäkert, och den bör behandlas som en separat komponent i arkitekturen.
Hur mycket infrastruktur du ska äga
Rätt svar beror på vad som redan finns. Om du har en fungerande chattagent är det oftast snabbast och minst riskfyllt att lägga ett röstlager ovanpå den, utan att ändra din LLM, orkestrering eller affärslogik.
Du bygger inte om något. Du lägger till ett ljudgränssnitt till något som redan fungerar.
Om kraven omfattar telefoni, hantering av driftsättningskanaler, inbyggd testning och analys är det rimligt att låta en plattform för röstagenter hantera en större del av stacken. De två tillvägagångssätten utesluter inte varandra – team kan börja med ett enkelt röstlager och lägga till plattformsfunktioner i takt med att användningsfallet mognar.
Demo: Lägg till röst i en befintlig chattbot
Den här demon följer en användare som är mitt i en konversation med en textbaserad chattbot för reseplanering och ber om rekommendationer på områden och mat inför en resa till Japan.
Det här gick vi igenom:
- Chattboten utökades med ett röstlager utan några ändringar av den underliggande agenten.
- Användaren bytte från att skriva till att prata mitt i konversationen – agenten behöll hela kontexten i båda modaliteterna.
- Användaren pratade nederländska och agenten upptäckte språkbytet automatiskt
- När agenten avbröts och ombads att byta tillbaka till engelska mitt i en mening gjorde den det – och avslutade svaret med en lätt nederländsk accent, utan att bli ombedd.
- Under hela konversationen gjorde avbrottsdetekteringen det möjligt för användaren att naturligt prata över agenten utan att den avslutade sin tur.
Varför det spelar roll:
Demon visade inte en specialbyggd röstagent. Den visade en textagent som redan fungerade, med ett röstlager lagt ovanpå. Kontext-, språk- och avbrottshanteringen kom alla från röstlagret – den underliggande textagenten var oförändrad.
Se hela sessionen
Se hela webbinariet här.
Paul jobbar i Developer Growth-teamet på ElevenLabs i Valencia, Spanien. Han är Developer Experience Engineer och fokuserar på att förbättra upplevelsen och verktygen för plattformen. Innan ElevenLabs ansvarade han för Developer Relations på Stripe, jobbade med DX på WorkOS och har flera års erfarenhet av att bygga fullstack-webbappar och verktyg för utvecklare.



