SSML-taggar förklarade: Så styr du pauser, uttal och tempo i text till tal
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Speech Synthesis Markup Language (SSML) är ett XML-baserat märkspråk som omsluter text med taggar för att berätta för en text till tal-modell hur den ska tala den, bland annat var den ska pausa, hur ett ord ska uttalas och vilken fras som ska betonas.
Det här kontrollagret ligger bakom mycket av AI-talet du redan hör. Ett interaktivt röstsvarssystem (IVR) som läser upp ett bekräftelsenummer och en AI-ljudboksberättare som pausar i slutet av ett kapitel bygger båda på någon variant av det. Om du har ägnat tid åt att anpassa AI-genererat tal har du förmodligen stött på SSML.
SSML har varit en del av TTS-tekniken i över två decennier och är fortfarande en viktig del av hur många leverantörer erbjuder TTS. Den här guiden förklarar vad SSML är och exakt var det används i ElevenLabs modellutbud, tillsammans med det förbättrade Audio Tag-systemet som Eleven v3 och Eleven v4 använder för text till tal med ledande naturligt ljud.
Se Eleven v4 i praktiken med Audio Tags
Upptäck Eleven v4Sammanfattning
- SSML är ett märkspråk med rötter i W3C som används för att styra röstpauser, betoning, uttal och tempo i syntetiserat tal.
- ElevenLabs modeller, förutom Eleven v3 och Eleven v4, har stöd för SSML-taggen <break> för pauser på upp till 3 sekunder.
- Eleven Flash v2 och Eleven Turbo v2 har stöd för taggen <fonem> för anpassat engelskt uttal.
- Eleven v3 och Eleven v4 har inget stöd för SSML alls. I stället använder de Audio Tags för instruktioner inom hakparenteser på naturligt språk, som [whispering] och [sighs], för att styra flödet i syntetiserat tal.
- WebSocket API styr SSML-tolkning med parametern enable_ssml_parsing och skickar SSML-taggar som kompletta meddelanden för att undvika extra fördröjning.
- Taggar som <prosody>, <say-as>, <sub>, <lang>, <voice> och <audio> stöds inte av ElevenLabs modeller, men alla har en motsvarighet: röstinställningar, textnormalisering, uttalslexikon, flerspråkiga modeller, separata röster och ljudeffekter.
Vad är SSML?
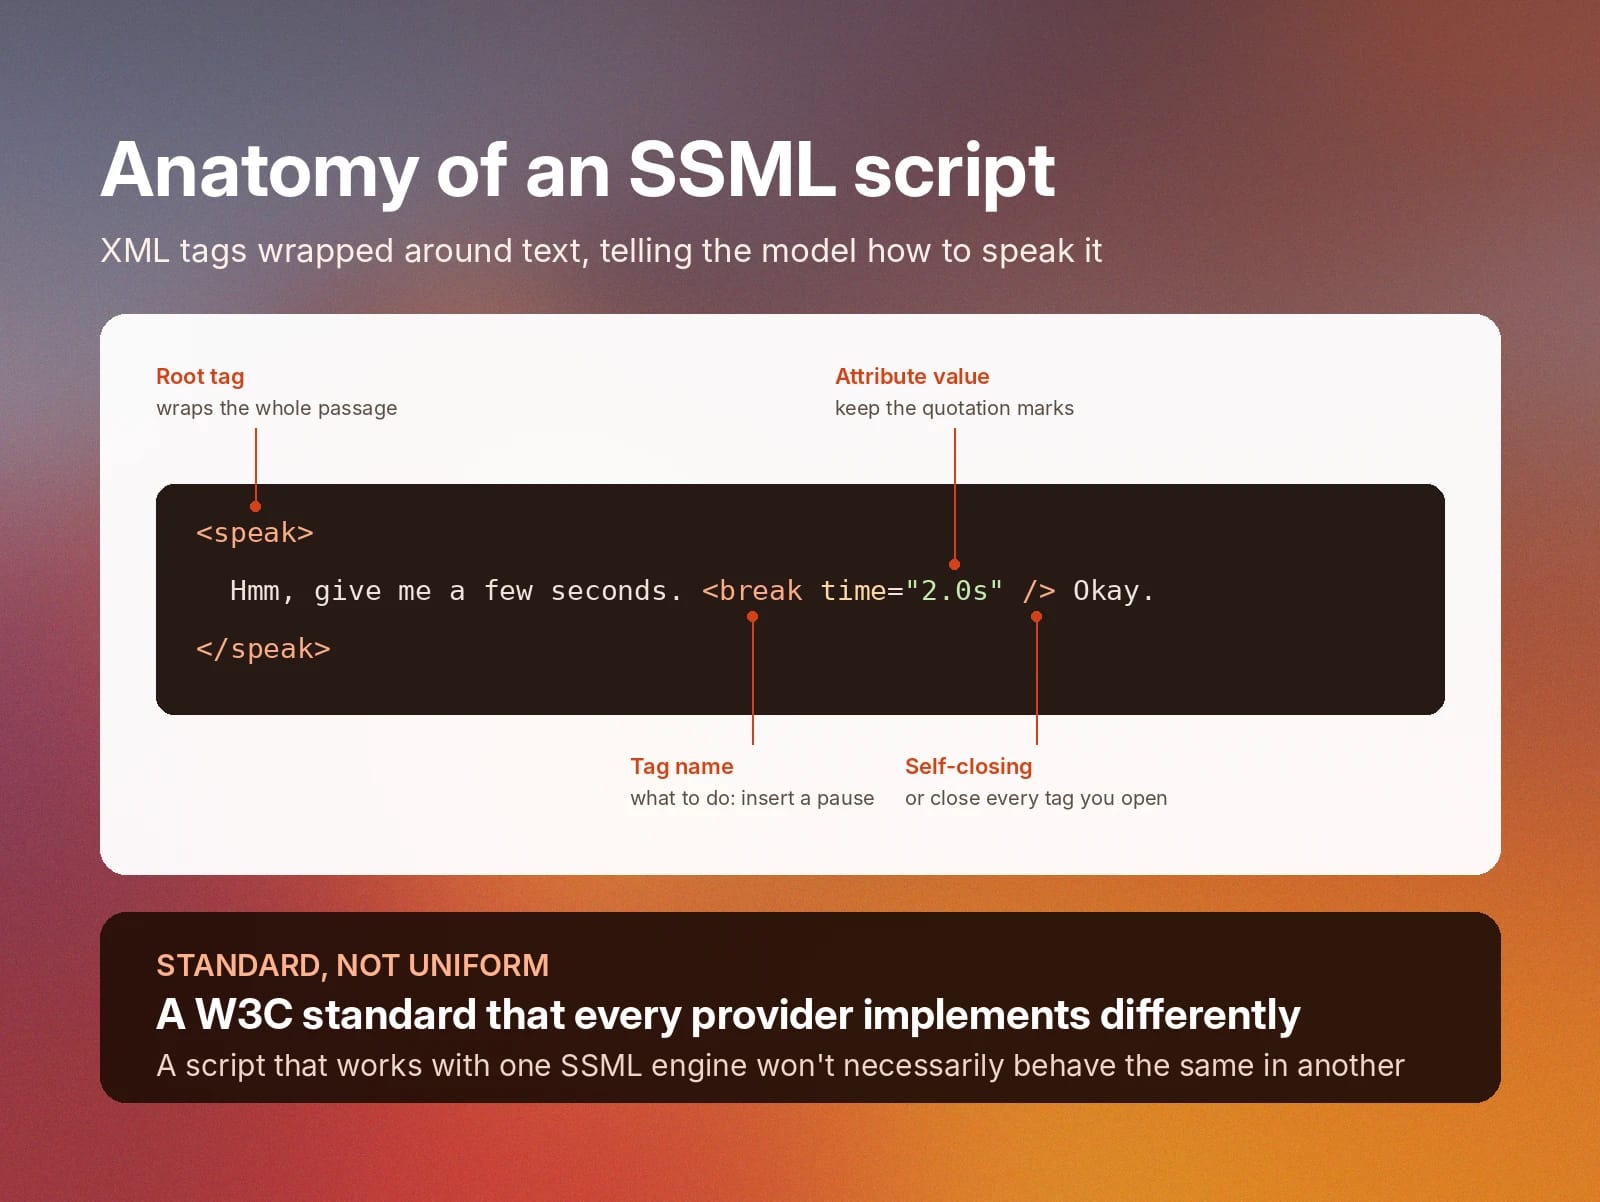
SSML är ett märkspråk som låter dig kommentera skriven text med instruktioner om hur en talsyntesmotor ska uttala den. World Wide Web Consortium (W3C) utvecklade det som en standard för att gå längre än vanliga text till tal-modeller. SSML ger uttryckliga, maskinläsbara anvisningar för hur ett stycke ska uttalas, i stället för att förlita sig på modeller som tolkar vanlig text.
SSML är inte ett unikt märkspråk som är begränsat till en enskild leverantör. Amazon Polly och Microsoft Azure Speech använder båda SSML-taggar, som <break> och <emphasis>, som sin främsta kontrollmekanism. De flesta molnplattformar för text till tal accepterar någon version av standarden. SSML har varit standardsättet att annotera tal långt innan generativa röstmodeller fanns.
SSML är fortfarande en grundläggande standard, medan nyare modellspecifika kontroller utvecklas parallellt med modern generativ röstteknik. Den leverantörsoberoende specifikationen bakom SSML låter leverantörer implementera gemensamma grundtaggar. Leverantörerna kan sedan lägga till egna utökningar och begränsningar ovanpå dessa grundtaggar.
Vanliga SSML-taggar för bättre intonation och vad de gör
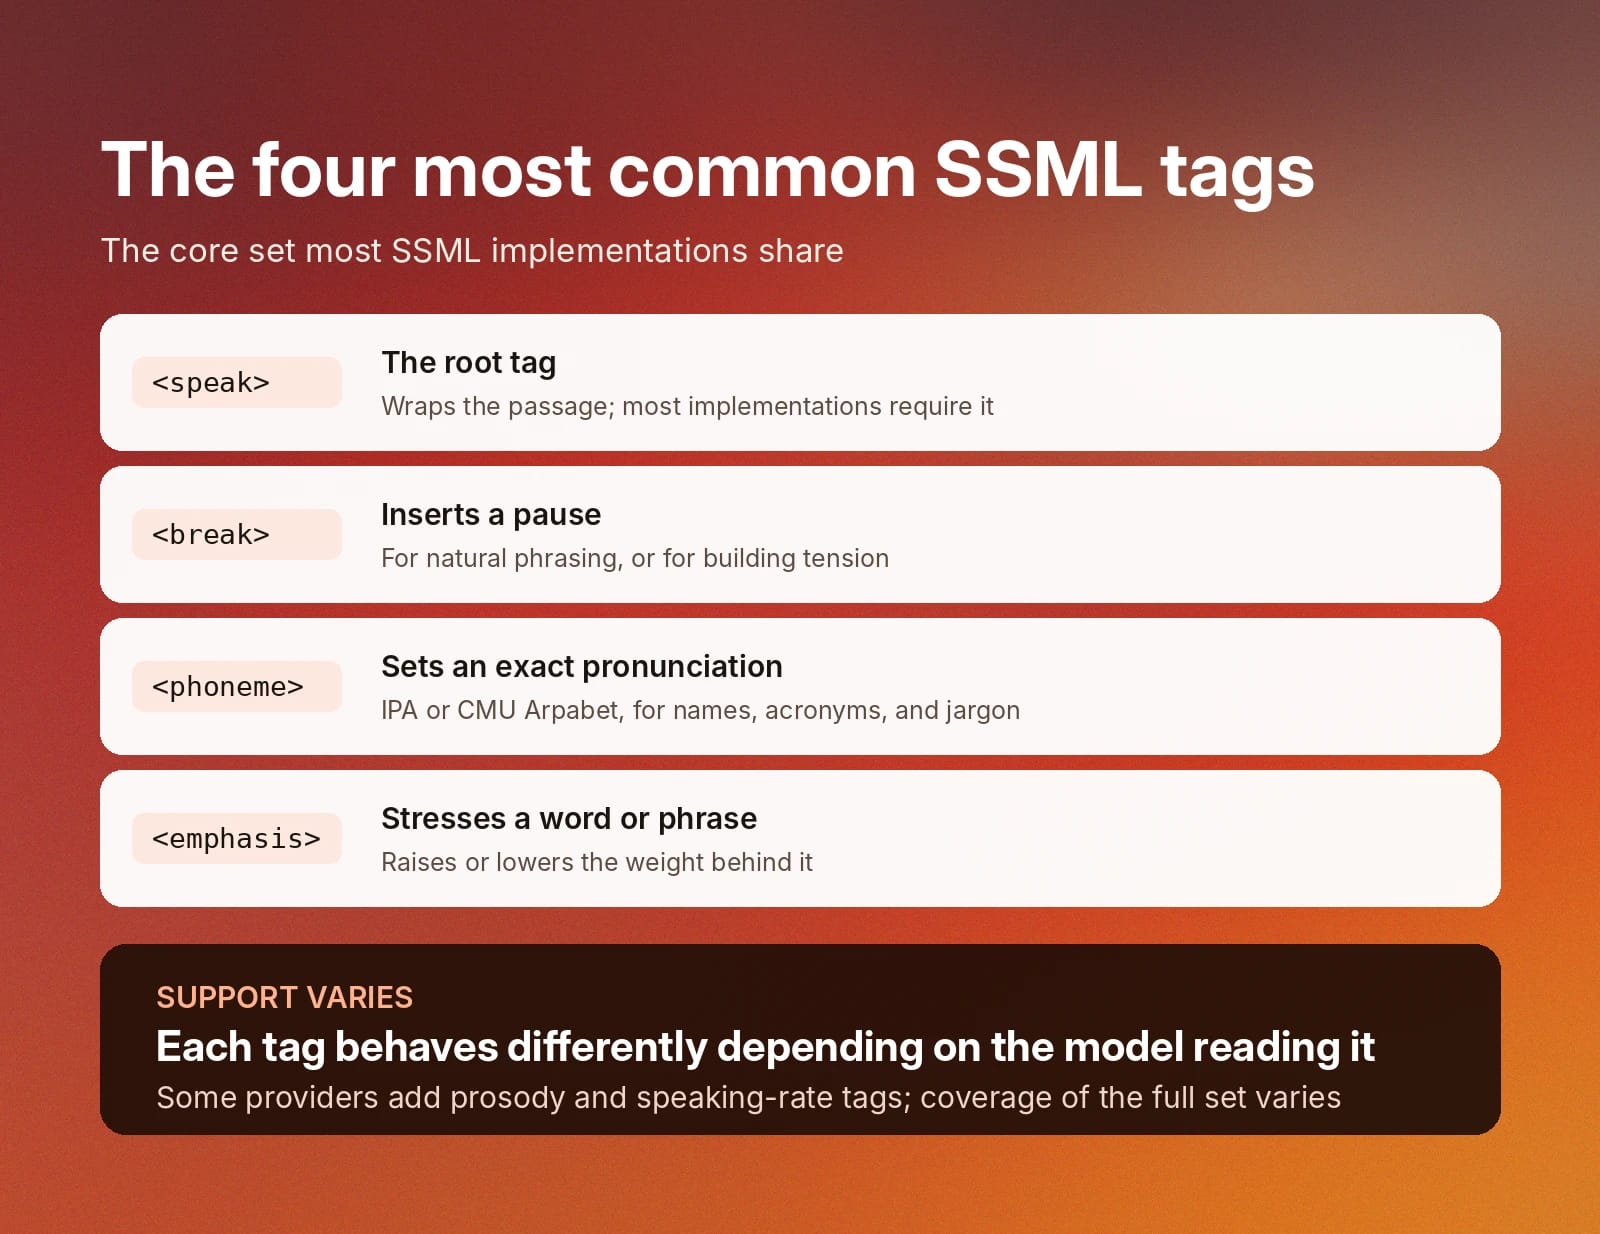
SSML-implementationer har en gemensam uppsättning grundtaggar som de flesta letar efter när de vill styra syntetiserat tal.
Dessa vanliga SSML-taggar är:
- <speak>: Rottaggen som omsluter hela textstycket. De flesta implementationer kräver den för att känna igen det inneslutna innehållet som SSML.
- <break>: Infogar en paus med en angiven längd. Det är användbart för naturlig formulering mellan satser eller meningar, eller för att bygga upp spänning i en text.
- <phoneme>: Anger exakt uttal av ett ord med ett fonetiskt alfabet som IPA eller CMU Arpabet, vilket är användbart för förkortningar, namn eller tekniska termer.
- <emphasis>: Betonar ett ord eller en fras och efterliknar hur en talare naturligt skulle höja eller sänka betydelsen bakom den.
Var och en av dessa fyra taggar fungerar olika beroende på TTS-modellen som läser den. Vissa leverantörer stöder ytterligare taggar för prosodi eller talhastighet. Ett manus som skrivits för en TTS-leverantör kommer inte att fungera på samma sätt hos en annan, även om båda påstår sig ha stöd för SSML, eftersom stödet för hela tagguppsättningen varierar.
Det som varierar mest är vilka taggar en viss text till tal-modell faktiskt bearbetar, och det är här ElevenLabs implementation blir specifik.
Använda SSML med ElevenLabs
SSML-stödet hos ElevenLabs är inte helt enhetligt. Det beror på vilken modell du väljer för att generera ljudet. Taggen <break> är det mest brett stödda elementet och <phoneme> är tillgänglig för en mindre uppsättning modeller.
Äldre TTS-modeller från ElevenLabs, som Multilingual v2, stöder taggen <break> för pauser på upp till tre sekunder. Till exempel kan en AI-agent säga ”Vänta, låt mig tänka”, och sedan använda <break time="2.0s" /> för att skapa en hörbar paus innan den fortsätter med ”Okej, jag vet hur jag kan hjälpa.” Det är den vanligaste taggen i många workflow, eftersom den bidrar till att simulera en mer naturlig samtalsstil.
När du använder SSML-taggar är det bäst att hålla dig till ett fåtal åt gången. Många taggar i samma mening eller stycke kan göra att en modell oväntat ändrar hastighet eller får olika ljudartefakter. Olika röster hanterar också pauser olika, särskilt röster som tränats på exempel med utfyllnadsord som ”eh” eller ”öh”.
SSML i praktiken med ElevenLabs
ElevenLabs modeller Flash v2 och Turbo v2 går ett steg längre och stöder även taggen <phoneme> för anpassade uttal, men endast på engelska. Det gör phoneme-taggen användbar för att korrigera hur en modell uttalar ett namn, en förkortning, en teknisk term eller annan affärsrelaterad formulering. Detta gäller så länge manuset körs på någon av dessa två modeller.
Eleven v3 och Eleven v4 avviker däremot helt från detta mönster. De använder Audio Tags för att styra framförandet. Eleven v4 introducerar dessutom inbyggt stöd för IPA direkt i texten, vilket gör att IPA-symboler inom snedstreck kan läsas direkt i din text. Nedan går vi igenom vad som ersätter break-taggen och andra kontroller för framförande.
För en fullständig genomgång av ElevenLabs kontroller för text till tal, inklusive uttalslexikon och textnormalisering, se guiden med bästa praxis.
SSML-kոդexempel med ElevenLabs
Exemplen nedan visar SSML i ett manus och i ett API-anrop. Kom ihåg att <break> fungerar på alla modeller utom Eleven v4 och Eleven v3, och att <phoneme> bara fungerar på Flash v2 och Turbo v2 (endast engelska).
Implementera SSML för röststyrning och lägga till en paus
Omslut texten och taggen i ett <speak>-block och behåll citattecknen runt attributvärdet:
Läs mer om pauser och SSML phoneme-taggar via ElevenAPI.
Korrigera ett uttal med <phoneme>
Använd IPA eller CMU Arpabet för att ange exakt hur ett ord ska låta. Här vägleds namnet ”Siobhan” med IPA, medan ”Madison” anges med CMU Arpabet:
Generera tal med SSML i Python
Det här anropet skickar ett manus som innehåller en break-tagg till en modell som stöder den:
Generera tal med SSML i JavaScript
Nedan finns ett liknande exempel på att generera tal med SSML, men skrivet i JavaScript.
SSML och WebSocket API: Använd SSML med TTS API:er
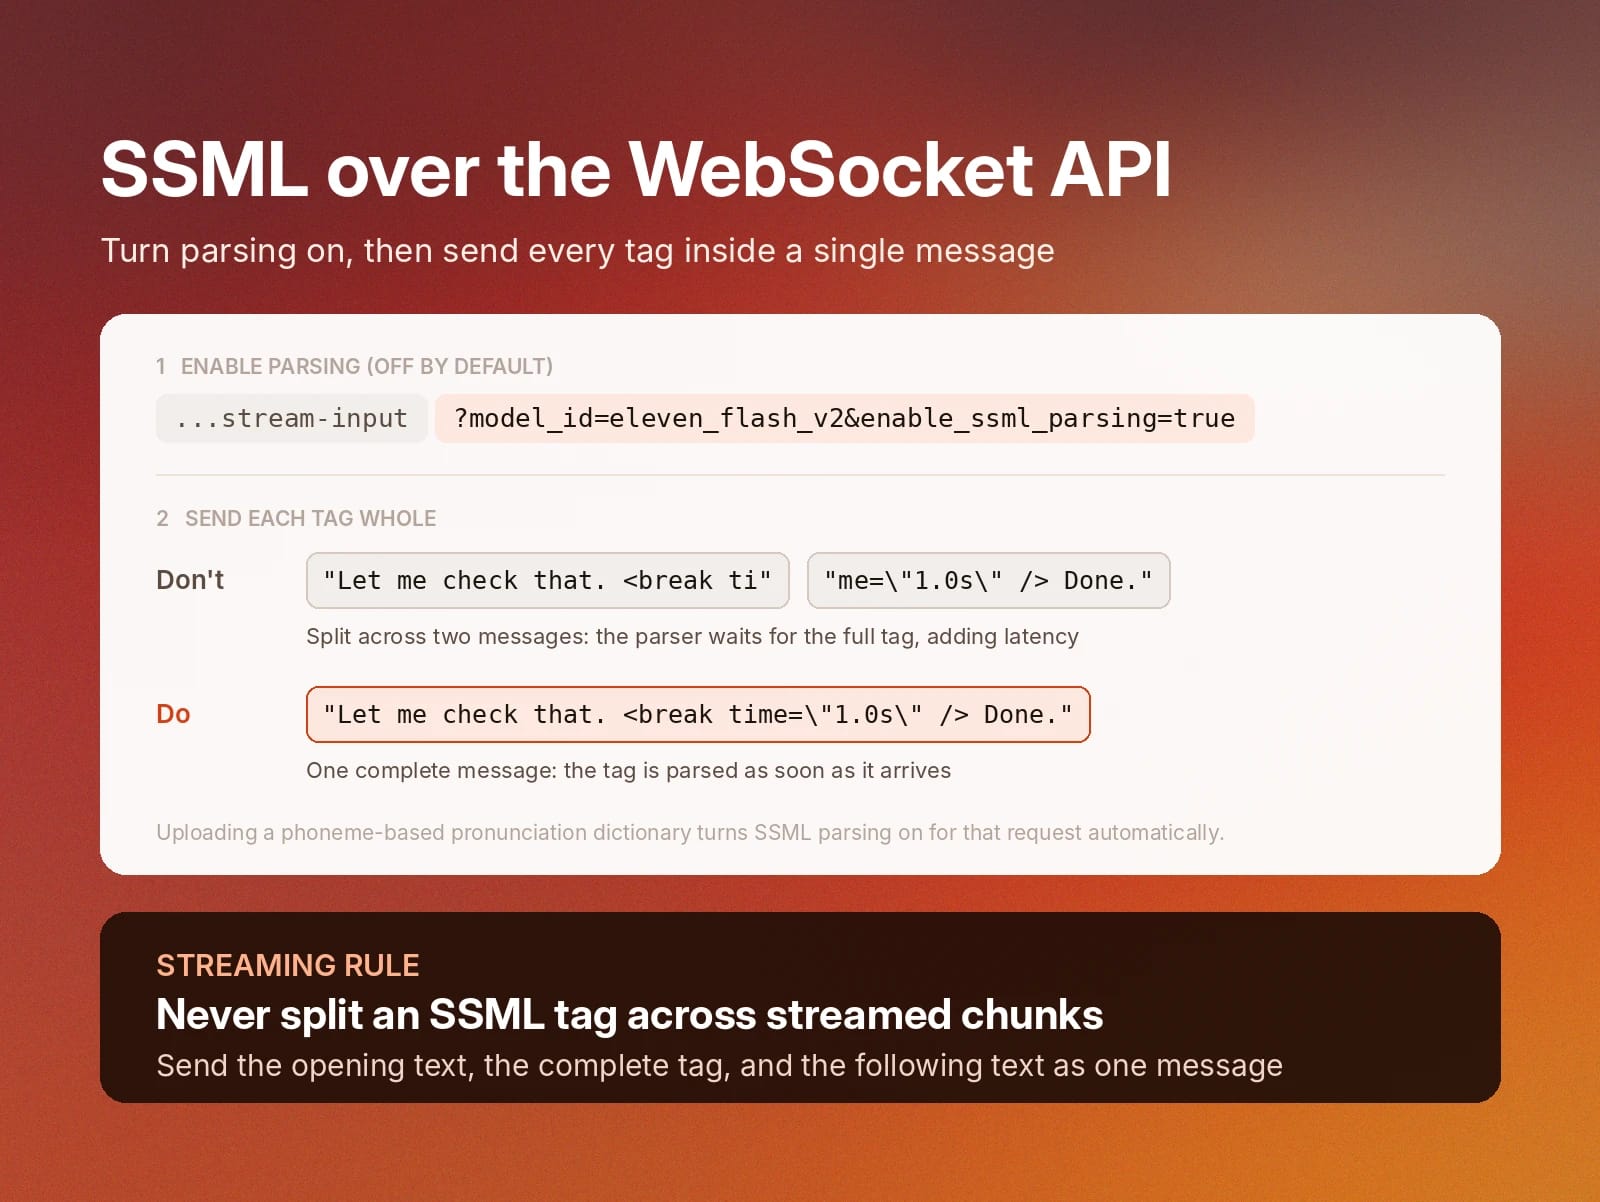
Att strömma ljud via ElevenLabs WebSocket API i stället för en vanlig HTTP-begäran kräver att du uttryckligen aktiverar SSML-tolkning. Den är avstängd som standard och kan styras med parametern enable_ssml_parsing.
För bästa resultat rekommenderar vi att du skickar varje SSML-tagg som ett helt fristående meddelande i stället för att dela upp den i flera strömmade delar. Att dela en tagg mitt i ett meddelande ökar fördröjningen, eftersom parsern behöver hela taggen innan den kan agera på den.
Att ladda upp en fonembaserad uttalslexikon aktiverar automatiskt SSML-tolkning för begäran, även om parametern enable_ssml_parsing inte har angetts specifikt. Fullständig information om parametrar och meddelandeformatering för WebSocket API finns i den här dokumentationsguiden om att generera ljud i realtid.
Exemplet nedan aktiverar SSML-tolkning i anslutnings-URL:en och skickar hela break-taggen i ett enda meddelande:
SSML-taggar som ElevenLabs inte stöder och vad du kan använda i stället
Genom att gå över till Audio Tags-systemet ger ElevenLabs Text to Speech-modeller användare större flexibilitet och mer detaljerad kontroll över sina ljudresultat. Audio Tags skrivs dessutom helt på naturligt språk, vilket gör dem mycket enkla att lägga in i dina manus.
Om du arbetar med en äldre ElevenLabs-modell kan det vara bra att veta vilka SSML-taggar som stöds. Tack vare flera föredragna alternativ bearbetar äldre ElevenLabs-modeller nu bara <break> och <phoneme>, medan övriga SSML-taggar täcks av andra metoder.
Andra SSML-taggar som du kanske känner till från W3C-specifikationen läses inte som märkspråk, så var och en kräver en annan metod. Här är vad du kan ersätta andra SSML-taggar med i ElevenLabs:
SSML-tagg
Funktion
Använd i stället
<prosody>
Ställer in tonhöjd, talhastighet och volym
Röstinställningarna för hastighet och stabilitet. På Eleven v3 och Eleven v4: Audio Tags för framförande som [slowly] eller [rushed]
<emphasis>
Betonar ett ord eller en fras
Versaler eller skiljetecken för betoning. På Eleven v3 och Eleven v4: taggar som [shouts]
<say-as>
Styr hur siffror, datum och förkortningar läses upp
Textnormalisering, att skriva ut värdet med ord eller en regel i ett uttalslexikon
<sub>
Ersätter den talade formen av ett skrivet ord
En aliasregel i ett uttalslexikon
<lang>
Byter språk för en fras
En flerspråkig modell, med frasen skriven på målspråket
<voice>
Byter talare mitt i manuset
En separat generering per röst eller dialog med flera talare på Eleven v3 och Eleven v4
<audio>
Infogar en inspelad ljudfil eller ett ljud
Audio Tags för ljudeffekter på Eleven v3 och v4, ElevenLabs verktyg för ljudeffekter eller att mixa ljud efter generering
Prosodi: Tonhöjd, talhastighet och volym med SSML
SSML-taggen <prosody> justerar tonhöjd, talhastighet och volym för ett textavsnitt. I tidigare ElevenLabs-modeller styr du tempot med röstinställningen för hastighet och uttrycksfullheten med inställningen för stabilitet. Båda gäller för hela genereringen, snarare än för en enskild fras.
För att ändra tempo inom ett manus delar du upp texten i separata genereringar eller lägger till <break>-taggar mellan meningarna. På Eleven v3 och v4 använder du Audio Tags i tabellen ovan, som [slowly], [rushed] och [whispers], direkt på raden.
Uttal: <phoneme>, <say-as> och <sub> med SSML
ElevenLabs ger dig tre sätt att styra uttalet i dina TTS-resultat.
Här är de främsta metoderna du kan använda:
- Använd <phoneme> för en enstaka korrigering på Flash v2 eller Turbo v2, som i exemplet ovan.
- Använd ett uttalslexikon för termer som återkommer i många manus. Ett lexikon kan innehålla fonemregler och aliasregler som fungerar som <sub>, till exempel genom att mappa ”UN” till ”United Nations”.
- För det som <say-as> hanterar, som siffror, datum, valutor och telefonnummer, kan du använda textnormalisering, som omvandlar skrivna värden till talade ord. När ett värde måste läsas på exakt ett sätt, som ett bekräftelsenummer, skriv ut det eller separera siffrorna i manuset.
Språk och språkvariant
SSML-taggen <lang> markerar en fras som tillhörande ett annat språk. ElevenLabs TTS-modeller läser inte den här taggen. Välj i stället en flerspråkig modell och skriv frasen på det språk den ska uttalas på.
Flash v2 och Turbo v2 är endast för engelska, så manus som blandar språk behöver en flerspråkig modell som Multilingual v2, Flash v2.5, Eleven v3 eller Eleven v4. Eleven v4 och v3 stöder också accenttaggar som [French accent] och IPA-transkription på fler än 70 språk.
Ljud och ljudeffekter
SSML-taggen <audio> spelar upp ett inspelat klipp i ett talat svar. Det är en SSML-tagg som ElevenLabs inte stöder, eftersom våra TTS-modeller kan generera nya ljudeffekter från dina uppmaningar på naturligt språk.
För att lägga till ljud i själva talet skriver du bara ljudeffektstaggen, som [applause] eller [door slamming], och ser hur Eleven v4 och Eleven v3 väcker den till liv. För längre eller mer detaljerad ljuddesign kan du generera ljudeffekten separat och mixa den med röstspåret i din redigerare eller ditt produktionsworkflow.
Bästa praxis för SSML med ElevenLabs
Om du arbetar med någon av de äldre TTS-modellerna från ElevenLabs stöds SSML-taggar fortfarande delvis. Kom ihåg att du när som helst kan byta till Eleven v4 för att få full nytta av Audio Tags, vilket innebär att du aldrig mer behöver leta upp den exakta formuleringen för en SSML-tagg.
Men när du arbetar med SSML i ElevenLabs får du här några tips för att komma igång:
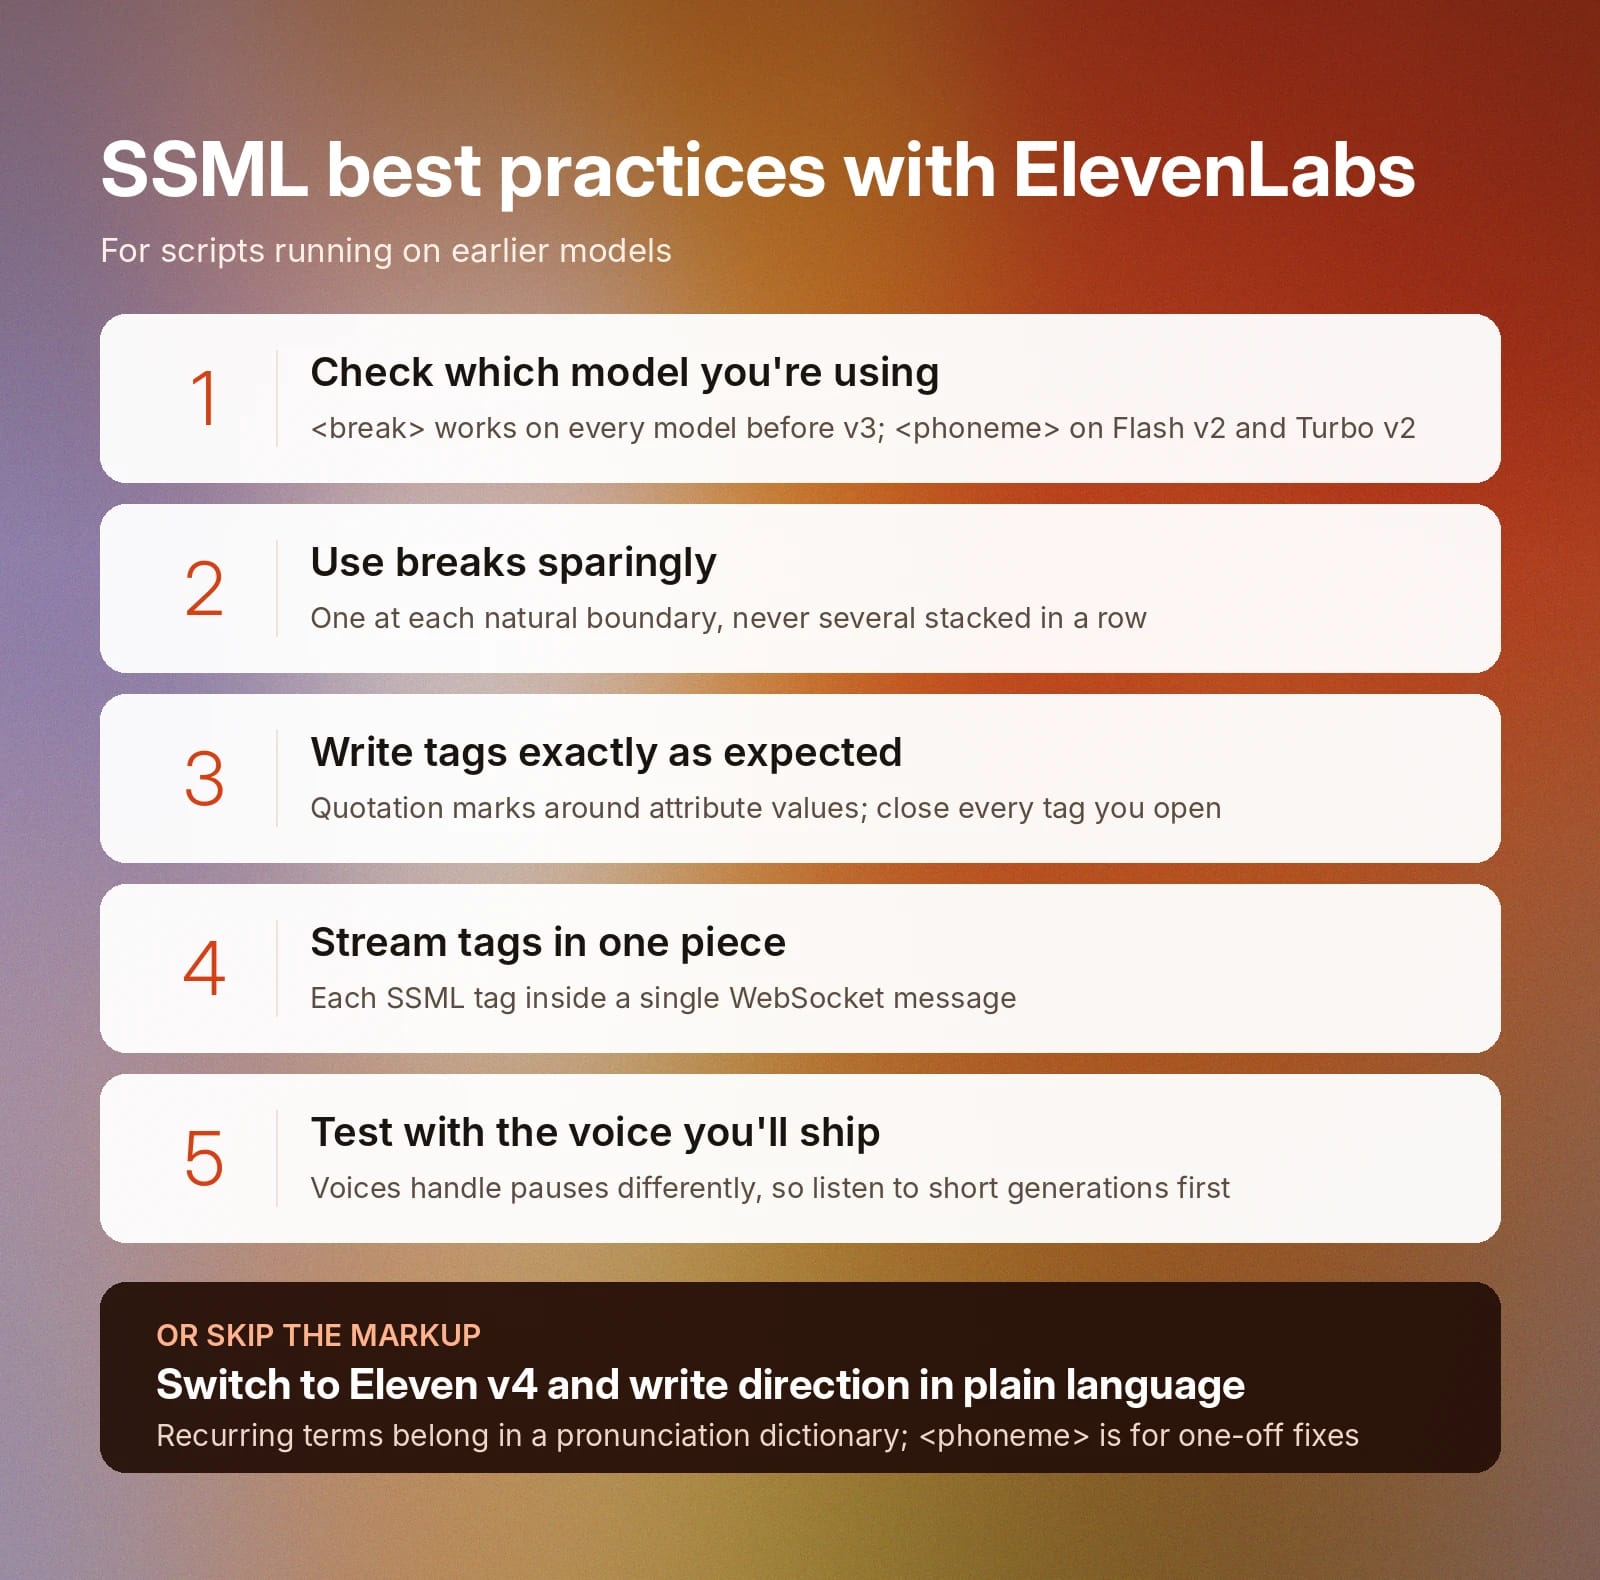
- Kontrollera vilken modell du använder: <break> fungerar på alla modeller utom Eleven v3, <phoneme> fungerar bara på Flash v2 och Turbo v2, och Audio Tags fungerar bara på nyare modeller som Eleven v4 och Eleven v3.
- Använd pauser sparsamt: Placera en vid varje naturlig gräns i stället för att stapla flera i rad.
- Skriv SSML-taggar enligt förväntat format: Behåll citattecknen runt attributvärden, till exempel <break time="2.0s" />, och stäng varje tagg du öppnar.
- Strömma taggar i ett stycke: Skicka varje SSML-tagg i ett enda WebSocket-meddelande.
- Testa med rösten du ska använda: Röster hanterar pauser olika, så lyssna på korta genereringar innan du kör ett helt manus. ElevenLabs har över 17 500 röster i vårt Voice Library.
Utöver denna bästa praxis för SSML är det en bra idé att använda ett uttalslexikon för termer som kommer att förekomma ofta. För enstaka korrigeringar är <phoneme> det bästa alternativet.
Vilka är de främsta användningsområdena för SSML?
Speech Synthesis Markup Language används främst för att styra eller finjustera hur en TTS-motor skapar ett ljudklipp. Det är ett användbart verktyg för att infoga pauser eller förfina uttalet av ett visst ord, samt för att lägga till en känsla av prosodi i AI-genererat tal.
Här är några användningsområden där SSML-standarden är användbar:
- Interaktiva röstsvarssystem (IVR): Användbart när ett IVR-system vill pausa mellan en uppmaning och en meny eller läsa siffror tydligt.
- Konversations-agenter: Lägga till en kort paus före ett svar så att utbytet låter naturligt.
- Ljudböcker och lång berättarröst: Pausa vid kapitelslut och mellan scener för att tydligt avgränsa det som kommer före och efter att ögonblicket tar slut.
- E-lärande och utbildning: Korrigera uttalet av produktnamn, tekniska termer, förkortningar och verksamhetsspecifika termer.
- Aviseringar och varningar: Styra hur datum, tider och referenskoder läses upp.
Även om SSML erbjuder många användningsområden kan allt detta uppnås med Audio Tags, utan att du behöver memorera och infoga ofta komplicerade SSML-taggar i dina manus. Eleven v4 och Eleven v3 skapade Audio Tag-systemet för att ge användare full kontroll över sina AI-genererade talresultat utan SSML-krångel.
Varför Eleven v4 använder Audio Tags i stället för SSML
Eleven v4 använder Audio Tags som en annan mekanism för att styra framförandet och förfina uttalet. Den läser inbäddade instruktioner inom hakparenteser direkt från manustexten, så att du kan skriva på naturligt språk för att skapa ett visst resultat. Dessa Audio Tags täcker ett brett spektrum av instruktioner, bland annat:
- Känslor, som [sad] eller [excited]
- Framförande och tempo, som [whispers] eller [rushed]
- Mänskliga reaktioner, som [sighs] eller [laughs]
- Accenter och karaktärsröster, som [French accent]
- Ljudeffekter, inklusive [applause] eller [door shutting]
Anledningen till denna design bygger på hur modellen läser kontext i en konversation. Eleven v4:s arkitektur läser kontext djupare än tidigare modeller, vilket gör att den kan följa känslomässiga signaler, tonala skiften, talarbyten och ledtrådar i sammanhanget utan separata parametrar eller inställningar.
SSML ger specifika instruktioner vid en fast punkt i texten, vilket kan få framförandet att kännas stelt och hackigt. SSML är en av de främsta anledningarna till att AI-text låter robotaktig, trots högkvalitativa underliggande modeller.
En signal som [whisper] ger Eleven v4 en tolkningsanvisning som tillämpas på den omgivande raden och formas av prosodin i allt runt omkring.
De flesta SSML-element har en direkt motsvarighet i v4:
SSML-tagg
Funktion
Motsvarigheter i Eleven v4
<break time="1s">
Infogar en paus
[pause], en ellips eller en radbrytning
<prosody rate="slow">
Saktar ned talet
[drawn out] eller [slowly]
<prosody rate="fast">
Snabbar upp talet
[rushed]
<emphasis>
Betonar ett visst ord
[shouts] eller att skriva ett ord med versaler
<prosody pitch="high">
Höjer tonhöjden
Känslotaggar som [excited]
<prosody pitch="low">
Sänker tonhöjden
Känslotaggar som [sorrowful]
Uttal följer samma mönster för ersättning. IPA ingår som inbyggt stöd i Eleven v4, med transkription på fler än 90 språk. Det låter team styra uttalet utan de XML-taggar som annars krävs, genom att lägga till transkription inom snedstreck direkt i texten.
Kom igång med naturligt tal i ElevenCreative
Audio Tags ger manus de pauser, känslor, det tempo och den röststil som en röstskådespelare skulle läsa direkt ur texten. Eleven v4 för in denna uttrycksfullhet i ett komplett produktionsworkflow och kombinerar ElevenLabs röstmodeller med bild- och videomodeller, så att ett manus blir en färdig ljud- eller videoproduktion i en arbetsyta.
Se hur Audio Tags blir till färdigt ljud med Eleven v4 eller skapa ett kostnadsfritt konto för att experimentera med SSML och Audio Tags i dina egna manus redan i dag.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.