Så åtgärdar du problem med Text to Speech-precision
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Även om de tränas på enorma röstdatauppsättningar och konsekvent kan skapa ljud med hög kvalitet, kan de flesta modeller för Text to Speech (TTS) fortfarande uttala ord fel eller få andra talproblem. Feluttal uppstår när en TTS-motor stöter på ord och fraser utanför det tal som finns i dess träningsdata. Det händer oftast med branschjargong, varumärkesnamn eller egennamn.
TTS-motorer kan också generera stressat, styltigt eller robotliknande tal när textstycken är långa eller har interpunktion för läsning i stället för att vara strukturerade för att läsas upp.
Du kan också stöta på några vanliga tekniska problem när du ansluter dina applikationer till TTS-motorer via API.
I den här artikeln går vi igenom dessa tre kategorier av problem och vanliga sätt att lösa dem.
Sammanfattning
- Fel med Text to Speech delas vanligtvis in i feluttal, onaturligt tempo eller rytm samt tekniska API-körningsfel.
- Du kan effektivast åtgärda feluttal med ordböcker enligt W3C-standarden Pronunciation Lexicon Specification (PLS), eller justera dem individuellt med fonetiska taggar direkt i dina manus.
- Du kan styra hur naturlig din talutdata låter genom att formatera och sätta interpunktion i manuset på rätt sätt. Text som är formaterad för att talas skiljer sig ofta från text som bara ska läsas.
- Du kan diagnostisera API-fel med vanliga HTTP-statuskoder.
- Genom att testa uttalet av varumärkesnamn, egennamn och nya fraser var för sig i förväg kan du spara mycket felsökning senare.
Varför fungerar inte Text to Speech?
Problem med Text to Speech kan i stort delas in i tre kategorier.
Typer av TTS-problem
Feluttal
TTS-modellen läser fel på nya ord eller fraser, till exempel ditt varumärkesnamn, branschjargong, akronymer eller homografer.
Onaturlig leverans & rytm
Talutdata är monoton, pausar på märkliga ställen eller skyndar igenom stycken som behöver levereras långsammare.
Integrations- & API-fel
Din applikation genererar inte tal av en eller flera tekniska orsaker, till exempel saknade röst-ID:n, kapacitetsgränser eller trasiga API-nycklar.
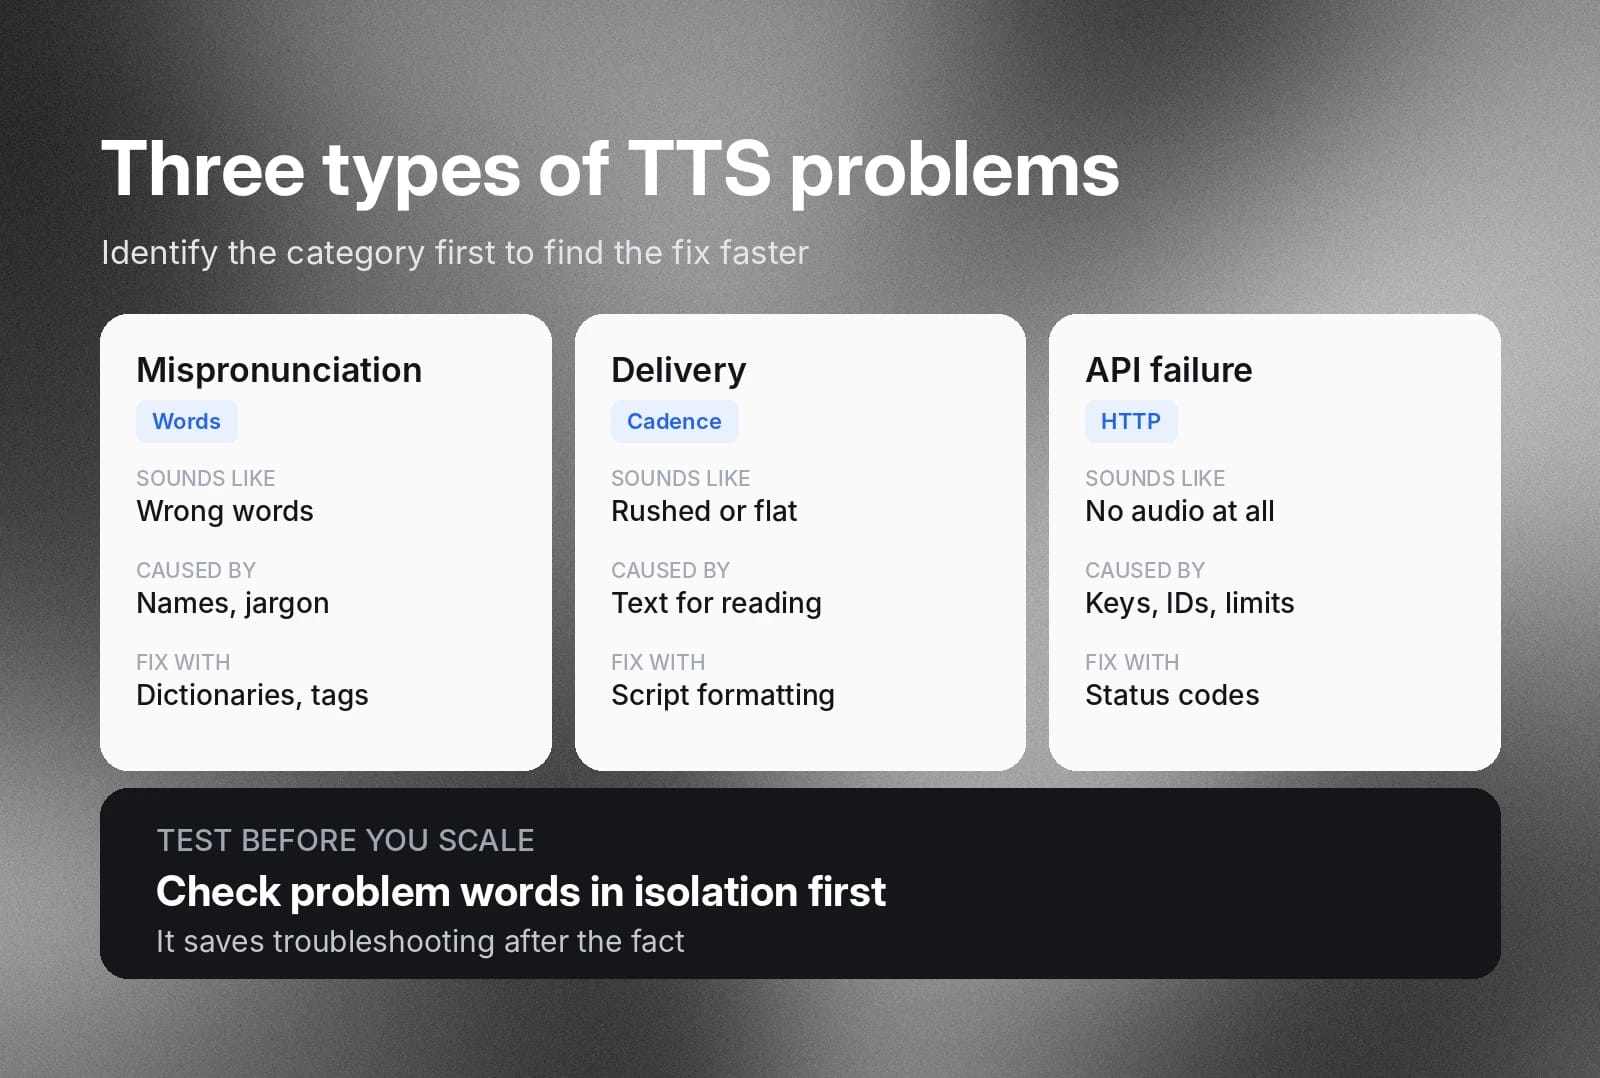
I den här guiden går vi igenom vart och ett av de tre problemen mer ingående, så att du kan förstå exakt vilken typ av kvalitets- eller tekniskt problem du står inför. När du förstår dem kan du snabbare hitta rätt lösning.
Så åtgärdar du problem med Text to Speech-precision: Feluttal och onaturlig leverans
Ingenjörer tränar moderna neurala röstmodeller på enorma taldatauppsättningar. De kan generera naturligt tal för nästan oräkneliga ordkombinationer. Men ingen träningsdatauppsättning är heltäckande. Det kommer alltid att finnas ovanliga uttal och obskyra ord eller egennamn som modellen inte uttalar korrekt.
Det här händer inte ofta, men alla som använder TTS-modeller regelbundet bör vara förberedda på hur de ska hantera det när det händer. Först är det viktigt att förstå varför dessa feluttal uppstår.
Vanliga grundorsaker till talfel
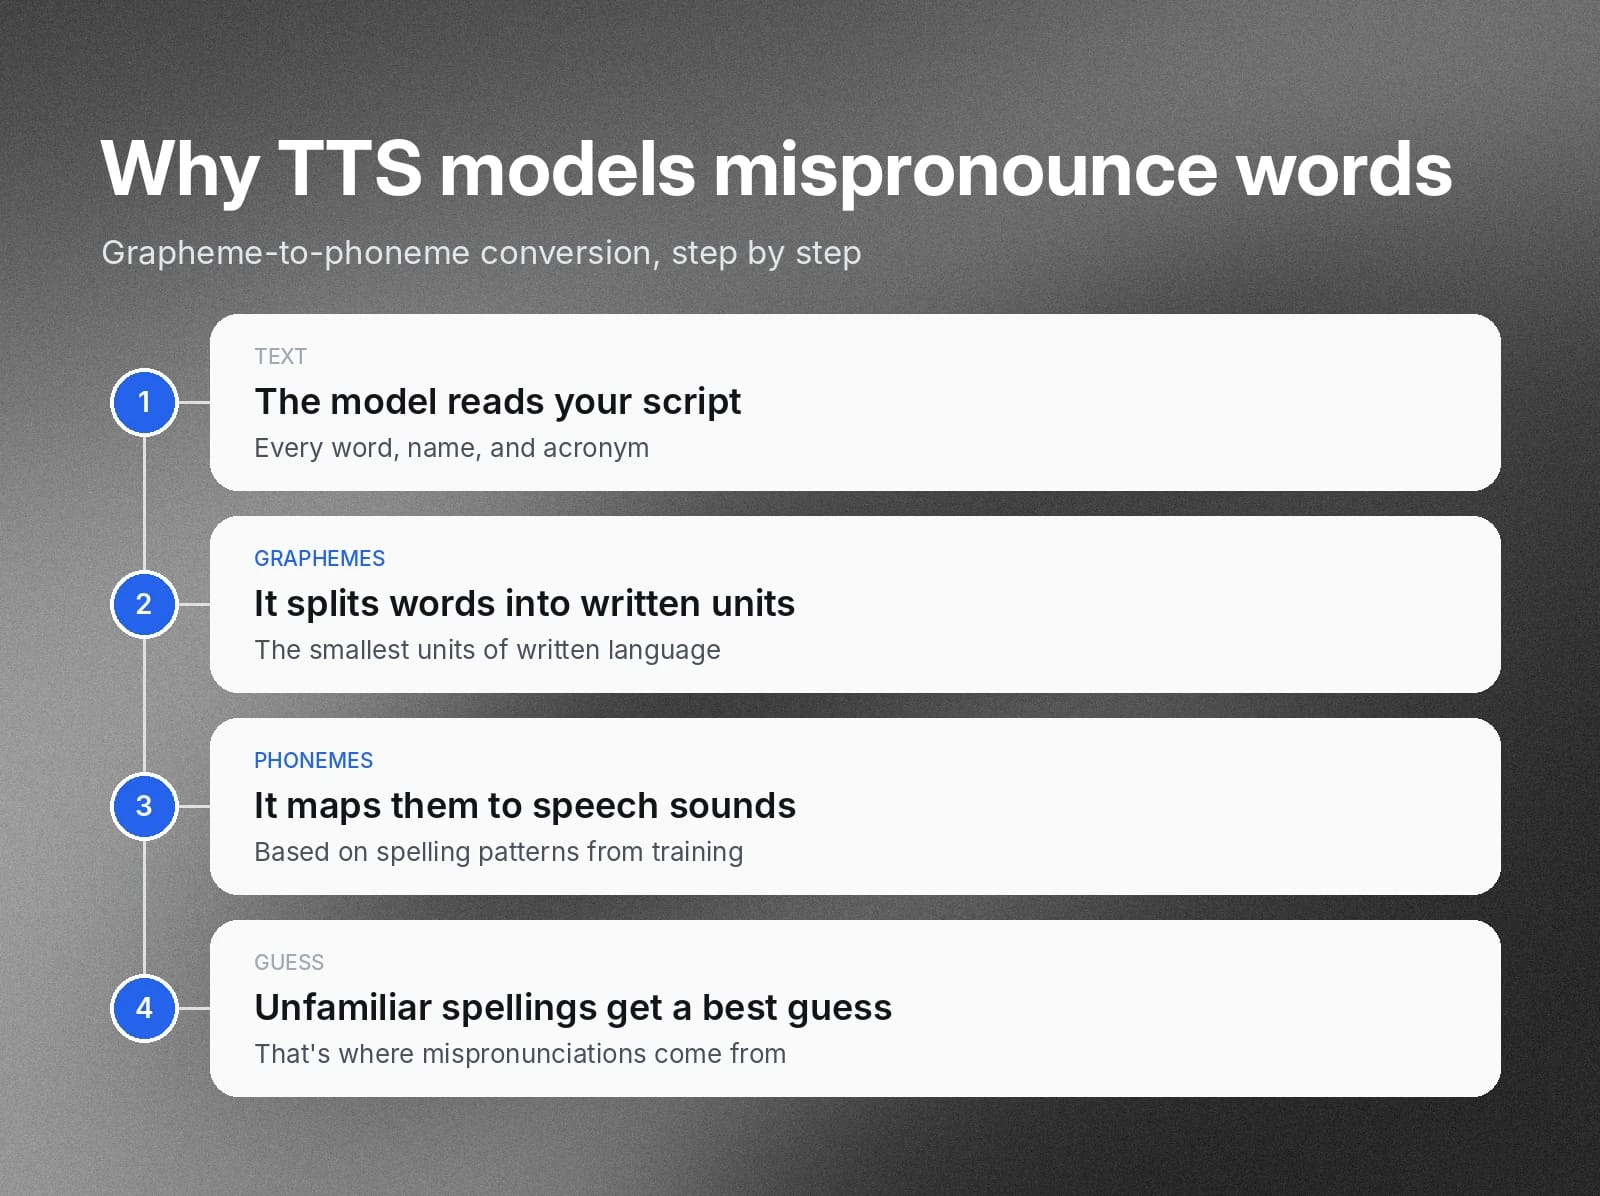
Talsyntesmodeller fungerar genom att omvandla text till tal med en process som kallas grafem-till-fonem-konvertering (G2P). Fonem är de minsta enheterna av talat ljud. Grafem är de minsta enheterna i skriftspråket, vanligtvis en bokstav, som representerar ett fonem.
När textinmatningen inte matchar de stavningsmönster modellerna har stött på i träningsdata gör de sin bästa gissning av det fonetiska uttalet. Ibland leder det till feluttal.
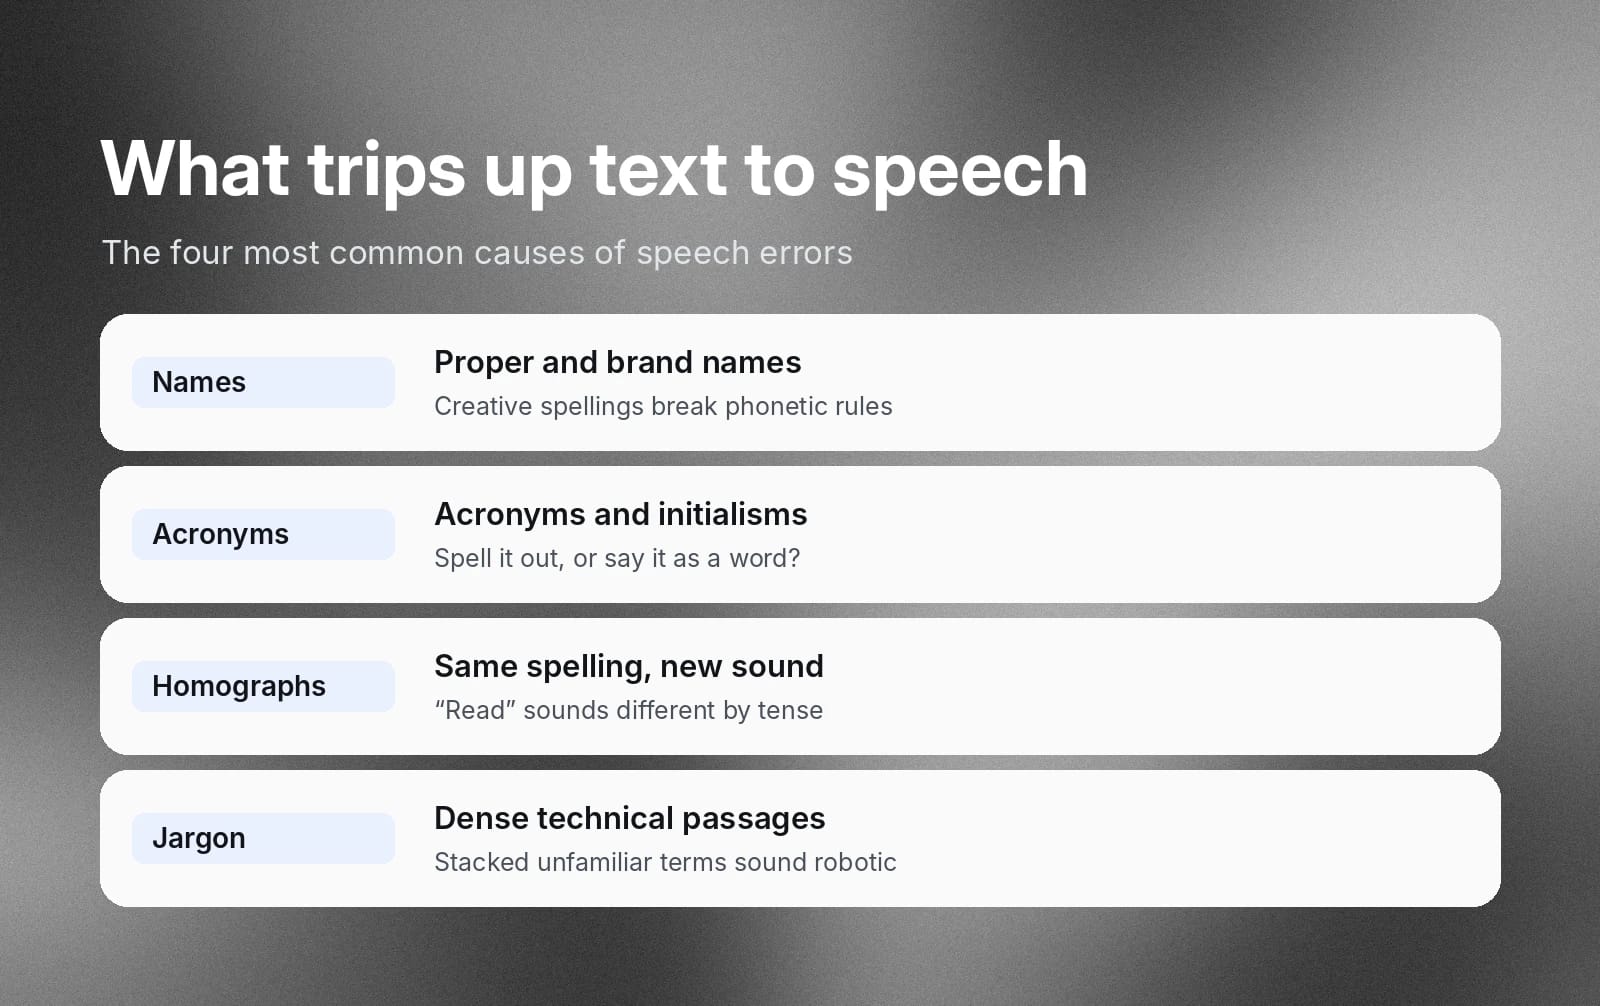
Egennamn och varumärkesnamn
Företag använder ofta kreativa stavningar för varumärkesnamn. De drar till sig blickar, men förvirrar också ofta talsyntesmodeller. Kreativa för- och efternamn kan göra detsamma, av samma anledning.
När en modell stöter på ett obekant namn försöker den tillämpa de grundläggande fonetiska regler den har lärt sig. Talutdata kan då hamna långt från det du vill ha.
Akronymer & initialförkortningar
Tänk på akronymen NASA. Föreställ dig att du aldrig har sett den förut, precis som en talmodell kanske inte har gjort. Uttalar du den ”N.A.S.A.” eller ”nasa?” Hur är det med ett API för programvara? Är det ”A.P.I.” eller ”api?” Vad händer om ditt företag säljer ett helt nytt programvaruverktyg med en ny akronym? Du kan vara säker på att den inte finns i en talmodells träningsdata. Modellen måste därför gissa hur du vill att den ska uttalas, om du inte ger anpassade instruktioner.
Homografer
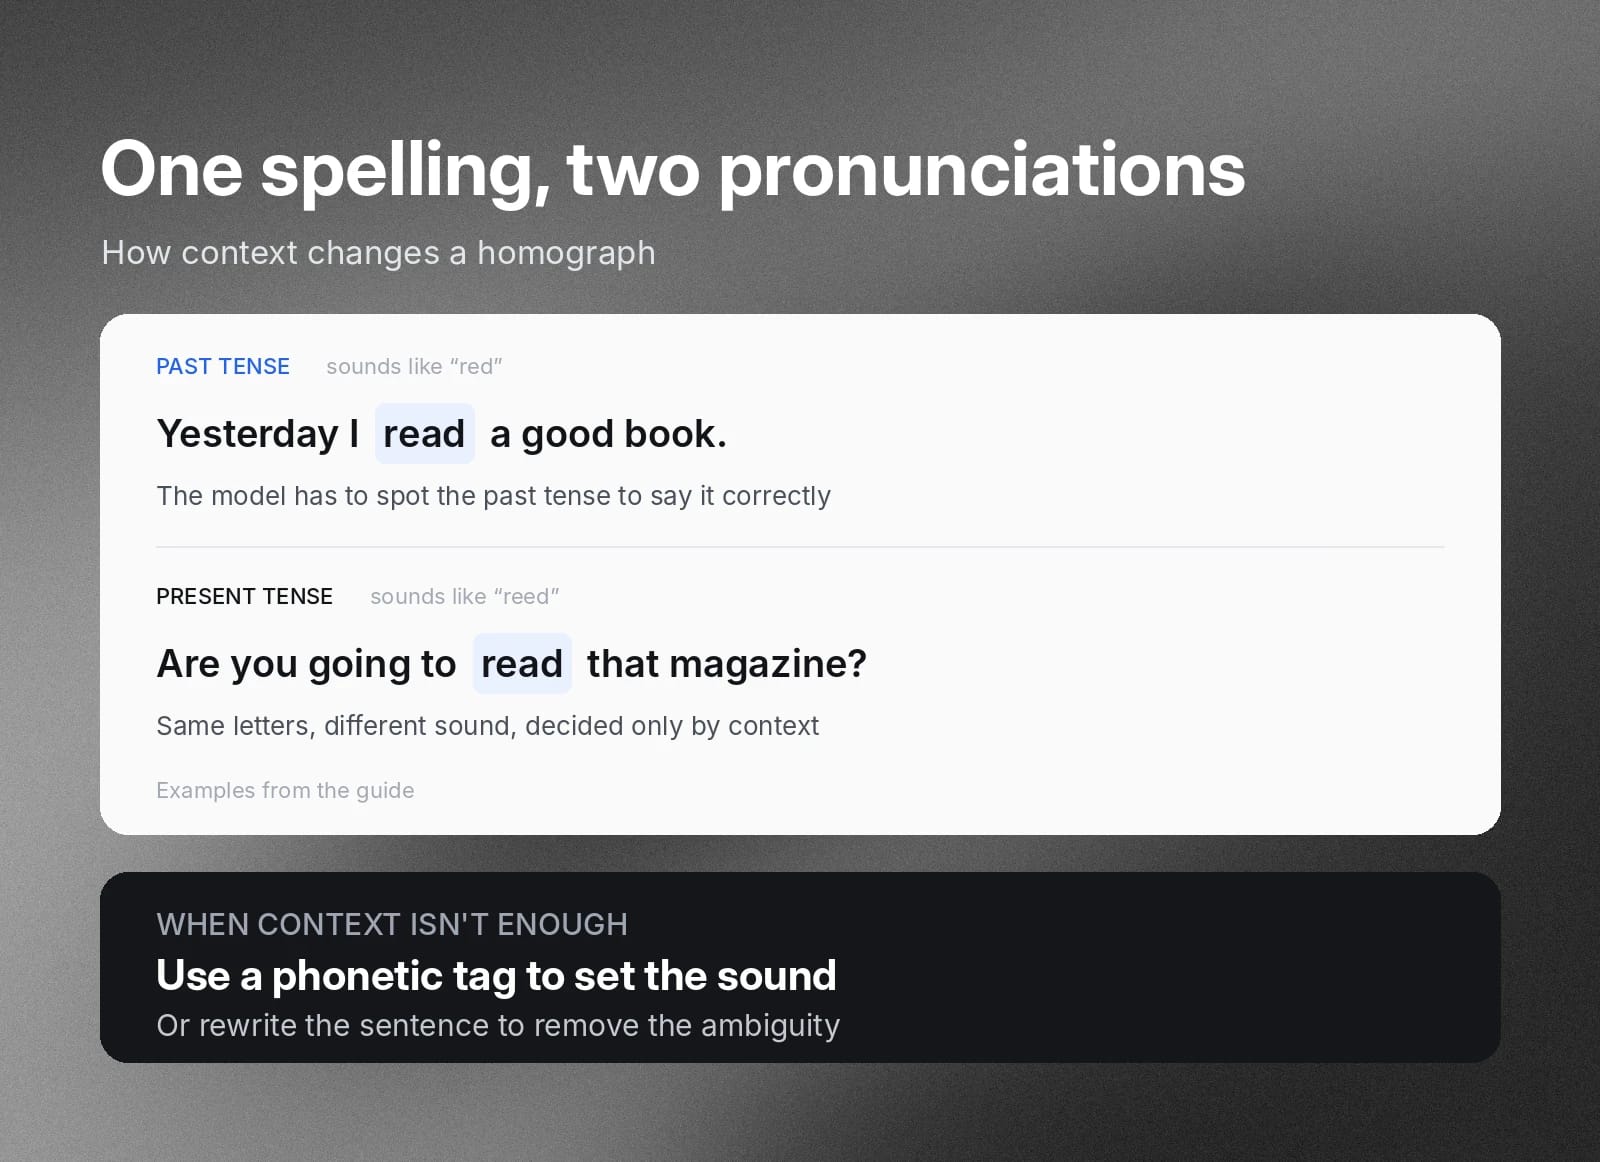
Homografer är ord som stavas likadant men uttalas olika beroende på sammanhanget. Till exempel stavas det engelska ordet ”read” likadant men uttalas olika i dåtid och nutid.
- ”I går läste jag en bra bok.”
- ”Ska du läsa den där tidningen?”
En talmodell behöver tillräcklig förståelse för sammanhanget för att avgöra hur homografer ska uttalas enligt dina önskemål.
Onaturliga betoningar
Långa meningar med teknisk jargong kan snabbt stapla obskyra ord, särskilda uttal och akronymer på varandra. Ett fel som knappt märks för sig kan snabbt bli en del av ett platt, robotliknande tal när modellen försöker tolka många obekanta ord och formuleringar.
Två sätt att styra röstuttal
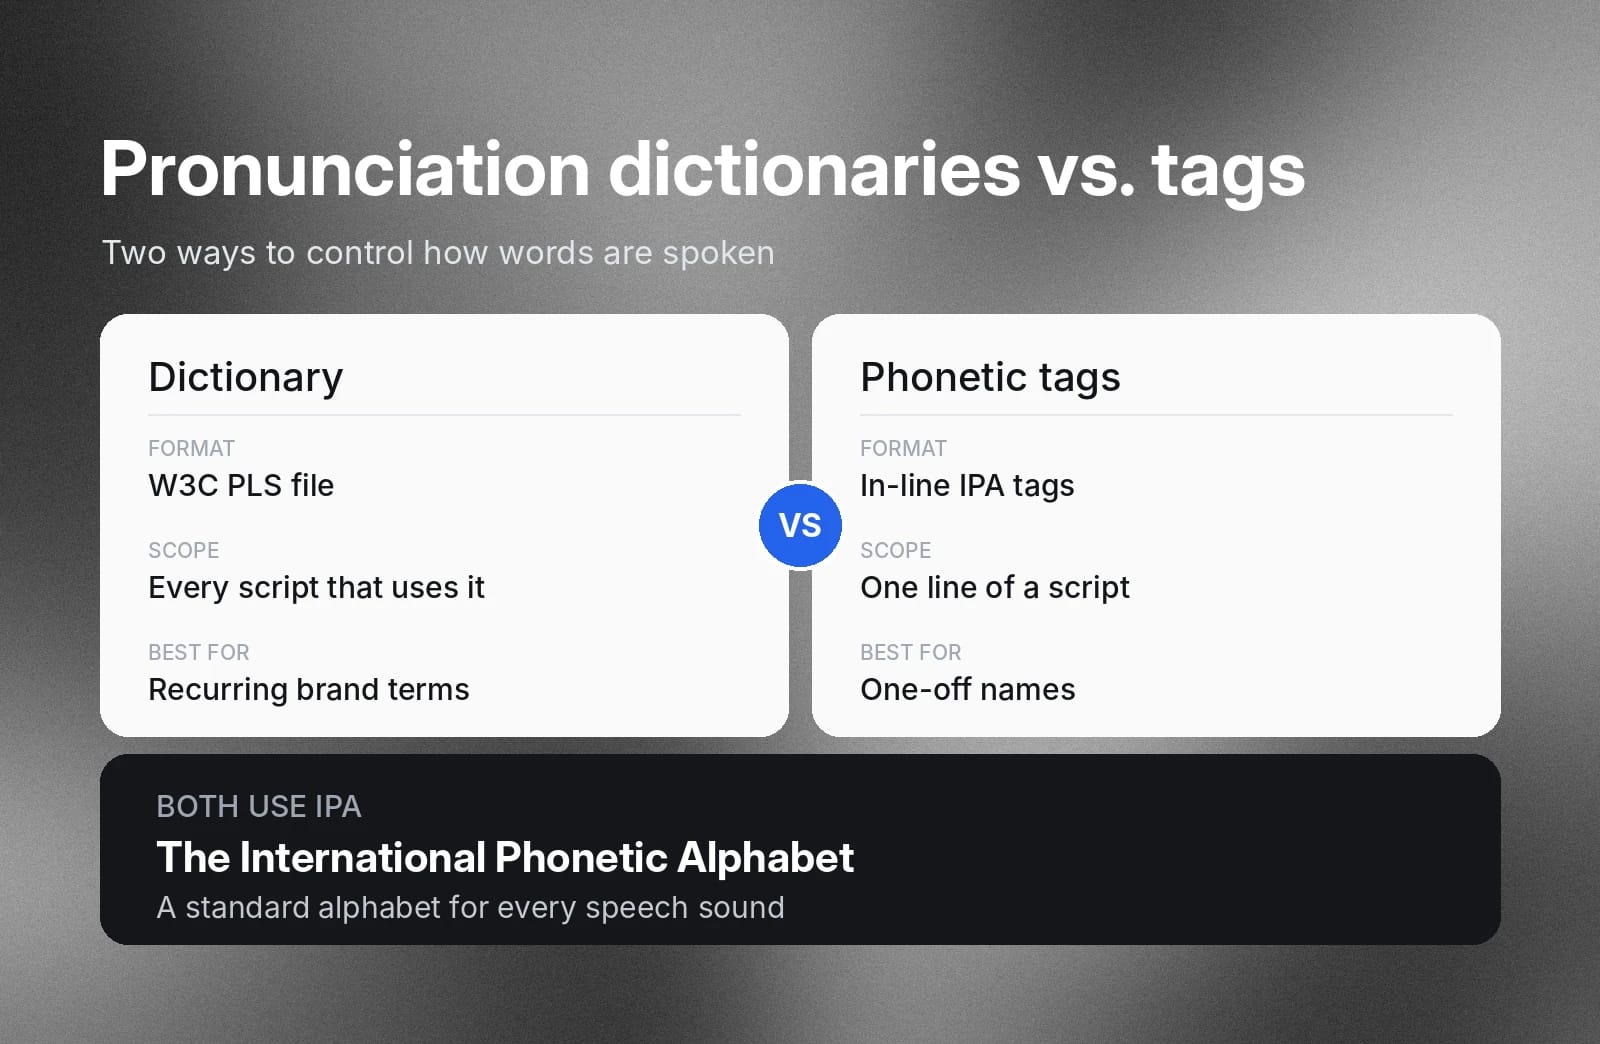
Du behöver inte skriva om hela dina manus för att undvika de här situationerna. Moderna neurala talmodeller har två verktyg för att lösa dem effektivt från fall till fall: uttalsordböcker och fonetiska manustaggar.
Uttalsordböcker för Text to Speech
Ordböcker är bäst när du har en uppsättning anpassade uttal som återkommer regelbundet i dina TTS-projekt. Till exempel om ditt företag säljer medicintekniska produkter och dina manus ofta innehåller tekniska termer, medicinska procedurer och annat domänspecifikt innehåll.
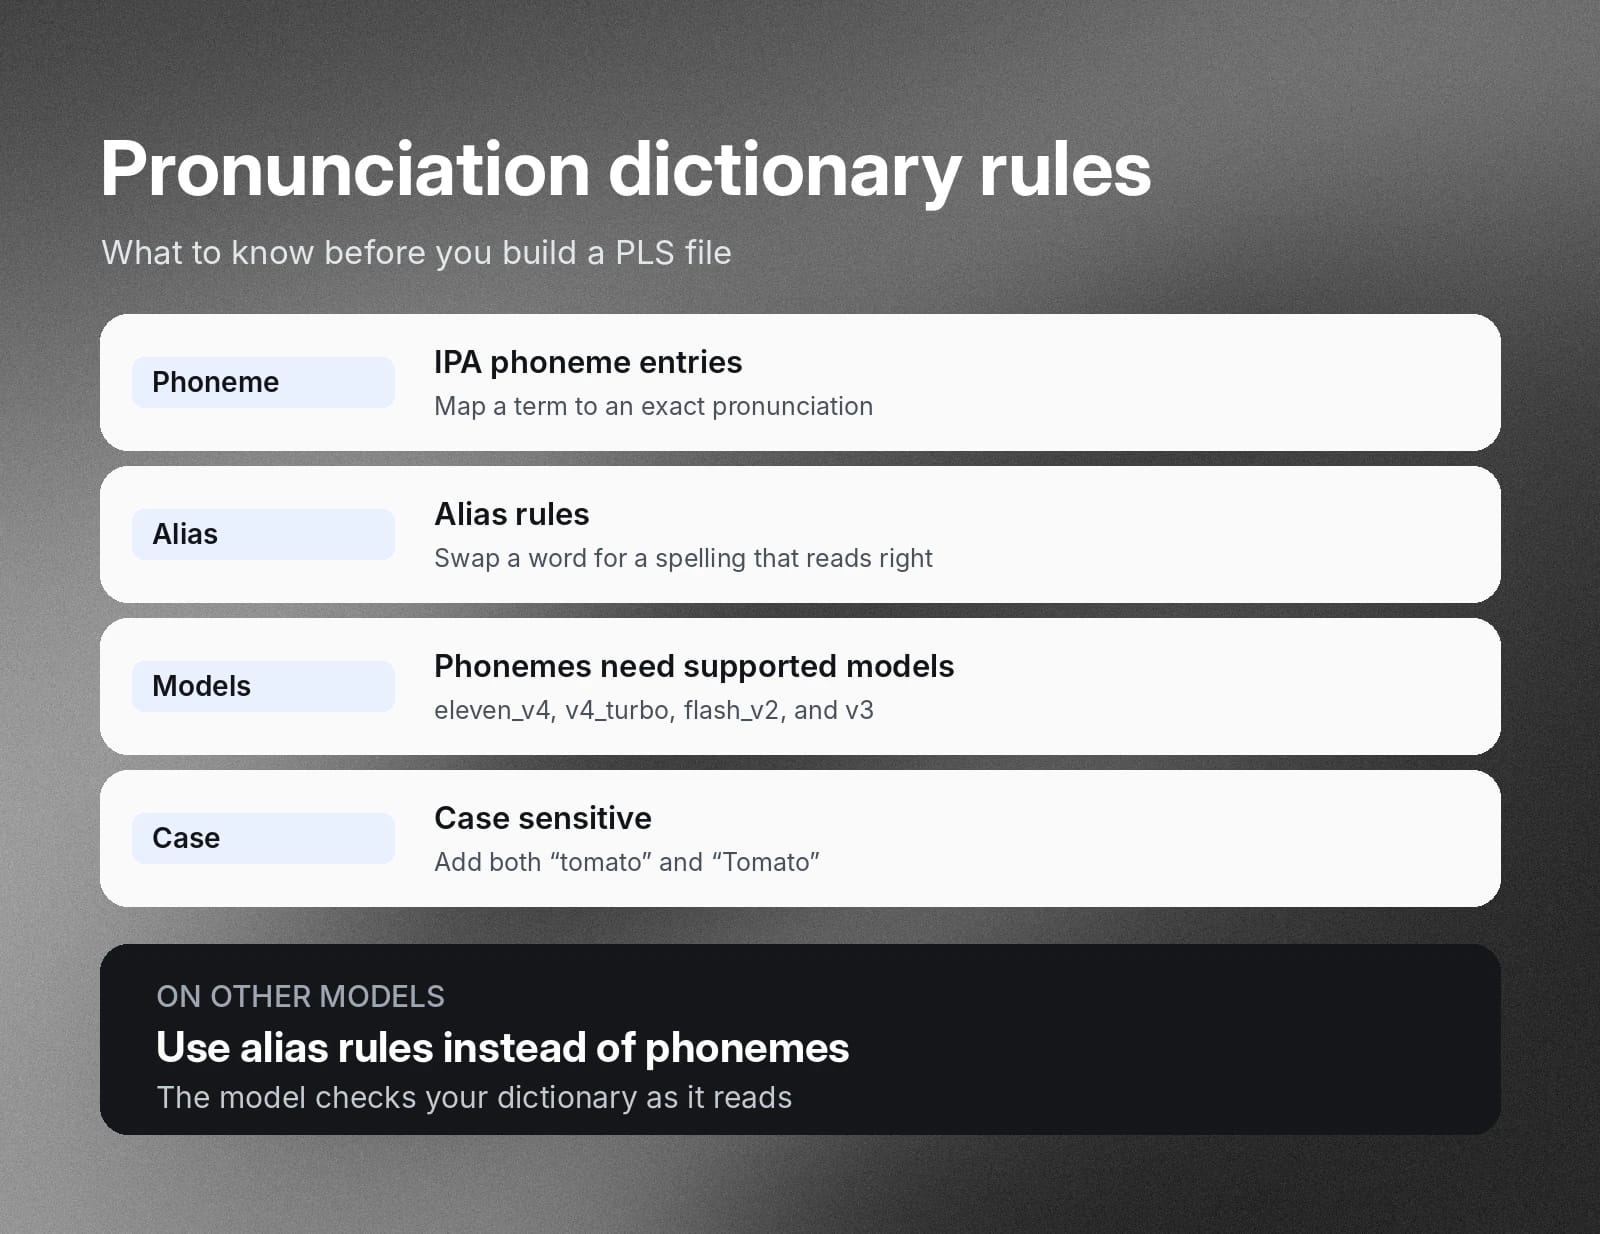
Formatet enligt W3C-standarden Pronunciation Lexicon Specification (PLS) ger en struktur för att koppla dessa termer till specifika fonetiska uttal med notation från International Phonetic Alphabet (IPA). International Phonetic Alphabet är ett standardiserat alfabet för alla möjliga talljud. Talmodellen kontrollerar din ordbok medan den läser manuset och använder dina angivna uttal när den stöter på ord i ordboken. Fonempunkter fungerar endast med modellerna eleven_v4, eleven_v4_turbo, eleven_flash_v2 och eleven_v3. Använd aliasregler för andra modeller. PLS-filer är skiftlägeskänsliga, så lägg till både ”tomato” och ”Tomato” om du behöver båda.
Fonetiska manustaggar
Fonetiska taggar är vanligtvis ett bättre val när du behöver justera enskilda rader i ett manus. I stället för att skapa en ordbok använder du fonetiska taggar direkt i texten som får talmodellen att uttala ett ord som du vill enligt IPA.
Anta till exempel att du skriver ett podcastmanus och vill hänvisa till en branschexpert två eller tre gånger. I stället för att lägga till henne i företagets uttalsordbok taggar du bara hennes namn med rätt uttal när du använder det i manuset.
Skriv och formatera manus som låter naturliga när de läses upp
Ordböcker och taggar är användbara för att hantera problem med enskilda ord i talutdata, men de löser inte frågor om övergripande leverans, rytm och taldynamik. När du skriver ett manus är det viktigt att utforma texten med insikten att den ska läsas upp. Ditt ordval, dina formuleringar och din interpunktion bör ofta skilja sig från text som bara är avsedd att läsas.
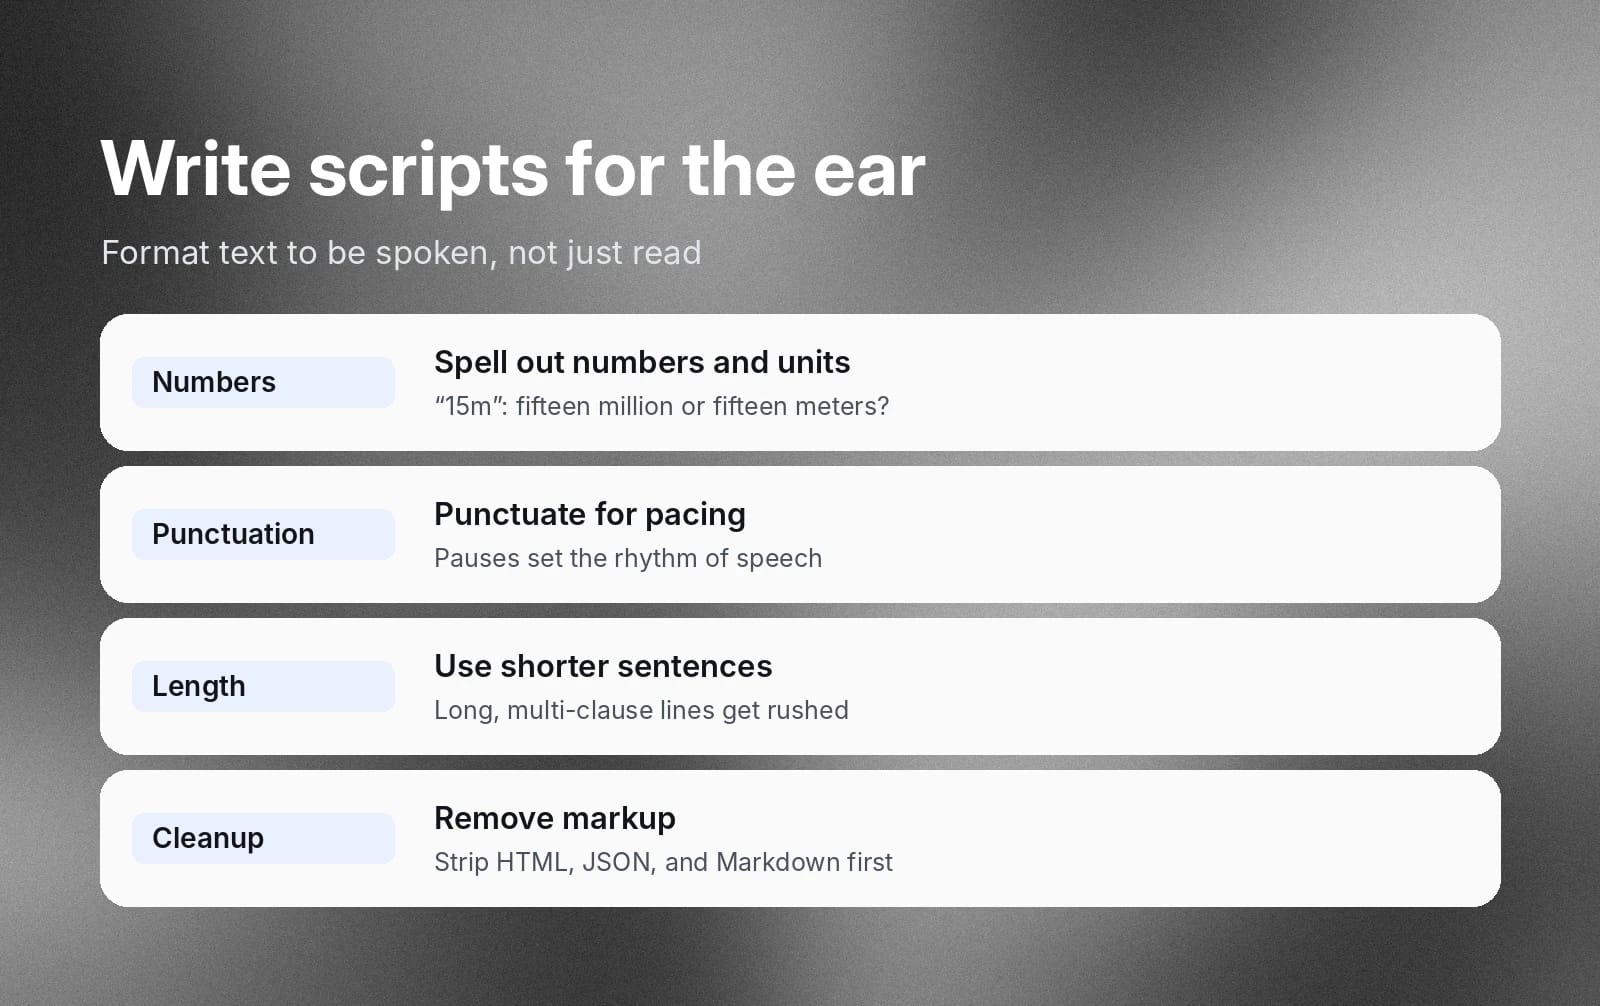
Skriv för örat, inte för ögat
När du skriver manus, tänk som en talskrivare: ”Hur vill jag att det här ska läsas upp? Var pausar vi för dramatisk effekt? Var ökar vi tempot?” De frågorna är lika relevanta för manus till avancerade neurala talmodeller som för manus du skriver för en person.
Skriv ut siffror, valutor och datum
Du vill inte lämna något utrymme för tvetydighet i dina manus. Neurala talmodeller förstår sammanhang väl, men fungerar bäst när de inte behöver gissa. Förkortningar och kortformer är vanliga saker som de kan snubbla på.
Ett manus kan till exempel säga: ”Du letar efter en siffra nära 15m.” Vill skribenten att TTS-motorn ska säga ”femton miljoner” eller ”femton meter”? Skriv ut det så att modellen inte behöver gissa utifrån sammanhanget.
Använd vanlig interpunktion för att styra tempot
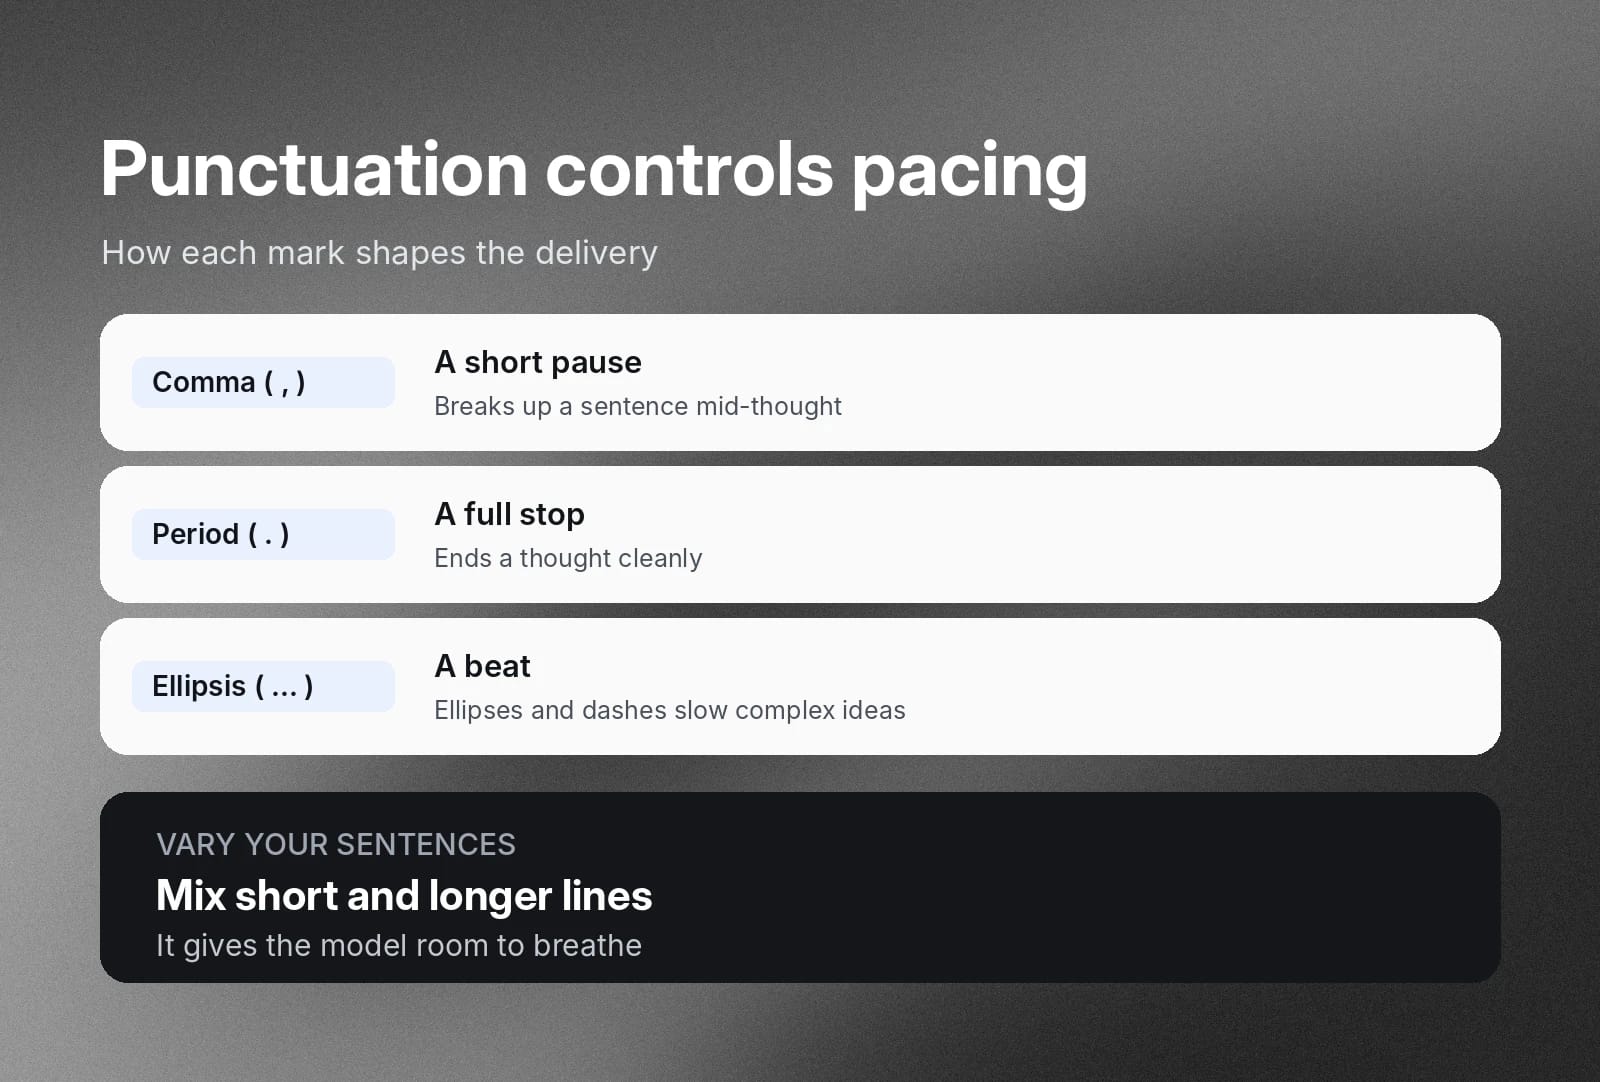
Interpunktion spelar en viktig roll i skriven text, men den är ännu viktigare i Text to Speech-syntes. Interpunktion styr rytmen. Den representerar olika typer av pauser som du kan använda för att dela upp komplexa tankar eller bara behålla en naturlig rytm som är bekvämare att lyssna på.
- Använd kommatecken för korta pauser mitt i en mening.
- Använd punkt för att avsluta en tanke.
- Använd ellipser och tankstreck för att skapa ett avbrott mitt i komplexa idéer så att modellen inte låter stressad.
Korta meningar är bättre meningar
Modeller snubblar oftast på eller skyndar igenom långa meningar med villkor och flera satser. Dela upp dem i kortare påståenden av varierande längd. Det ger modellen mer andrum och hindrar den från att skynda när den försöker hitta rytmen i långa, slingrande meningar.
Ta bort formatering och Markdown-rester
Om du syntetiserar tal från ett innehållshanteringssystem eller annat affärssystem kan texten innehålla HTML, JSON, Markdown eller annan formatering. Ta bort detta och formatera innehållet som text för att få så naturligt tal som möjligt. Talmodeller kan ha svårt att förstå när de ska ignorera dessa taggar, läsa dem bokstavligt eller införliva dem i utdata utifrån sammanhanget.
Du kan läsa mer om feluttal och andra problem i ElevenLabs felsökningsguide.
Åtgärda vanliga ElevenLabs API-fel
Team som producerar röstljud i stor skala ansluter vanligtvis sina applikationer till en talsyntesmodell via API. Det gör produktionen mer effektiv överlag, men lägger till ett tekniskt lager som du behöver hantera utöver modellens talutdata.
Referensen för ElevenLabs API-felkoder beskriver svarskoder i detalj, men här är de fyra vanligaste HTTP-statuskoderna vid felsökning av Text to Speech-integrationer och hur du hanterar dem.
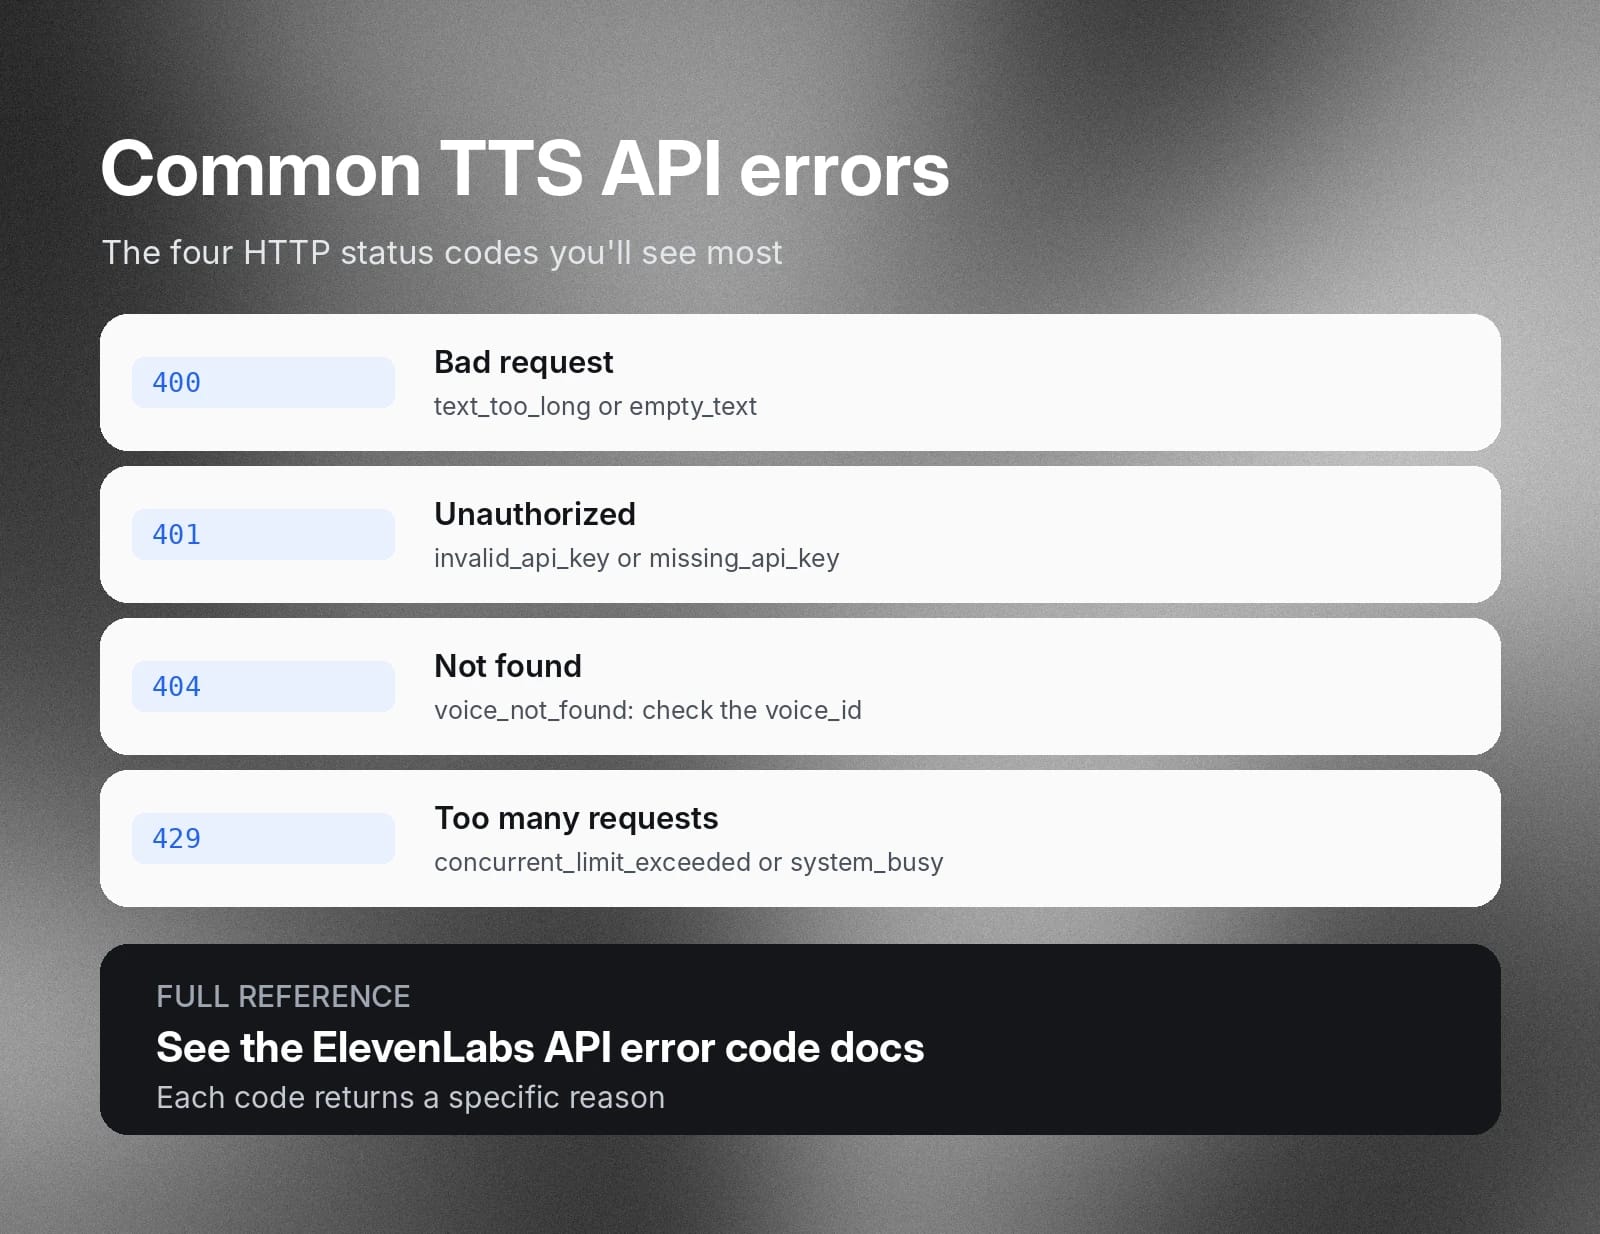
400 Bad Request (payloadfel)
Ett svar med statuskod 400 från ett API för talmodeller betyder att din applikation skickade data som modellen inte kunde bearbeta. I TTS-workflows beror det vanligtvis på att teckenbegränsningar överskrids eller att tomma indata skickas av misstag.
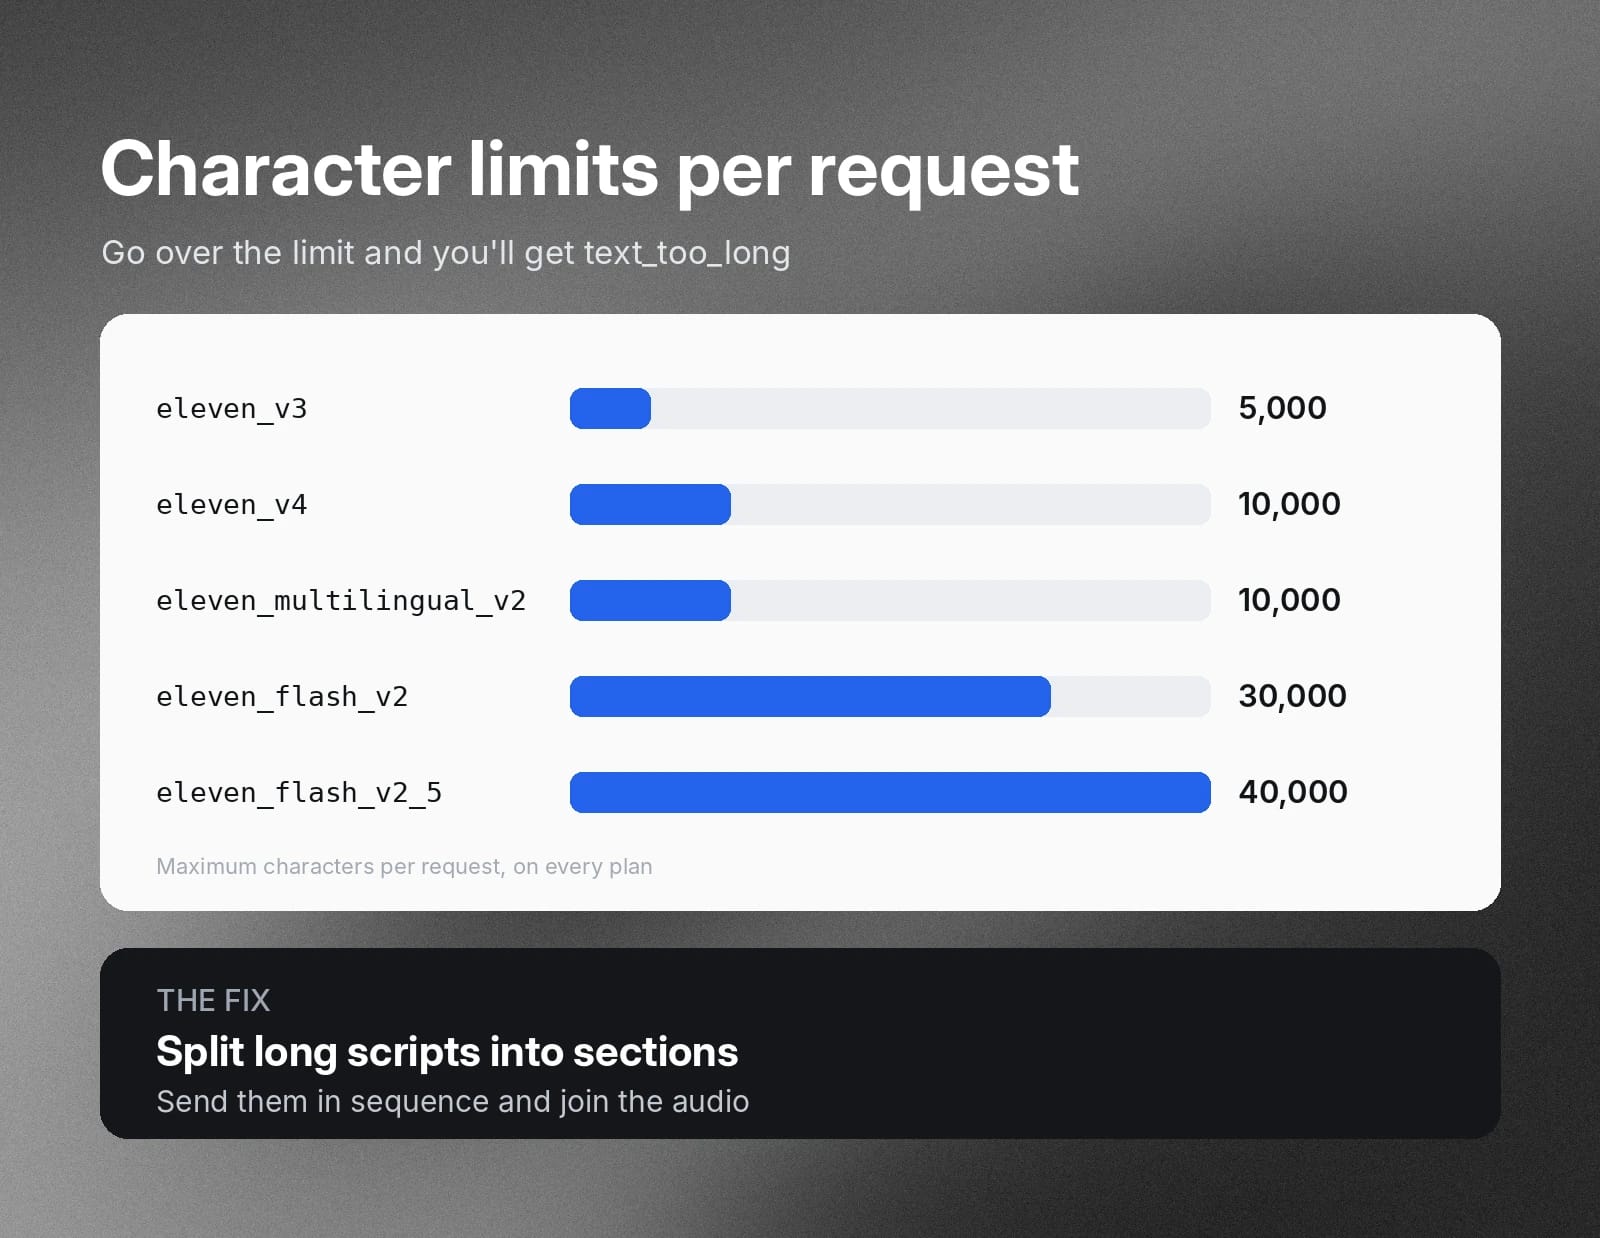
Teckengränsen har överskridits (text_too_long)
Varje TTS-begäran du skickar har en teckengräns som anges av modellen. Om du försöker skicka mer text än modellens gräns tillåter returnerar TTS-servern detta fel. Gränserna per begäran är 10 000 tecken för eleven_v4 och eleven_multilingual_v2, 5 000 för eleven_v3, 30 000 för eleven_flash_v2 och 40 000 för eleven_flash_v2_5, på alla abonnemang. Lös problemet genom att dela upp längre manus i flera avsnitt som modellen kan bearbeta i följd.
Tom inmatningstext
En TTS-motor avvisar alla payloads som innehåller tomma strängar (empty_text). Lägg till rensningssteg i din inmatningspipeline för att ta bort tomma rader, så att servern inte avvisar en annars fungerande payload.
401 Unauthorized (autentiseringsproblem)
Fel 401 betyder att API-gatewayen avvisade dina autentiseringsuppgifter och att din payload inte skickades vidare till modellen. Det händer när det finns ett problem med API-nyckeln.
Ogiltig API-nyckel
Din begäran till modellservern måste innehålla en giltig xi-api-key. Om den inte gör det returnerar servern fel 401. Kontrollera att din nyckel faktiskt finns med i begäran och att den inte har återkallats, gått ut eller trunkerats från headers vid driftsättning. API:t returnerar invalid_api_key när nyckeln är fel och missing_api_key när ingen nyckel skickas.
404 Not Found (felaktiga röstidentifierare)
Du får fel 404 när endpointen inte kan hitta TTS-resursen som anges i URL-begäran. Det kan hända om du skickar fel voice_id-parameter eller om den saknas i begärans URL. Kontrollera att du har fått rätt voice_id att använda. Verifiera att den faktiskt finns i sökvägsparametrarna och inte är felstavad. API:t returnerar voice_not_found när röst-ID:t inte finns.
429 Too Many Requests
Det här felet har två olika orsaker: du har nått gränsen för samtidiga begäranden för din tjänstenivå, eller så begränsar TTS-plattformen begäranden för att hantera en trafikspik.
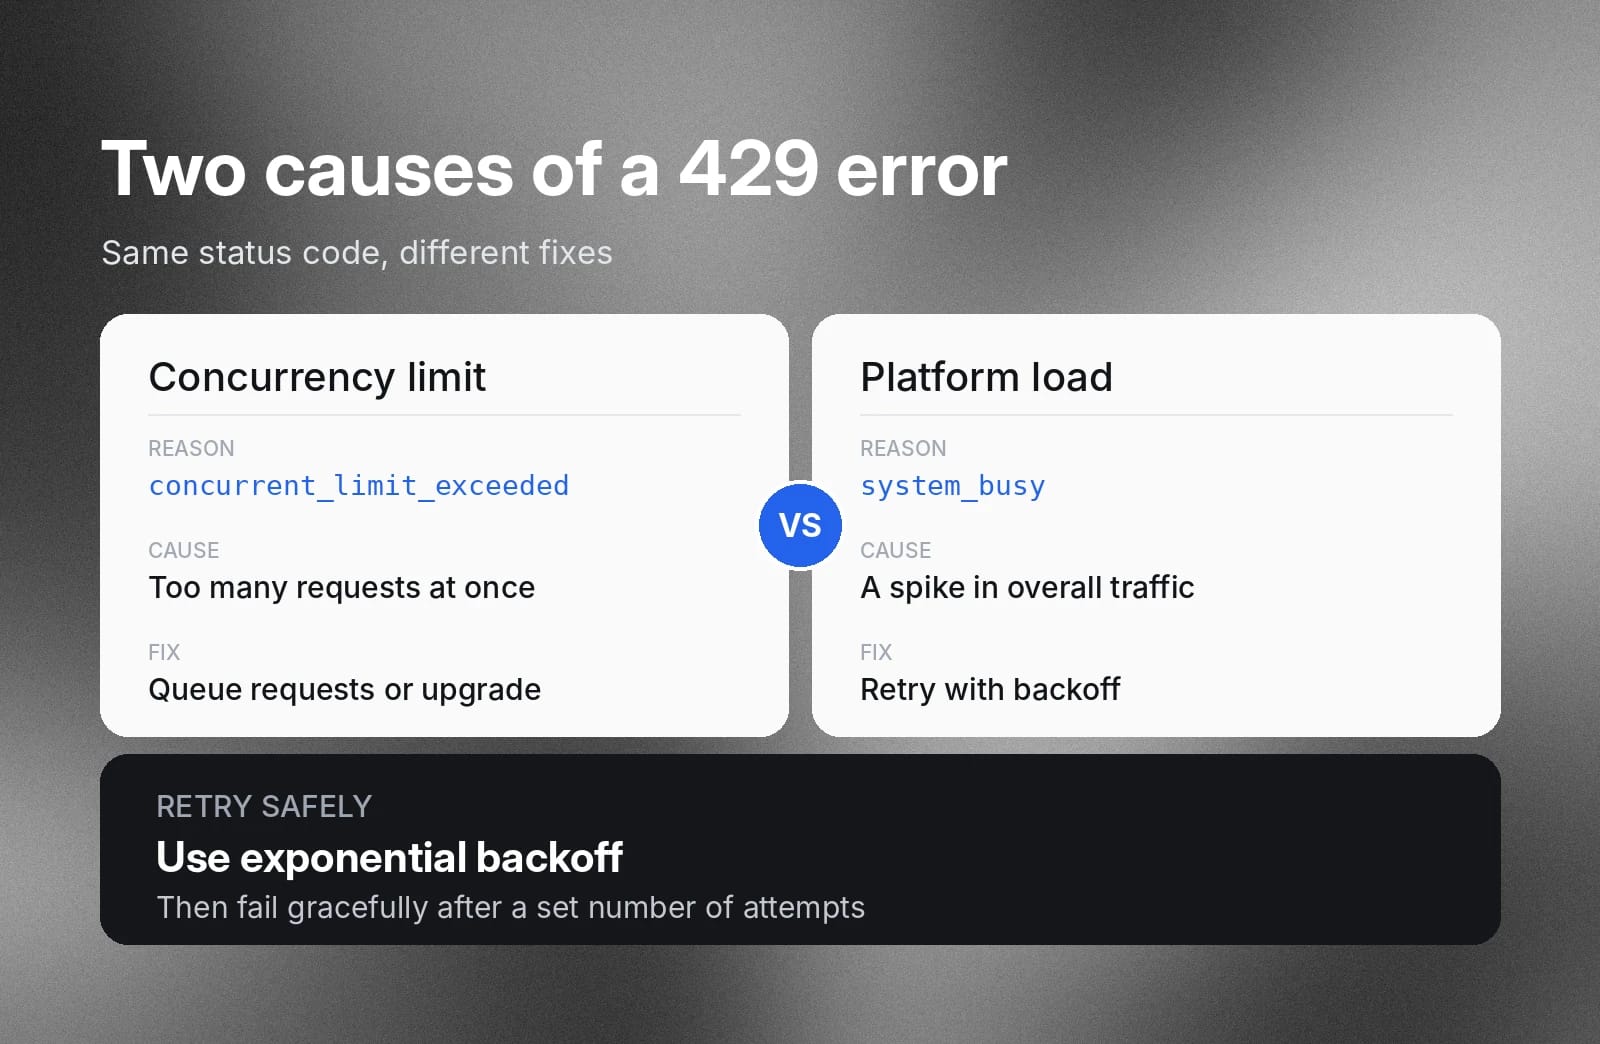
Gränser för samtidiga begäranden (concurrent_limit_exceeded)
Varje abonnemangsnivå för en TTS-motor anger ett fast antal samtidiga begäranden som du kan skicka. Om dina applikationer överskrider den gränsen returnerar servern den här typen av 429-fel.
Bygg ett asynkront kölager med en tjänst som Redis för att styra dina utgående payloads så att de inte överskrider gränserna för din nivå. Du kan också bedöma om ett abonnemang på en högre nivå är kostnadseffektivt.
Toppar i plattformsbelastning (system_busy)
Vid hög belastning kan en TTS-server begränsa inkommande begäranden för att upprätthålla prestandan. Bygg in automatiserad återförsökslogik i applikationens API-klient. Se till att den kan försöka igen med exponentiell backoff och sedan avsluta på ett kontrollerat sätt efter ett maximalt antal försök.
Testa röster, språk och inställningar före publicering
Ett snabbt test i en webbapp är vanligtvis inte tillräcklig kvalitetskontroll för TTS-payloads i stor skala. Kostnaden för dåliga körningar kan snabbt bli hög. Testa manuset i en serie kontrollerade iterationer innan du skickar in det. Den förberedelsen hjälper dig att producera röstljud av högsta kvalitet på ett effektivare sätt.
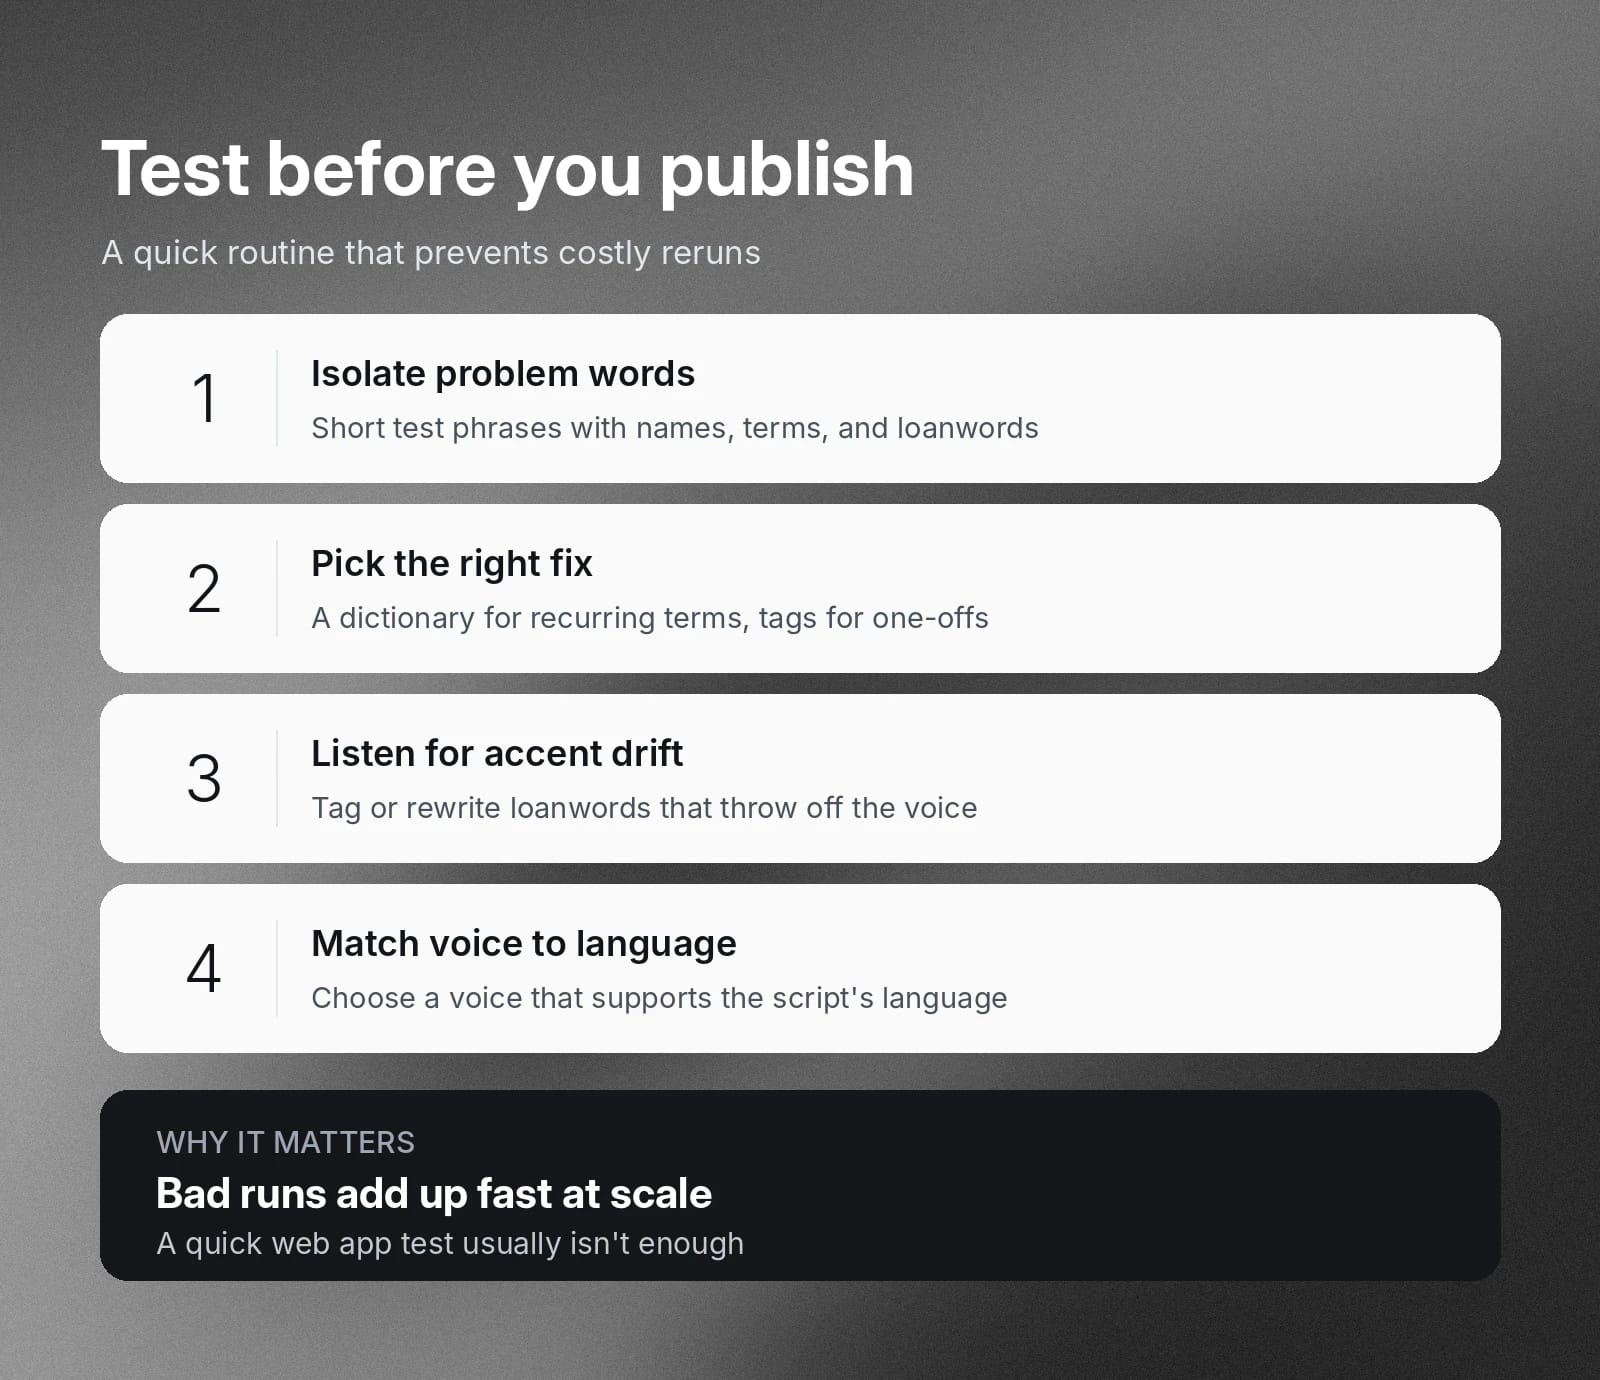
Testa problemord var för sig
Oftast gäller problemen specifika stycken eller enskilda ord eller namn, snarare än något genomgående. Skapa testfraser på fem till tio ord som innehåller dina varumärkesnamn, tekniska termer eller fraser på främmande språk. Utifrån utdata avgör du om du vill använda en uttalsordbok eller bara fonetiska taggar för varje fall.
Identifiera sannolik språk- eller accentdrift
Talmodeller kan ibland få en märklig eller långsam rytm mitt i en mening. Det händer ofta när modellen måste gissa hur ett stycke ska uttalas och det skiljer sig från vad den såg under träningen.
- Lånord: Text med obskyra lånord från ett främmande språk kan störa en modells grafemmappning, så att allt efterföljande tal får en märklig accent. Använd fonetiska taggar på lånordet eller skriv om texten.
- Styltigt tal på andra språk än engelska: En modell som är optimerad för engelska kan staka sig eller låta robotliknande när den läser ett översatt manus. Välj en röstprofil som också stöder det aktuella språket.
Kom igång med ElevenAPI för mer tillförlitlig talutdata
När du vet vad du ska hålla utkik efter kan du skapa röstinnehåll av hög kvalitet snabbare och med mindre krångel. Lär dig hantera problem med utdata och tekniska API-problem som kan stoppa produktionen.
Läs mer om hur du skapar högkvalitativt och precist TTS-innehåll med ElevenAPI, eller hämta din API-nyckel i dag för att komma igång.
Vanliga frågor om problem med Text to Speech

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.