Tagi SSML wyjaśnione: jak kontrolować pauzy, wymowę i tempo zamiany tekstu na mowę
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Speech Synthesis Markup Language (SSML) to oparty na XML język znaczników, który otacza tekst tagami i informuje model zamiany tekstu na mowę, jak ma go wypowiedzieć — gdzie zrobić pauzę, jak wymówić słowo i którą frazę zaakcentować.
Ta warstwa kontroli stoi za wieloma głosami AI, które już słyszysz. System interaktywnej obsługi głosowej (IVR), odczytujący numer potwierdzenia, i narrator audiobooka AI, robiący pauzę na końcu rozdziału, oba korzystają z jego odmiany. Jeśli dostosowywałeś głos generowany przez AI, prawdopodobnie spotkałeś się z SSML.
SSML jest częścią technologii TTS od ponad dwóch dekad i wciąż odgrywa dużą rolę w sposobie, w jaki wielu dostawców oferuje TTS. Ten przewodnik wyjaśnia, czym jest SSML i gdzie dokładnie działa w modelach ElevenLabs, wraz z ulepszonym systemem Audio Tags, z którego korzystają Eleven v3 i Eleven v4 do tworzenia naturalnie brzmiącej zamiany tekstu na mowę.
Zobacz Eleven v4 w akcji z Audio Tags
Odkryj Eleven v4Podsumowanie
- SSML to język znaczników oparty na standardzie W3C używany do kontrolowania pauz, akcentu, wymowy i tempa syntezowanej mowy.
- Modele ElevenLabs, z wyjątkiem Eleven v3 i Eleven v4, obsługują tag SSML <break> dla pauz do 3 sekund.
- Eleven Flash v2 i Eleven Turbo v2 obsługują tag <fonem> dla własnej angielskiej wymowy.
- Eleven v3 i Eleven v4 w ogóle nie obsługują SSML. Zamiast tego używają Audio Tags — instrukcji w języku naturalnym w nawiasach kwadratowych, takich jak [whispering] i [sighs], które kontrolują przebieg syntezowanej mowy.
- WebSocket API kontroluje analizę SSML parametrem enable_ssml_parsing i wysyła tagi SSML jako kompletne wiadomości, aby uniknąć dodatkowych opóźnień.
- Tagi takie jak <prosody>, <say-as>, <sub>, <lang>, <voice> i <audio> nie są obsługiwane przez modele ElevenLabs, ale każdy ma odpowiednik: ustawienia głosu, normalizację tekstu, słowniki wymowy, modele wielojęzyczne, osobne głosy i efekty dźwiękowe.
Czym jest SSML?
SSML to język znaczników, który pozwala opisać tekst pisany instrukcjami określającymi, jak silnik syntezy ma go wypowiedzieć. World Wide Web Consortium (W3C) stworzyło go jako standard wykraczający poza zwykłe modele zamiany tekstu na mowę. SSML oferuje jasne, czytelne dla maszyn instrukcje wymowy fragmentu tekstu, zamiast polegać na modelach interpretujących zwykły tekst.
SSML nie jest unikalnym językiem znaczników ograniczonym do jednego dostawcy. Amazon Polly i Microsoft Azure Speech używają tagów SSML, takich jak <break> i <emphasis>, jako głównego mechanizmu kontroli. Większość chmurowych platform zamiany tekstu na mowę akceptuje jakąś wersję tego standardu. SSML był domyślnym sposobem oznaczania mowy na długo przed pojawieniem się generatywnych modeli głosowych.
SSML pozostaje podstawowym standardem, a nowsze mechanizmy kontroli specyficzne dla modeli rozwijają się wraz z nowoczesnymi generatywnymi technologiami głosowymi. Niezależna od dostawców specyfikacja SSML pozwala wdrażać wspólne podstawowe tagi. Dostawcy mogą następnie nakładać na nie własne rozszerzenia i ograniczenia.
Popularne tagi SSML poprawiające intonację i ich działanie
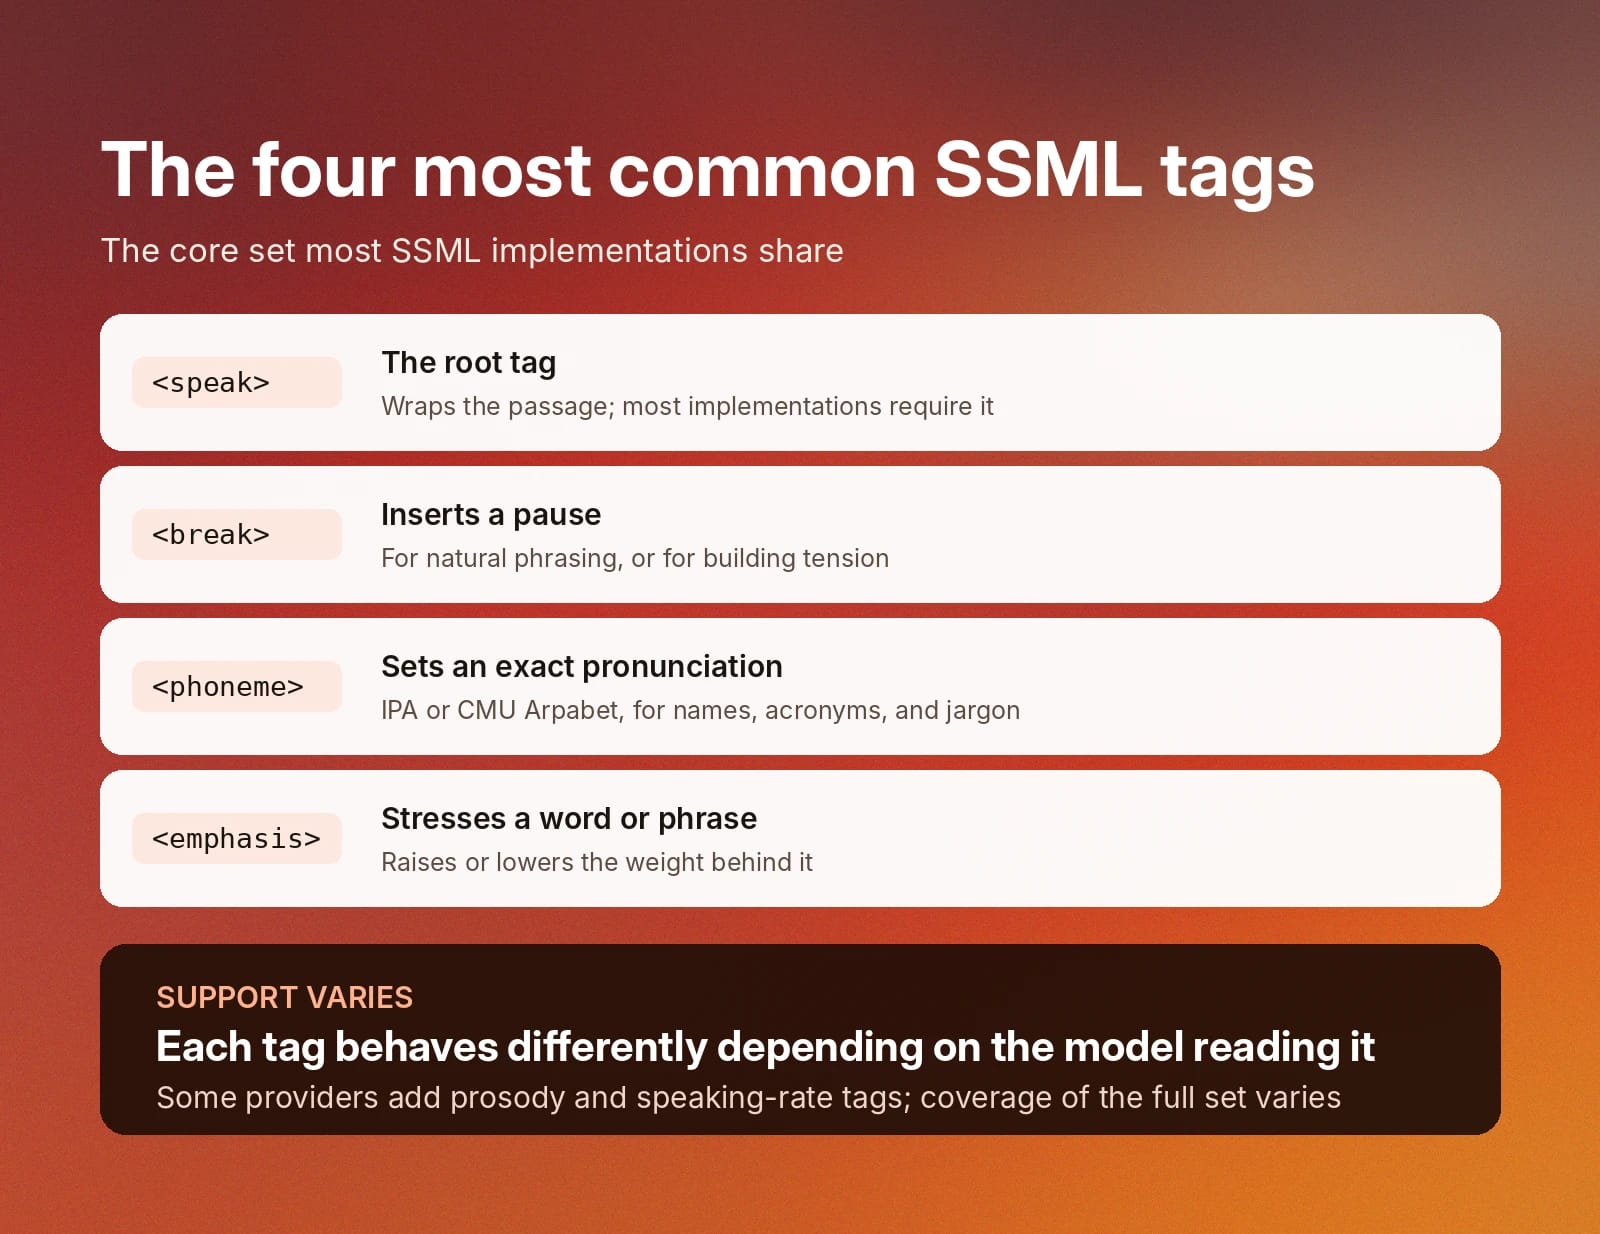
Implementacje SSML mają wspólny zestaw podstawowych tagów, których większość osób szuka, próbując kontrolować syntezowaną mowę.
Oto popularne tagi SSML:
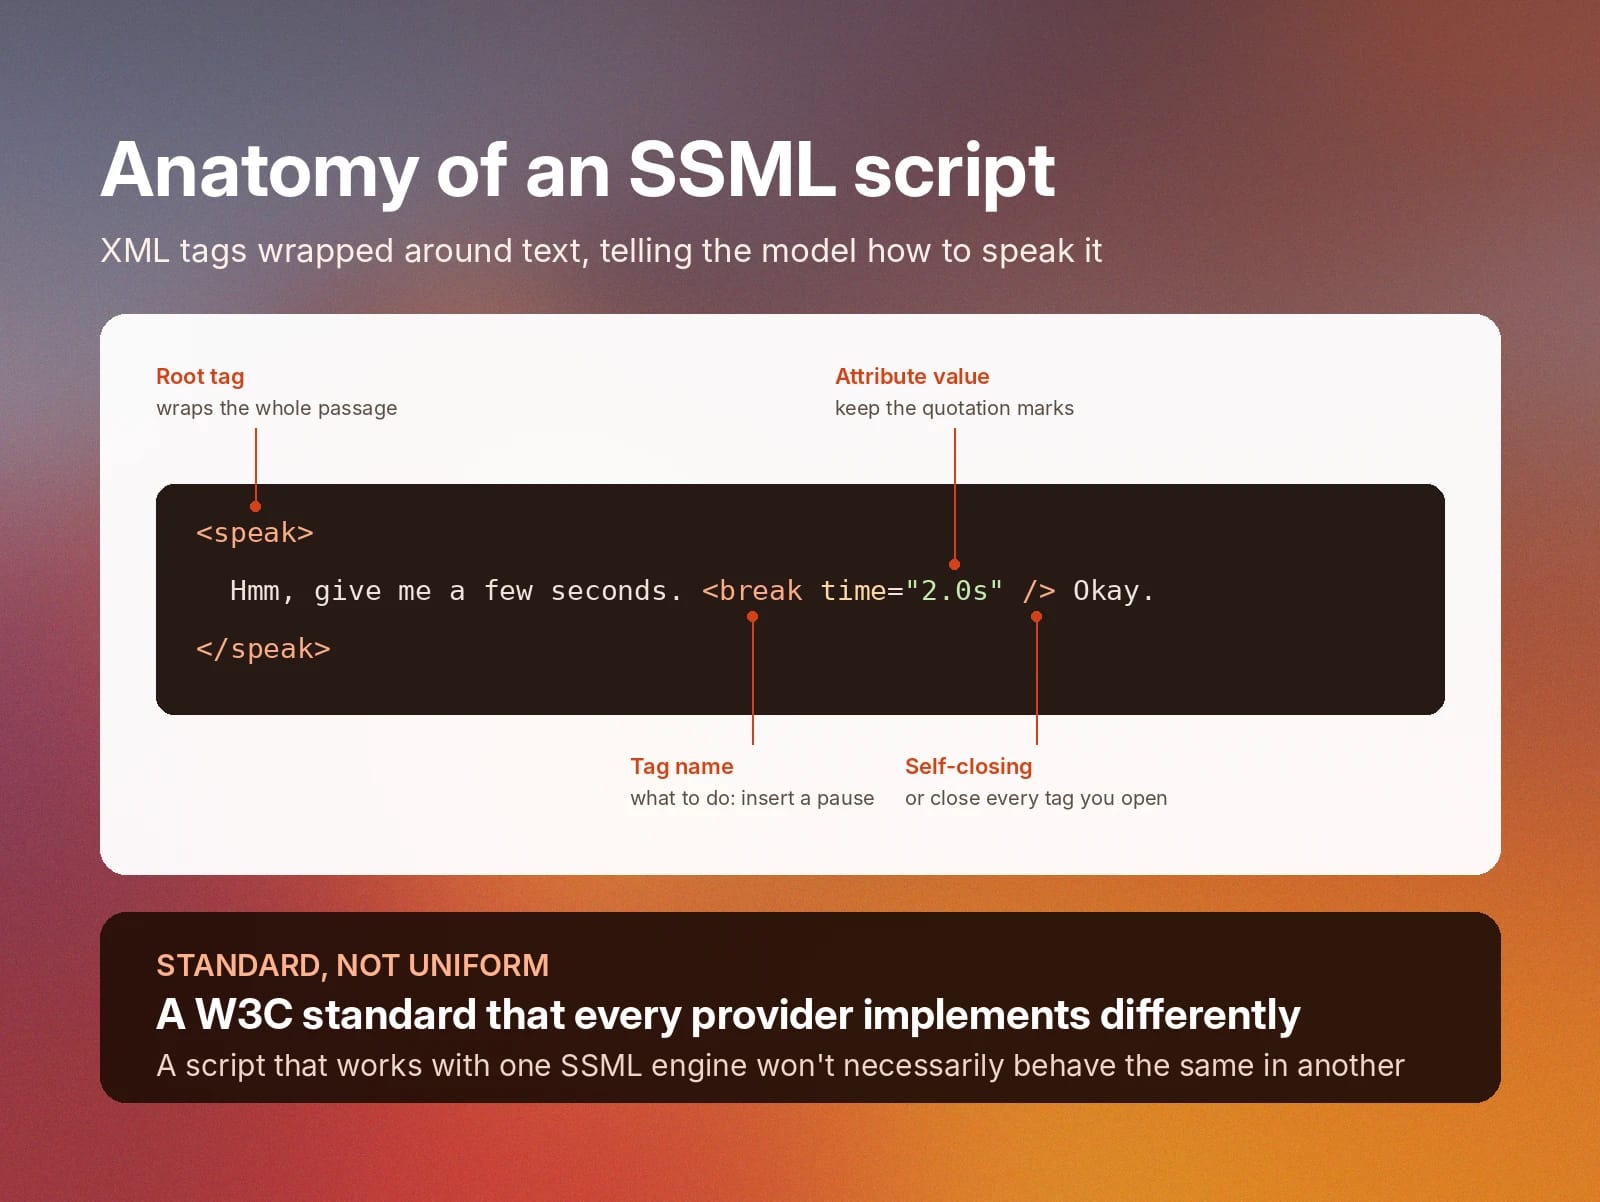
- <speak>: To tag główny, który obejmuje cały fragment. Większość implementacji wymaga go, aby rozpoznać zawartą treść jako SSML.
- <break>: Wstawia pauzę o określonym czasie trwania. Przydaje się do naturalnego frazowania między zdaniami lub częściami zdania albo do budowania napięcia w tekście.
- <phoneme>: Określa dokładną wymowę słowa za pomocą alfabetu fonetycznego, takiego jak IPA lub CMU Arpabet. Przydaje się przy skrótach, nazwach i terminach technicznych.
- <emphasis>: Akcentuje słowo lub frazę, naśladując naturalne wzmacnianie lub osłabianie znaczenia przez mówiącego.
Każdy z tych czterech tagów zachowuje się inaczej zależnie od modelu TTS, który go odczytuje. Niektórzy dostawcy obsługują dodatkowe tagi prozodii lub tempa mówienia. Skrypt napisany dla jednego dostawcy TTS nie będzie działał tak samo u innego, nawet jeśli obaj deklarują obsługę SSML, ponieważ zakres obsługiwanych tagów jest różny.
Najbardziej różni się to, które tagi dany model zamiany tekstu na mowę faktycznie przetwarza — i tu implementacja ElevenLabs ma własną specyfikę.
Korzystanie z SSML w ElevenLabs
Obsługa SSML w ElevenLabs nie jest w pełni jednolita. Zależy od modelu wybranego do generowania audio. Tag <break> jest obsługiwany najszerzej, a <phoneme> działa w węższym zestawie modeli.
Starsze modele TTS ElevenLabs, takie jak Multilingual v2, obsługują tag <break> dla pauz do trzech sekund. Na przykład agent AI może powiedzieć „Poczekaj, niech pomyślę”, a następnie użyć <break time="2.0s" />, aby utworzyć słyszalną pauzę przed kontynuacją: „Dobrze, już wiem, jak pomóc”. To najpopularniejszy tag w wielu workflow, ponieważ pomaga symulować bardziej naturalną rozmowę.
Przy używaniu tagów SSML najlepiej ograniczyć się do kilku naraz. Użycie wielu w jednym zdaniu lub akapicie może sprawić, że model nieoczekiwanie zmieni tempo albo wygeneruje różne artefakty audio. Różne głosy inaczej radzą sobie też z pauzami, zwłaszcza głosy trenowane na próbkach z wypełniaczami, takimi jak „eee” czy „yyy”.
SSML w praktyce z ElevenLabs
Modele ElevenLabs Flash v2 i Turbo v2 idą o krok dalej i obsługują też tag <phoneme> dla własnej wymowy, wyłącznie po angielsku. Dzięki temu tag phoneme przydaje się do poprawiania wymowy nazw, skrótów, terminów technicznych i innego słownictwa biznesowego. Dotyczy to skryptów uruchamianych na jednym z tych dwóch modeli.
Z kolei Eleven v3 i Eleven v4 całkowicie odchodzą od tego wzorca. Do kontroli sposobu wypowiedzi używają Audio Tags. Ponadto Eleven v4 wprowadza natywną obsługę IPA w tekście, dzięki czemu symbole IPA ujęte w ukośniki są odczytywane bezpośrednio. Poniżej wyjaśniamy, czym zastąpić tag break i inne mechanizmy kontroli wypowiedzi.
Pełny opis mechanizmów kontroli zamiany tekstu na mowę w ElevenLabs, w tym słowników wymowy i normalizacji tekstu, znajdziesz w przewodniku po najlepszych praktykach.
Przykłady kodu SSML w ElevenLabs
Poniższe przykłady pokazują SSML w skrypcie i wywołaniu API. Pamiętaj, że <break> działa na każdym modelu poza Eleven v4 i Eleven v3, a <phoneme> tylko na Flash v2 i Turbo v2 (wyłącznie po angielsku).
Implementacja SSML do kontroli głosu i dodania pauzy
Umieść tekst i tag w bloku <speak> oraz zachowaj cudzysłowy wokół wartości atrybutu:
Więcej informacji o pauzach i tagach fonemów SSML w ElevenAPI.
Popraw wymowę za pomocą <phoneme>
Użyj IPA lub CMU Arpabet, aby dokładnie zapisać brzmienie słowa. Tutaj nazwę „Siobhan” prowadzi IPA, a „Madison” opisano za pomocą CMU Arpabet:
Generowanie mowy z SSML w Pythonie
To wywołanie wysyła skrypt zawierający tag break do modelu, który go obsługuje:
Generowanie mowy z SSML w JavaScript
Poniżej znajdziesz podobny przykład generowania mowy z SSML, ale napisany w JavaScript.
SSML i WebSocket API
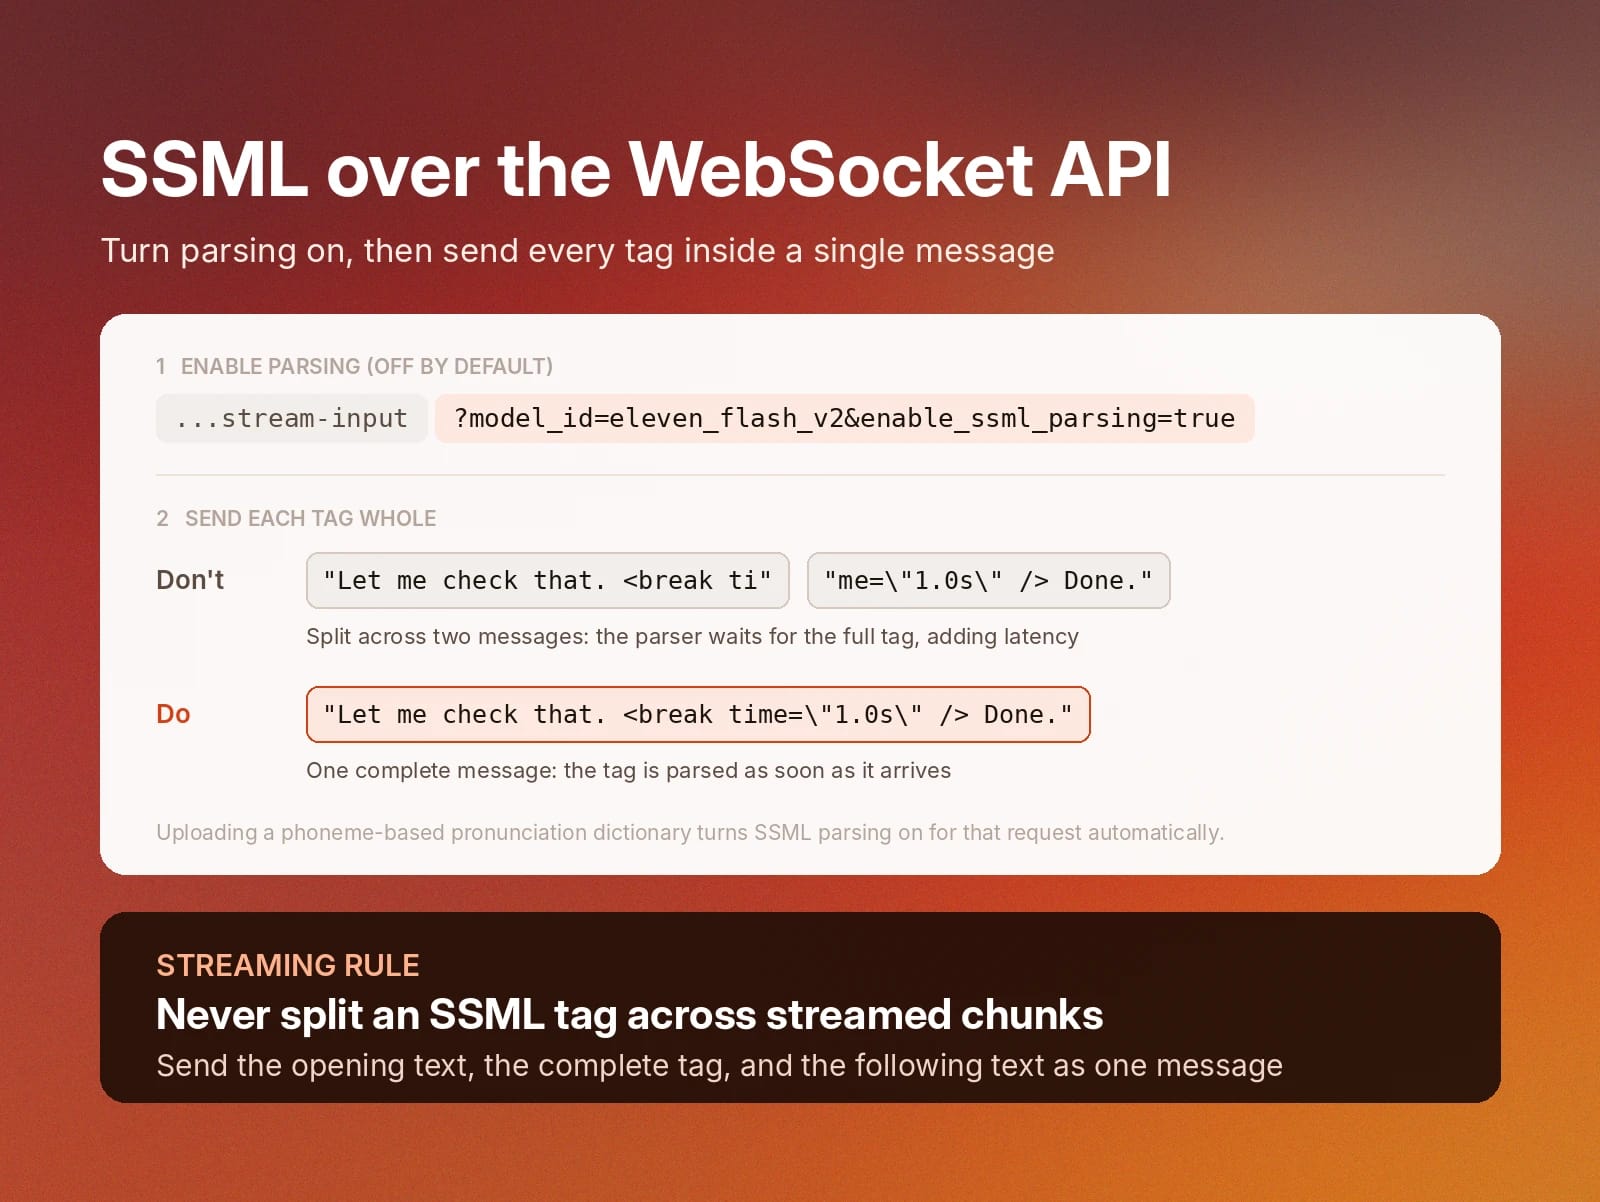
Strumieniowanie audio przez WebSocket API ElevenLabs zamiast standardowego żądania HTTP wymaga jawnego włączenia analizy SSML. Domyślnie jest ona wyłączona i można nią sterować parametrem enable_ssml_parsing.
Dla najlepszych wyników zalecamy wysyłanie każdego tagu SSML jako jednej kompletnej wiadomości, zamiast dzielić go między kilka przesyłanych fragmentów. Podzielenie tagu w środku wiadomości zwiększa opóźnienie, ponieważ parser potrzebuje pełnego tagu, zanim będzie mógł go przetworzyć.
Przesłanie opartego na fonemach słownika wymowy automatycznie włącza analizę SSML dla żądania, nawet jeśli parametr enable_ssml_parsing nie został ustawiony. Pełne informacje o parametrach i formatowaniu wiadomości w WebSocket API znajdziesz w dokumentacji dotyczącej generowania audio w czasie rzeczywistym.
Poniższy przykład włącza analizę SSML w adresie URL połączenia i wysyła cały tag break w jednej wiadomości:
Tagi SSML nieobsługiwane przez ElevenLabs i czym je zastąpić
Dzięki przejściu na system Audio Tags modele ElevenLabs Text to Speech dają użytkownikom większą elastyczność i szczegółową kontrolę nad generowanym audio. Audio Tags zapisuje się też w całości w języku naturalnym, więc łatwo dodać je do skryptów.
Jeśli pracujesz z wcześniejszym modelem ElevenLabs, warto wiedzieć, które tagi SSML są obsługiwane. Ze względu na dostępność preferowanych alternatyw starsze modele ElevenLabs przetwarzają obecnie tylko <break> i <phoneme>, a pozostałe tagi SSML zastępują inne metody.
Inne tagi SSML znane ze specyfikacji W3C nie są odczytywane jako znaczniki, dlatego każdy wymaga innego podejścia. Oto czym zastąpić pozostałe tagi SSML w ElevenLabs:
Tag SSML
Działanie
Czego użyć zamiast
<prosody>
Ustawia wysokość głosu, tempo mówienia i głośność
Ustawienia szybkości i stabilności głosu. W Eleven v3 i Eleven v4 — tagi audio wypowiedzi, takie jak [slowly] lub [rushed]
<emphasis>
Akcentuje słowo lub frazę
Wielkie litery lub interpunkcja dla podkreślenia. W Eleven v3 i Eleven v4 — tagi takie jak [shouts]
<say-as>
Kontroluje sposób odczytu liczb, dat i skrótów
Normalizacja tekstu, zapisanie wartości słowami lub reguła w słowniku wymowy
<sub>
Zastępuje zapisaną formę słowa jego formą mówioną
Reguła aliasu w słowniku wymowy
<lang>
Zmienia język dla frazy
Model wielojęzyczny i fraza zapisana w języku docelowym
<voice>
Zmienia mówiącego w środku skryptu
Osobne generowanie dla każdego głosu lub dialog wielu mówców w Eleven v3 i Eleven v4
<audio>
Wstawia nagrany plik audio lub dźwięk
Tagi audio efektów dźwiękowych w Eleven v3 i v4, narzędzie efektów dźwiękowych ElevenLabs lub miksowanie audio po generowaniu
Prozodia: wysokość głosu, tempo mówienia i głośność z SSML
Tag <prosody> w SSML dostosowuje wysokość głosu, tempo mówienia i głośność dla fragmentu tekstu. W starszych modelach ElevenLabs tempo kontrolujesz ustawieniem szybkości głosu, a ekspresję ustawieniem stabilności — oba działają na całe generowanie, a nie na pojedynczą frazę.
Aby zmienić tempo w skrypcie, podziel tekst na osobne generowania lub dodaj tagi <break> między zdaniami. W Eleven v3 i v4 użyj tagów Audio Tags z tabeli powyżej, takich jak [slowly], [rushed] i [whispers], umieszczając je bezpośrednio w tekście.
Wymowa: <phoneme>, <say-as> i <sub> z SSML
ElevenLabs oferuje trzy sposoby kontroli wymowy w wynikach TTS.
Oto główne metody:
- Użyj <phoneme> do jednorazowej poprawki w Flash v2 lub Turbo v2, jak w przykładzie powyżej.
- Użyj słownika wymowy dla terminów powtarzających się w wielu skryptach. Słownik może zawierać reguły fonemów oraz reguły aliasów działające jak <sub>, na przykład mapujące „UN” na „United Nations”.
- W przypadku tego, co obsługuje <say-as>, na przykład liczb, dat, walut i numerów telefonów, korzystaj z normalizacji tekstu, która zamienia zapisane wartości na słowa mówione. Gdy wartość musi być odczytana dokładnie w jeden sposób, na przykład numer potwierdzenia, zapisz ją słownie lub rozdziel cyfry spacjami w skrypcie.
Język i ustawienia regionalne
Tag <lang> w SSML oznacza frazę jako należącą do innego języka. Modele TTS ElevenLabs nie odczytują tego tagu. Zamiast tego wybierz model wielojęzyczny i zapisz frazę w języku, w którym ma zostać wypowiedziana.
Flash v2 i Turbo v2 działają tylko po angielsku, więc skrypty mieszające języki wymagają modelu wielojęzycznego, takiego jak Multilingual v2, Flash v2.5, Eleven v3 lub Eleven v4. Eleven v4 i v3 obsługują też tagi akcentu, takie jak [French accent], oraz transkrypcję IPA w ponad 70 językach.
Audio i efekty dźwiękowe
Tag <audio> w SSML odtwarza nagrany klip w odpowiedzi głosowej. ElevenLabs go nie obsługuje, ponieważ nasze modele TTS mogą generować nowe efekty dźwiękowe na podstawie promptów w języku naturalnym.
Aby dodać dźwięk bezpośrednio do mowy, po prostu wpisz tag efektu dźwiękowego, na przykład [applause] lub [door slamming], i zobacz, jak Eleven v4 i Eleven v3 go ożywiają. Jeśli potrzebujesz dłuższego lub bardziej szczegółowego projektu dźwiękowego, wygeneruj efekt dźwiękowy osobno i zmiksuj go ze ścieżką głosową w edytorze lub workflow produkcyjnym.
Najlepsze praktyki SSML w ElevenLabs
Jeśli pracujesz z jednym ze starszych modeli TTS ElevenLabs, tagi SSML są nadal częściowo obsługiwane. Pamiętaj, że w każdej chwili możesz przejść na Eleven v4, aby w pełni korzystać z Audio Tags — nie musisz wtedy już sprawdzać dokładnej składni tagów SSML.
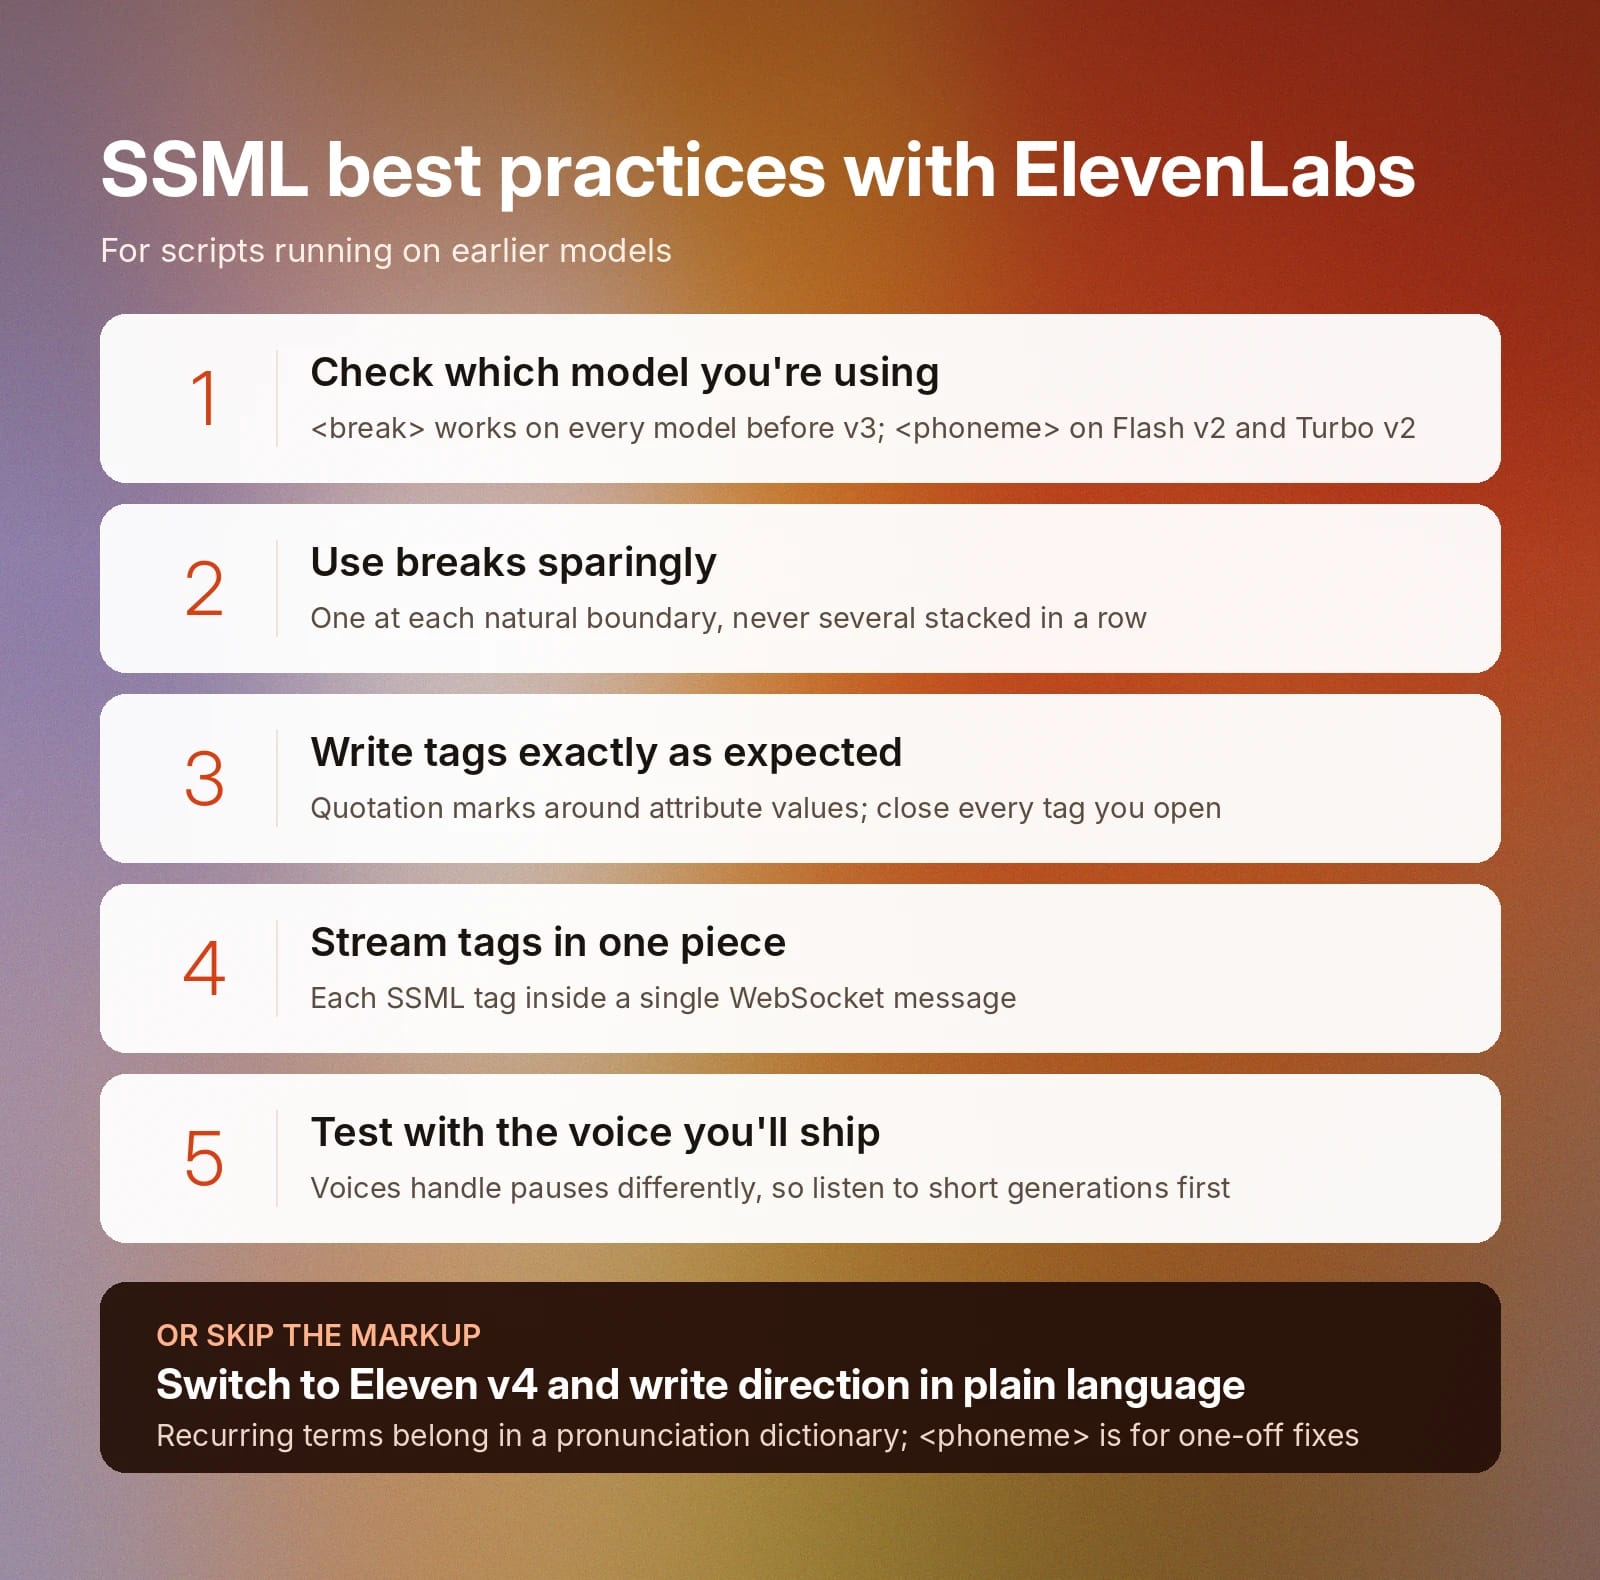
Podczas pracy z SSML w ElevenLabs skorzystaj z kilku wskazówek na początek:
- Sprawdź, którego modelu używasz: <break> działa na każdym modelu poza Eleven v3, <phoneme> tylko na Flash v2 i Turbo v2, a tagi audio tylko w nowszych modelach, takich jak Eleven v4 i Eleven v3.
- Używaj pauz oszczędnie: Wstawiaj jedną na każdej naturalnej granicy zamiast układać kilka z rzędu.
- Zapisuj tagi SSML prawidłowo: Zachowaj cudzysłowy wokół wartości atrybutów, na przykład <break time="2.0s" />, i zamykaj każdy otwarty tag.
- Przesyłaj tagi w całości: Wysyłaj każdy tag SSML w jednej wiadomości WebSocket.
- Testuj z głosem, którego użyjesz w produkcji: Głosy różnie obsługują pauzy, więc odsłuchaj krótkie generowania przed uruchomieniem całego skryptu. ElevenLabs oferuje ponad 17 500 głosów w naszej Voice Library.
Poza tymi najlepszymi praktykami SSML warto użyć słownika wymowy dla terminów, które będą pojawiać się często. Do jednorazowych poprawek <phoneme> jest najlepszą opcją.
Jakie są główne zastosowania SSML?
Speech Synthesis Markup Language służy głównie do kontrolowania lub dostrajania sposobu, w jaki silnik TTS tworzy klip audio. To przydatne narzędzie do wstawiania pauz, poprawiania wymowy wybranego słowa oraz nadawania prozodii mowie generowanej przez AI.
Oto kilka zastosowań SSML, w których ten standard się sprawdza:
- Systemy interaktywnej obsługi głosowej (IVR): Przydatne, gdy system IVR ma zrobić pauzę między komunikatem a menu lub wyraźnie odczytać liczby.
- Konwersacyjne agenty: Dodanie krótkiej pauzy przed odpowiedzią, aby wymiana brzmiała naturalnie.
- Audiobooki i długa narracja: Pauzy na końcach rozdziałów i między scenami, które wyraźnie oddzielają zakończone momenty od kolejnych.
- E-learning i szkolenia: Poprawianie wymowy nazw produktów, terminów technicznych, skrótów i pojęć specyficznych dla firmy.
- Powiadomienia i alerty: Kontrolowanie sposobu odczytu dat, godzin i kodów referencyjnych.
Choć SSML oferuje wiele zastosowań, wszystko to można osiągnąć za pomocą Audio Tags bez zapamiętywania i wstawiania do skryptów często złożonych tagów SSML. Eleven v4 i Eleven v3 stworzyły system Audio Tags, aby dać użytkownikom pełną kontrolę nad mową generowaną przez AI bez kłopotu z SSML.
Dlaczego Eleven v4 używa tagów audio zamiast SSML
Eleven v4 korzysta z Audio Tags jako innego mechanizmu kontroli wypowiedzi i dopracowywania wymowy. Odczytuje instrukcje w nawiasach kwadratowych bezpośrednio ze skryptu, dzięki czemu możesz pisać w języku naturalnym, aby uzyskać określony efekt. Te tagi audio obejmują szeroki zakres wskazówek, w tym:
- Emocje i uczucia, takie jak [sad] lub [excited]
- Sposób wypowiedzi i tempo, takie jak [whispers] lub [rushed]
- Ludzkie reakcje, takie jak [sighs] lub [laughs]
- Akcenty i głosy postaci, takie jak [French accent]
- Efekty dźwiękowe, w tym [applause] lub [door shutting]
Powód tego rozwiązania wynika ze sposobu, w jaki model odczytuje kontekst rozmowy. Architektura Eleven v4 analizuje kontekst głębiej niż wcześniejsze modele, dzięki czemu rozpoznaje sygnały emocjonalne, zmiany tonu, przejścia między mówcami i wskazówki kontekstowe bez osobnych parametrów czy ustawień.
SSML przekazuje konkretne instrukcje w ustalonym miejscu tekstu, przez co wypowiedź może brzmieć sztywno i nienaturalnie. SSML to jedna z głównych przyczyn, dla których tekst AI brzmi robotycznie, mimo wysokiej jakości modeli bazowych.
Wskazówka taka jak [whisper] daje Eleven v4 ogólną instrukcję interpretacyjną stosowaną w całej otaczającej linijce i kształtowaną przez prozodię wszystkiego wokół niej.
Większość elementów SSML ma bezpośredni odpowiednik w v4:
Tag SSML
Działanie
Odpowiedniki w Eleven v4
<break time="1s">
Wstawia pauzę
[pause], wielokropek lub nowa linia
<prosody rate="slow">
Spowalnia mowę
[drawn out] lub [slowly]
<prosody rate="fast">
Przyspiesza mowę
[rushed]
<emphasis>
Akcentuje konkretne słowo
[shouts] lub zapisanie słowa wielkimi literami
<prosody pitch="high">
Podnosi wysokość głosu
Tagi emocji, takie jak [excited]
<prosody pitch="low">
Obniża wysokość głosu
Tagi emocji, takie jak [sorrowful]
Wymowa podlega temu samemu schematowi zastępowania. IPA jest natywnie obsługiwane w Eleven v4, z transkrypcją w ponad 90 językach. Pozwala to zespołom kontrolować wymowę bez tagów XML, przez dodanie transkrypcji w ukośnikach bezpośrednio w tekście.
Zacznij tworzyć naturalnie brzmiącą mowę w ElevenCreative
Audio Tags dodają skryptom pauzy, emocje, tempo i styl głosowy, które aktor głosowy odczytałby bezpośrednio z tekstu. Eleven v4 przenosi tę ekspresję do pełnego workflow produkcyjnego, łącząc modele głosowe ElevenLabs z modelami obrazu i wideo, aby skrypt w jednym miejscu stał się gotowym nagraniem audio lub wideo.
Zobacz, jak Audio Tags przekładają się na gotowe audio w Eleven v4 lub utwórz bezpłatne konto, aby już dziś testować SSML i tagi audio na własnych skryptach.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.