Jak rozwiązać problemy z dokładnością zamiany tekstu na mowę
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Choć modele zamiany tekstu na mowę (TTS) są trenowane na ogromnych zbiorach danych głosowych i stale tworzą audio o wysokiej jakości, nadal mogą błędnie wymawiać słowa lub mieć inne problemy z mową. Do błędnej wymowy dochodzi, gdy silnik TTS napotyka słowa i wyrażenia spoza zakresu mowy obecnego w danych treningowych. Najczęściej dotyczy to żargonu branżowego, nazw marek i nazw własnych.
Silniki TTS mogą też tworzyć pospieszną, sztywną lub robotyczną mowę, gdy fragmenty tekstu są długie albo interpunkcja jest dostosowana do czytania, a nie do wypowiedzi na głos.
Podczas łączenia aplikacji z silnikami TTS przez API możesz też napotkać kilka typowych problemów technicznych.
W tym artykule omawiamy te trzy kategorie problemów i typowe sposoby ich rozwiązywania.
Podsumowanie
- Problemy z zamianą tekstu na mowę zwykle należą do jednej z trzech kategorii: błędna wymowa, nienaturalne tempo i rytm oraz techniczne błędy wykonania API.
- Błędy wymowy najskuteczniej poprawisz za pomocą słowników Pronunciation Lexicon Specification (PLS) zgodnych ze standardem W3C lub indywidualnie, używając tagów fonetycznych w skryptach.
- Naturalność mowy możesz kontrolować odpowiednim formatowaniem i interpunkcją skryptu. Tekst przygotowany do wypowiedzenia często różni się od tekstu przeznaczonego wyłącznie do czytania.
- Błędy API możesz diagnozować za pomocą standardowych kodów stanu HTTP.
- Wcześniejsze testowanie wymowy nazw marek, nazw własnych i nowych wyrażeń w izolacji może oszczędzić dużo późniejszego rozwiązywania problemów.
Dlaczego zamiana tekstu na mowę nie działa?
Problemy z zamianą tekstu na mowę można ogólnie podzielić na trzy kategorie.
Rodzaje problemów TTS
Błędna wymowa
Model TTS błędnie odczytuje nowe słowa lub wyrażenia, np. nazwę marki, żargon branżowy, akronimy lub homografy.
Nienaturalne brzmienie i rytm
Wygenerowana mowa jest monotonna, robi pauzy w dziwnych miejscach lub zbyt szybko przechodzi przez fragmenty wymagające wolniejszego tempa.
Błędy integracji i API
Twoja aplikacja nie generuje mowy z jednego lub kilku powodów technicznych, np. braku identyfikatorów głosu, limitów obciążenia lub nieprawidłowych kluczy API.
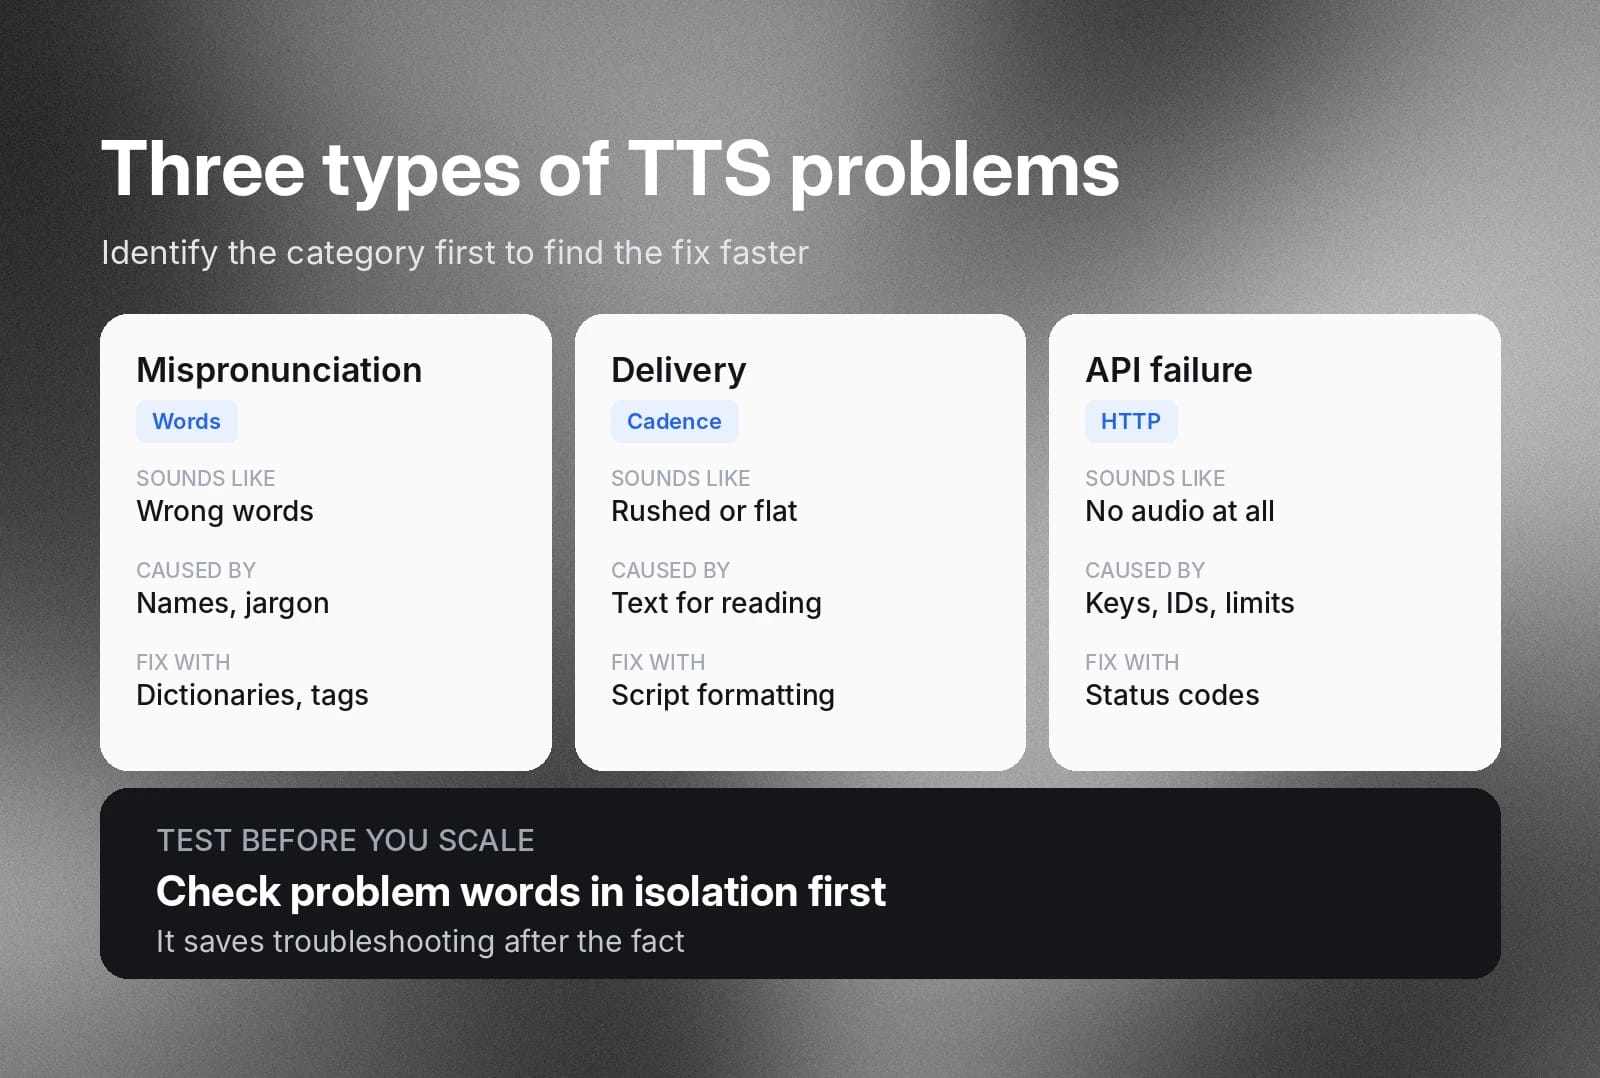
W tym przewodniku szczegółowo omawiamy każdy z tych trzech problemów, aby pomóc ci dokładnie zrozumieć, z jakim problemem jakości wyjścia lub problemem technicznym masz do czynienia. Dzięki temu szybciej znajdziesz właściwe rozwiązanie.
Jak rozwiązać problemy z dokładnością zamiany tekstu na mowę: błędna wymowa i nienaturalne brzmienie
Inżynierowie trenują nowoczesne neuronowe modele głosowe na ogromnych zbiorach danych mowy. Potrafią one generować naturalnie brzmiącą mowę w niemal niezliczonych kombinacjach słów. Żaden zbiór danych treningowych nie jest jednak uniwersalny. Zawsze znajdą się nietypowe wymowy oraz rzadkie słowa lub nazwy własne, których model nie wypowie poprawnie.
Nie zdarza się to często, ale każdy, kto regularnie korzysta z modeli TTS, powinien wiedzieć, jak sobie z tym radzić. Najpierw warto zrozumieć, skąd biorą się te błędy wymowy.
Najczęstsze przyczyny błędów mowy
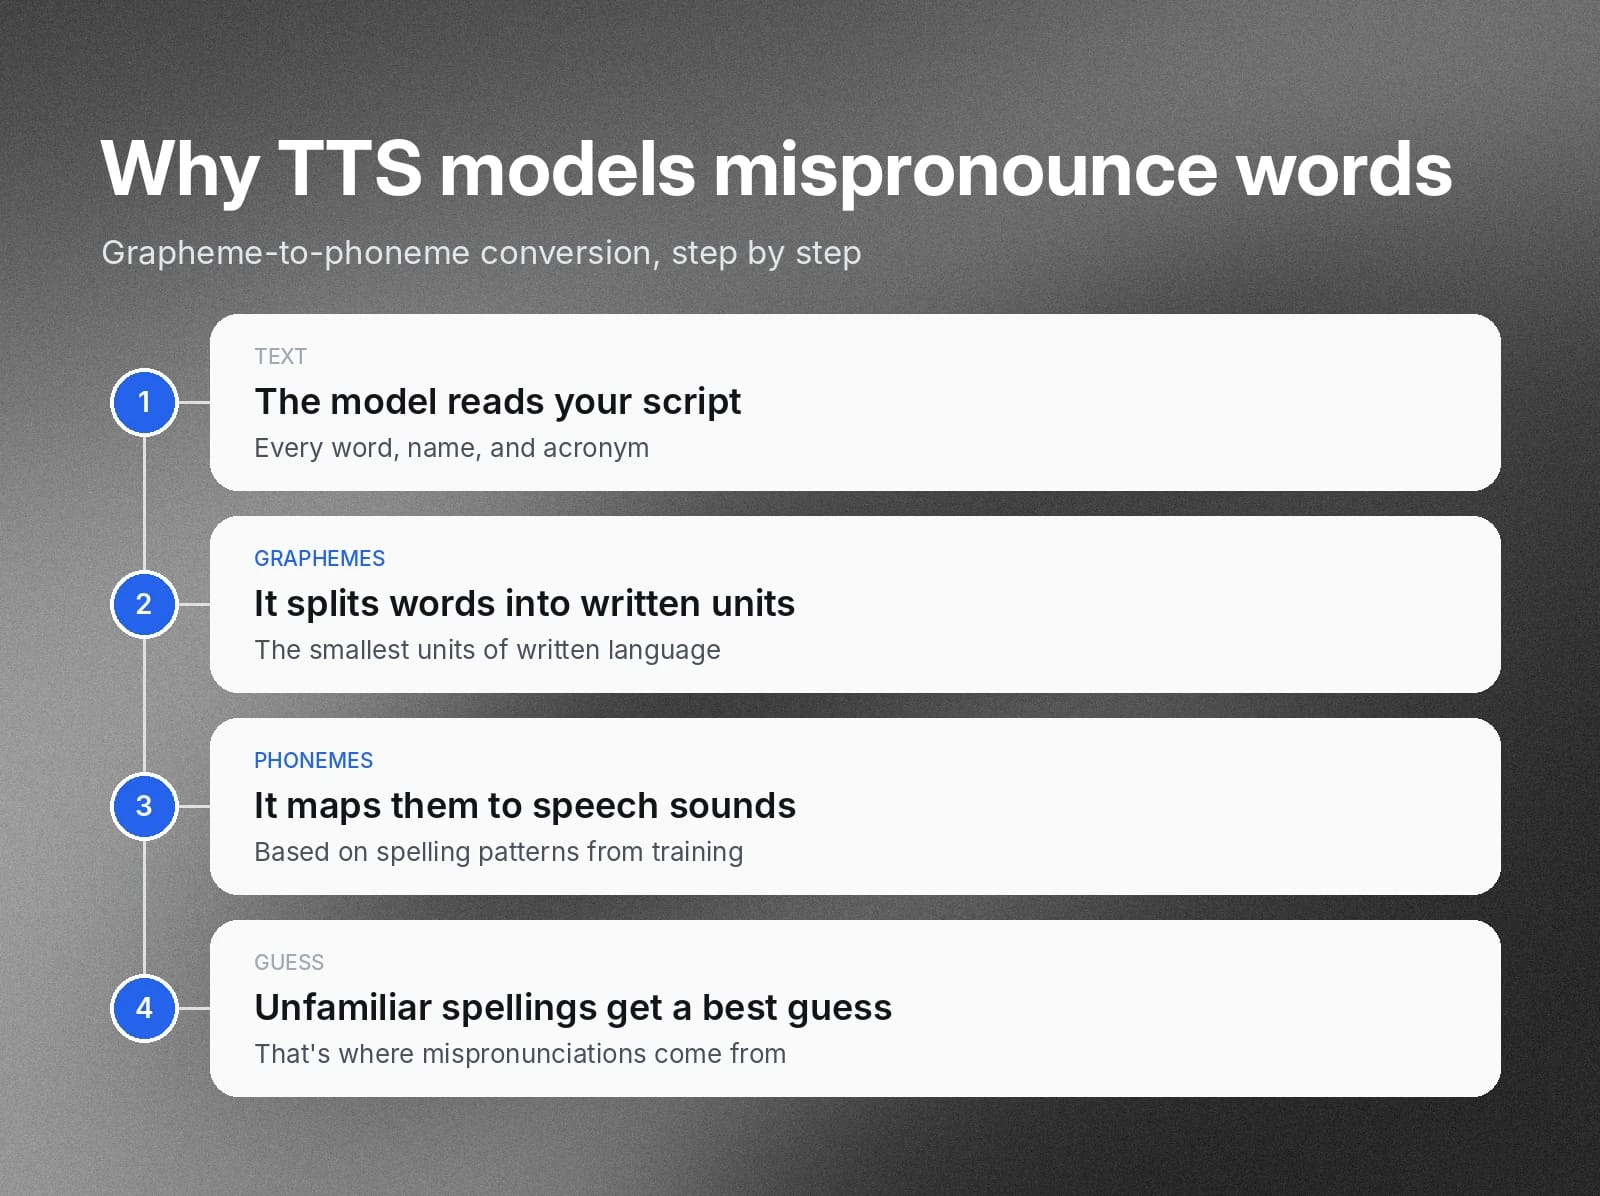
Modele syntezy mowy zamieniają tekst na mowę w procesie zwanym konwersją grafem-na-fonem (G2P). Fonemy to najmniejsze jednostki dźwięku mowy. Grafemy to najmniejsze jednostki języka pisanego, zwykle pojedyncze litery, które reprezentują fonem.
Gdy tekst wejściowy nie pasuje do wzorców pisowni, które model napotkał w danych treningowych, model zgaduje wymowę fonetyczną najlepiej, jak potrafi. Czasem prowadzi to do błędów wymowy.
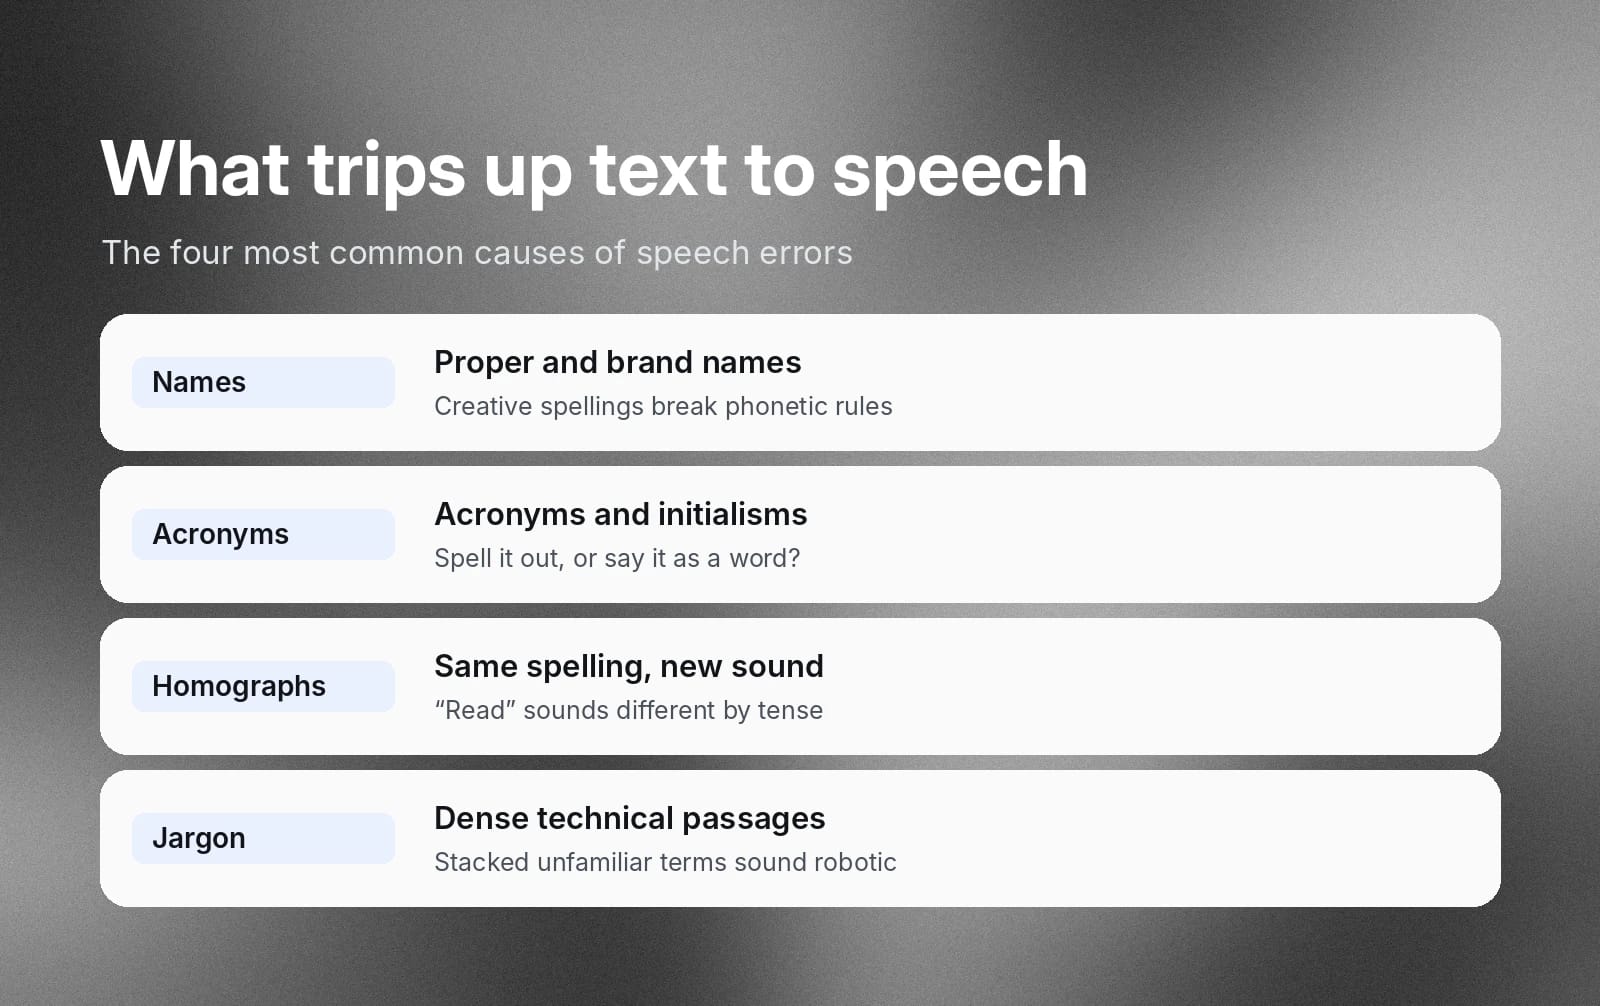
Nazwy własne i nazwy marek
Firmy często stosują kreatywną pisownię nazw marek. Przyciąga wzrok, ale często dezorientuje też modele syntezy mowy. Z tego samego powodu problematyczne mogą być również nietypowe imiona i nazwiska.
Gdy model napotyka nieznaną nazwę, próbuje zastosować podstawowe reguły fonetyczne, których się nauczył. Wygenerowana mowa może znacznie odbiegać od tego, czego oczekujesz.
Akronimy i skrótowce
Pomyśl o akronimie NASA. Wyobraź sobie, że nigdy wcześniej go nie widziałeś, tak jak model mowy. Wymówisz go „N.A.S.A.” czy „nasa”? A co z API oprogramowania? To „A.P.I.” czy „api”? A jeśli twoja firma sprzedaje zupełnie nowe narzędzie z nowym akronimem? Na pewno nie ma go w danych treningowych modelu mowy. Model musiałby więc zgadywać, jak ma go wymówić, chyba że podasz mu własne instrukcje.
Homografy
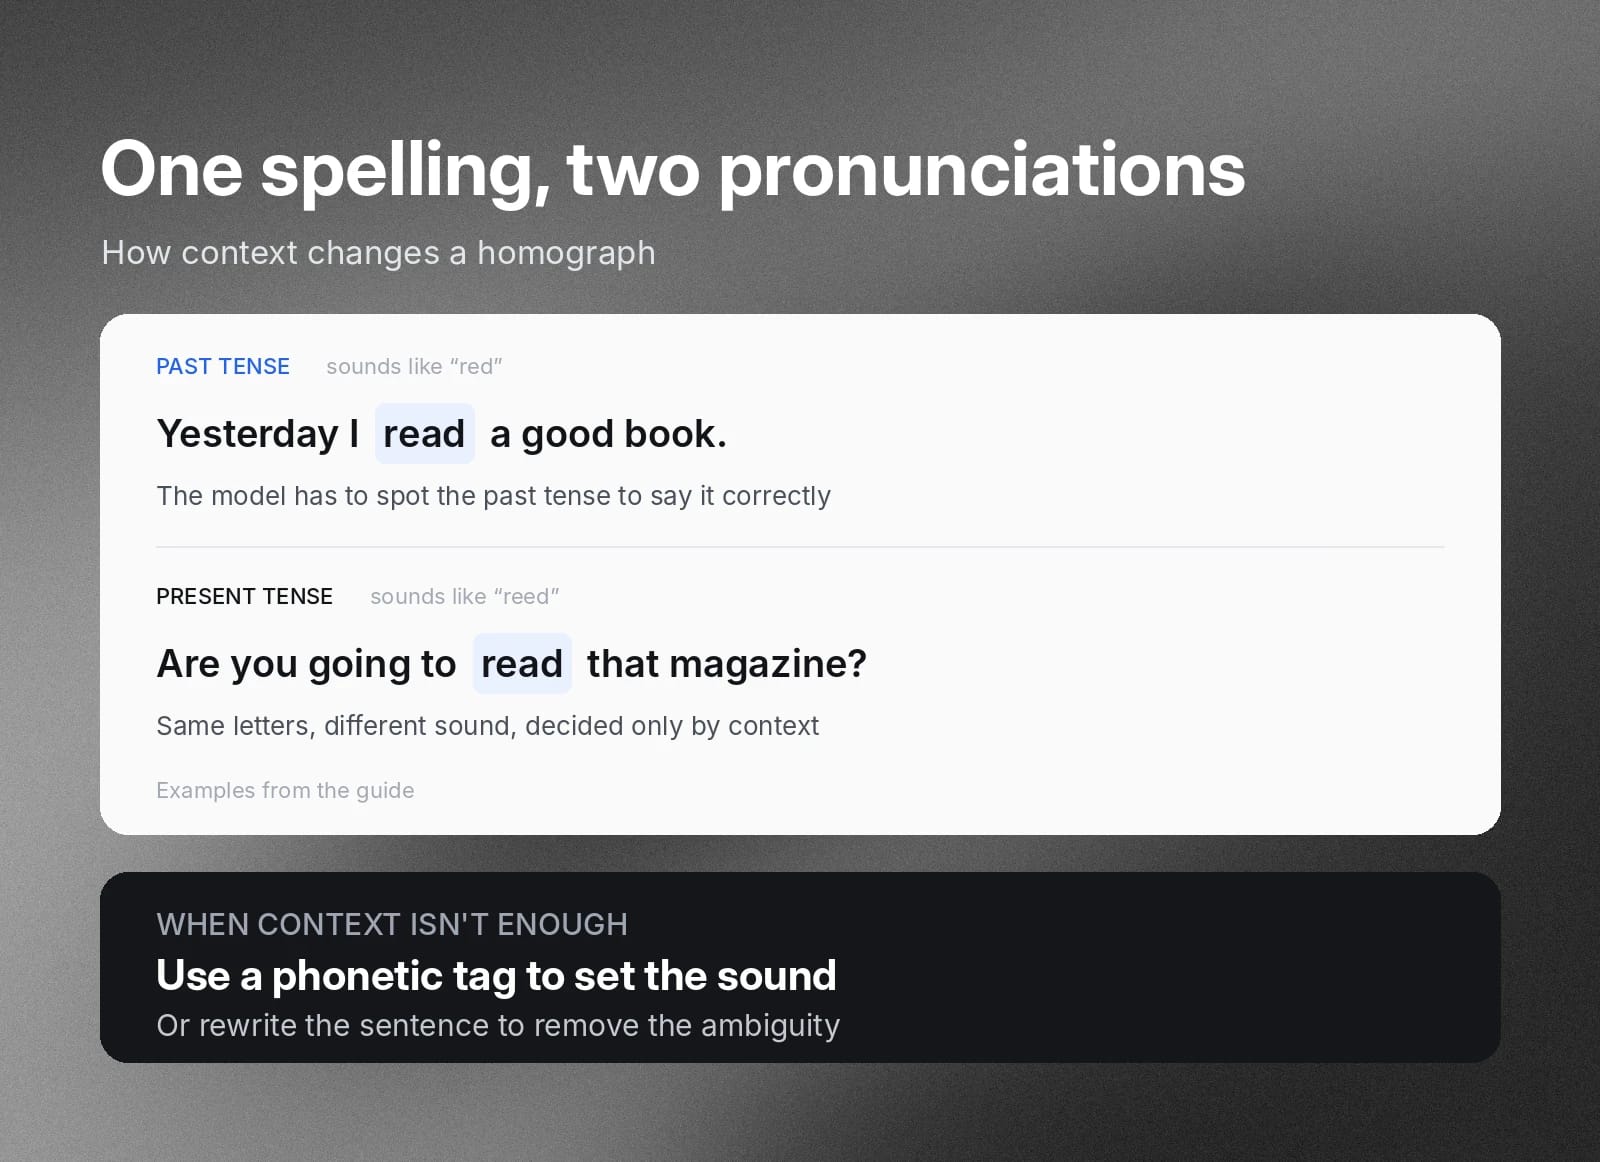
Homografy to słowa o tej samej pisowni, ale różnej wymowie zależnie od kontekstu. Na przykład angielskie słowo „read” zapisuje się tak samo, ale inaczej wymawia w czasie przeszłym i teraźniejszym.
- „Wczoraj przeczytałem dobrą książkę.”
- „Czy zamierzasz przeczytać ten magazyn?”
Model mowy potrzebuje wystarczającego zrozumienia kontekstu, aby wymawiać homografy zgodnie z twoimi oczekiwaniami.
Nienaturalne akcentowanie
Długie zdania pełne żargonu technicznego mogą szybko połączyć rzadkie słowa, konkretną wymowę i akronimy. Błąd, który sam w sobie byłby niezauważalny, może szybko stać się częścią płaskiej, robotycznej mowy, gdy model próbuje przetworzyć wiele nieznanych słów i sformułowań.
Dwa sposoby kontrolowania wymowy głosu
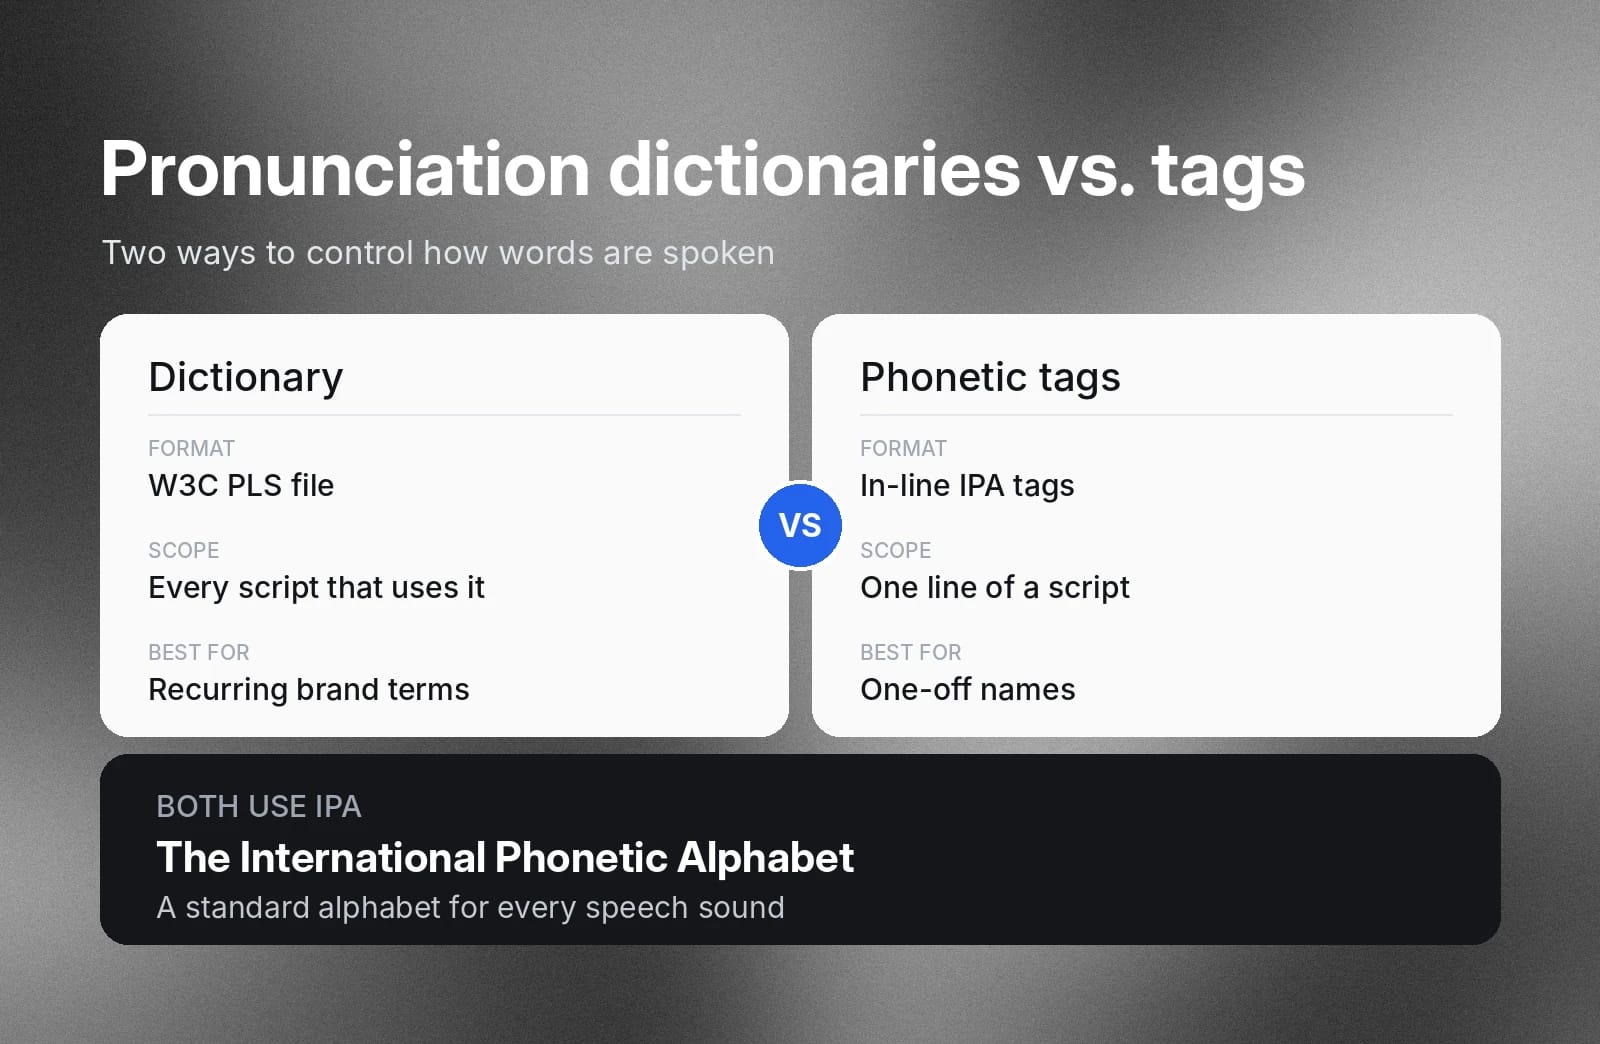
Nie musisz całkowicie przepisywać skryptów, aby uniknąć tych sytuacji. Nowoczesne neuronowe modele mowy oferują dwa narzędzia do skutecznego rozwiązywania ich w każdym przypadku: słowniki wymowy i fonetyczne tagi w skrypcie.
Słowniki wymowy dla zamiany tekstu na mowę
Słowniki sprawdzają się najlepiej, gdy masz zestaw własnych wymów, które regularnie powtarzają się w projektach TTS. Na przykład gdy twoja firma sprzedaje urządzenia medyczne, a skrypty często zawierają terminy techniczne, procedury medyczne i inne treści specyficzne dla branży.
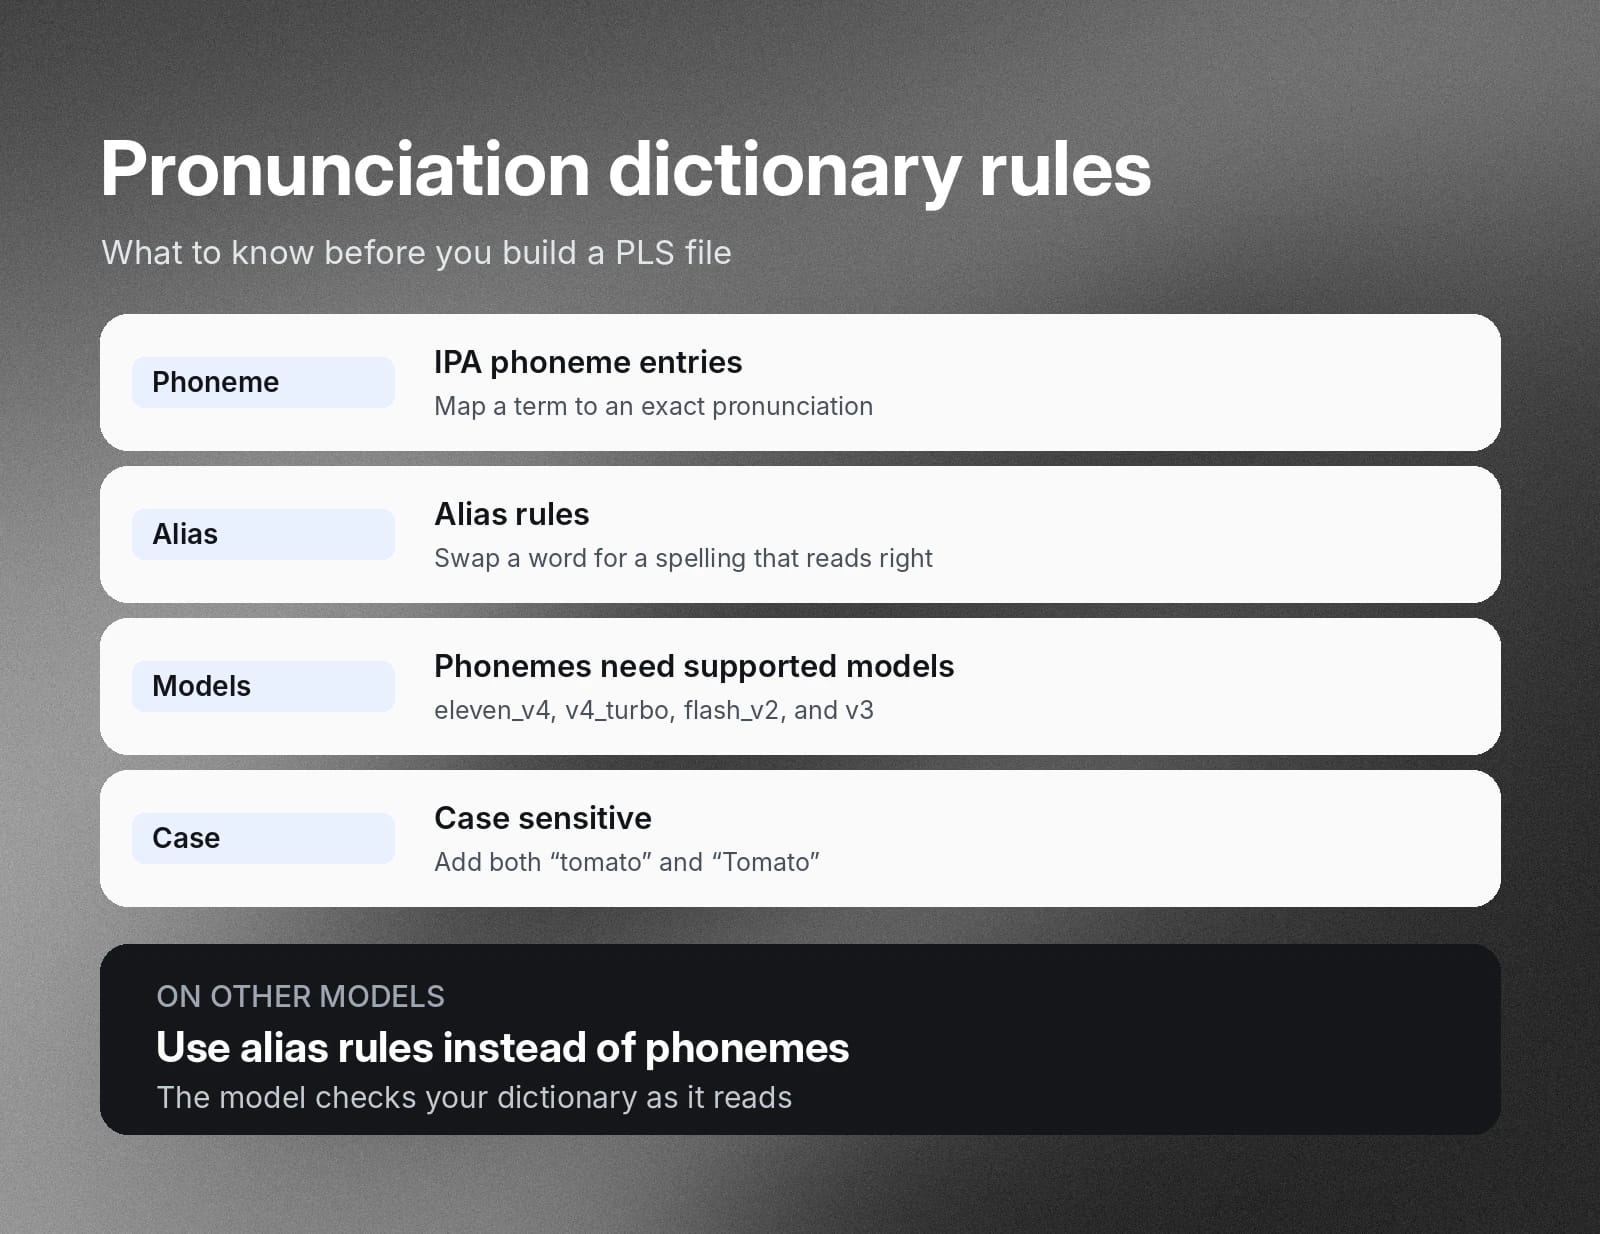
Format Pronunciation Lexicon Specification (PLS), zgodny ze standardem W3C, pozwala przypisać tym terminom konkretną wymowę fonetyczną za pomocą notacji Międzynarodowego Alfabetu Fonetycznego (IPA). Międzynarodowy Alfabet Fonetyczny to ustandaryzowany alfabet wszystkich możliwych dźwięków mowy. Model mowy sprawdza słownik podczas czytania skryptu i korzysta z podanych wymów, gdy napotyka zawarte w nim słowa. Wpisy fonemów działają tylko z modelami eleven_v4, eleven_v4_turbo, eleven_flash_v2 i eleven_v3. W innych modelach użyj reguł aliasów. W plikach PLS wielkość liter ma znaczenie, więc dodaj zarówno „tomato”, jak i „Tomato”, jeśli potrzebujesz obu form.
Fonetyczne tagi w skrypcie
Tagi fonetyczne są zwykle lepszym wyborem, gdy chcesz poprawić pojedyncze linie skryptu. Zamiast tworzyć słownik, używasz tagów fonetycznych w tekście, które wskazują modelowi mowy, jak ma wymówić dane słowo zgodnie z IPA.
Załóżmy na przykład, że piszesz skrypt podcastu i chcesz dwa lub trzy razy wspomnieć ekspertkę z branży. Zamiast dodawać ją do firmowego słownika wymowy, po prostu oznaczasz jej nazwisko poprawną wymową w miejscu, w którym pojawia się w skrypcie.
Pisz i formatuj skrypty tak, by naturalnie brzmiały na głos
Słowniki i tagi pomagają rozwiązywać problemy z pojedynczymi słowami w wygenerowanej mowie, ale nie wpływają na ogólne brzmienie, rytm i dynamikę wypowiedzi. Pisząc skrypt, pamiętaj, że będzie on wypowiadany na głos. Dobór słów, sformułowania i interpunkcja często powinny różnić się od tekstu przeznaczonego wyłącznie do czytania.
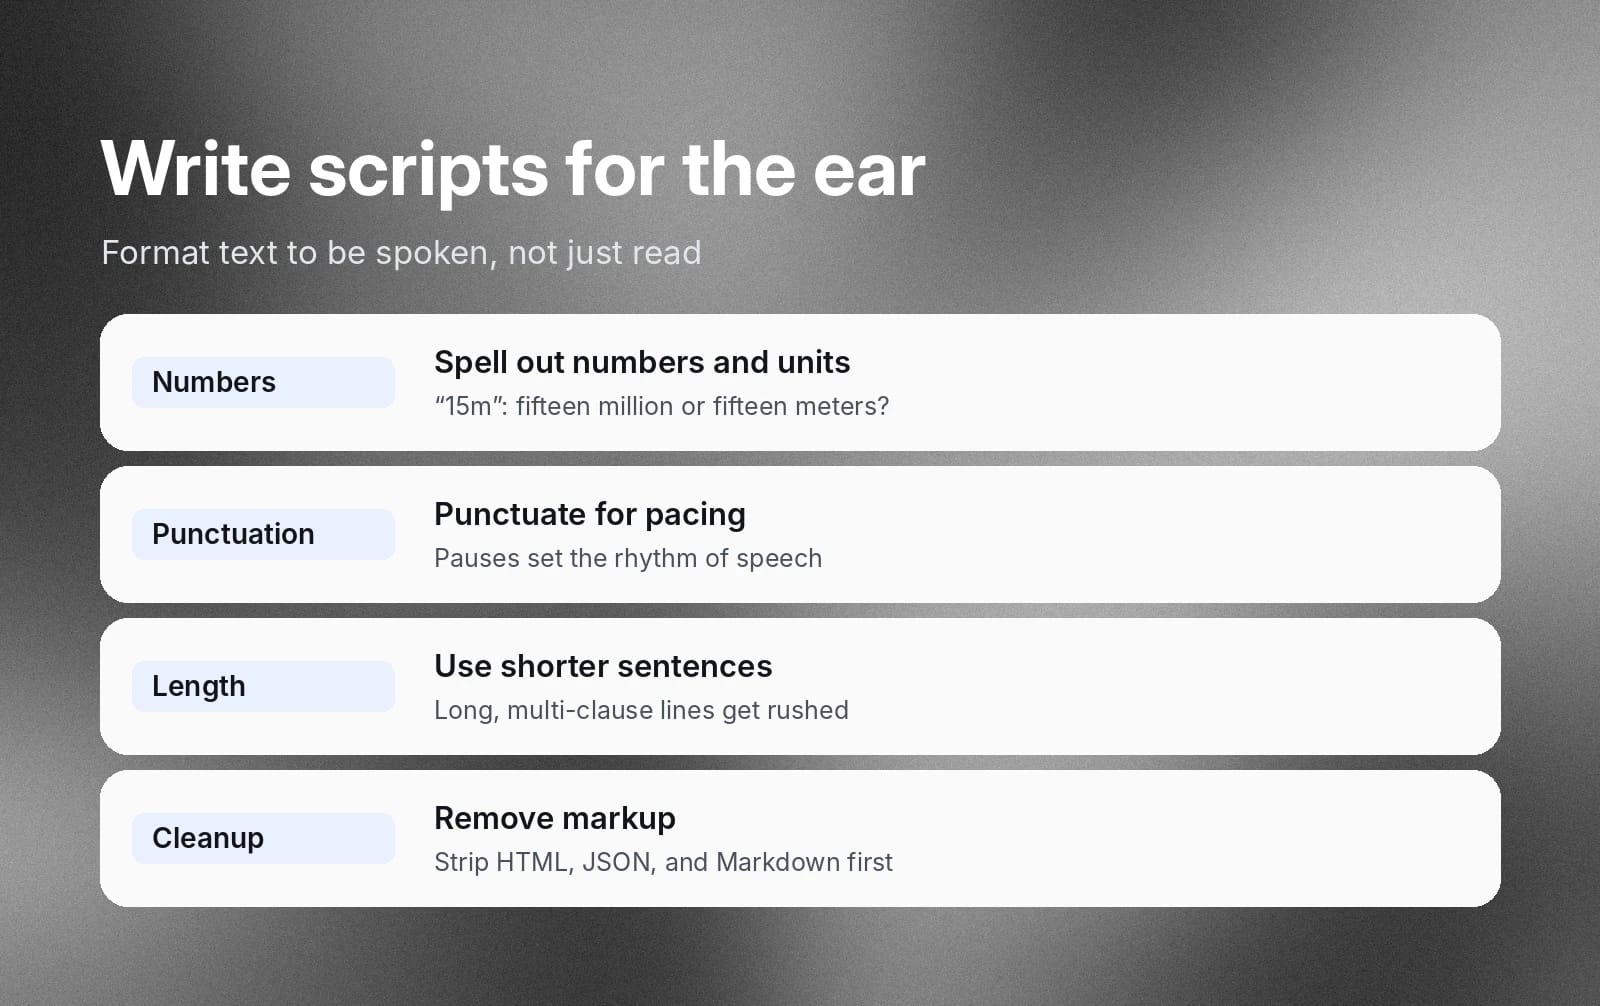
Pisz dla ucha, nie dla oka
Pisz skrypt jak autor przemówienia: „Jak chcę, aby to zabrzmiało na głos? Gdzie zrobić pauzę dla efektu? Gdzie przyspieszyć?” Te pytania są równie ważne dla skryptu dla zaawansowanych neuronowych modeli mowy, jak dla tekstu pisanego dla człowieka.
Zapisuj liczby, waluty i daty słownie
Nie pozostawiaj w skryptach żadnej dwuznaczności. Neuronowe modele mowy dobrze rozumieją kontekst, ale działają najlepiej, gdy nie muszą zgadywać. Skróty i zapis skrótowy to częste elementy, na których mogą się potknąć.
Na przykład w skrypcie może znaleźć się zdanie: „Szukasz wartości zbliżonej do 15m”. Czy autor chce, by silnik TTS powiedział „piętnaście milionów” czy „piętnaście metrów”? Zapisz to wprost, aby model nie musiał zgadywać na podstawie kontekstu.
Używaj zwykłej interpunkcji do kontrolowania tempa
Interpunkcja odgrywa ważną rolę w tekście pisanym, ale w syntezie mowy jest jeszcze ważniejsza. Kontroluje rytm. Określa różne rodzaje pauz, którymi możesz rozdzielać złożone myśli lub po prostu utrzymać naturalny rytm wygodniejszy dla słuchacza.
- Używaj przecinków do krótkich pauz w środku zdania.
- Używaj kropek, aby zakończyć myśl.
- Używaj wielokropków i półpauz, aby dodać pauzę w środku złożonych myśli, dzięki czemu model nie zabrzmi pospiesznie.
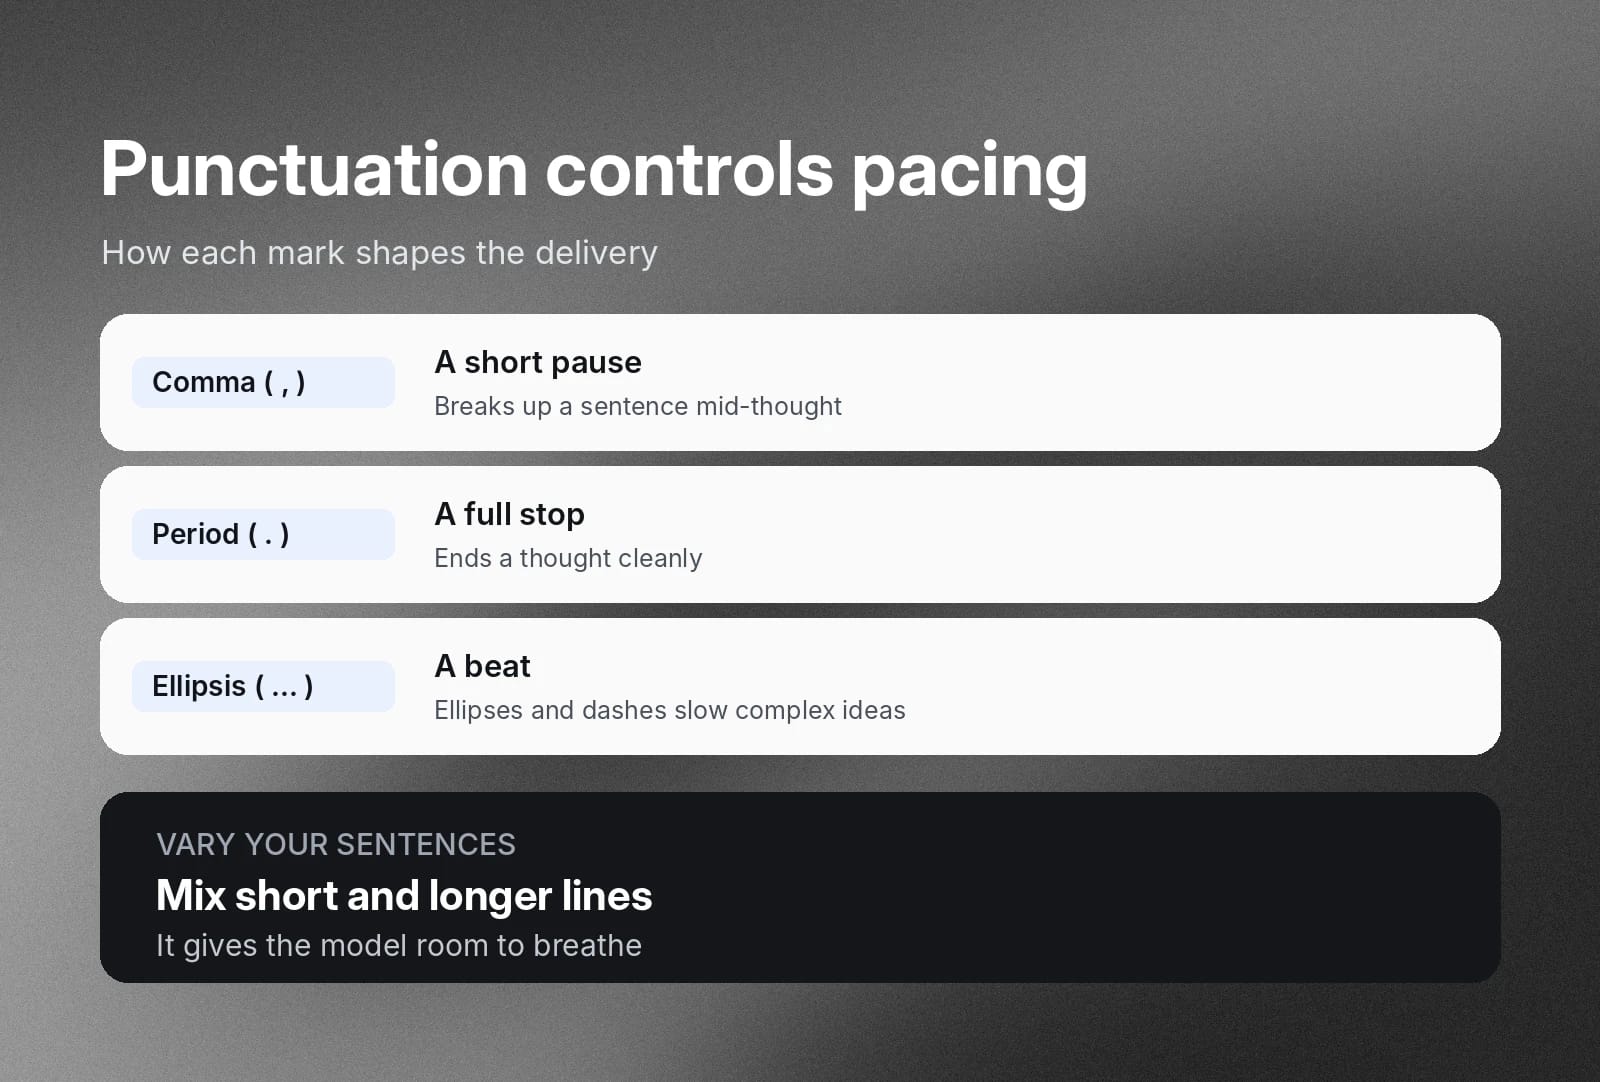
Krótkie zdania są lepsze
Modele najczęściej potykają się lub przyspieszają przy długich, warunkowych zdaniach wielokrotnie złożonych. Podziel je na krótsze zdania o różnej długości. Daje to modelowi więcej przestrzeni i zapobiega pośpiechowi, gdy próbuje znaleźć rytm dla długich, rozwlekłych zdań.
Usuń formatowanie i pozostałości Markdown
Jeśli syntezujesz mowę z tekstu pobranego z systemu zarządzania treścią lub innego systemu biznesowego, może on zawierać HTML, JSON, Markdown albo inne formatowanie. Usuń je i użyj zwykłego tekstu, aby uzyskać najbardziej naturalne brzmienie. Modele mowy mogą mieć trudność z rozpoznaniem, kiedy ignorować te tagi, czytać je dosłownie lub uwzględniać je w kontekście w odpowiedzi.
Więcej o błędnej wymowie i innych problemach przeczytasz w przewodniku rozwiązywania problemów ElevenLabs.
Rozwiązywanie typowych błędów API ElevenLabs
Zespoły tworzące audio głosowe na dużą skalę zwykle łączą aplikacje z modelem syntezy mowy przez API. To zwiększa efektywność produkcji, ale dodaje warstwę techniczną, którą trzeba zarządzać obok wyników generowanych przez model.
Dokumentacja kodów błędów API ElevenLabs szczegółowo opisuje kody odpowiedzi, ale poniżej znajdziesz cztery najczęstsze kody stanu HTTP podczas rozwiązywania problemów z integracjami zamiany tekstu na mowę oraz sposoby ich obsługi.
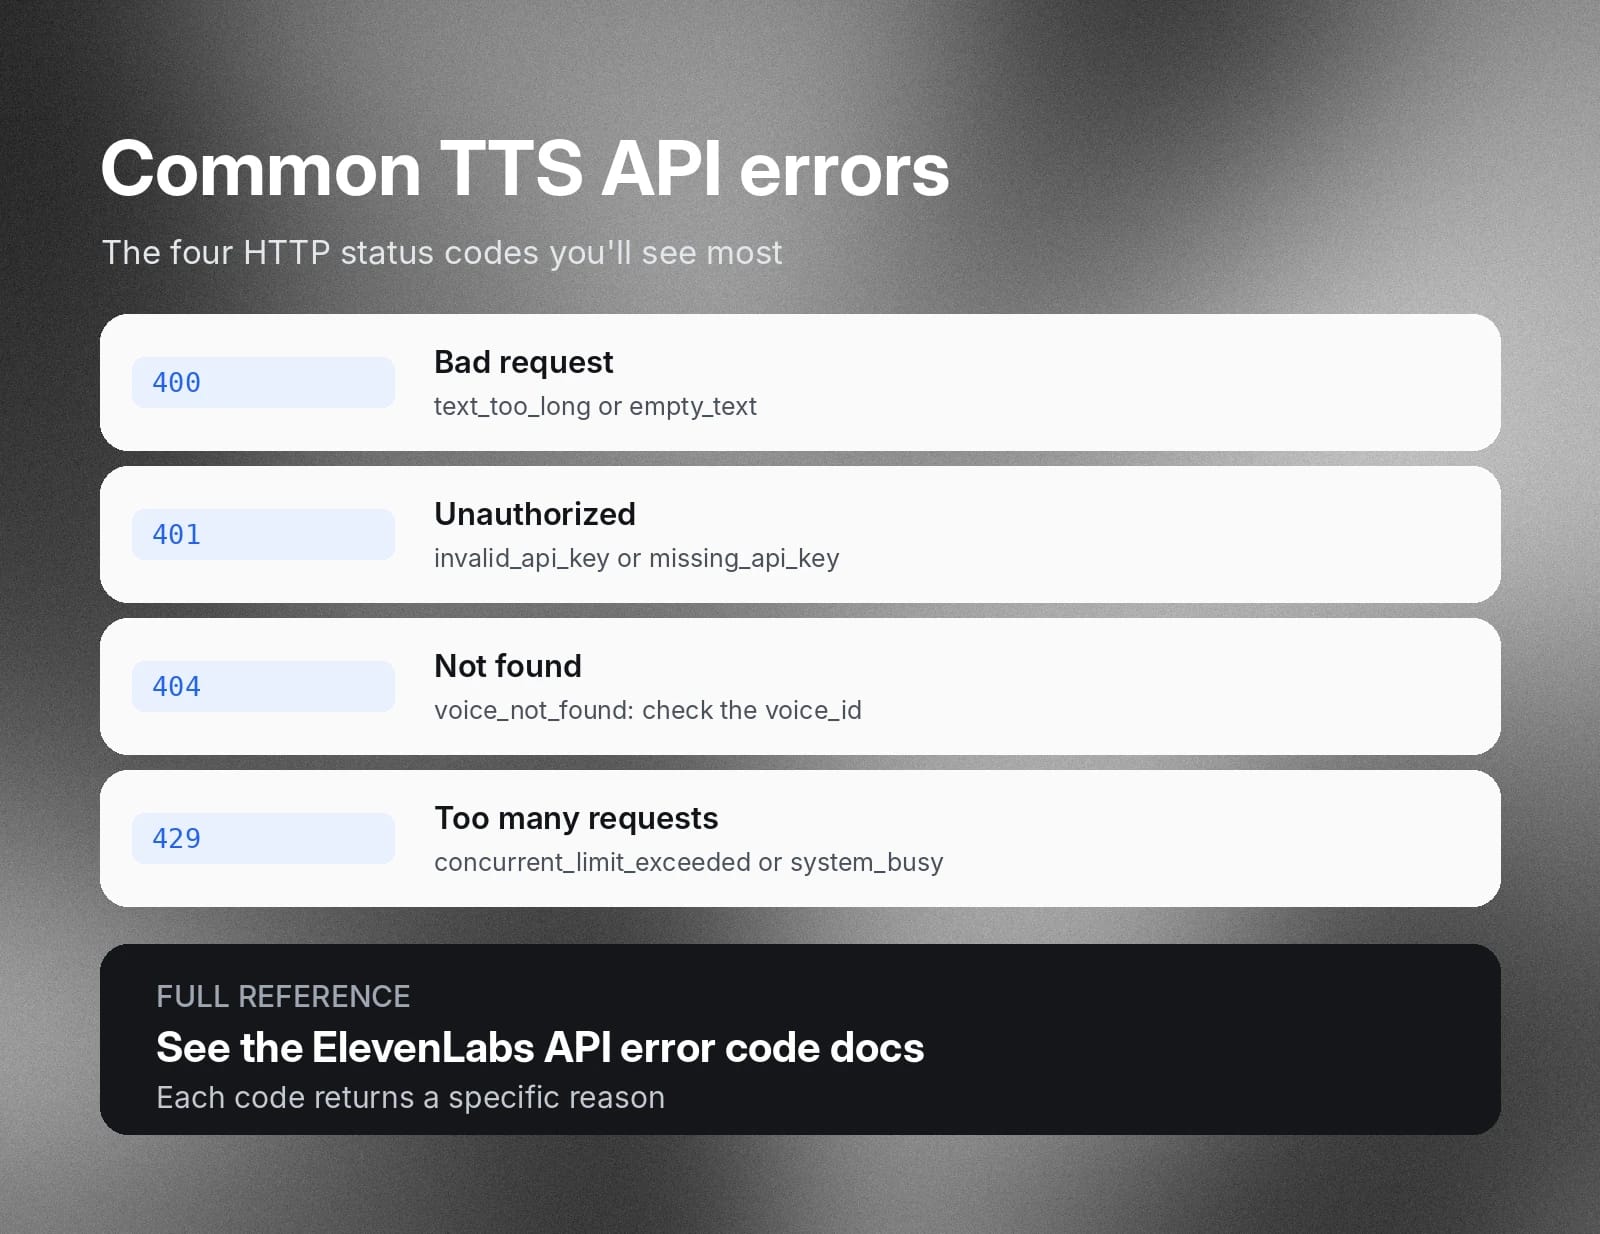
400 Bad Request (błędy payloadu)
Odpowiedź z kodem 400 z API modelu mowy oznacza, że aplikacja wysłała dane, których model nie mógł przetworzyć. W workflow TTS zwykle wynika to z przekroczenia limitów znaków lub przypadkowego wysłania pustych danych wejściowych.
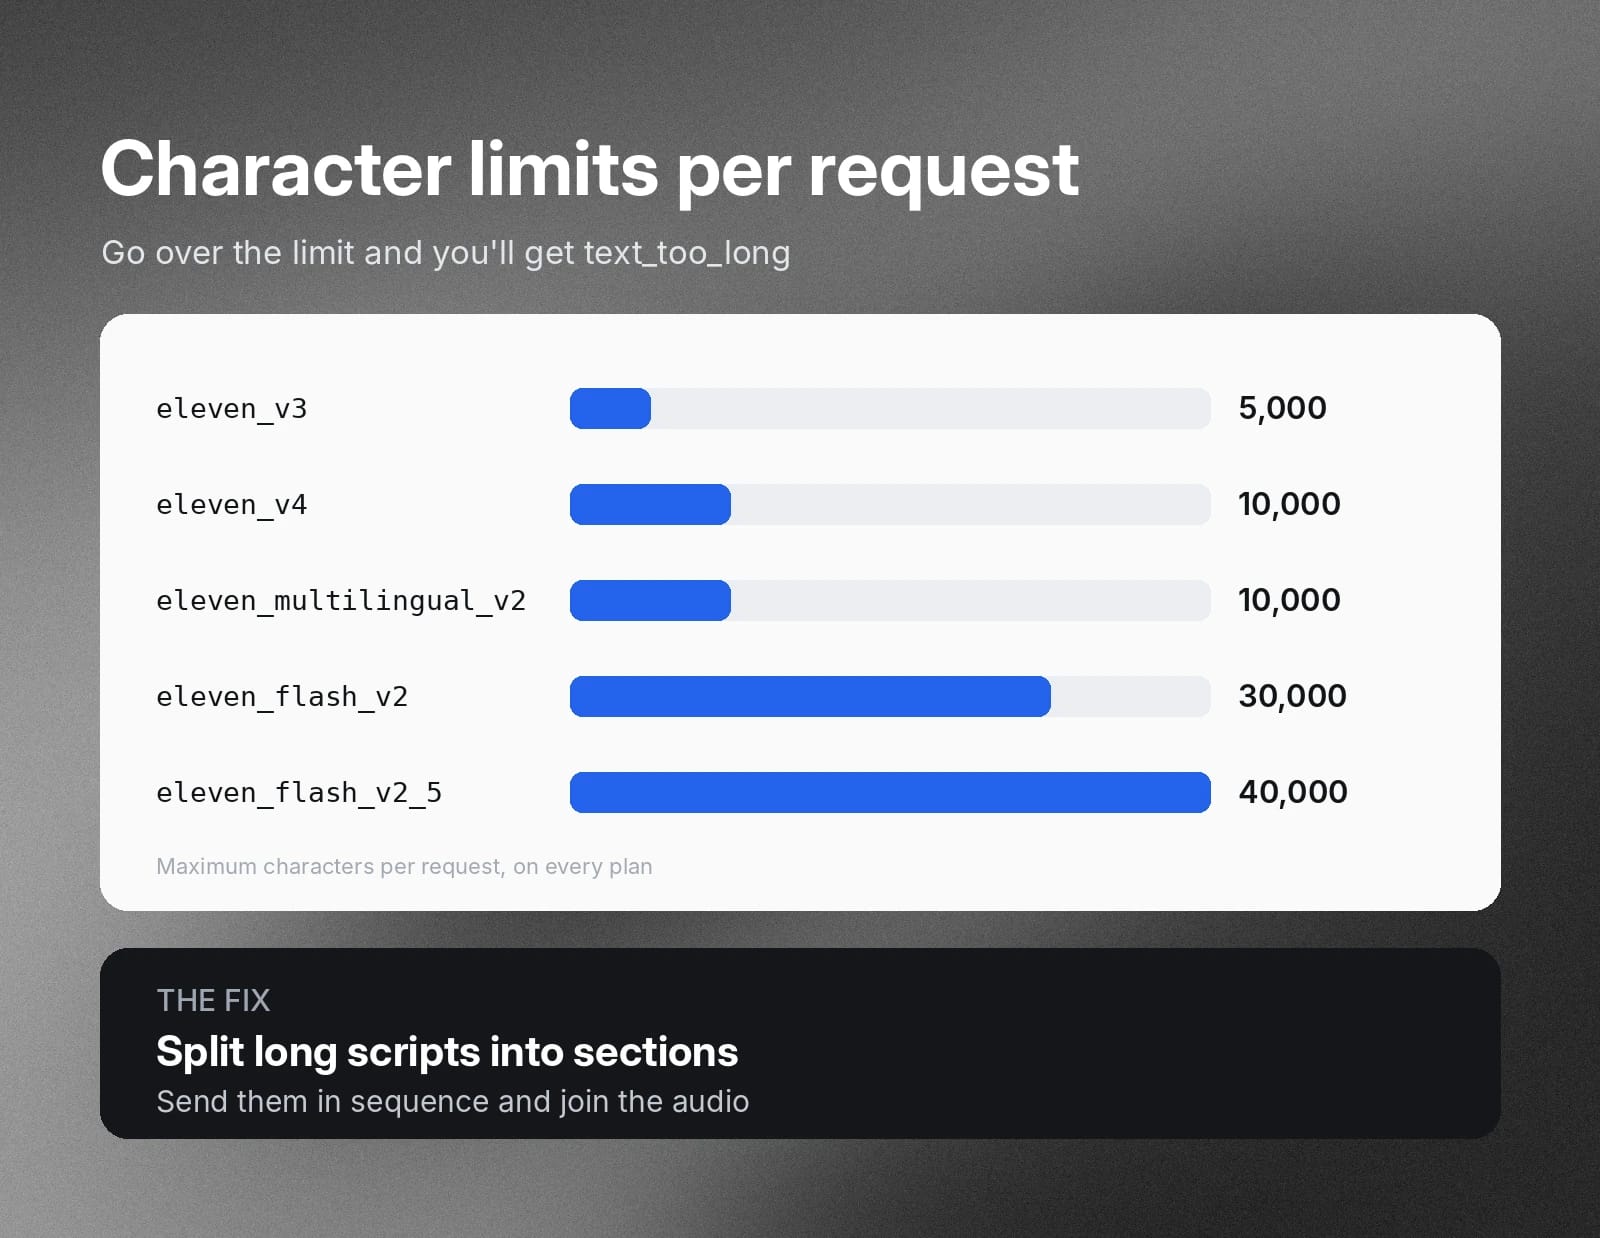
Przekroczony limit znaków (text_too_long)
Każde wysyłane żądanie TTS ma limit znaków określony przez model. Jeśli wyślesz więcej tekstu, niż pozwala limit modelu, serwer TTS zwróci ten błąd. Limity na żądanie wynoszą 10 000 znaków dla eleven_v4 i eleven_multilingual_v2, 5000 dla eleven_v3, 30 000 dla eleven_flash_v2 oraz 40 000 dla eleven_flash_v2_5 — w każdym planie. Aby rozwiązać ten problem, podziel dłuższe skrypty na kilka części, które model może przetwarzać kolejno.
Pusty tekst wejściowy
Silnik TTS odrzuci każdy payload zawierający puste ciągi znaków (empty_text). Dodaj kroki czyszczenia do procesu przetwarzania danych wejściowych, aby usuwać puste linie i zapobiec odrzuceniu poprawnego poza tym payloadu przez serwer.
401 Unauthorized (problemy z uwierzytelnianiem)
Kod błędu 401 oznacza, że brama API odrzuciła twoje dane uwierzytelniające, a payload nie trafił do modelu. Dzieje się tak, gdy występuje problem z kluczem API.
Nieprawidłowy klucz API
Twoje żądanie do serwera modelu musi zawierać prawidłowy xi-api-key. W przeciwnym razie serwer zwróci błąd 401. Sprawdź, czy klucz rzeczywiście znajduje się w żądaniu oraz czy nie został unieważniony, nie wygasł ani nie został skrócony w nagłówkach podczas wdrożenia. API zwraca invalid_api_key, gdy klucz jest nieprawidłowy, oraz missing_api_key, gdy nie wysłano żadnego klucza.
404 Not Found (niezgodne identyfikatory głosu)
Błąd 404 otrzymasz, gdy endpoint nie znajdzie zasobu TTS wskazanego w żądaniu URL. Może się tak zdarzyć, jeśli wyślesz nieprawidłowy parametr voice_id albo brakuje go w adresie URL żądania. Upewnij się, że masz właściwy voice_id. Sprawdź, czy faktycznie znajduje się w parametrach ścieżki i czy nie ma w nim literówki. API zwraca voice_not_found, gdy identyfikator głosu nie istnieje.
429 Too Many Requests
Ten błąd ma dwie różne przyczyny: osiągnięto limit równoczesnych żądań dla twojego planu lub platforma TTS ogranicza żądania, aby obsłużyć nagły wzrost ruchu.
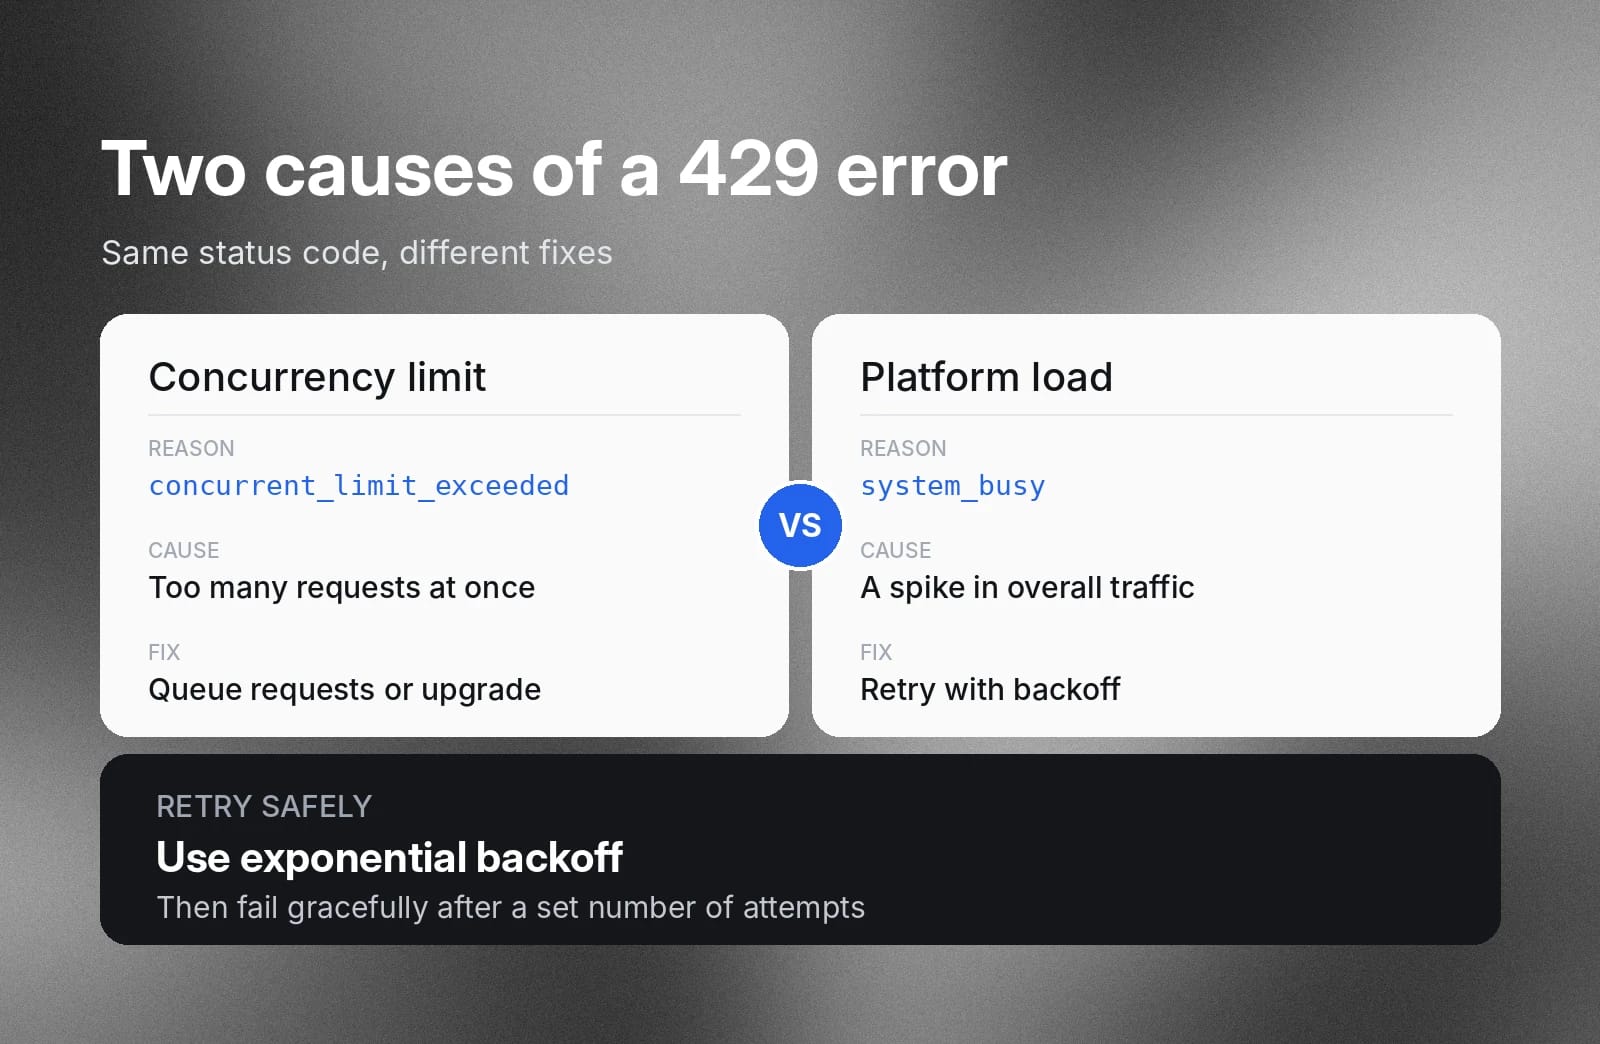
Limity równoczesnych żądań (concurrent_limit_exceeded)
Każdy plan subskrypcji silnika TTS określa stałą liczbę równoczesnych żądań, które możesz wysłać. Jeśli aplikacje przekroczą ten limit, serwer zwróci ten rodzaj błędu 429.
Zbuduj asynchroniczną warstwę kolejkowania z użyciem usługi takiej jak Redis, aby kontrolować wysyłane payloady i nie przekraczać limitów planu. Możesz też ocenić, czy subskrypcja wyższego planu się opłaca.
Nagłe wzrosty obciążenia platformy (system_busy)
Przy dużym obciążeniu serwer TTS może ograniczać przychodzące żądania, aby utrzymać wydajność. Dodaj automatyczną logikę ponawiania prób do klienta API aplikacji. Upewnij się, że może ponawiać próby z wykładniczym opóźnieniem, a po maksymalnej liczbie prób zakończyć działanie w kontrolowany sposób.
Testuj głosy, języki i ustawienia przed publikacją
Szybki test w aplikacji webowej zwykle nie zapewnia wystarczającej kontroli jakości przy payloadach TTS na dużą skalę. Koszt nieudanych przebiegów może szybko rosnąć. Przed wysłaniem przetestuj skrypt w serii kontrolowanych iteracji. Takie przygotowanie pomoże ci sprawnie tworzyć audio głosowe najwyższej jakości.
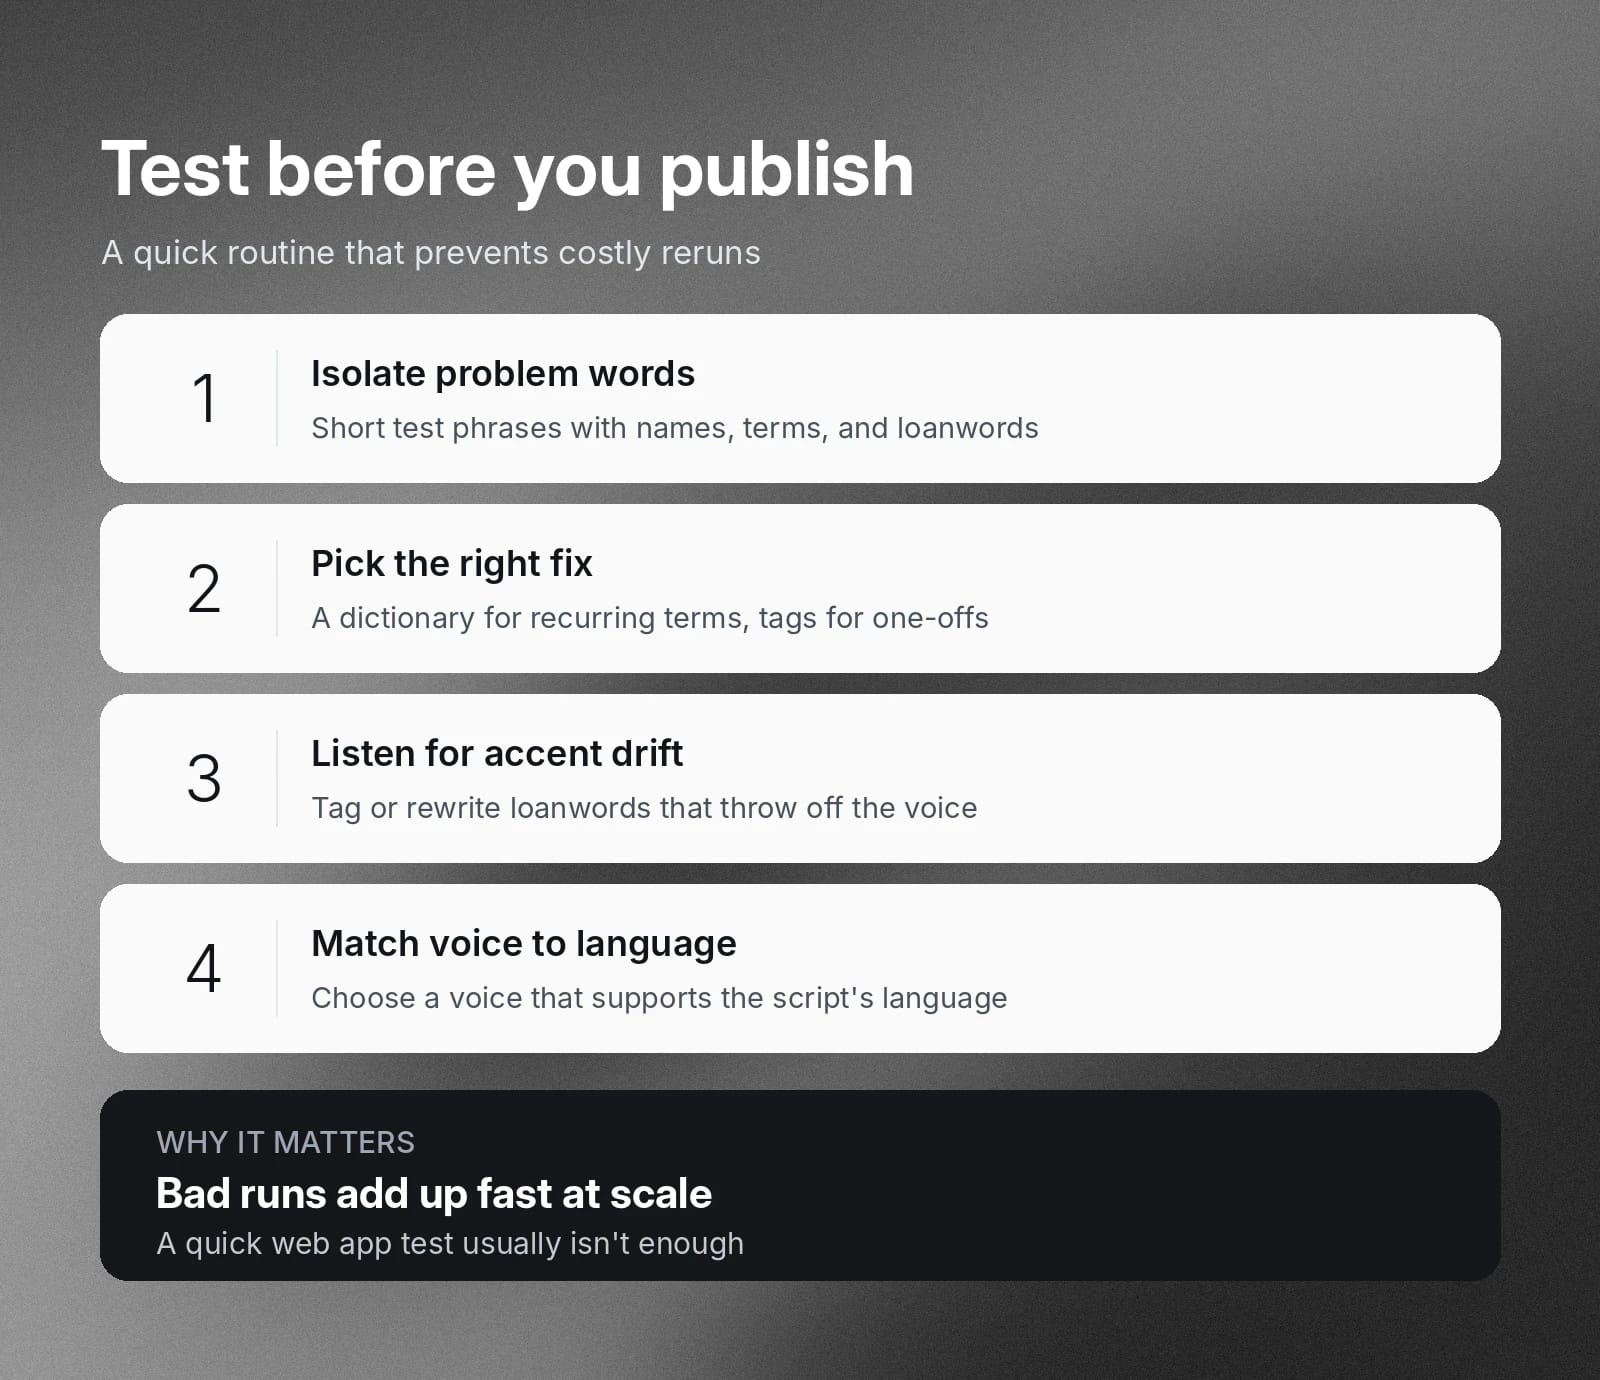
Testuj problematyczne słowa osobno
Problemy zwykle dotyczą konkretnych fragmentów, słów lub nazw, a nie całego tekstu. Twórz testowe frazy od pięciu do dziesięciu słów zawierające nazwy marek, terminy techniczne lub wyrażenia w językach obcych. Na podstawie wyników zdecyduj, czy dla każdego przypadku użyć słownika wymowy, czy tylko tagów fonetycznych.
Rozpoznawaj możliwe odchylenia językowe lub akcentowe
Modele mowy mogą czasem przyjąć dziwny lub powolny rytm w środku zdania. Często dzieje się tak, gdy model musi zgadywać wymowę fragmentu innego niż te, które widział podczas treningu.
- Zapożyczenia: tekst zawierający rzadkie zapożyczenia z języka obcego może zaburzyć mapowanie grafemów przez model, przez co cała dalsza mowa zabrzmi jakby z dziwnym akcentem. Użyj tagów fonetycznych przy zapożyczeniu lub przeredaguj tekst.
- Sztywna mowa w językach innych niż angielski: model zoptymalizowany pod angielski może jąkać się lub brzmieć robotycznie podczas czytania przetłumaczonego skryptu. Wybierz profil głosu obsługujący również język ojczysty.
Zacznij korzystać z ElevenAPI, aby uzyskać bardziej niezawodne wyniki mowy
Gdy wiesz, na co zwracać uwagę, szybciej tworzysz wysokiej jakości treści głosowe i unikasz wielu problemów. Naucz się radzić sobie z problemami z wynikami oraz technicznymi problemami API, które mogą zatrzymać produkcję.
Dowiedz się więcej o tworzeniu precyzyjnych treści TTS wysokiej jakości z ElevenAPI lub pobierz klucz API już dziś.
Często zadawane pytania o problemy z zamianą tekstu na mowę

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.