대화형 AI 에이전트 테스트
- 작성자
- Anna Neely
- 게시일
- 최종 업데이트
대화형 음성 에이전트를 출시한 후, 어떻게 대규모로 모니터링할 수 있을까요? 의도한 대로 작동하지 않는 경우는 어떻게 포착할 수 있을까요? 변경을 적용한 뒤에는 어떻게 테스트할 수 있을까요?
이러한 질문은 El, 대화형 AI로 구동되는 문서 지원 어시스턴트인 El을 개발하는 데 중요한 방향이 되었습니다. 대화형 AI. El이 발전하면서 평가 기준과 대화 시뮬레이션을 기반으로 에이전트를 모니터링하고 평가하며 테스트하는 시스템을 구축했습니다.
기반 마련: 신뢰할 수 있는 평가 기준
에이전트 개선은 실제 환경에서 어떻게 작동하는지 이해하는 것에서 시작됩니다. 이를 위해 평가 기준을 고도화하고, 에이전트 성능을 모니터링할 만큼 정확하고 신뢰할 수 있도록 했습니다. 에이전트가 잘못된 정보를 제공하거나 사용자의 목표 달성을 돕지 못한 대화를 실패한 대화로 정의합니다.
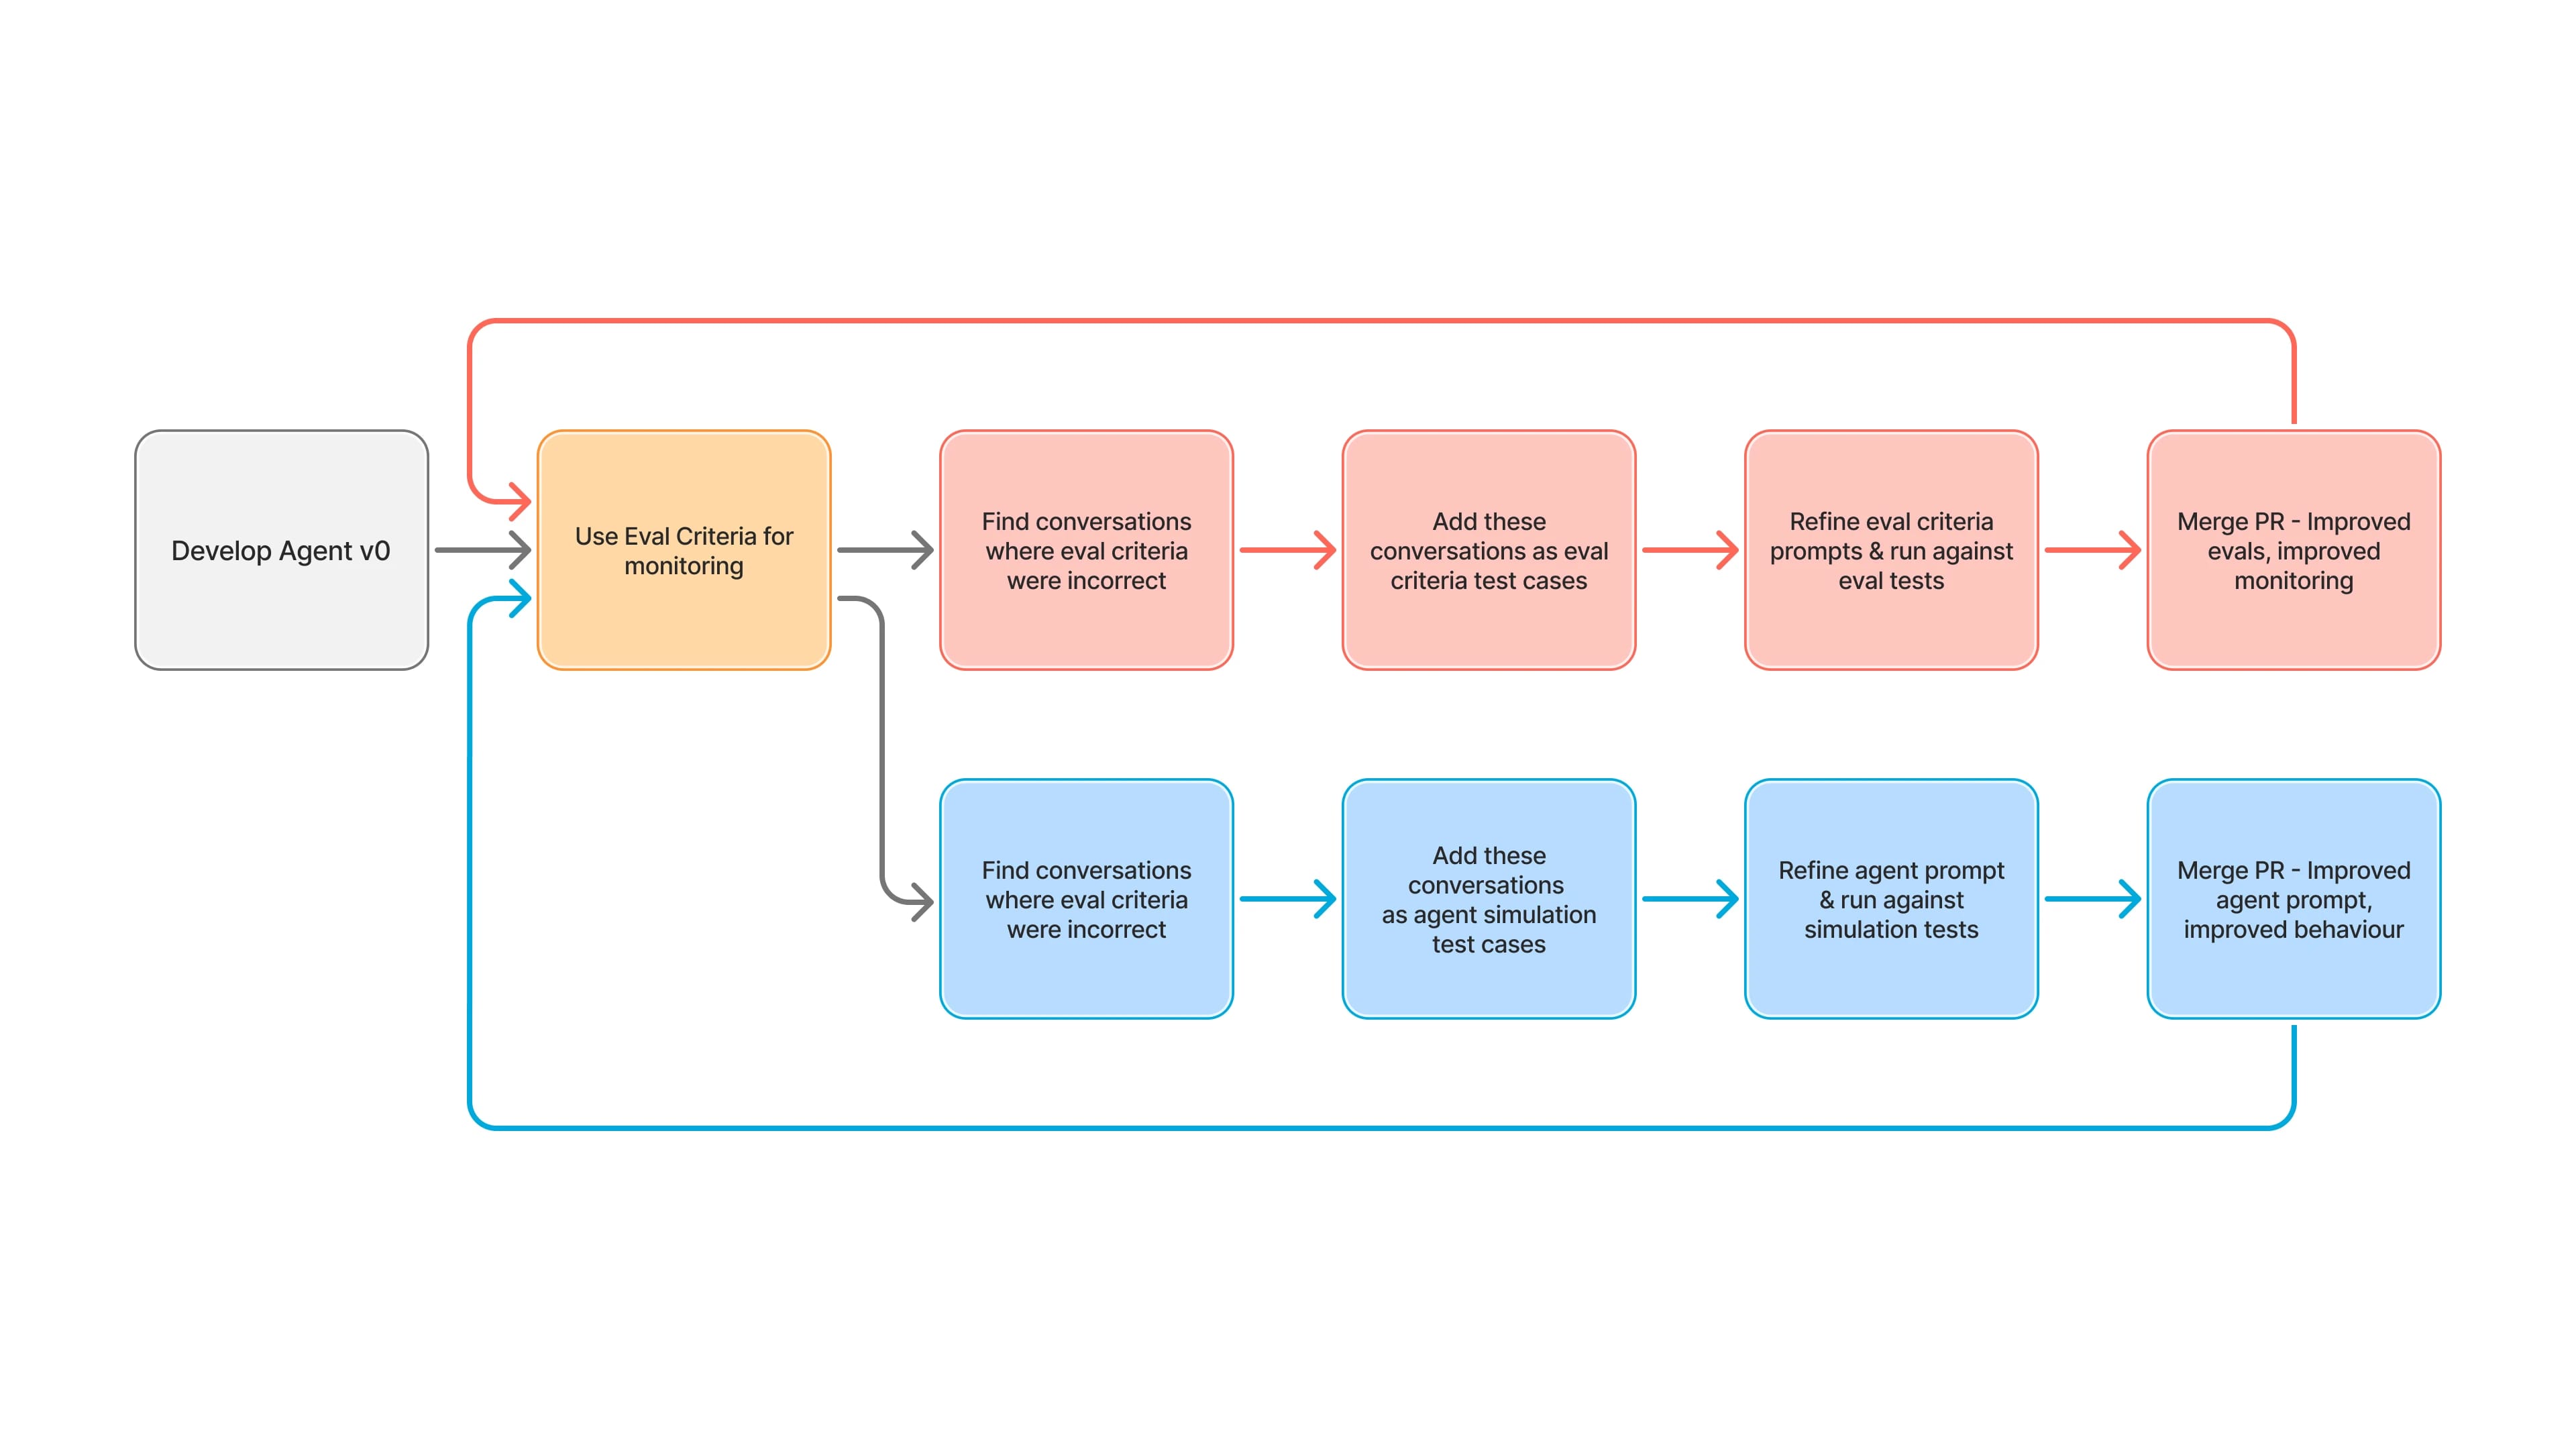
다음과 같은 평가 기준을 개발했습니다:
- 상호작용: 유효한 대화인가요? 사용자가 관련 질문을 했나요? 대화가 자연스럽게 이어졌나요?
- 긍정적 상호작용: 사용자는 만족했나요, 아니면 혼란스럽거나 답답함을 느꼈나요?
- 근본 원인 파악: 에이전트가 사용자의 근본적인 문제를 정확히 파악했나요?
- 사용자 문의 해결: 에이전트가 사용자의 문제를 해결했거나 대체 지원 방법을 제공했나요?
- 환각: 에이전트가 지식 베이스에 없는 정보를 사실처럼 생성했나요?
상호작용 기준에 실패하면 대화 자체가 유효하지 않습니다. 다른 기준 중 하나라도 실패하면 추가로 조사합니다. 이 조사는 에이전트를 개선하는 방향을 결정합니다. 도구 사용 방식이나 타이밍을 다듬어야 할 때도 있고, 지원되지 않는 작업을 막기 위한 가드레일을 추가해야 할 때도 있습니다.
자신 있게 반복 개선하기: 대화 시뮬레이션 API
개선할 부분을 파악했다면 다음 단계는 테스트입니다. 이때 대화 시뮬레이션 API가 필요합니다. 이 API는 처음부터 끝까지 진행하는 시나리오와 특정 구간을 대상으로 하는 시나리오 모두에서 현실적인 사용자 상황을 시뮬레이션하고, 프로덕션에서 적용하는 것과 동일한 기준으로 결과를 자동 평가합니다. 도구 모킹과 맞춤형 평가를 지원하므로 특정 동작을 유연하게 테스트할 수 있습니다.
두 가지 방식을 사용합니다:
- 전체 시뮬레이션: 전체 대화 테스트를 처음부터 끝까지 진행합니다.
- 부분 시뮬레이션: 대화 중간부터 시작해 의사 결정 지점이나 하위 플로우를 검증합니다. 빠른 반복과 집중적인 디버깅을 지원하는 단위 테스트에 가장 많이 사용하는 방법입니다.
명확하고 집중된 시나리오를 통해 LLM이 무엇을 테스트받는지 제어하고, 엣지 케이스, 도구 사용, 폴백 로직을 빠짐없이 다룰 수 있습니다.
확장성을 위한 자동화: CI/CD에 테스트 통합
마지막 요소는 자동화입니다. ElevenLabs의 오픈 API를 사용해 평가와 시뮬레이션을 CI/CD 파이프라인에 통합하여 GitHub DevOps 플로우와 연결했습니다. 모든 업데이트는 배포 전에 자동으로 테스트됩니다. 이를 통해 회귀를 방지하고 실제 환경 성능에 관한 빠른 피드백을 얻을 수 있습니다.
결과: 더 강력하고 스마트해진 El
이 프로세스는 El을 구축하고 유지 관리하는 방식을 바꿨습니다. 실제 사용량을 체계적인 평가, 집중 테스트, 자동 검증과 연결하는 피드백 루프를 구축해 더 빠르고 확신 있게 개선 사항을 출시할 수 있게 되었습니다.
이제 이 프레임워크를 구축하는 모든 에이전트에 적용할 수 있습니다.
Anna Neely focuses on product strategy and partners with enterprise customers on solution design and implementation