Vibe Draw 구축: ElevenLabs와 FLUX Kontext를 결합한 음성 기반 이미지 제작
- 게시일
- 최종 업데이트
음성 인터페이스는 AI와 소통하는 방식을 바꾸고 있습니다. 이미지를 만드는 일이 소리 내어 설명하는 것만큼 쉬워진다면 어떨까요?
이 아이디어로 주말 프로젝트인 Vibe Draw를 만들게 되었습니다. ElevenLabs의 음성 AI와 Black Forest Labs의 FLUX Kontext를 결합해 음성 프롬프트를 이미지로 바꾸는 음성 우선 크리에이티브 도구입니다.
FLUX Kontext는 새로운 유형의 이미지 모델입니다. 기존 텍스트-이미지 시스템과 달리 Kontext는 생성과 편집을 모두 처리합니다. 프롬프트로 새 이미지를 만들고, 기존 이미지를 수정하며, 여러 참조 이미지를 하나의 결과물로 병합할 수도 있습니다.
GPT-4o나 Gemini 2 Flash 같은 모델도 멀티모달 기능을 제공하지만, FLUX Kontext는 고품질 시각 조작을 위해 특별히 설계되었습니다. 테스트에서 변경 사항을 설명하는 것만으로 스타일화된 텍스트의 개별 글자를 바꾸거나 객체 위치를 조정할 수 있었습니다.
그때 이런 생각이 들었습니다. “이걸 음성으로 하면 어떨까?” 그리고 ElevenLabs의 강력한 음성 기술보다 더 좋은 기반이 있을까요?

기술적 과제
음성 기반 이미지 시스템을 구축하려면 다음 5가지 핵심 문제를 해결해야 했습니다:
- 자연어 이해 — 새 이미지 생성과 편집 구분
- 맥락 인식 — 상호작용 전반에서 연속성 유지
- 오디오 관리 — 응답이 겹치지 않도록 하고 큐 관리
- 시각 생성 — 생성과 편집 간의 매끄러운 전환
- 사용자 경험 — 고급 AI 상호작용을 직관적으로 구현
아키텍처 개요
Vibe Draw는 전적으로 클라이언트 측에서 실행되며 다음 구성 요소를 통합합니다:
- 음성 인식을 위한 Web Speech API
- 음성 응답을 위한 ElevenLabs TTS API
- 이미지 생성 및 편집을 위한 FLUX Kontext API
- 사용자 입력 이해를 위한 맞춤형 의도 감지
이 접근 방식은 프로토타입을 가볍게 유지하지만, 실제 배포 환경에서는 보안을 위해 서버 측에서 요청을 프록시해야 합니다.
ElevenLabs로 음성 구현하기
Vibe Draw는 대화형 응답성을 위해 조정된 ElevenLabs의 텍스트 음성 변환 API를 사용합니다:
다양성을 위해 음성 응답은 미리 정의된 템플릿에서 무작위로 선택됩니다:
오디오 재생 관리
음성 응답이 겹치면 대화의 자연스러운 느낌이 깨집니다. Vibe Draw는 오디오 큐 시스템으로 이를 해결합니다:
각 메시지는 다음 메시지가 재생되기 전에 끝까지 재생됩니다.
의도 감지 및 맥락 관리
시스템은 키워드와 맥락 감지를 사용해 사용자 프롬프트가 새 이미지 요청인지 편집 요청인지 판단합니다:
이 접근 방식은 기존 이미지가 있고 맥락상 명확한 경우에만 편집이 적용되도록 합니다.
FLUX Kontext를 활용한 이미지 생성
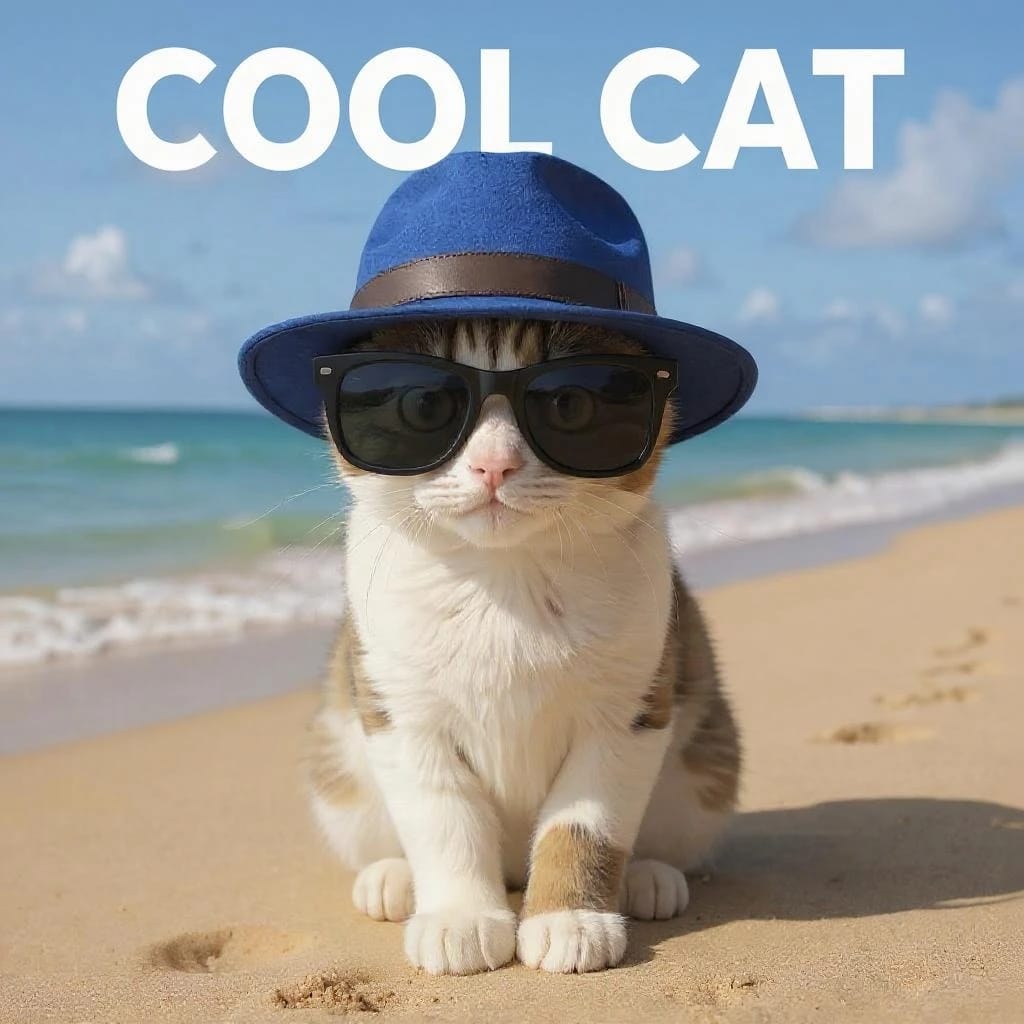
Kontext는 생성과 편집, 두 가지 모드를 지원합니다.
생성(텍스트-이미지)
편집(맥락 기반 변환)
복잡한 변환 처리
일부 프롬프트는 편집 API의 한계를 넘어서는 변경을 의미합니다. 이를 감지하면 시스템은 대체 방안을 제공합니다:
경험 최적화
점진적 피드백
UI 피드백은 사용자가 시스템 상태를 파악하는 데 도움이 됩니다:
지능형 타이밍
자연스러운 대화에는 자연스러운 타이밍이 필요합니다:
세션 상태
맥락을 유지하기 위해 세션 데이터를 저장합니다:
성능 고려 사항
응답성을 보장하기 위해:
- 지연 로딩 — 필요할 때만 API 초기화
- 디바운싱 — 상호작용당 API 요청 제한
- 오류 처리 — 시간 초과나 실패 시 원활하게 복구
- 리소스 정리 — 오디오 객체와 이벤트 리스너를 적절히 제거
다음 단계
대화형 UI는 새로운 기능의 가능성을 엽니다:
- 멀티모달 입력 — “이 사진과 더 비슷하게 만들어 줘.”
- 협업 세션 — 여러 사용자가 하나의 디자인에 기여
- 스타일 기억 — 시간이 지날수록 시스템이 사용자의 미적 감각을 학습
- 실시간 스트리밍 — 사용자가 말하는 동안 이미지 업데이트를 스트리밍하고 대화형 AI 를 통합해 스트리밍 음성을 지원합니다.
핵심 요점
Vibe Draw를 구축하며 음성 우선 도구를 위한 몇 가지 핵심 원칙을 확인했습니다:
- 맥락이 핵심 — 상태를 추적하면 상호작용이 일관되게 느껴짐
- 타이밍이 개성을 더함 — 응답 속도를 조절하면 AI가 더 반응성 있게 느껴짐
- 대체 방안이 흐름을 유지 — 생성에 실패하면 대안을 제시
- 다양성이 신선함을 유지 — 같은 문구를 반복하면 몰입감이 깨짐
결론
Vibe Draw는 대화형 음성 AI와 시각적 창의성이 만날 때 무엇이 가능한지 보여줍니다. ElevenLabs의 자연스러운 음성 합성과 FLUX Kontext의 이미지 API가 결합해 클릭도, 슬라이더도 없이 음성만으로 만드는 새로운 방식을 구현합니다.
만드는 일이 설명하는 것만큼 쉬워지면, 상상과 구현 사이의 장벽이 사라집니다.
직접 사용해 보기
전체 소스 코드는 GitHub에서 확인할 수 있습니다. 직접 실행하려면:
- 리포지토리 복제하기
- ElevenLabs API 키 추가하기
- FAL.ai API 키 추가하기
- 최신 브라우저에서 vibe-draw-v2.html 열기
- 마이크를 클릭하고 제작을 시작하세요
나만의 음성 우선 경험을 구축하고 싶으신가요? 다음을 살펴보세요: ElevenLabs 대화형 AI 또는 문의하기.
Ryan joined ElevenLabs after more than two decades in news and publishing, including roles at the BBC and Future Plc. He focuses on content strategy and storytelling, helping ElevenLabs shape and share its narrative.