AIエージェントのための多層的なセーフティフレームワーク
- 公開日
- 最終更新日
聴くこの記事を聴く
AIエージェントが重要度の高い業務を担うようになる中、チームには、エージェントが安全かつ予測可能に動作するという確信が必要です。
ElevenAgentsでは、会話のあらゆる段階におけるガードレール、リリース前の敵対的テスト、本番環境でのモニタリング、データ保護、独立した検証を網羅する、多層的なセーフティアーキテクチャを採用しています。
非決定論的なシステムであらゆるリスクを防ぐことはできませんが、この包括的なセーフティフレームワークにより、ElevenAgentsを活用する主要企業や政府機関は、障害が起こりにくく、適切に復旧し、高い安全基準を満たすエージェントを設計できます。
会話のあらゆる段階を保護
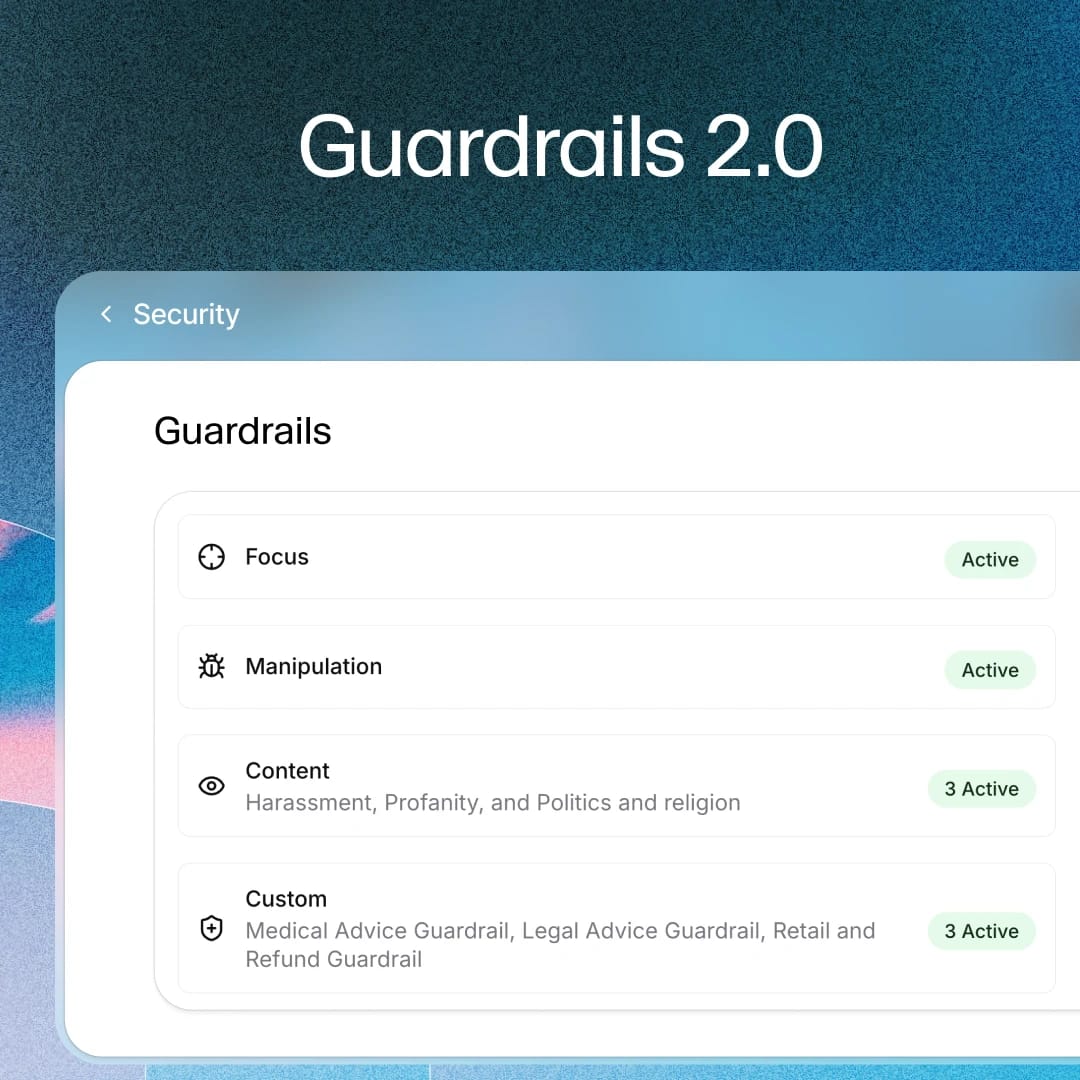
すべてのやり取りにある3つの段階を保護するコントロールを、簡単に有効化・設定できます。これはElevenAgentsにおけるGuardrails 2.0の基盤です。
入力 - ユーザーが送信する内容をリアルタイムでチェックします。
- 操作対策ガードレールはユーザー入力を独立して分析し、プロンプトインジェクションの兆候がある会話を終了できます。
判断 - エージェントが行動を決定する際に、適切に導かれ、軌道から外れないようにします。
- システムプロンプトには、不適切なトピックを避けること、エージェント自身の表現方法を定義すること、対応範囲を制限することなど、明確な指示を含める必要があります。
- ワークフローと手順では、アカウント情報を共有する前に発信者の本人確認を行うなど、特に機密性の高い操作をツール呼び出しの後にのみ実行するよう制御できます。
- Focusガードレールは既存のシステム指示を強化し、特に長時間または複雑なやり取りで重要となる逸脱を軽減します。
出力 - 応答生成と並行して独立したバリデーターが実行されるため、レイテンシーの増加は最小限です。これらを有効にすると、機密コンテンツを含む、またはポリシーに違反する応答をブロックできます。
- コンテンツガードレールは、カテゴリごとに設定したしきい値で機密カテゴリを審査します。
- カスタムガードレールは、自然言語で記述したドメイン固有のルールを適用します。各ルールは軽量モデルで評価されます。
- 終了戦略では、ガードレールが作動した際の動作を定義できます。たとえば、通話の終了、人間の担当者への転送、修正指示を付けた応答の再試行などです。
堅牢なリリース前テスト
ElevenAgentsは、プラットフォーム上で構築するユーザーが、エージェントや設定変更を本番公開する前に問題を見つけて修正できる、堅牢なテスト機能を提供します。
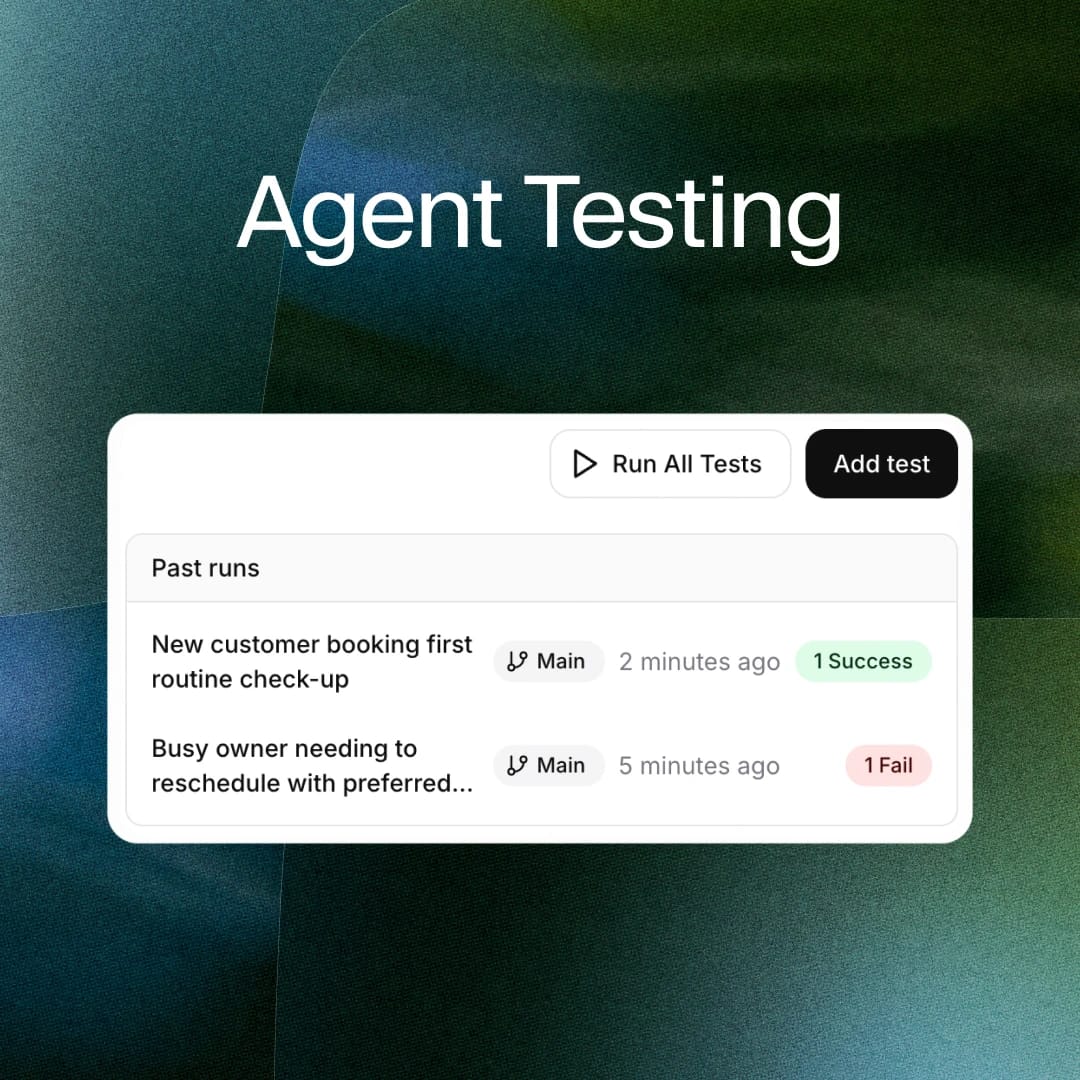
シミュレーション では、実際の対話の前に、シミュレートされたユーザーとの完全なマルチターン会話を実行できます。シナリオを定義すると、シミュレーターが実際またはモックのツール呼び出しを含め、解決まで会話を進めます。シミュレートされたユーザーは制御できるため、敵対的または操作的に設定できます。これにより、通常のフローを検証する同じ仕組みで、敵対的なフローもテストできます。
以下の機能により、テスト範囲をさらに広げられます。
- 繰り返し実行 では、テストを何度も実行し、失敗を理由別にグループ化して、エラーパターンやエッジケースを特定できます。
- 次の応答とツール呼び出しのテストでは、個々の応答と重要なアクションを確認します。
- チャネル別テスト では、チャネルによってエージェントの出力を調整できるため(たとえば通話では簡潔に、メールでは詳しく)、提供するすべての接点で期待どおりに機能することを検証します。
- APIによるレッドチーミング。 レッドチーミングSDKを使用して、API経由でテストを実行することもできます。
リリース後のエージェント評価と改善
エージェントをデプロイすると、実際の会話に対する評価が継続的に実行されます。LLMを判定者として使うアプローチにより、各通話を設定した基準に照らして自動評価できます。ダッシュボードで会話の結果を確認し、検索可能な文字起こし、ソース、ツール呼び出し、ガードレールの発動を含む詳細な会話ログを使って問題を追跡できます。
本番環境で見つかった問題は、簡単にテストスイートへフィードバックできます。変更を提案する際は、Experimentsを使用して実際のトラフィックの一部をバリアントへ振り分け、広く適用する前に実際の成果を測定できます。
段階的なデプロイをおすすめします。トラフィックの限定的な割合をエージェントへ振り分けて会話を評価し、期待どおりに機能していることを確認してから、追加のユースケース、チャネル、地域へと拡大してください。
機密データの保護
エージェントは決済情報、健康情報、個人識別子を扱う可能性があるため、どのデータが、どこに、どのくらいの期間保存されるかを検討することが重要です。
データ保護のために、さまざまな仕組みを提供しています。
- Zero Retention Modeは、対象サービスで有効にすると、特定の種類のデータが保持されないようにします。厳格な規制環境向けに設計されています。
- 会話履歴の編集は、通話後に機密エンティティを削除し、テキストではプレースホルダー、オーディオではビープ音に置き換えます。個々のエンティティタイプ単位で適用できます。
- 設定可能な保持期間は、保存期間を規制要件に合わせます。
- データレジデンシーは、処理を必要な法的管轄区域内に維持します。
- プライベートデプロイメント(VPC)は、高機密性ワークロード向けに環境を分離します。
- 暗号化は、転送中および保存時のデータを保護します。
プラットフォームレベルの保護措置と外部検証
上記のすべては、より広範な プラットフォームレベルの保護措置に支えられています。これは、コンテンツの来歴、悪用検知、禁止用途の施行、モデルのレッドチーミングを網羅する包括的なプログラムです。Safety Partnership Programを通じて、AIセーフティの最前線に立つ企業とも協力し、そのプロダクトや新たな業界標準に貢献しています。
また、SOC 2 Type II、ISO 27001、GDPRなどの一般的なセキュリティおよびプライバシー基準に加え、決済処理向けのPCI DSS Level 1や米国医療向けのHIPAAなど、業界・ユースケース固有の認証を含む独立した審査を受けています。詳しくは トラストセンターをご覧ください。
AI管理システムを規定するISO 42001や、AIUC-1など、より新しいAIネイティブの基準にも準拠しています。AIUC-1では、AIエージェントが独立評価者による四半期ごとの敵対的シミュレーションに耐えることが求められます。AIUC-1を支える同じ機能により、業界初となるエージェント向け保険ポリシーも利用できます。
大規模または複雑な導入では、Forward Deployed Engineersがお客様のチームと連携し、設定、ガードレール、テスト、モニタリング、展開戦略を含むエージェント戦略の設計と実装を支援します。
まとめ
ElevenAgentsのセーフティへのアプローチは多層的で、各要素が相互に補強し合います。
- エージェント設定: 動作を形づくるシステムプロンプト、ワークフロー、手順。特に機密性の高い操作はツール呼び出しの後にのみ実行されます。
- ガードレール: あらゆる段階での独立したチェック。入力時の操作検知、判断時のFocus、出力時のコンテンツおよびカスタムバリデーターに加え、設定可能な終了戦略を提供します。
- テスト: リリース前の敵対的シミュレーション、繰り返し実行、チャネル別テスト、レッドチーミング。
- モニタリング: 段階的な展開、その後の継続的な評価、検索可能なログと文字起こし、リリース後のフィードバックループ。
- データ保護: 編集、Zero Retention Mode、設定可能な保持期間、データレジデンシー、プライベート(VPC)デプロイメント、暗号化。
- 外部検証: 認証、AIUC-1の独立した敵対的テスト、エージェント保険、レッドチーミング、専門家によるサポート。