Vibe Draw बनाना: वॉइस-आधारित इमेज क्रिएशन के लिए ElevenLabs को FLUX Kontext के साथ जोड़ना
- लेखक
- Ryan Morrison
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
वॉइस इंटरफ़ेस, AI के साथ हमारे संवाद का तरीका बदल रहे हैं। क्या हो अगर इमेज बनाना, उसे ज़ोर से बताने जितना आसान हो?
इसी विचार से मैंने वीकेंड प्रोजेक्ट के रूप में Vibe Draw बनाया। यह एक वॉइस-फर्स्ट क्रिएटिव टूल है, जो बोले गए प्रॉम्प्ट को इमेज में बदलने के लिए ElevenLabs के वॉइस AI को Black Forest Labs के FLUX Kontext के साथ जोड़ता है।
FLUX Kontext इमेज मॉडल की एक नई श्रेणी है। पारंपरिक टेक्स्ट-टू-इमेज सिस्टम के उलट, Kontext जनरेशन और एडिटिंग, दोनों संभालता है। यह प्रॉम्प्ट से नई इमेज बना सकता है, मौजूदा इमेज में बदलाव कर सकता है और कई रेफ़रेंस इमेज को एक ही आउटपुट में मिला भी सकता है।
GPT-4o और Gemini 2 Flash जैसे मॉडल मल्टीमॉडल क्षमताएं देते हैं, लेकिन FLUX Kontext को खास तौर पर उच्च-गुणवत्ता वाले विज़ुअल बदलावों के लिए बनाया गया है। टेस्टिंग में, मैं सिर्फ बदलाव बताकर स्टाइलिश टेक्स्ट के अलग-अलग अक्षर बदल सका या किसी ऑब्जेक्ट की जगह बदल सका।
तभी मैंने सोचा: “इसे वॉइस के साथ क्यों न किया जाए?” और ElevenLabs की शक्तिशाली वॉइस टेक्नोलॉजी से बेहतर आधार क्या हो सकता है?

तकनीकी चुनौती
वॉइस-आधारित इमेज सिस्टम बनाने के लिए पांच मुख्य समस्याएं हल करनी पड़ीं:
- प्राकृतिक भाषा की समझ — नई क्रिएशन और एडिट में अंतर करना
- कॉन्टेक्स्ट की समझ — इंटरैक्शन के दौरान निरंतरता बनाए रखना
- ऑडियो मैनेजमेंट — ओवरलैप होती प्रतिक्रियाओं से बचना और क्यू मैनेज करना
- विज़ुअल जनरेशन — जनरेशन और एडिटिंग के बीच सहज बदलाव
- यूज़र अनुभव — उन्नत AI इंटरैक्शन को सहज बनाना
आर्किटेक्चर का अवलोकन
Vibe Draw पूरी तरह क्लाइंट-साइड चलता है और इनमें से घटकों को इंटीग्रेट करता है:
- स्पीच रिकग्निशन के लिए Web Speech API
- वॉइस प्रतिक्रियाओं के लिए ElevenLabs TTS API
- इमेज जनरेशन और एडिटिंग के लिए FLUX Kontext API
- यूज़र इनपुट समझने के लिए कस्टम इंटेंट डिटेक्शन
यह तरीका प्रोटोटाइप को हल्का रखता है, लेकिन सुरक्षा के लिए प्रोडक्शन डिप्लॉयमेंट में रिक्वेस्ट को सर्वर-साइड प्रॉक्सी करना चाहिए।
ElevenLabs के साथ वॉइस इम्प्लीमेंट करना
Vibe Draw बातचीत के दौरान तेज़ प्रतिक्रिया के लिए ट्यून की गई ElevenLabs की टेक्स्ट-टू-स्पीच API का उपयोग करता है:
विविधता के लिए, वॉइस प्रतिक्रियाएं पहले से तय टेम्पलेट से रैंडम तरीके से चुनी जाती हैं:
ऑडियो प्लेबैक मैनेज करना
ओवरलैप होती वॉइस प्रतिक्रियाएं बातचीत का स्वाभाविक अनुभव तोड़ देती हैं। Vibe Draw इसे ऑडियो क्यू सिस्टम से हल करता है:
हर मैसेज अगला शुरू होने से पहले पूरी तरह प्ले होता है।
इंटेंट डिटेक्शन और कॉन्टेक्स्ट मैनेजमेंट
सिस्टम कीवर्ड और कॉन्टेक्स्ट डिटेक्शन का इस्तेमाल करके तय करता है कि यूज़र का प्रॉम्प्ट नई इमेज की रिक्वेस्ट है या एडिट:
यह तरीका सुनिश्चित करता है कि एडिट सिर्फ तभी लागू हों, जब कोई मौजूदा इमेज हो और कॉन्टेक्स्ट से यह स्पष्ट हो।
FLUX Kontext के साथ इमेज जनरेशन
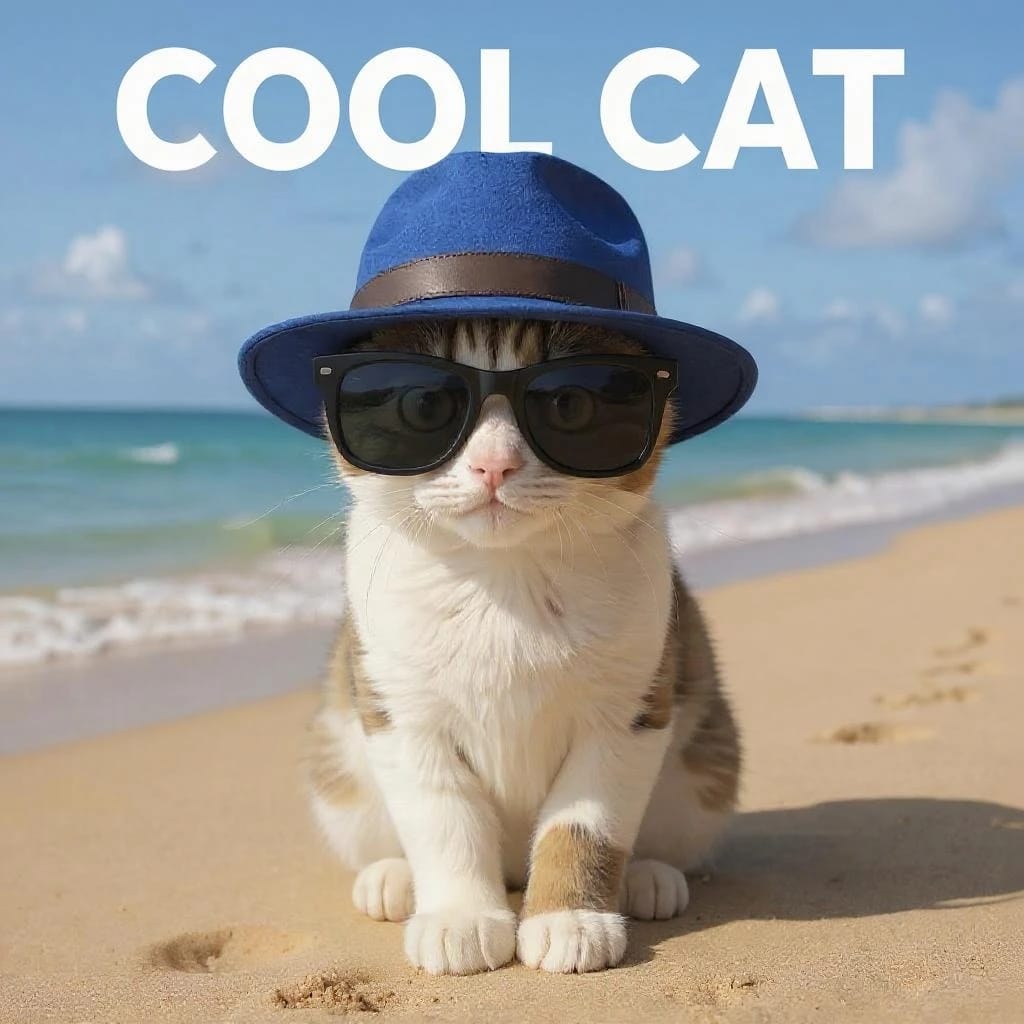
Kontext दो मोड सपोर्ट करता है: जनरेशन और एडिटिंग।
जनरेशन (टेक्स्ट से इमेज)
एडिटिंग (कॉन्टेक्स्ट के आधार पर बदलाव)
जटिल बदलावों को संभालना
कुछ प्रॉम्प्ट ऐसे बदलाव बताते हैं, जो एडिटिंग API की सीमाओं से बाहर होते हैं। इन्हें पहचानने पर सिस्टम एक वैकल्पिक तरीका देता है:
अनुभव को बेहतर बनाना
प्रोग्रेसिव फ़ीडबैक
UI फ़ीडबैक यूज़र्स को सिस्टम की स्थिति समझने में मदद करता है:
स्मार्ट टाइमिंग
स्वाभाविक बातचीत के लिए स्वाभाविक टाइमिंग चाहिए:
सेशन स्टेट
कॉन्टेक्स्ट बनाए रखने के लिए सेशन डेटा स्टोर किया जाता है:
परफ़ॉर्मेंस पर ध्यान देने वाली बातें
तेज़ प्रतिक्रिया सुनिश्चित करने के लिए:
- लेज़ी लोडिंग — API को सिर्फ ज़रूरत पड़ने पर इनिशियलाइज़ करें
- डिबाउंसिंग — हर इंटरैक्शन में API रिक्वेस्ट सीमित रखें
- एरर हैंडलिंग — टाइमआउट या विफलता से सहजता से उबरें
- रिसोर्स क्लीनअप — ऑडियो ऑब्जेक्ट और इवेंट लिस्नर को सही तरीके से हटाएं
आगे क्या
कन्वर्सेशनल UI नई क्षमताओं के दरवाज़े खोलते हैं:
- मल्टीमॉडल इनपुट — “इसे इस फ़ोटो जैसा और बनाएं।”
- कोलैबोरेटिव सेशन — एक ही डिज़ाइन में कई यूज़र योगदान दे सकते हैं
- स्टाइल मेमोरी — सिस्टम समय के साथ आपकी पसंदीदा स्टाइल सीखता है
- रियल-टाइम स्ट्रीमिंग — यूज़र के बोलते समय इमेज अपडेट स्ट्रीम करें और स्ट्रीम की गई स्पीच के लिए कन्वर्सेशनल AI को इंटीग्रेट करें।
मुख्य बातें
Vibe Draw बनाने से वॉइस-फर्स्ट टूल के लिए कई मुख्य सिद्धांत सामने आए:
- कॉन्टेक्स्ट ही सब कुछ है — स्टेट ट्रैक करने से इंटरैक्शन सुसंगत लगते हैं
- टाइमिंग से व्यक्तित्व आता है — प्रतिक्रिया की गति AI को ज़्यादा रिस्पॉन्सिव महसूस कराती है
- वैकल्पिक तरीके गति बनाए रखते हैं — जनरेशन विफल होने पर विकल्प दें
- विविधता अनुभव को ताज़ा रखती है — एक ही वाक्य दोहराने से इमर्सन टूटता है
निष्कर्ष
Vibe Draw दिखाता है कि कन्वर्सेशनल वॉइस AI और विज़ुअल क्रिएटिविटी के मिलने पर क्या होता है। ElevenLabs का प्राकृतिक स्पीच सिंथेसिस और FLUX Kontext की इमेज APIs मिलकर बनाने का एक नया तरीका देते हैं—न क्लिक, न स्लाइडर—बस बोलिए।
जब बनाना, बताने जितना आसान होता है, तो हम कल्पना और उसे साकार करने के बीच की रुकावटें हटा देते हैं।
खुद आजमाएं
पूरा सोर्स कोड GitHub पर उपलब्ध है। अपना वर्ज़न चलाने के लिए:
- रिपॉज़िटरी क्लोन करें
- अपनी ElevenLabs API कुंजी जोड़ें
- अपनी FAL.ai API कुंजी जोड़ें
- किसी आधुनिक ब्राउज़र में vibe-draw-v2.html खोलें
- माइक्रोफ़ोन पर क्लिक करें और बनाना शुरू करें
क्या आप अपना वॉइस-फर्स्ट अनुभव बनाना चाहते हैं? ElevenLabs कन्वर्सेशनल AI देखें या हमसे संपर्क करें।
रयान ने बीबीसी और फ्यूचर पीएलसी में भूमिकाओं सहित, समाचार और प्रकाशन में दो दशकों से अधिक समय के बाद ElevenLabs में शामिल हुए। वह कंटेंट स्ट्रेटेजी और कहानी कहने पर ध्यान केंद्रित करते हैं, जिससे ElevenLabs अपनी कहानी को आकार देने और साझा करने में मदद मिलती है।