
Afbeeldingen en documenten verwerken in ElevenAgents
- Geschreven door
- Francesca Peñaranda Roy
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
Een bouwopzichter ontdekt een tekort aan materialen op een bouwplaats. Hij maakt er een foto van, stuurt die via WhatsApp naar de inkoopagent en bevestigt het afleveradres met zijn stem. De agent verwerkt de foto, stelt vast wat ontbreekt en plaatst met spoed een bestelling, allemaal in één gesprek. Workflows van ondernemingen bevatten regelmatig context die woorden alleen niet kunnen overbrengen. De informatie die nodig is om een verzoek af te handelen, kan worden ingevoerd als foto van een beschadigd item of als PDF van een polis. Door die rechtstreeks aan de agent door te geven, wordt het gesprek korter en verloopt de afhandeling sneller. Wanneer een klant iets kan laten zien in plaats van beschrijven, kan de agent sneller problemen oplossen zonder te vragen van kanaal te wisselen. Rohlik, een van de grootste online supermarktplatforms van Europa, zet zijn agent in via telefoon, web, app en WhatsApp in zes talen en handelt 90% van de klantvragen automatisch af. Multimodale invoer breidt datzelfde afhandelingspercentage uit naar momenten waarop een klant iets moet laten zien, niet vertellen. ElevenAgents behandelt bestanden als primaire invoer voor dezelfde agent die al spraak, WhatsApp, web en mobiel afhandelt. Bestanden bereiken het onderliggende model als native berichten, zodat één agent elk invoertype binnen één gespreksthread afhandelt.
In dit artikel lees je wat multimodaliteit op het platform betekent, hoe bestanden van het apparaat van een klant naar de context van het model gaan, wat elk kanaal ondersteunt en hoe je context tussen sessies behoudt wanneer een klant terugkomt.
Kanalen en invoer
ElevenAgents is opgebouwd rond de kanalen die ondernemingen al gebruiken om klanten te bereiken: web- en mobiele applicaties, hun supportplatform, telefoon, sms, e-mail, WhatsApp en andere. De agentconfiguratie (prompt, model, tools, kennisbank en stem) wordt één keer gedefinieerd en gedeeld met alle kanalen. Twee zaken verschillen per kanaal: de transportlaag en de invoertypen die het ondersteunt. Web- en mobiele applicaties maken verbinding via de insluitbare widget, een van de SDK's of de Agents WebSocket. Telefonische gesprekken maken verbinding via native Twilio, SIP-trunking of native websocketgebaseerde integraties. Sms maakt verbinding via de native Twilio-integratie. WhatsApp maakt verbinding door een WhatsApp Business-account te importeren en de integratie op de agent in te schakelen. Eén agent kan gelijktijdig via al deze transportlagen worden ingezet.
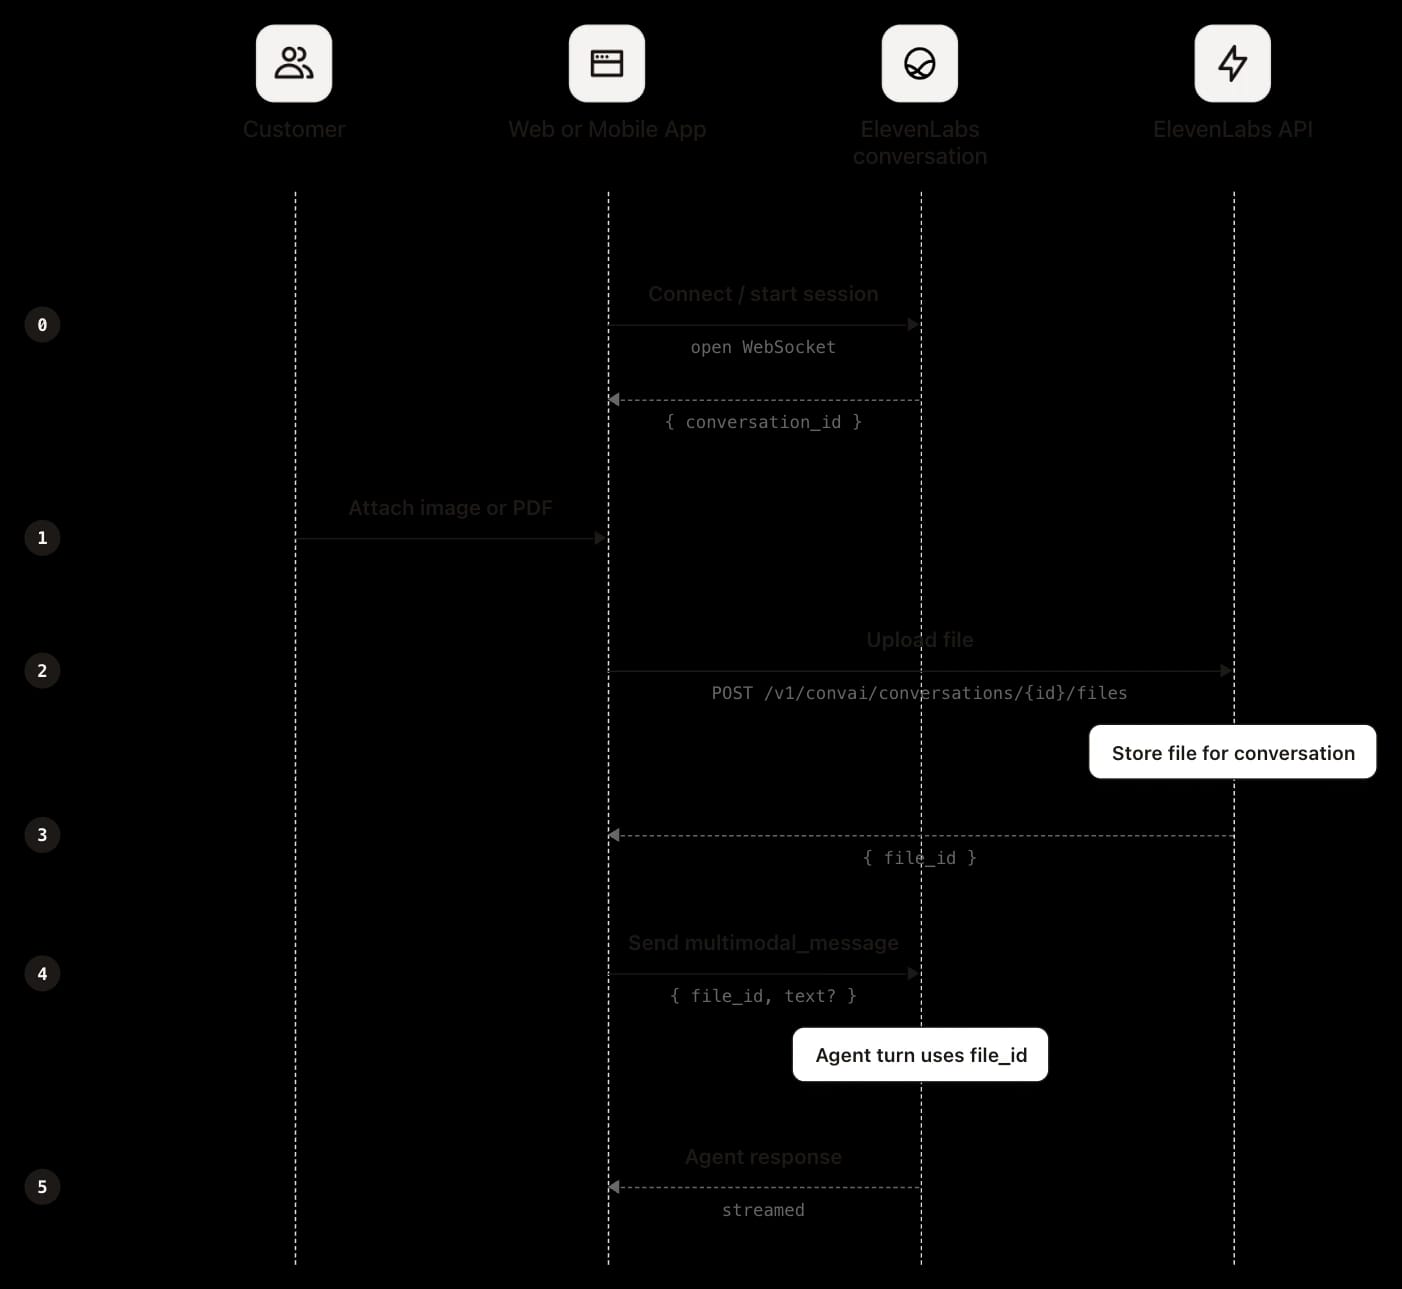
Bestandsinvoer (afbeeldingen en PDF's) wordt momenteel ondersteund op web, mobiel en WhatsApp. De verwerking van invoer wordt bepaald door het type, niet door het kanaal: een foto en een spraakbericht die in dezelfde WhatsApp-sessie binnenkomen, worden via totaal verschillende pipelines verwerkt voordat ze het model bereiken. Ongeacht het kanaal of invoertype komen alle invoerbronnen samen in dezelfde voorverwerkingslaag voordat ze als native context aan het model worden doorgegeven, waarna ze een van twee paden volgen.
Invoerrepresentatie: op bestanden gebaseerd versus inline
Ongeacht het invoertype of kanaal normaliseert het platform elke invoer naar een van twee interne representaties voordat die aan het model wordt doorgegeven. Die classificatie bepaalt hoe de invoer wordt gecodeerd in het contextvenster van het model en wat je integratie vooraf moet afhandelen.
Op bestanden gebaseerde invoer
Afbeeldingen en PDF's worden als native bestandsverwijzingen aan het model doorgegeven, niet als tekstsamenvattingen. Het platform slaat het bestand op, kent er een file_id aan toe en koppelt die identificatie aan de beurt van de gebruiker. Een model dat afbeeldingen of documenten kan verwerken, ontvangt het onbewerkte bestand in zijn contextvenster in plaats van een afgeleide representatie. De vereiste voor de integratie is eenvoudig: leg de file_id vast die door het uploadendpoint wordt geretourneerd en neem deze op in de message payload. Als het bericht zonder de file_id wordt verstuurd, heeft het model geen verwijzing naar het bestand, ongeacht of de upload is geslaagd. Bestandsopslag is beperkt tot het gesprek. Dat betekent dat je integratie alles wat na de sessie behouden moet blijven (het bestand zelf, geëxtraheerde velden of gestructureerde output) expliciet moet afhandelen. Hoe je dat doet, verschilt per kanaal en use case.
Inline
De tweede representatie is inline en omvat al het overige. Spraak en spraakberichten worden getranscribeerd. Getypte tekst, getranscribeerde spraak, WhatsApp-locatiepins en contactkaarten worden allemaal genormaliseerd naar platte tekst in het transcript voordat het model wordt uitgevoerd. Een locatiepin wordt coördinaten en een optioneel adres; een contact wordt een naam en telefoonnummer. Geen van deze wordt als bestand opgeslagen of levert een bestandsverwijzing op. Deze invoer bevindt zich rechtstreeks in het transcript.
Waarom het onderscheid belangrijk is
De splitsing bepaalt waar je integratiewerk naartoe gaat. Het inlinepad vereist tijdens het gesprek niets van je: het platform normaliseert deze invoer naar tekst en die staat rechtstreeks in het transcript. Het pad voor bestandsgebaseerde invoer heeft een apart integratieoppervlak. In plaats van bestandsinhoud naar tekst te converteren voordat het model wordt uitgevoerd, geeft de orchestrator het onbewerkte bestand rechtstreeks door aan het contextvenster van het model. Het model werkt met de structuur van het bestand in plaats van met een afgeleide tekstrepresentatie of beschrijving, waardoor ruimtelijke relaties, visuele lay-out en documentopmaak behouden blijven die anders verloren zouden gaan. Met dat onderscheid in gedachten behandelt de rest van dit artikel de implementatie: hoe je de agent configureert, hoe bestanden door elk kanaal gaan en hoe je context tussen sessies behoudt.
Multimodale invoer instellen
Het inschakelen van multimodale invoer begint met dezelfde agentconfiguratie voor web, mobiel en WhatsApp. Daarna hangt de manier waarop een bestand wordt geüpload en hoe je het later ophaalt af van het kanaal.
Bestandsinvoer inschakelen
Er moeten twee instellingen in de agentconfiguratie zijn ingesteld voordat bestandsinvoer werkt. Stel eerst conversation_config.conversation.file_input.enabled in op True, via de API bij het maken van de agent of in het dashboard onder Settings > Advanced Settings > File Input. Ten tweede moet de agent zijn geconfigureerd met een model dat afbeeldingen en documenten kan verwerken. De vlag alleen doet niets als het onderliggende model geen afbeeldings- of documentblokken kan verwerken; beide moeten zijn ingesteld voordat je gaat testen.
SDK en WebSocket
Bestandsinvoer op web of mobiel vereist een aangepaste chatclient die is gebouwd op de SDK of een rechtstreekse Agents-websocketverbinding. De flow is voor alle drie identiek en de volgorde is een harde vereiste: het bestand moet worden geüpload voordat het bericht wordt verzonden, omdat de message payload verwijst naar de identificatie die de upload retourneert.
Upload eerst het bestand:
Bekijk de bestandsupload voor de volledige request en response:
Stuur vervolgens via de verbinding een bericht dat verwijst naar de geretourneerde file_id:
De SDK's voegen de stappen voor uploaden en verwijzen samen in één aanroep en verwerken de bestandsidentificatie intern. Bekijk de multimodal_message-specificatie voor de volledige berichtindeling. Omdat je applicatie de upload uitvoert, heb je het bestand op dat moment al in handen. Als je het alleen voor het huidige gesprek nodig hebt, volstaat het om het te uploaden en naar de identificatie te verwijzen. Als je het na de sessie wilt behouden, kun je het het best vanuit je applicatie opslaan tijdens het uploaden. Je kunt het ook later ophalen via de post-call webhook, zoals behandeld in de sectie over context tussen sessies.
Op WhatsApp speelt je applicatie geen rol bij de upload. Wanneer een klant een afbeelding, document of sticker stuurt, gaat het bestand eerst naar de infrastructuur van Meta. Meta brengt ElevenLabs via de WhatsApp Business API-webhook op de hoogte en ElevenLabs gebruikt de inloggegevens van je gekoppelde WhatsApp Business-account om het bestand server-naar-server te downloaden, slaat een eigen kopie op en koppelt die op dezelfde manier aan het gesprek als bij een web- of SDK-upload. De agent ontvangt het als multimodale invoer en het transcript registreert een file_input-event.
Omdat je applicatie de upload nooit afhandelt, heeft deze het bestand nooit rechtstreeks in handen. Er is geen mogelijkheid om het tijdens het uploaden vast te leggen, zoals op web en mobiel. Het bestand bereikt je systeem via de file_url in de post-call webhook, die verwijst naar de opgeslagen kopie van ElevenLabs. De media-URL van Meta wordt alleen gebruikt voor opname en nooit extern beschikbaar gesteld. De ophaalmechanismen, waaronder tijdsbeperkingen voor downloads, worden behandeld in de sectie over context tussen sessies.
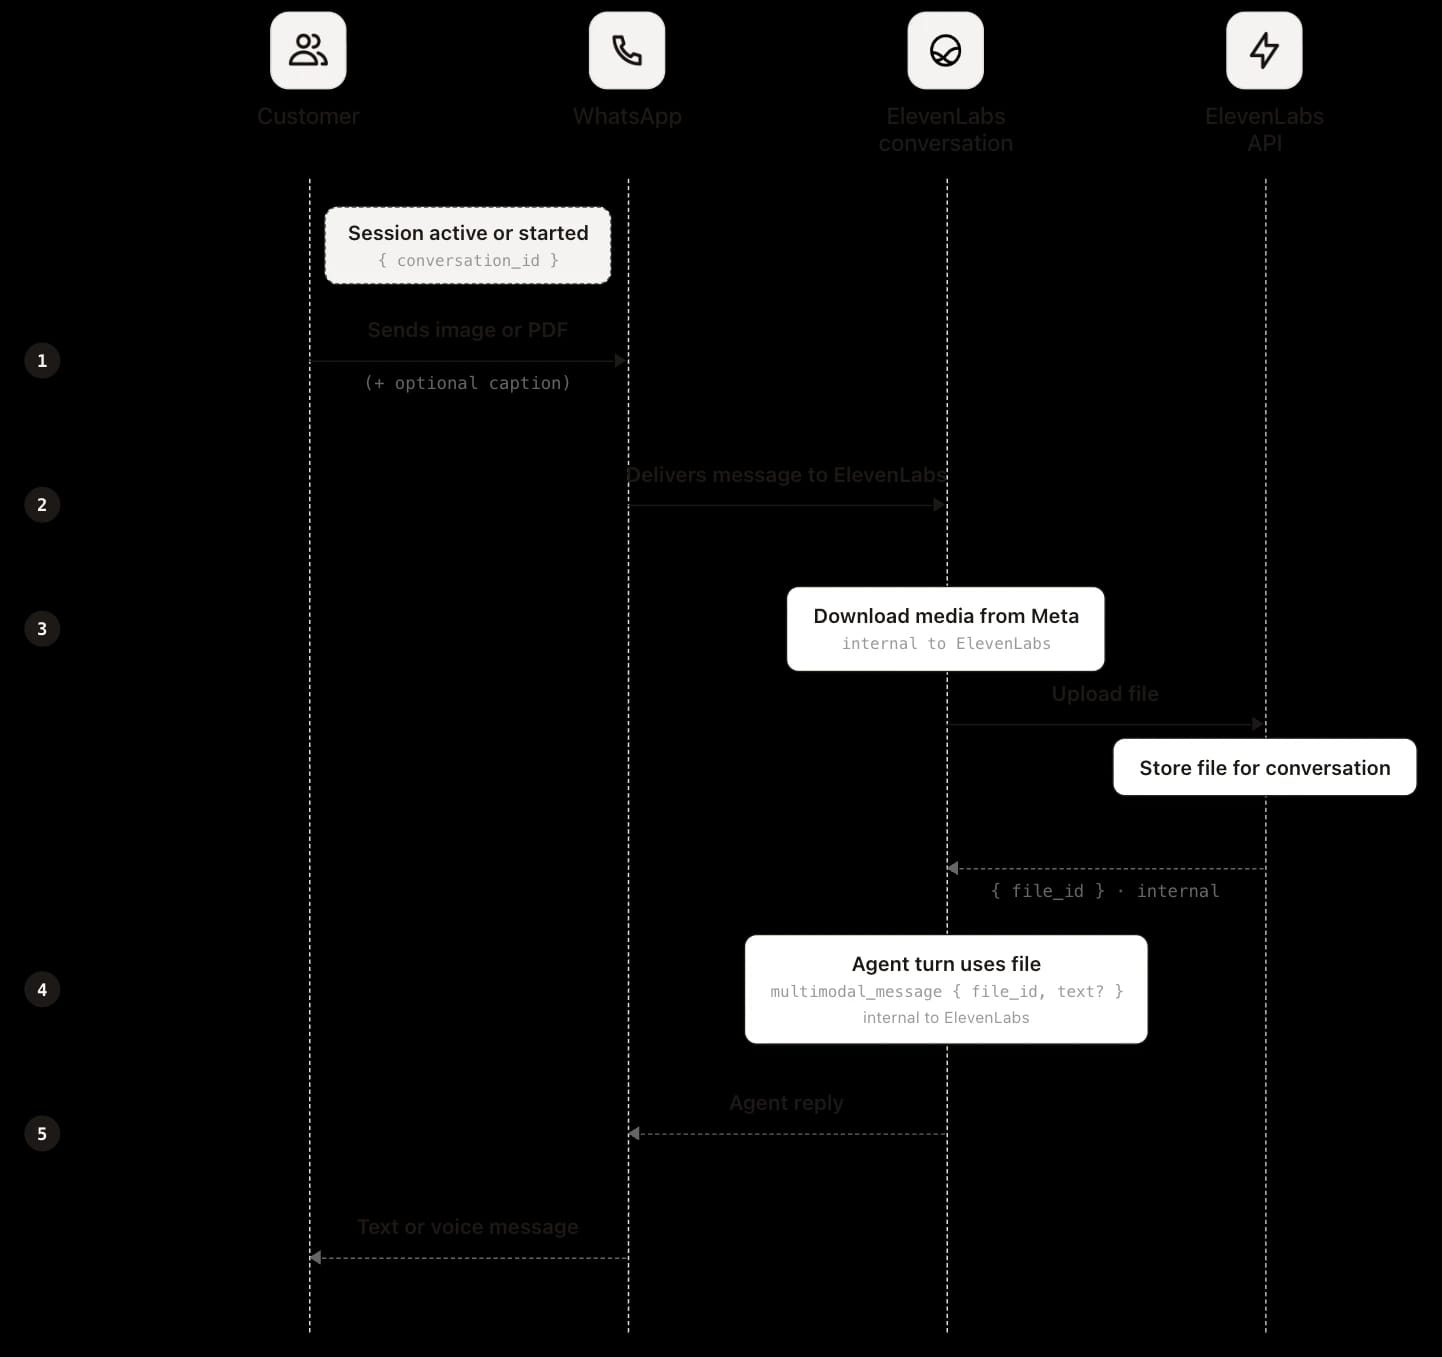
Op WhatsApp stuurt de klant het bestand in de chat. ElevenLabs haalt het op bij Meta, slaat het op en koppelt de file_id aan de kant van het platform. Dit betekent dat er geen uploadstap aan de clientzijde is. Anders dan op web en mobiel roept je applicatie niet POST /v1/convai/conversations/{id}/files aan en verstuurt deze geen multimodal_message via WebSocket. ElevenLabs verzorgt de bezorging, opslag en de beurt van de agent.
Context tussen sessies behouden
ElevenAgents verwerkt elk gesprek onafhankelijk. Niets wat een klant verstuurt, en niets wat de agent tijdens een gesprek afhandelt, wordt automatisch naar het volgende gesprek meegenomen. De agent geeft je systeem via de post-call webhook alles uit een voltooid gesprek, maar het geheugen dat gesprekken overspant, bevindt zich buiten de grenzen van ElevenLabs. De continuïteit ligt bij jou.
Het loont om bewust rond die architecturale grens te ontwerpen. De gesprekken waarin multimodale invoer het belangrijkst is (een klant die een beschadigd item fotografeert, een polisdocument uploadt of een locatie deelt) worden vaak niet in één sessie afgehandeld. Een klant die een foto van een kapot onderdeel stuurt en een terugbelafspraak maakt, verwacht dat de agent de foto onthoudt wanneer die terugbelt. Zonder expliciet contextbeheer begint de agent elke keer vanaf nul en moet de klant zichzelf herhalen. Het patroon dat dit oplost, bestaat uit twee delen. Wanneer een gesprek eindigt, levert de post-call webhook het transcript, analyseresultaten, eventueel door jou gedefinieerde velden voor gestructureerde gegevensverzameling en bestands-URL's voor bestanden die door de sessie zijn gegaan. Je backend slaat relevante informatie op bij een duurzame klantidentificatie, zoals een telefoonnummer, gebruikers-ID of accountsleutel. Wanneer die klant terugkomt, voegt je applicatie bij de start van de sessie de opgeslagen context toe via dynamische variabelen, zodat de agent het gesprek begint met wat deze al weet. Specifiek voor op bestanden gebaseerde invoer verwijst de bestands-URL in de webhook-payload naar de opgeslagen kopie van ElevenLabs en is dit het enige ophaalpad nadat het gesprek is gesloten. De kopie van het platform is beperkt tot de sessie, dus als je het bestand in een toekomstig gesprek of in je eigen systemen nodig hebt, moet je het uit de webhook-payload downloaden voordat dat venster sluit. Hoe snel je moet handelen, hangt af van het bewaarbeleid, dat wordt behandeld in de referentiedocumentatie. De webhook voert de status uit. Dynamische variabelen voeren deze weer in. Alles daartussen is de verantwoordelijkheid van je systeem, en daar zit het echte integratiewerk voor elke use case waarin klanten terugkomen, escaleren of een afhandeling halverwege voortzetten.
Context injecteren hangt af van het kanaal
Het injectiemechanisme verschilt per kanaal, maar het onderliggende patroon is consistent. Voor telefonie roept ElevenLabs je server aan voordat het gesprek wordt verbonden, zodat je de beller op nummer kunt opzoeken en dynamische variabelen zoals naam, order-ID of accountniveau kunt terugsturen voordat de agent spreekt. Op WhatsApp wordt bij elk inkomend bericht een pre-message webhook geactiveerd, waarmee je het kunt verrijken met identiteits- en bedrijfscontext uit je systemen voordat de agent het verwerkt. In andere gevallen worden dezelfde velden doorgegeven in conversation_initiation_client_data wanneer de sessie wordt geopend. ElevenAgents voegt sessies van verschillende kanalen niet samen tot één thread. Een WhatsApp-gesprek en een webgesprek zijn afzonderlijke sessies, zelfs als ze dezelfde klant betreffen. Maar omdat de webhook-output en het injecteren van dynamische variabelen voor alle kanalen hetzelfde werken, kan één persistentielaag ze allemaal afhandelen. Bouw deze één keer en deze dekt elk kanaal waarop de agent draait. Contextinjectie verwerkt tekstuele gegevens: namen, order-ID's, samenvattingen en gestructureerde velden. Bestanden vormen een apart geval en vereisen een andere aanpak.
Bestanden meenemen
Bestanden zijn beperkt tot één gesprek en blijven niet automatisch behouden. Wat je meeneemt, hangt af van of het volgende gesprek de informatie uit een bestand of het bestand zelf nodig heeft. In de meeste gevallen is alleen de informatie nodig. De agent interpreteert een geüpload bestand in de beurt waarin het binnenkomt, maar schrijft die interpretatie niet automatisch ergens duurzaam weg. De gestructureerde output komt uit de post-callgegevens: het transcript, de transcriptsamenvatting en eventueel door jou gedefinieerde velden met resultaten van gegevensverzameling. Als een klant een foto van een gebarsten deurafdichting stuurt en een week later terugkomt om de claim op te volgen, heeft de agent de foto niet opnieuw nodig. De agent moet weten dat de claim over een gebarsten deurafdichting gaat. Je haalt dat uit de post-callgegevens, slaat het op bij de klantidentificatie en voegt het als dynamische variabele toe wanneer de klant terugkomt. Een korte samenvatting of enkele gestructureerde velden is doorgaans voldoende.
Wanneer je het oorspronkelijke bestand wel nodig hebt, voor je eigen administratie, compliance of downstreamsystemen, is de post-call webhook het ophaalpad. Elk geüpload bestand verschijnt in het transcript als een file_input-event met een ondertekende bestands-URL. Die URL is vijftien minuten geldig, dus download en sla het bestand op wanneer de webhook binnenkomt in plaats van dit uit te stellen. Als je dat venster mist terwijl het gesprek nog bestaat, geeft de GET conversation API als terugvaloptie nieuwe URL's uit. Houd er rekening mee dat file_input in sommige gevallen, zoals de modus zonder bewaring, kan ontbreken, in plaats van ervan uit te gaan dat elke beurt met bestandsinvoer een URL bevat.
Dat omvat de volledige levenscyclus: een bestand komt de sessie binnen, het model werkt er native mee, gestructureerde output verlaat de sessie via de webhook en je persistentielaag bepaalt wat de agent de volgende keer weet.
Conclusie
Dezelfde agentconfiguratie accepteert afbeeldingen en PDF's op web, mobiel en WhatsApp, zonder een aparte implementatie per kanaal. Bestanden worden genormaliseerd, aan de beurt gekoppeld en als native blokken aan het model doorgegeven in plaats van als tekstsamenvattingen, zodat ruimtelijke lay-out, visuele structuur en documentopmaak intact het model bereiken. Context tussen sessies volgt op elk kanaal hetzelfde patroon: de post-call webhook voert de status uit en dynamische variabelen voeren deze weer in.
Als je bouwt met ElevenLabs Agents en wilt dat je agent naast spraak en tekst ook met afbeeldingen en documenten werkt, schakel dan multimodale invoer in en laat ons weten wat je ervan vindt.

Francesca maakt deel uit van het Forward Deployed Engineering-team en helpt klanten ElevenLabs Agents in hun workflows te integreren. Voordat ze bij ElevenLabs kwam, was ze Forward Deployed AI Engineer in de zorg, waar ze dossierbeoordelingen automatiseerde. Daarvoor bouwde ze technische oplossingen voor energiehandelaren.



