Praktische gids: opensource-agentframeworks en ElevenAgents
- Geschreven door
- Akhil Chauhan
- Gepubliceerd
- Laatst bijgewerkt
LuisterenLuister naar dit artikel
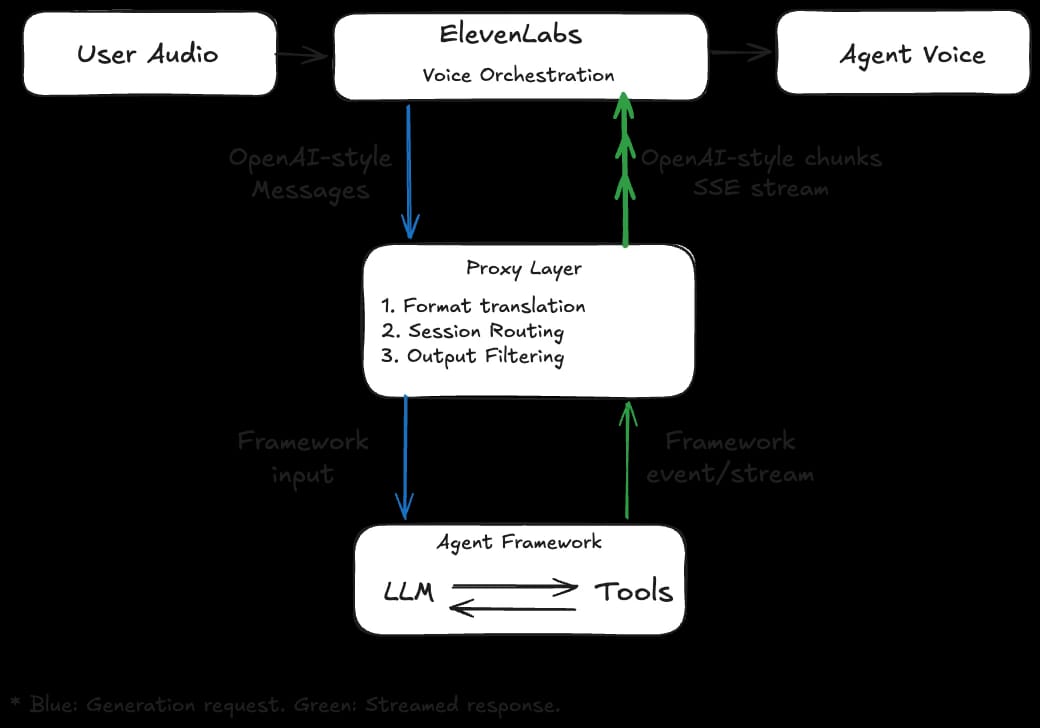
In onze vorige blogpost over Externe agents integreren met ElevenLabs Voice Orchestration, legden we uit hoe teams hun bestaande, op tekst gebaseerde agentorkestratie via de Custom LLM met ElevenLabs kunnen verbinden. Voortbouwend op die basis laat deze gids zien hoe toonaangevende opensource-agentframeworks kunnen worden aangepast en ingezet achter de Custom LLM-interface. Het resultaat is een flexibele architectuur waarin spraak wordt toegevoegd aan volwassen agentsystemen, zonder concessies te doen aan statusbeheer, toolorkestratie of applicatiespecifieke controle. Voor alle frameworks volgen we hetzelfde patroon in drie stappen: een generation request maken, de uiteindelijke tekstrespons ophalen en deze opnieuw formatteren naar een OpenAI-compatibel Server-Sent Events-formaat (SSE). ElevenLabs ondersteunt zowel de Chat Completions als Responses-formaten. Deze gids behandelt vier veelgebruikte frameworks, maar de patronen zijn toepasbaar op elke runtime die OpenAI-compatibele streamingoutput kan produceren.
Algemene configuratie
De voorbeelden in deze sectie gebruiken Python en FastAPI, maar elke stack die HTTP POST-requests en streaming SSE-responses verwerkt, werkt ook. Wanneer de spraakorkestratie van ElevenLabs waarschijnlijk het einde van een beurt detecteert, stuurt deze een generation request naar het geconfigureerde Custom LLM-endpoint. Deze sectie behandelt de kernonderdelen van die vertaallaag: de bridge of proxy die ervoor zorgt dat de spraakorkestratie en het agentframework dezelfde taal spreken.
Het is begrijpelijk dat klanten elk framework kunnen kiezen vanwege hun algemene bekendheid ermee of omdat het een specifiek doel kan vervullen. LlamaIndex is bijvoorbeeld oorspronkelijk ontwikkeld om het instellen van Retrieval-Augmented Generation (RAG) eenvoudiger te maken, terwijl CrewAI is ontwikkeld om afgebakende taken te automatiseren in het tijdperk van agents. Verschillende ontwerpdoelen leiden tot verschillende responsstructuren, die elk een specifieke aanpak vereisen. Chunks streamen terwijl het LLM ze genereert, in plaats van te wachten op een volledige beurt, is cruciaal: hierdoor kan het Text-to-Speech- (TTS)model eerder spraak genereren, waardoor de ervaren latentie afneemt. We richten ons op vier populaire frameworks: LangGraph, Google ADK, CrewAI en LlamaIndex.
Een opmerking over gedeelde code
Elk framework moet responses streamen als OpenAI-compatibele SSE-chunks. We introduceren een kleine hulpfunctie die in alle voorbeelden wordt gebruikt om deze chunks op te bouwen.
Met die basis kunnen we beginnen met LangGraph.
LangGraph
LangGraph modelleert agents als grafen, waarbij knooppunten afzonderlijke stappen voorstellen en verbindingen de control flow ertussen definiëren. De minimale configuratie is eenvoudig: initialiseer een chatmodel, definieer agenttools en maak de runtime voor de agentgraaf.
Voor elke generation request ontvangt de LangGraph Agent de volledige gesprekshistorie, waardoor deze de benodigde status intern kan bijhouden. LangGraph ondersteunt server-side persistentie via Checkpoints, maar om de implementatie minimaal te houden behandelen we die hier niet.
Nu het statusbeheer is geregeld, is de volgende LangGraph-specifieke keuze de streamingmodus. LangGraph biedt twee opties, elk geschikt voor een andere use case:
- stream_mode="values" levert snapshots van de graafstatus. Dit is eenvoudiger te implementeren, maar bevat bij elke respons een uitgebreidere berichtstatus, wat latentie toevoegt aan realtime gespreksflows.
- stream_mode="messages" streamt incrementele berichtchunks van het model. Dit heeft doorgaans de voorkeur voor realtime spraakinteracties, omdat het de time-to-first-audio in de ElevenLabs-orkestratielaag verkort.
Meer specifiek bevat de messages-implementatie van de agentloop tussenstappen, zoals updates voor tool calling, die niet hardop mogen worden uitgesproken. De proxy filtert deze eruit en geeft alleen responstekst voor de gebruiker door aan de TTS-laag. Hieronder staat een voorbeeld van een beurt waarin een tool wordt gebruikt.
[1] Model besluit een tool aan te roepen (tool_calls=["get_price"])[2] Tool wordt uitgevoerd en retourneert gegevens (result="$24.99") [3] Model produceert een respons met het resultaat (content="It costs $24.99")
Natuurlijk mogen alleen de chunks uit stap 3 in de SSE-stream worden doorgestuurd. In de praktijk verwerken twee controles deze filtering in de streamingloop: één om alleen events met langgraph_node == "model" te behouden en één die lege content overslaat. Samen zorgen deze controles ervoor dat alleen assistenttekst voor de gebruiker als SSE naar ElevenLabs wordt doorgestuurd. Met deze concepten samen bieden we een lichtgewicht implementatie van de requestproxy.
Dit zorgt ervoor dat alleen modelchunks voor de gebruiker naar ElevenLabs worden doorgestuurd. Omdat LangGraph de interne tooluitvoering zichtbaar maakt via de statusstream, is de filtering expliciet en wordt deze door de proxy beheerd.
Vervolgens gaan we in op de nuances van werken met Google's Agent Development Kit (ADK)
Google ADK
Google's ADK abstraheert de runtimeloop achter enkele kernprimitieven: Agent, Runner en SessionService. De Runner van ADK bevindt zich tussen de HTTP-laag en de agentdefinitie. Deze verwerkt berichtroutering, toolorkestratie, de sessielevenscyclus en eventstreaming.
Nadat de agent, session backend en runner zijn geïnitialiseerd, zoekt de proxy voor elke inkomende request een ADK-sessie op of maakt er een. In ADK beheert session_id de geheugenpersistentie: door dezelfde session_id in verschillende beurten te hergebruiken, worden de geschiedenis, tool calls en eerdere responses automatisch meegenomen. Omdat de gespreksidentiteit upstream in ElevenLabs staat, verwerkt de proxy deze toewijzing expliciet. Door de juiste identifier voor de generation request door te geven, kan de SDK de eerdere context intern verwerken. We geven de willekeurige identifier bij het starten van het gesprek door via extra parameters die aan de body van de request worden doorgegeven.
Nu het bericht en de sessie zijn voorbereid, kan de runner worden aangeroepen. Tool calls en toolresultaten verschijnen tijdens de uitvoering nog steeds als interne ADK-events, maar worden behandeld als tussenstappen in de orkestratie en niet als output voor de gebruiker. Hierdoor is geen handmatig filter nodig, in tegenstelling tot frameworks waarin tool calls als voor gebruikers zichtbare tekst verschijnen.
De onderstaande handler is een vereenvoudigde implementatie waarin sessie-resolutie en get-or-create-logica inline zijn opgenomen.
Vervolgens bekijken we CrewAI, dat van opzet meer taakgericht is.
CrewAI
CrewAI is ontworpen om multi-agentworkflows rond gestructureerde taken (onderzoeken, schrijven, samenvatten) te orkestreren, in plaats van rond open dialoogloops. Agents worden gedefinieerd met een rol, doel en achtergrondverhaal. De uitvoering draait om Task-objecten, elk met een duidelijke beschrijving en verwachte output.
In tegenstelling tot het agentloopmodel van LangGraph en ADK, maakt CrewAI doorgaans per request een Task en Crew om de werkeenheid voor die gespreksbeurt te definiëren. We nemen de gesprekscontext mee door eerdere beurten via een placeholder in de volgende taak in te voegen. De variabele {crew_chat_messages} wordt bij elke request gevuld met de lopende gesprekshistorie en vervolgens tijdens de uitvoering in de taakbeschrijving geïnterpoleerd. We streven daarnaast naar schone, spraakklaar tekst door tussenliggende tracingpatronen (Thought, Action, Action Input, Observation) expliciet weg te filteren en alleen tekst van het uiteindelijke antwoord uit te sturen.
De onderstaande handler brengt taakconstructie per request, interpolatie van de geschiedenis, streaming op Crew-niveau, tracefiltering en outputformattering samen.
Vervolgens bekijken we LlamaIndex, dat een andere aanpak hanteert en zich richt op een native eventgestuurd streamingmodel.
LlamaIndex
In tegenstelling tot de andere frameworks in deze blogpost is LlamaIndex ontworpen om LLM's te verbinden met externe databronnen (document stores, indexen, retrieval pipelines). De agentlaag ervan, FunctionAgent, bouwt voort op die basis om gestructureerde context op te halen en erover te redeneren, in plaats van open dialogen of taken uit te voeren.
Om de continuïteit van het gesprek te behouden, zet de proxy inkomende berichten om in LlamaIndex-chatberichten en splitst deze vervolgens op in de meest recente gebruikersbeurt (user_msg) en eerdere beurten (chat_history). Het veld event.delta van elk AgentStream-event bevat het volgende tekstfragment, dat rechtstreeks wordt toegewezen aan een delta.content-chunk in OpenAI-stijl. Niet-lege delta's kunnen ongewijzigd worden doorgestuurd, waardoor dit de meest eenvoudige streamingbridge in deze gids is. De stream bevat zowel orkestratie-events (tool calls, resultaten) als spraak-events (assistenttekstdelta's). Om de spraakoutput schoon te houden, bewaart de proxy alleen AgentStream-events en slaat deze lege delta's over.
[1] AgentStream (delta='') ← genegeerd[2] ToolCall ← genegeerd[3] ToolCallResult ← genegeerd[4] AgentStream (delta='It') ← doorgestuurd ✓[5] AgentStream (delta=' costs') ← doorgestuurd ✓[6] AgentStream (delta=' $49.99')← doorgestuurd ✓
Deze scheiding houdt tussenliggende toolmechanismen buiten de uitgesproken output, terwijl incrementele spraak met lage latentie behouden blijft. De onderstaande drop-in-handler brengt deze stappen samen.
LlamaIndex schrijft de end-to-end patronen voor de conversatieruntime minder voor dan de frameworks met zwaardere ingebouwde orkestratielagen. Voor productie-implementaties moeten klanten daarom doorgaans zelf sessiebeheer, guardrails voor responses, toolorkestratie en tracing implementeren.
Conclusie
Elk framework in deze gids verbindt met ElevenLabs via hetzelfde contract: accepteer een Completions- of Responses-request in OpenAI-stijl en stream SSE-chunks terug. Hierdoor kunnen teams met minimale wijzigingen spraakorkestratie toevoegen aan een bestaande agentimplementatie. Zo behouden ze wat ze al hebben gebouwd en maken ze realtime conversationele AI mogelijk. Deze modulariteit is een kernprincipe van het ElevenAgents-platform. Of organisaties nu een bestaande agent uitbreiden of vanaf het begin voor spraak bouwen, de spraakorkestratie van ElevenAgents is ontworpen om aan te sluiten op hun huidige situatie.
Gebruik je al een agent met een opensource-framework en wil je spraak inschakelen? Probeer deze aanpak en laat ons weten wat je ervan vindt.
Akhil maakt deel uit van het Forward Deployed Engineering-team bij ElevenLabs en helpt klanten agents te bouwen en implementeren. Daarvoor bouwde hij AI-gestuurde producten voor GTM-teams en was hij Lead Solutions Engineer bij Orgvue.